For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/azure-maia-300-microsoft-s-2027-multi-gig-1e316d9a.md.
Microsoft 正將其自研 AI 基礎設施計畫推進至規模更大的部署階段。
2026 年 10 月 12 日,該公司表示,計畫自 2027 年起將 Azure Maia 系列擴展至多吉瓦部署規模,並讓 Maia 成為 Microsoft 產品與服務的主要推論系統。
這項公告串聯了兩代由 Microsoft 設計的 AI 硬體。
Maia 200 已投入生產並支援 Microsoft 工作負載。下一代系統 Maia 300 預定於 2027 年開始投入生產部署,專為長上下文推理、對延遲敏感的對話,以及持續執行的多步驟代理工作負載而設計。
Microsoft 的核心論點是,推論效率已無法僅透過檢視晶片本身來改善。
該公司正將下列項目共同設計為一個系統:
這種系統級方法,正是 Microsoft 計畫擴展至多吉瓦規模的基礎。
在討論 Maia 300 前,Microsoft 的公告先從目前這一代開始。
Maia 200 不再只是開發平台。
Microsoft 表示,它現在正支援包括 Microsoft Copilot 在內的生產工作負載,同時協助 Microsoft AI 團隊開發下一代模型。
該公司表示,GitHub Copilot 與 Microsoft Foundry 預計將在 2026 年底前跟進。
在這些工作負載中,Maia 200 可以執行:
這點很重要,因為 Microsoft 並未將 Maia 定位為僅服務於單一專有模型系列的矽晶片。
此架構旨在支援 Azure 與 Microsoft 自身服務內的異質模型組合。
Microsoft 在極大規模下營運 AI 產品。
這讓其基礎設施團隊能直接掌握已部署模型在哪些環節消耗時間、記憶體頻寬、網路容量與電力。
Microsoft 表示,與其先設計通用加速器、之後才決定應用程式如何使用,不如讓硬體與軟體團隊提前數年協同工作。
目標是預判未來模型需求,並將其轉換為下列硬體選擇:
這個回饋迴路已在塑造下一代產品。
Microsoft 表示,Maia 200 正部署於:
針對 Microsoft Teams、Copilot 與 Cowork 等產品中的內建 AI 功能,Microsoft 報告稱,與其所稱的領先 GPU 基礎設施相比,Maia 200 每瓦可提供最高 1.7 倍更多權杖。
這是 Microsoft 自行報告的比較,而非基於標準化第三方系統所發布的獨立基準測試。
這項措辭很重要。
它反映 Microsoft 的內部生產經驗,但不應被解讀為 Maia 200 對每個模型、提示詞、批次大小、延遲目標或 GPU 部署都具有普遍性的 1.7 倍優勢。
Microsoft 表示,Maia 200 的生產經驗直接影響了 Maia 300 的設計。
新系統旨在支援更廣泛的工作負載,包括:
這些工作負載的共同限制條件是推論。
它們要求模型在處理更長上下文、維持更多狀態與執行更多步驟的同時,仍能保持回應速度。
Microsoft 將 Maia 300 描述為 Azure Maia 計畫的第三代產品。
其設計採取推論優先原則。
這代表 Microsoft 正圍繞其預期將主導已部署 AI 系統的工作負載進行最佳化,而不只著眼於訓練吞吐量。
這些工作負載包括:
目標指標日益不只是原始 FLOPS。
而是在下列固定限制條件內,一座資料中心可交付多少有用權杖:
Microsoft 表示,預期 Maia 300 相比領先的 GPU 型系統,可提供高出 40% 的每兆瓦權杖數。
此數據是 Microsoft 對系統級部署效率的預期,而非具有完整跨供應商測試方法的公開獨立基準測試。
在完整的 96 加速器機櫃中,Microsoft 也表示 Maia 300 的機櫃級權杖吞吐量可達 Maia 200 的最高 7 倍。
這兩項數據衡量的是不同的比較:
| 主張 | 比較對象 |
|---|---|
| 每兆瓦多 40% 權杖數 | Maia 300 與領先的 GPU 型系統 |
| 機櫃級權杖吞吐量最高 7 倍 | 完整 96 加速器 Maia 300 機櫃與 Maia 200 |
兩者不應視為可互換的數據。
Maia 300 背後的一項核心概念是:移動資料已成為重大瓶頸。
現代推論系統會反覆移動:
這些資料會在運算單元、記憶體與網路連線之間移動。
每一次移動都會消耗延遲與能源。
Microsoft 的解法是進一步發展 Maia 200 引入的 Software Defined Locally Accessed Dataflow Architecture,即 SDLA。
軟體控制資料在下列資源中的放置位置,以及跨資源移動的時機:
Maia 300 將這個概念延伸至多晶粒設計。
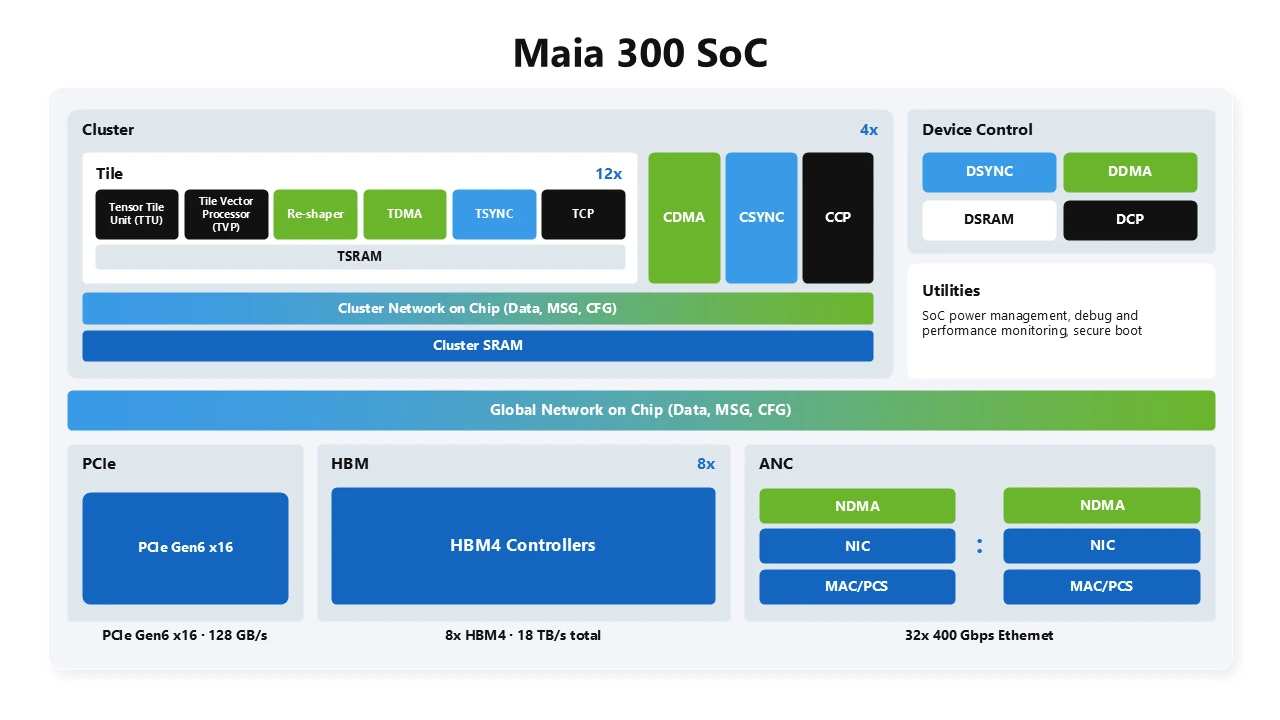
Maia 300 從較為統一的記憶體組織,轉向跨晶粒、具區域性意識的非一致性記憶體架構。
目的很直接:
讓資料更靠近使用它的運算資源
→ 移動更少位元組
→ 降低延遲與能源消耗
→ 提高利用率
此架構讓軟體對控制資料區域性承擔更多直接責任。
這對長上下文與以解碼為主的推論尤其重要,因為模型狀態與 KV 快取的移動可能主導整體工作負載。
記憶體是 Maia 300 最重要的升級之一。
每個加速器採用 八組 HBM4 堆疊,提供:
Microsoft 表示,這帶來約:
系統也使用晶片內 SRAM 作為由軟體管理的暫存空間。
這可透過將經常重複使用的資料保留在更接近運算的位置,降低 HBM 壓力。
對推論而言,這很重要,因為許多工作負載的限制在於狀態傳遞至運算引擎的速度,而非這些引擎的峰值算術能力。
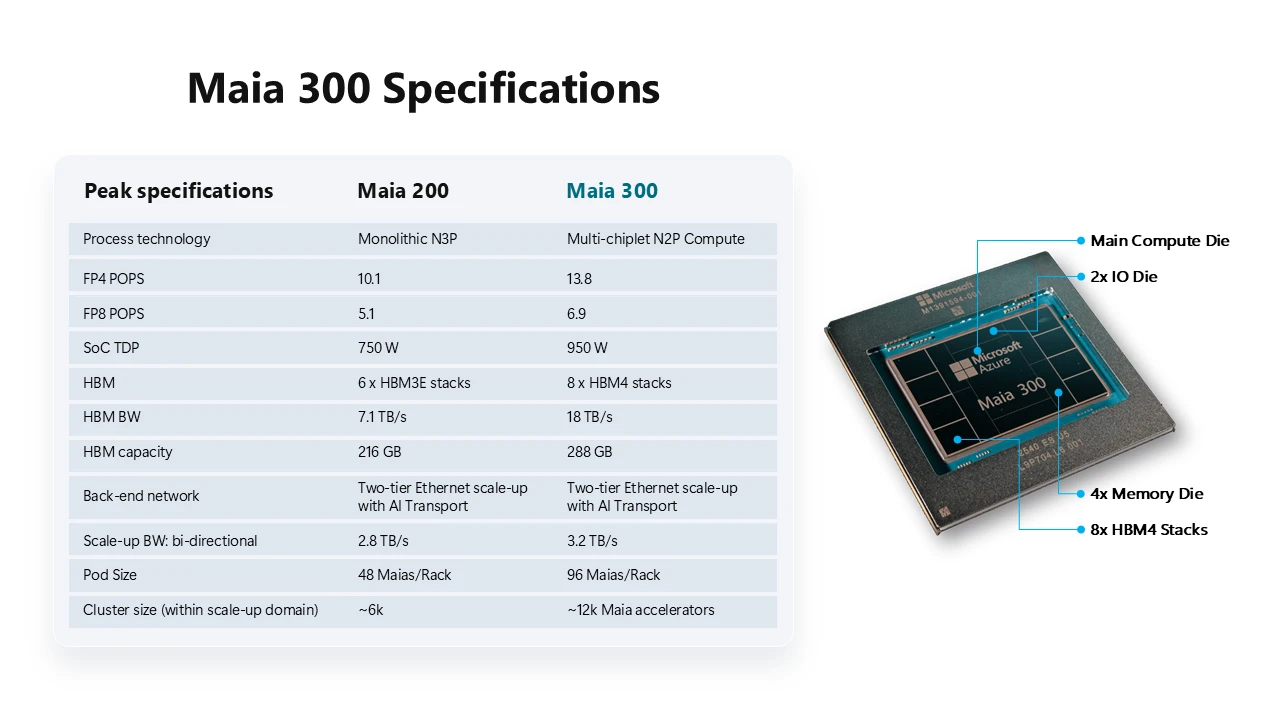
Maia 300 不像 Maia 200 一樣,採用單一單體晶粒。
Microsoft 正將主要功能分離至不同晶粒。
此架構包含以下獨立功能:
運算晶粒採用 TSMC 的 N2P 製程。
其考量同時涉及經濟效益與技術。
最先進的製程技術可集中於最能帶來每瓦效能效益的部分,其他功能則可採用針對頻寬、連線能力或成本最佳化的設計。
Microsoft 的技術架構文章表示,與 Maia 200 相比,此變化有助於實現:
Maia 300 也擴大支援低精度推論。
Microsoft 在技術架構資料中強調增強的 MXFP4 支援與低於 3 位元的儲存格式。
低精度可減少:
其效益不只是數值更小。
若模型可在較低精度下維持所需品質,基礎設施便能在相同電力範圍內支援:
Microsoft 也表示,向量引擎針對 softmax 與低精度資料轉換等推論核心,新增了指令級最佳化。
在大規模環境中,只有加速器能夠高效通訊,才具備實際價值。
Maia 300 將其資料流模型延伸至網路本身。
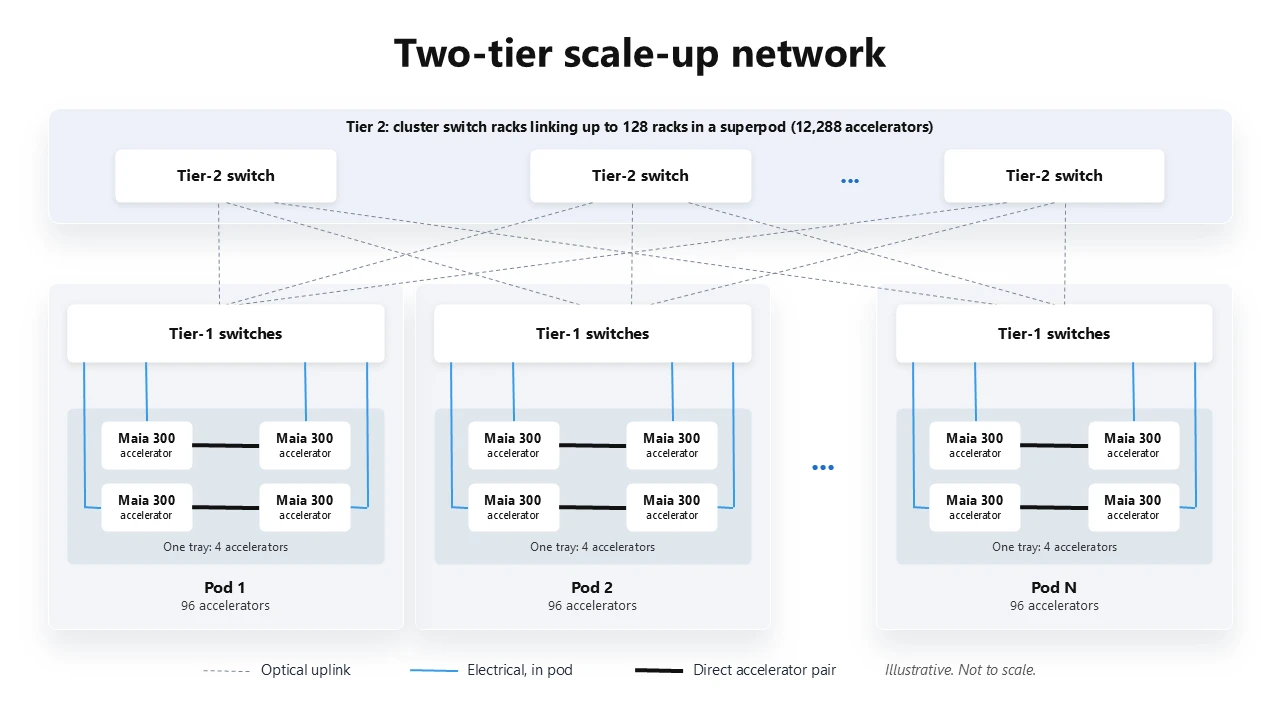
Microsoft 透過乙太網路型基礎設施上的自訂 AI 傳輸,搭配雙層擴展拓撲。
單一 Maia 300 機櫃包含:
96 個加速器
之後可將多個機櫃連接成超級叢集。
Microsoft 的技術架構描述其最大超級叢集為:
128 個機櫃
12,288 個 Maia 300 加速器
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
在機櫃內,直接連線將加速器成對連接,而交換式電氣路徑則連接完整的 96 加速器 Pod。
Microsoft 表示,讓機櫃內的擴展網路保持為電氣連線,有助於降低電力消耗與成本。
第二層網路採用光學連線以跨越機櫃。
這使最多 128 個機櫃可參與同一個擴展網域。
Microsoft 所述的目標,是避免針對每個實體邊界暴露不同的通訊語意。
同一套通用通訊模型涵蓋:
這為排程器與軟體在放置張量平行、管線平行與專家平行工作負載時提供更大彈性。
Maia 300 的機櫃是系統設計的重要部分。
每個機櫃包含:
Microsoft 的架構比較在其機櫃圖表中將總 HBM 容量四捨五入為 27.7 TB。
這個差異僅是 96 × 288 GB 的四捨五入結果。
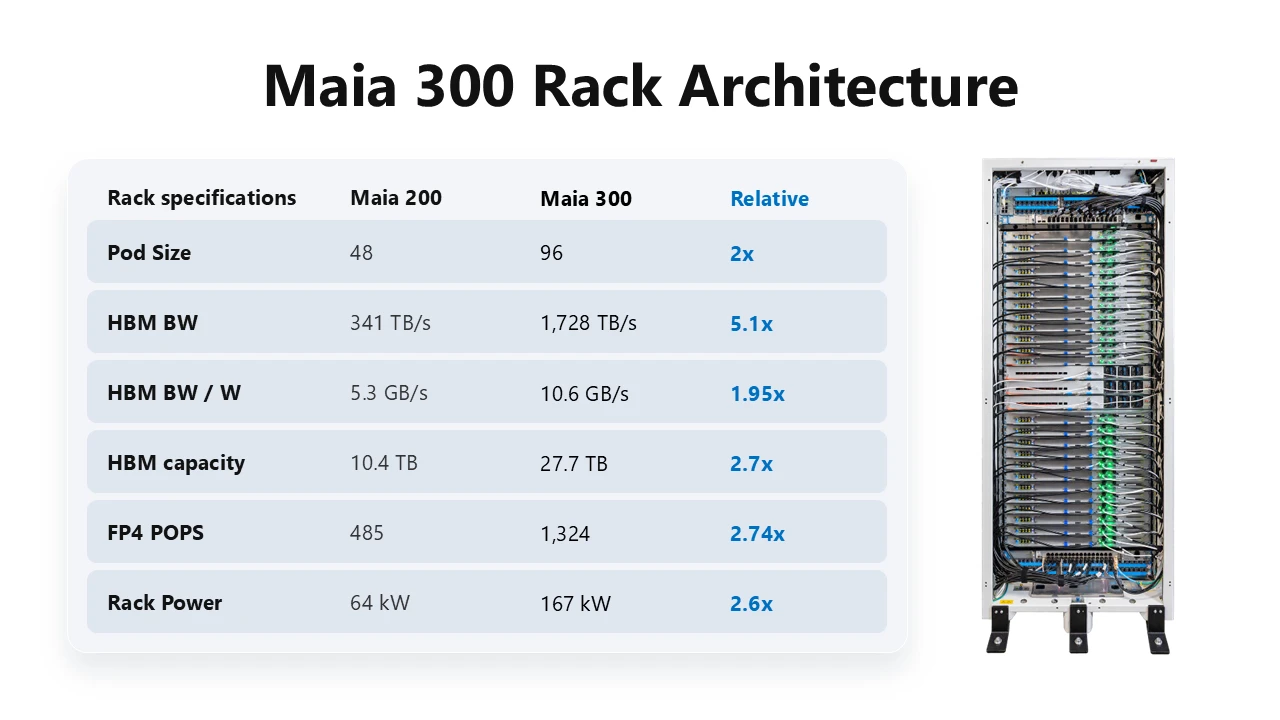
其加速器密度是 Maia 200 的兩倍。
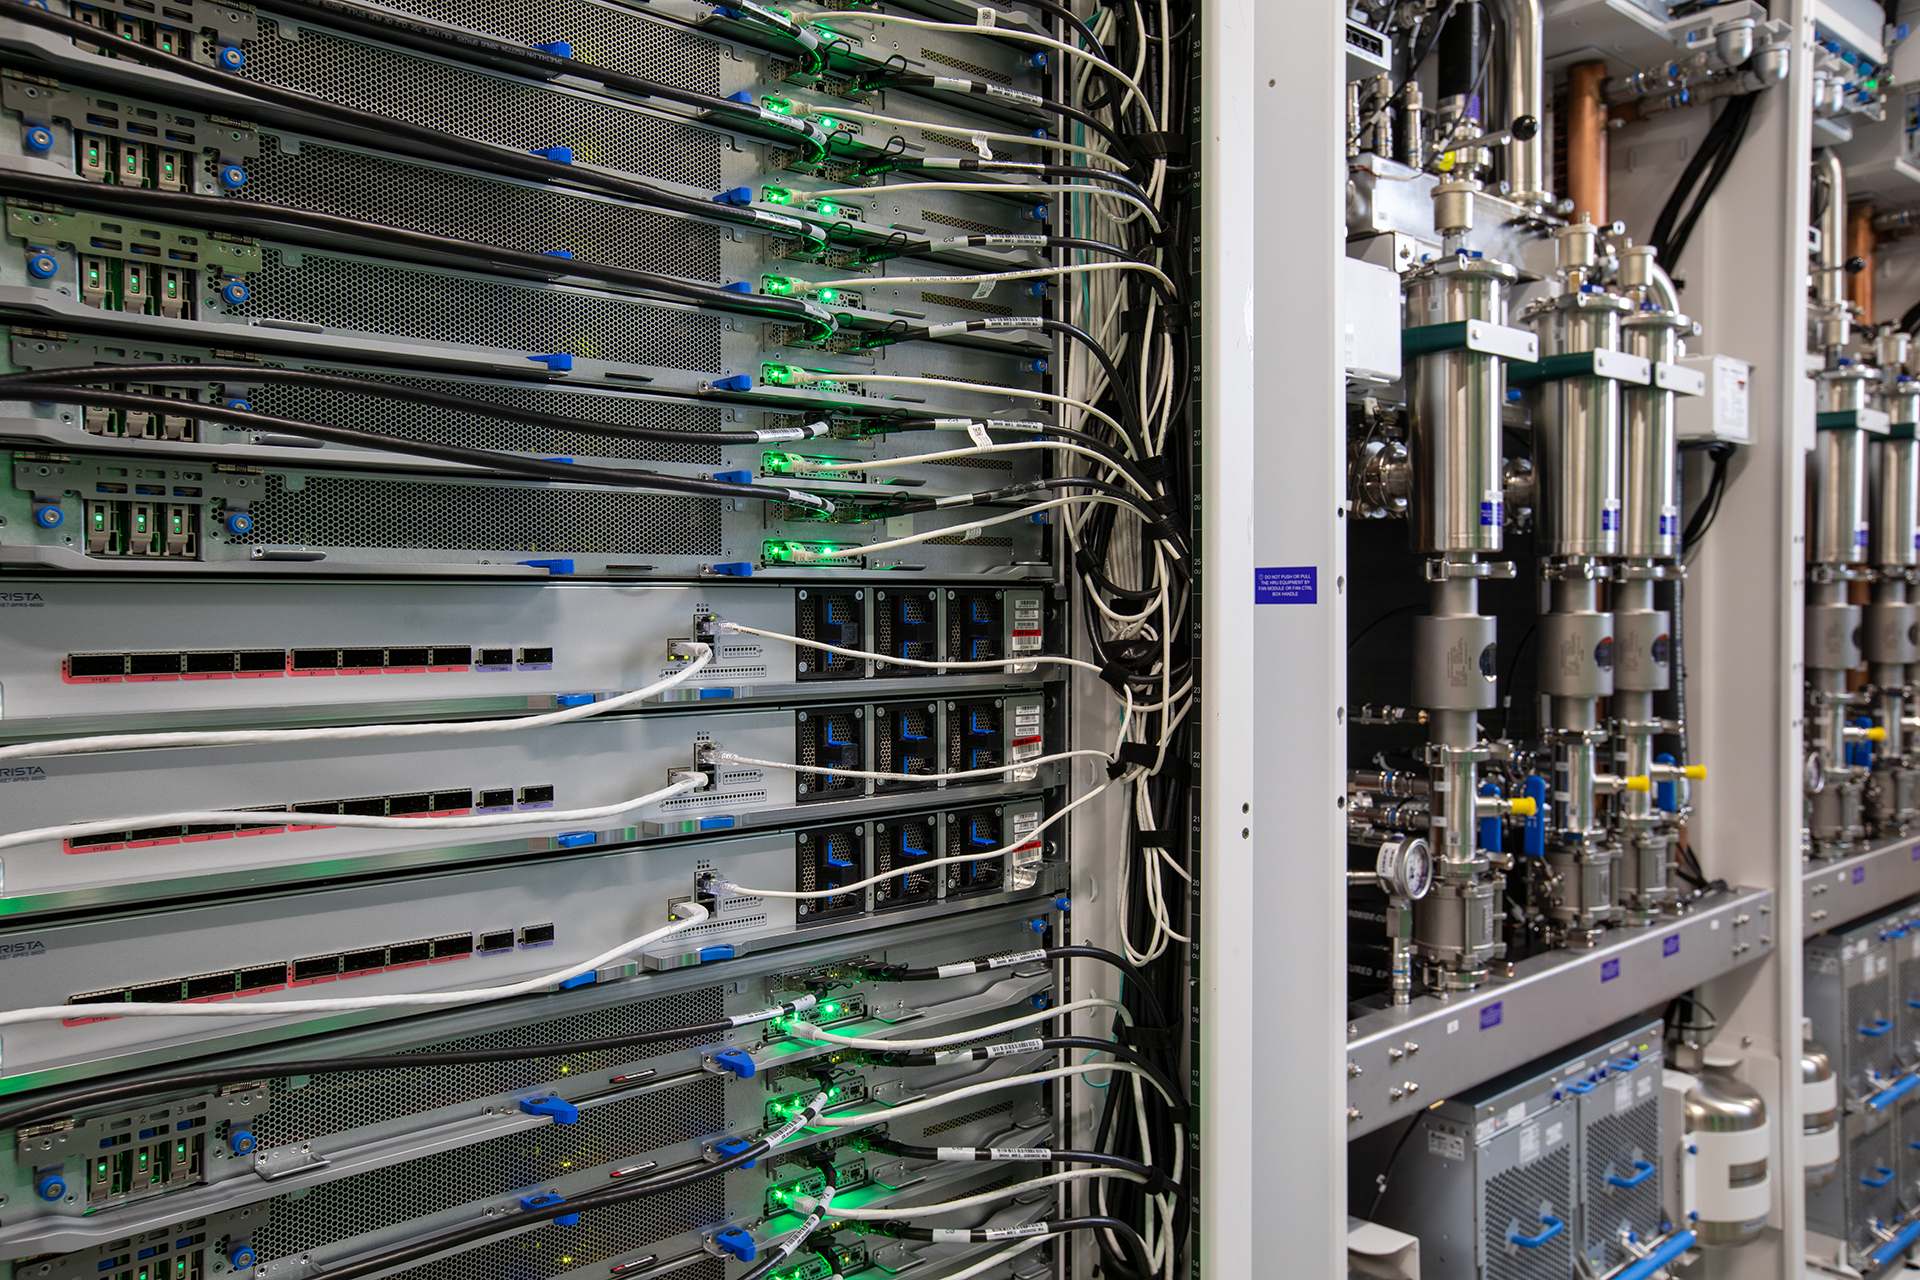
Microsoft 將主機運算、記憶體、儲存、冷卻與加速器整合至每個托盤中,而非要求使用獨立的主機托盤。
這釋放了機櫃空間,也讓電力與熱管理可作為一個系統處理。
一個 167 kW 的 AI 機櫃帶來顯著的熱管理挑戰。
Microsoft 表示,液冷可從下列元件移除超過 80% 的機櫃熱負載:
空氣冷卻仍用於記憶體、儲存與其他支援系統等元件。
在具備該基礎設施的場所,機櫃可直接連接設施供水。
在其他採空氣冷卻的設施中,也可使用熱交換器單元。
這種彈性對部署規模很重要。
Microsoft 無法只在圍繞單一精確冷卻配置建造的資料中心中擴展 Maia。
下表彙整 Microsoft 已發布的 Maia 300 規格,以及其與 Maia 200 的比較。
| 規格 | Maia 200 | Maia 300 |
|---|---|---|
| 製程/封裝方式 | 單體式 N3P | 多晶粒、N2P 運算 |
| FP4 峰值 | 10.1 POPS | 13.8 POPS |
| FP8 峰值 | 5.1 POPS | 6.9 POPS |
| SoC TDP | 750 W | 950 W |
| HBM | 6 × HBM3E | 8 × HBM4 |
| 每加速器 HBM 容量 | 216 GB | 288 GB |
| 每加速器 HBM 頻寬 | 7.1 TB/s | 18 TB/s |
| 雙向擴展頻寬 | 2.8 TB/s | 3.2 TB/s |
| 每機櫃加速器數量 | 48 | 96 |
| 約略機櫃 HBM 容量 | 10.4 TB | 27.7 TB |
| 機櫃電力 | 64 kW | 167 kW |
| 已公布最大擴展網域 | 約 6K 個加速器 | 約 12K 個加速器 |
以上是 Microsoft 發布的峰值/系統規格。
這些不是應用程式級保證。
實際吞吐量取決於模型、精度、批次大小、延遲目標、平行化策略、軟體堆疊與工作負載組合。
最受矚目的數字,是 Microsoft 計畫自 2027 年起將 Azure Maia 推進至多吉瓦部署規模。
這是一項關於基礎設施規模的說法。
Microsoft 尚未公布與此說法相關的確切總吉瓦數、逐項部署時程或加速器數量。
也不應將其解讀為單一 Maia 300 資料中心必然消耗數吉瓦電力。
吉瓦級計畫可以橫跨:
該公司的公告刻意聚焦於系統策略,而非逐座設施的建設計畫。
AI 基礎設施日益受限於可在既有電力範圍內配置多少有效運算能力。
若無法同時提供下列條件,資料中心就無法無限增加加速器:
這正是 Microsoft 強調每兆瓦權杖數的原因。
這項指標將模型服務輸出與日益決定資料中心擴張能力的稀缺資源連結起來。
一款速度更快、但耗電量也按比例提高的晶片,未必能解決真正的部署問題。
目標是在相同基礎設施範圍內生成更多有用的 AI 輸出。
Microsoft 的公告不僅表示 Maia 300 將是另一種加速器選項。
該公司表示,隨著部署規模擴大,Maia 系列將成為其 Microsoft 產品與服務的主要推論系統。
這使 Maia 在 Microsoft 的整個技術堆疊中具備策略重要性。
該公司提及或參考的工作負載包括:
這並不代表 Microsoft 正放棄 GPU 或其他加速器。
Microsoft 明確將其更廣泛的基礎設施描述為異質且模型多元。
Maia 計畫為 Microsoft 增加了一種可針對自身服務模式緊密最佳化的基礎設施選項。
Microsoft 公告的最後一節,將 Maia 納入該公司所稱的 Frontier Transformation。
其理念是,AI 基礎設施不應作為彼此孤立的層次進行最佳化。
Microsoft 希望串聯:
矽晶片
→ 系統
→ 資料中心
→ 模型服務
→ 代理
→ 應用程式
由於 Microsoft 營運所有這些層次,因此能運用來自應用程式的生產回饋來影響未來硬體。
反向關係同樣成立。
新的硬體能力可塑造未來模型與代理在大規模環境下可經濟實現的能力。
這就是 Maia 的策略目標。
該公司並不是試圖證明一款晶片將取代所有加速器。
而是在 Azure 中打造一個可與其他硬體並存、垂直協同設計的推論平台。
Maia 300 已發布的規格相當可觀,但多數關鍵系統仍處於量產前階段。
生產部署將於 2027 年開始。
當系統進入實際工作負載後,下列問題將十分關鍵。
Microsoft 預期 Maia 300 相比領先 GPU 型系統,每兆瓦可提供多 40% 的權杖。
真正值得關注的問題,是這項表現如何適用於不同模型與延遲目標。
自研矽晶片只有在編譯器、核心、可觀測性、部署工具與模型支援足夠成熟、能服務生產團隊時才會成功。
Microsoft 希望 Maia 支援 OpenAI、MAI 與開源模型系列。
異質架構下的生產效率將是重要考驗。
12,288 加速器的擴展網域在架構上具有重要意義。
實際利用率、故障復原、排程與跨機櫃通訊,將決定這項理論規模有多少能轉化為實際有效容量。
每瓦效能只是總成本的一部分。
資料中心營運商還會關注:
若該策略奏效,Microsoft 的優勢將來自最佳化整個系統,而非單一基準數字。
Azure Maia 300 是 Microsoft 第三代自研 AI 推論系統。它結合多晶粒加速器、HBM4 記憶體、軟體定義資料流、基於乙太網路的自訂擴展網路,以及專為雲端規模 AI 推論設計的 96 加速器機櫃架構。
Microsoft 表示,生產部署將於 2027 年開始。該公司也計畫在 2027 年開始將 Maia 系列擴展至多吉瓦部署規模。
這代表 Microsoft 計畫讓 Maia 基礎設施的總體電力規模達到以多個吉瓦計算的程度。Microsoft 並未公布確切總量、加速器數量,也未表示單一資料中心將消耗多個吉瓦,因此不應僅根據標題推論這些細節。
每個 Maia 300 加速器配備八組 HBM4 堆疊,提供 288 GB 容量與 18 TB/s 的峰值 HBM 頻寬。一個 96 加速器機櫃合計約有 27.6–27.7 TB HBM。
Microsoft 為完整的 96 加速器 Maia 300 機櫃指定 167 kW 電力範圍。加速器 SoC 本身的 TDP 為 950 W。
Microsoft 預期 Maia 300 相比領先 GPU 型系統可提供高出 40% 的每兆瓦權杖數,但尚未針對此主張發布完整的獨立跨供應商基準測試方法。因此,這個結果應視為 Microsoft 對系統級效能的預期,而非普遍性的基準測試結論。
Microsoft 表示 Maia 將成為其產品與服務的主要推論系統,但也將 Azure 描述為提供模型與矽晶片選擇的開放、異質平台。Maia 是更廣泛基礎設施組合的一部分,並不表示 Azure 將只採用 Microsoft 自研矽晶片。
Microsoft 表示,Maia 200 已在支援 Microsoft Copilot,並協助 MAI 團隊進行下一代模型開發。GitHub Copilot 與 Microsoft Foundry 預計將在 2026 年底前跟進。
Microsoft 正將 Azure Maia 從自研加速器計畫轉型為大規模推論平台。Maia 200 已在執行生產工作負載,而 Maia 300 預定於 2027 年開始部署,並圍繞長上下文、以解碼為主及代理式推論進行設計。
最重要的變化在於系統層級:每個加速器配備 288 GB HBM4、18 TB/s 記憶體頻寬、多晶粒 N2P 設計、每個 167 kW 機櫃配置 96 個加速器、可擴展至 12,288 個加速器的擴展網路,以及可移除超過 80% 機櫃熱量的液冷系統。
Microsoft 的目標是將 Maia 系列擴展至多吉瓦部署規模,並使其成為自家產品與服務背後的主要推論系統,同時維持 Azure 的異質性。
Maia 300 的核心故事,不是一款晶片取代另一款晶片,而是 Microsoft 圍繞 AI 推論的經濟性,設計從矽晶片到資料中心再到代理的完整路徑。
從一句話開始,幾分鐘內拿到完整網站。



