For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/claude-haiku-5-vs-gpt-6-luna-benchmarks-p-ec36c306.md.
Anthropic 已推出 **Claude Haiku 5.5**,這並不是一次例行的小模型更新。

Anthropic 已推出 Claude Haiku 5.5,這並不是一次例行的小模型更新。
新款 Haiku 在電腦操作、程式設計、專業工作與大量工具驅動的 Agent 任務方面,遠遠超越 Haiku 4.5,同時大幅降低了 API 的標示價格。
根據 Anthropic 自行公布的發布比較結果,Haiku 5.5 在多項基準測試中也擊敗了 GPT-6 Luna,包括 GDPval-AA v2.1、OSWorld 2.1、Terminal-Bench 4.0、FrontierCode 1.1 與 Chartography。
這使 Haiku 5.5 成為下列高使用量工作負載的新選項:
但這次發布也伴隨幾項重要注意事項。
定價會在 100K 提示詞邊界發生變化;新的分詞器會讓相同文字產生更多 Token;此外,升級現有的 Haiku 4.5 整合還需要進行多項 API 變更。
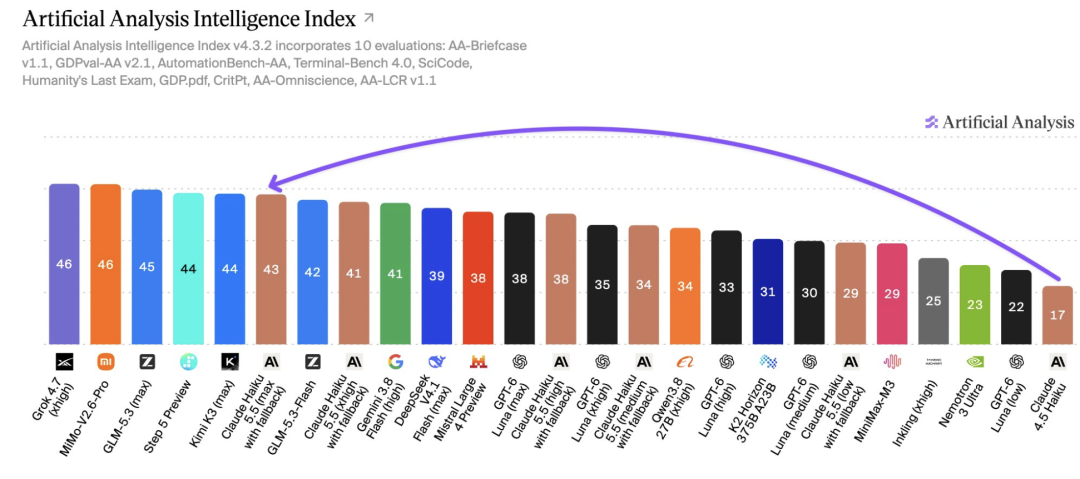
Anthropic 將 Haiku 5.5 定位為目前最便宜、最快且能力最強的小模型。
官方基準測試表清楚顯示了其目標競爭對手:GPT-6 Luna 直接與 Haiku 5.5 並列其中。
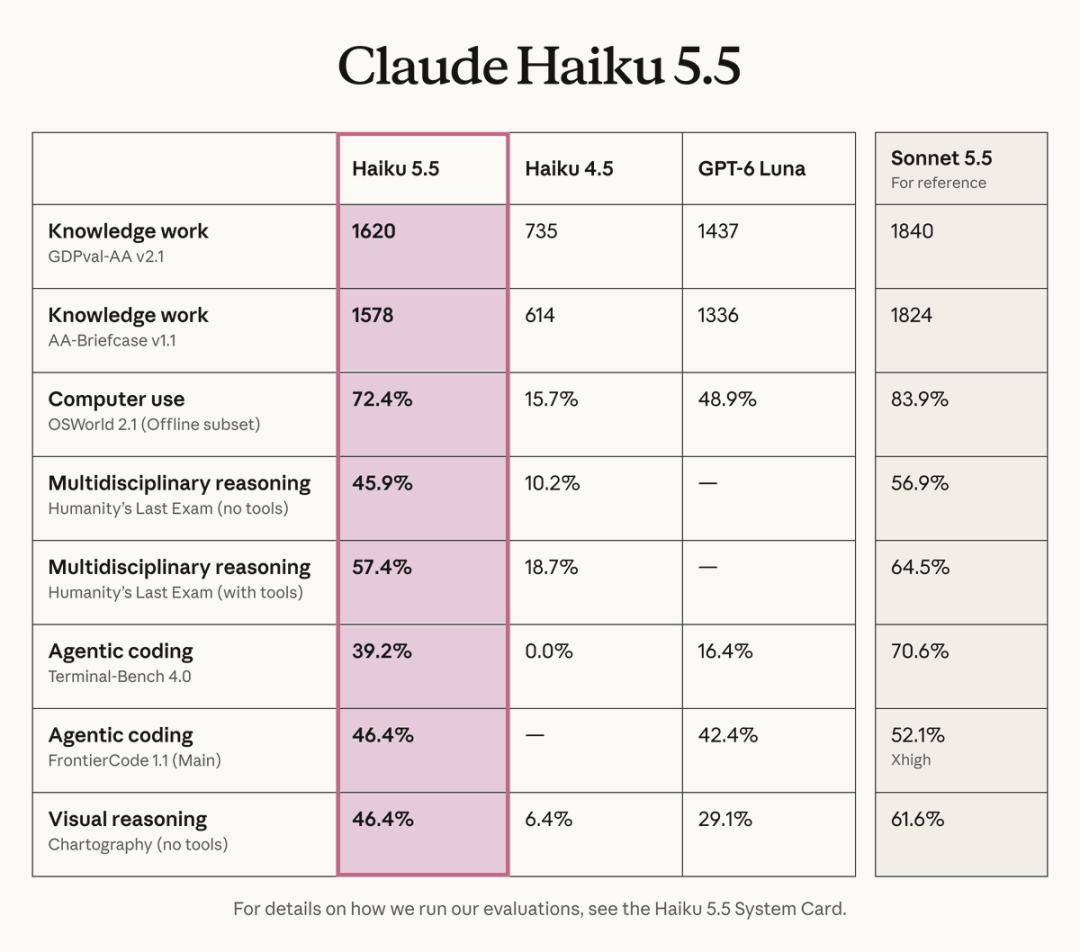
發布結果包括:
| 基準測試 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1,離線子集 | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity’s Last Exam,無工具 | 45.9% | 10.2% | — | 56.9% |
| Humanity’s Last Exam,使用工具 | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1(主要測試) | 46.4% | — | 42.4% | 52.1% |
| Chartography,無工具 | 46.4% | 6.4% | 29.1% | 61.6% |
重點並不是 Haiku 5.5 突然取代了所有更大型的模型。
真正的變化是,最小的 Claude 模型層級,如今在過去通常需要更大型模型才能完成的任務上,具備了更強的能力。
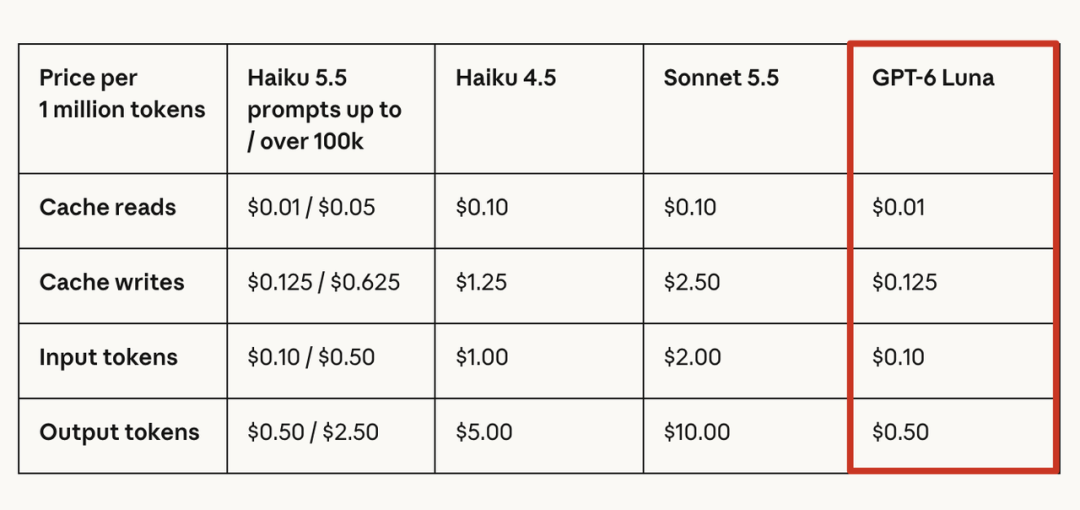
對於不超過 100K Token 的提示詞,Anthropic 收費如下:
Haiku 5.5 輸入:  $0.10 / 100 萬 Token
Haiku 5.5 輸出:  $0.50 / 100 萬 Token
快取讀取:       $0.01 / 100 萬 Token
快取寫入:       $0.125 / 100 萬 Token
OpenAI 目前的 GPT-6 Luna 標準定價如下:
GPT-6 Luna 輸入:        $0.10 / 100 萬 Token
GPT-6 Luna 快取輸入:    $0.01 / 100 萬 Token
GPT-6 Luna 快取寫入:    $0.125 / 100 萬 Token
GPT-6 Luna 輸出:        $0.50 / 100 萬 Token
因此,在短上下文的標準 API 工作中,兩個模型的標示 Token 費率幾乎完全一致。
Haiku 5.5 採用兩個定價層級。
| Token 類型 | 提示詞 ≤100K | 提示詞 >100K |
|---|---|---|
| 快取讀取 | $0.01/M | $0.05/M |
| 快取寫入 | $0.125/M | $0.625/M |
| 輸入 | $0.10/M | $0.50/M |
| 輸出 | $0.50/M | $2.50/M |
Anthropic 表示,不超過 100K Token 的提示詞約占 Haiku 4.5 請求量的 90%,因此較低的定價層級可以涵蓋預期流量中的大多數請求。
對於超過 100K Token 的提示詞,Haiku 5.5 仍然比 Haiku 4.5 便宜,但折扣幅度較小。
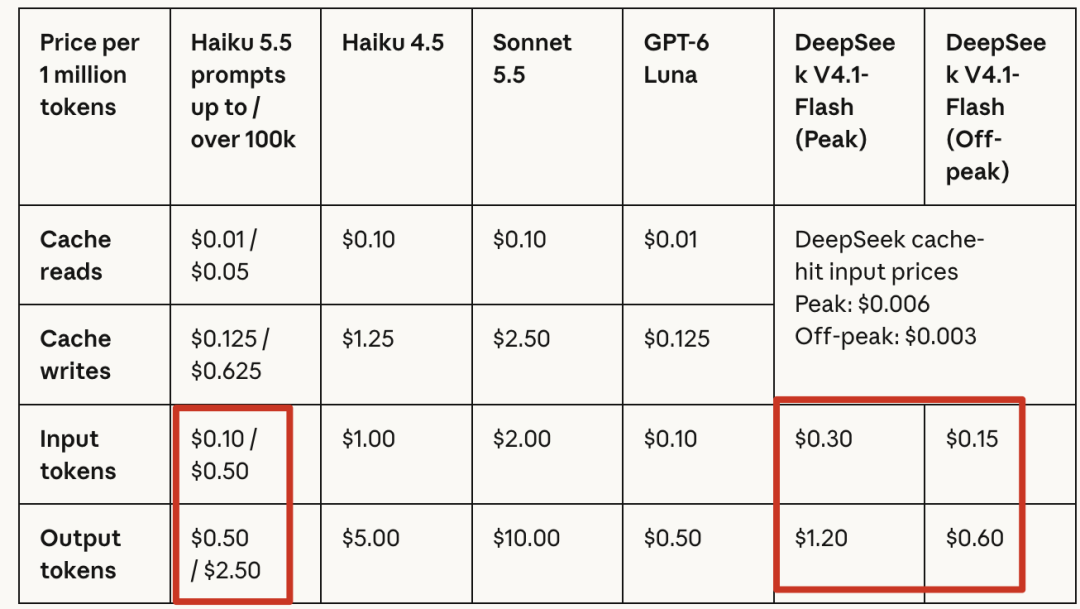
原文將 Haiku 5.5 與 DeepSeek-V4.1-Flash 進行了比較。
DeepSeek 目前的官方定價採用尖峰與非尖峰費率。
對於未命中快取的輸入與輸出:
| 模型 | 輸入 / 100 萬 | 輸出 / 100 萬 |
|---|---|---|
| Haiku 5.5,不超過 100K 提示詞 | $0.10 | $0.50 |
| DeepSeek-V4.1-Flash,非尖峰 | $0.15 | $0.60 |
| DeepSeek-V4.1-Flash,尖峰 | $0.30 | $1.20 |
DeepSeek 在命中快取的輸入價格方面仍然更便宜,尤其是在非尖峰時段。因此,總成本仍取決於工作負載結構。
上一代 Haiku 在要求較高的電腦操作任務上缺乏競爭力。
Haiku 5.5 大幅改變了這一點。
Anthropic 的 OSWorld 2.1 離線子集結果,從 Haiku 4.5 的 15.7% 提升至 Haiku 5.5 在最高努力程度下的 72.4%。
原文也進行了一項實務測試:要求 Haiku 5.5 將 GPT-6 與 DeepSeek 的定價資料加入 Haiku 發布頁面的表格中。
模型沒有透過使用者介面逐一手動編輯 HTML 元素,而是開啟瀏覽器主控台,並使用腳本注入變更。
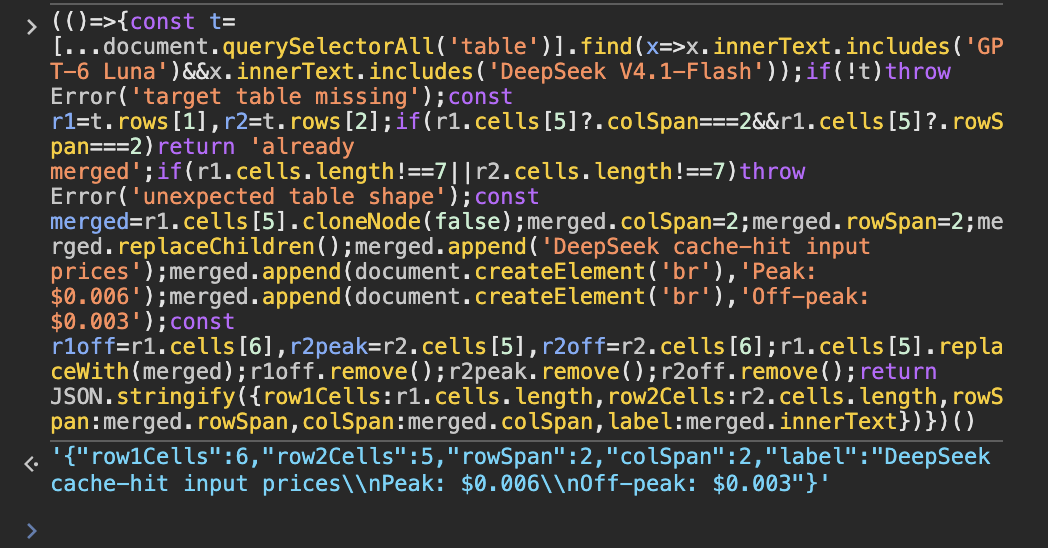
這種行為很有用,因為電腦操作 Agent 不一定需要完全模仿人類的滑鼠移動。
如果瀏覽器環境提供更直接的執行路徑,使用腳本可能比逐一點擊每個儲存格更快速、更可靠。
Haiku 5.5 是第一個具備可調整努力程度控制項的 Haiku 類模型。
模型支援從低成本、快速回應到更高成本、更審慎推理的完整範圍。
Anthropic 的發布圖表顯示了 OSWorld 上清晰的準確率與成本曲線。
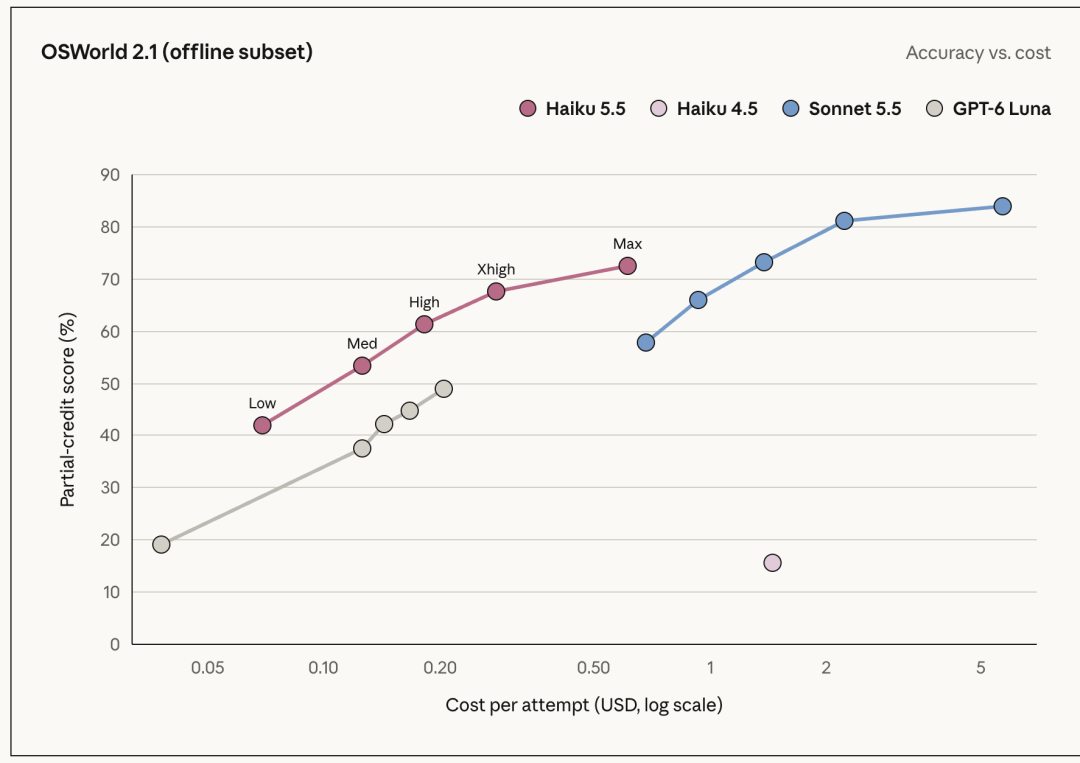
原文從該曲線中強調了兩個點:
生產任務的確切成本會因提示詞長度、輸出長度、快取與工具使用情況而異,但整體趨勢十分重要。
現在,你可以根據工作內容調整 Haiku,而不必再把「小模型」視為只有一個固定能力等級。
GDPval-AA v2.1 衡量涵蓋 44 種職業的真實專業工作能力。
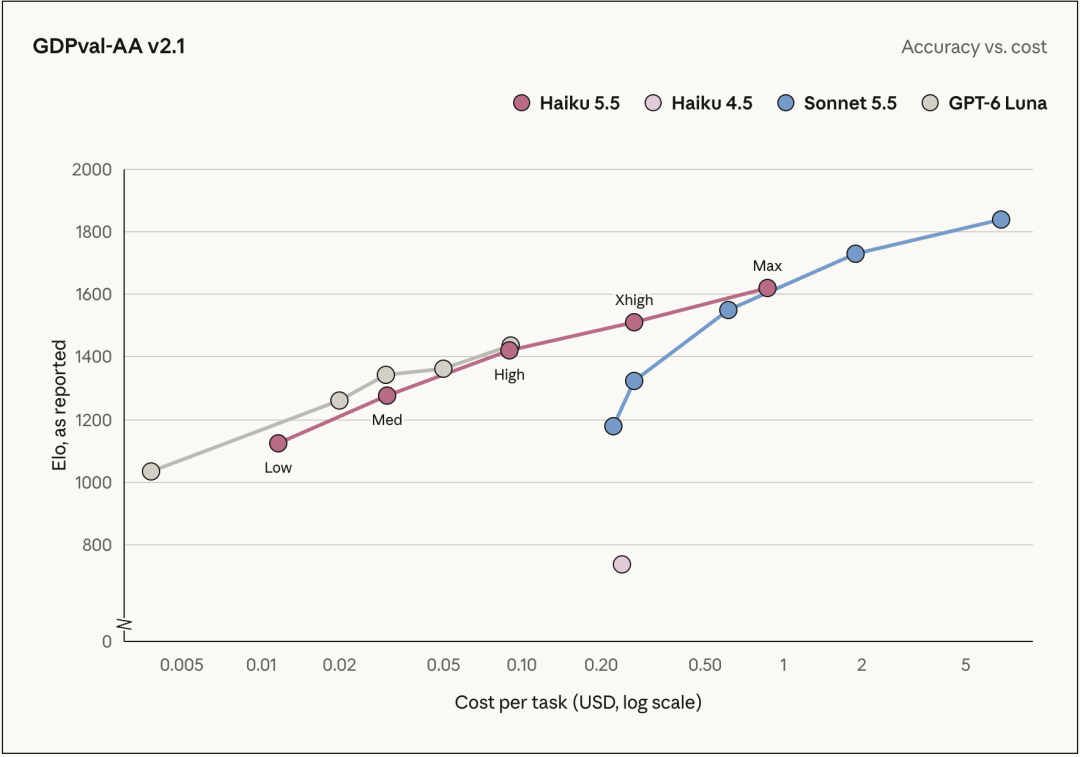
Anthropic 報告稱,在最高努力程度下,Haiku 5.5 的 Elo 為 1620,而 Haiku 4.5 為 735。
同樣地,Sonnet 5.5 仍然更強,但「小模型」與「具備專業使用價值」之間的距離已大幅縮小。
Haiku 5.5 引入了與新一代 Claude 共享的新分詞器。
這一點很重要,因為相同文字在 Haiku 4.5 與 Haiku 5.5 上不會產生相同的 Token 數量。
Anthropic 的遷移指南指出,相同輸入文字在 Haiku 5.5 上產生的 Token 約比 Haiku 4.5 多 30%,但實際增幅取決於內容。
影響可能因工作負載而更大或更小,其中程式碼、表格與非英語文字尤其值得重新測量。
因此,以下比較過於簡化:
舊輸入價格:$1.00
新輸入價格:$0.10
因此每項任務都確切便宜 90%
更好的計算方式是:
實際任務成本
= 新 Token 數量
× 新 Token 價格
+ 快取成本
+ 輸出成本
+ 工具成本
Anthropic 自身表示,在將分詞器變更納入計算後,Haiku 5.5 平均比 Haiku 4.5 便宜約 75%,而不是每項任務都一律降低 90%。
Artificial Analysis 也展示了,在比較低成本模型時,Token 效率為何十分重要。
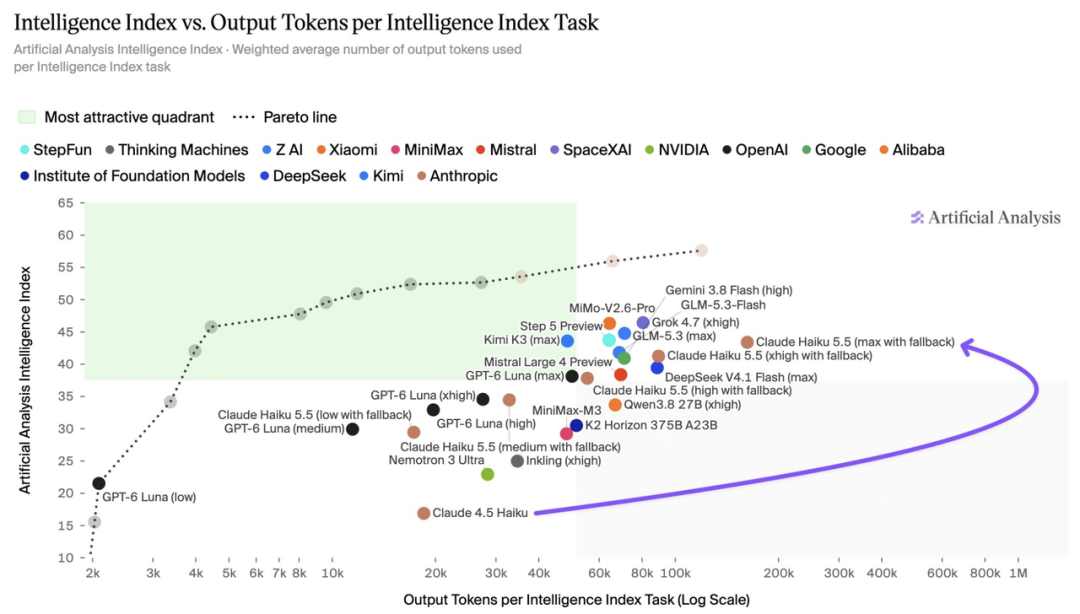
某個模型的 Token 價格可能很低,但完成同一項任務時,也可能需要產生更多輸出 Token。
對生產系統而言,每個已完成任務的成本比單獨查看每百萬 Token 的價格更有參考價值。
原文清楚指出了這一點:「小杯子」仍然是小杯子。
Haiku 5.5 比 Haiku 4.5 強大得多,但複雜的自主程式設計仍然是更大型模型的工作。
Terminal-Bench 4.0 顯示了兩者的差距:
Haiku 5.5:  39.2%
Sonnet 5.5:70.6%
Anthropic 明確建議,對於複雜的 Agent 式程式設計,應使用 Sonnet 5.5 或 Opus 5.5。
Haiku 5.5 更適合已經明確界定的任務:
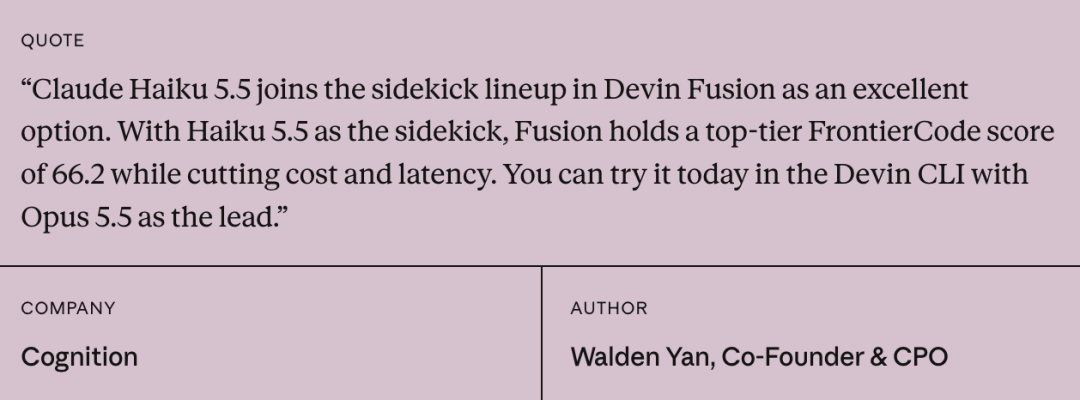
Cognition 已經在 Devin Fusion 中採用這種結構。
發布頁面表示,Opus 5.5 可以擔任主導模型,而 Haiku 5.5 則作為輔助模型工作。
在 Cognition 回報的配置中,這種組合取得了 66.2 的 FrontierCode 分數,同時降低了成本與延遲。
這種模式十分直接:
Opus / Sonnet
→ 規劃、拆解、困難判斷

Haiku 5.5
→ 狹窄子任務、平行執行、快速查詢、摘要
與其試圖在所有地方取代更大型模型,這可能是使用 Haiku 5.5 更現實的方式。
如果應用程式已經使用 Haiku 4.5,Anthropic 提醒,幾項變更可能導致現有請求失效。
官方模型 ID 現在是:
claude-haiku-5-5
但遷移還有幾項額外要求。
以下 Haiku 4.5 請求格式不再有效:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
Haiku 5.5 改用自適應思考與努力程度控制:
{
  "thinking": {
    "type": "adaptive"
  },
  "output_config": {
    "effort": "medium"
  }
}
傳送舊版 budget_tokens 格式的請求會返回 400 錯誤。
自適應思考也預設啟用,因此應用程式不應假設第一個回應內容區塊永遠是一般回答文字。
請依照 type 解析各個區塊。
max_tokens由於新的分詞器會將相同文字計算為更多 Token,舊的 max_tokens 值可能不足以容納等量輸出。
思考 Token 也會計入輸出預算。
請使用 claude-haiku-5-5 重新計算提示詞,而不要繼續沿用 Haiku 4.5 的 Token 估算值。
Haiku 5.5 不再以 Haiku 4.5 的方式支援任意取樣設定。
Anthropic 建議省略:
temperature
top_p
top_k
非預設值可能導致 400 錯誤,而 top_k 不被接受。
如果應用程式過去使用取樣參數來製造創意變化,應將這項控制移至提示詞或其他應用程式層級策略。
在某些配置中,Haiku 4.5 可以從最後一則 Assistant 訊息繼續生成。
Haiku 5.5 會拒絕 Assistant 預填。
如果過去使用以下前綴來強制輸出 JSON:
{"result":
請改用結構化輸出或工具 Schema。
對於 Claude API 與 Google Cloud 整合,舊版電腦操作宣告:
computer_20250124
必須更新為:
computer_toolset_20260801
新的工具組具有不同的事件結構,因此 Agent 迴圈必須正確分派返回的工具使用區塊,並在結果中保留 toolset_name。
Haiku 5.5 也支援 Anthropic 的瀏覽器使用工具組,可在支援的平台上執行網頁任務。
在部署 Haiku 5.5 之前,至少檢查以下項目:
claude-haiku-5-5。budget_tokens 思考替換為自適應思考與努力程度設定。type 解析內容區塊,不要假設第 0 個區塊就是回答文字。computer_toolset_20260801。refusal 停止原因。Anthropic 也提供自動化的 Claude Code 遷移指令:
/claude-api migrate this project to claude-haiku-5-5
該工具可以套用模型 ID 變更,並偵測幾種不相容的請求模式,但仍建議進行人工驗證。
Haiku 5.5 並不是 Anthropic 宣布的唯一定價變更。
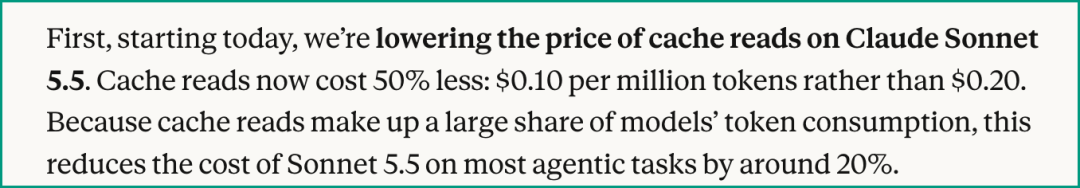
Sonnet 5.5 的快取讀取價格從:
$0.20 / 100 萬 Token
降至:
$0.10 / 100 萬 Token
Anthropic 表示,在許多 Agent 工作流程中,快取讀取占 Token 消耗的很大一部分,因此這項變更可使大多數 Sonnet 5.5 Agent 任務的成本降低約 20%。
這讓混合模型架構更具吸引力:
Sonnet 5.5
→ 規劃與較困難的執行

Haiku 5.5
→ 低成本的大量子任務
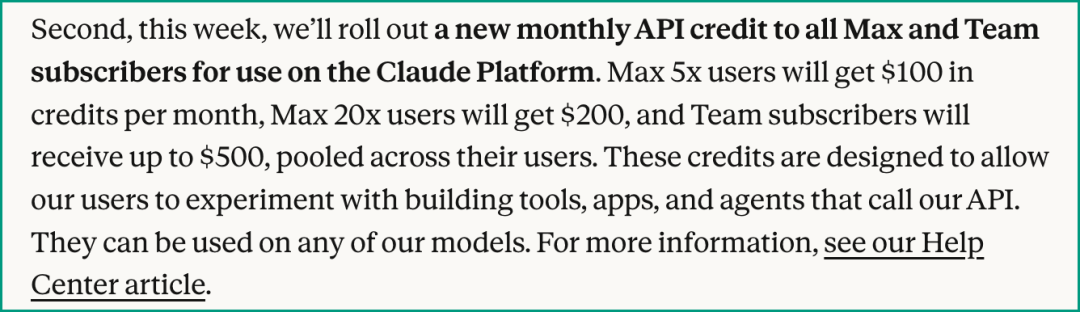
Anthropic 也為符合資格的 Max 與 Team 訂閱者推出每月 Claude Platform 額度。
目前官方額度如下:
| 方案 | 每月 API 額度 |
|---|---|
| Max 5x | $100 |
| Max 20x | $200 |
| Team Standard 座席 | 每座席 $20 |
| Team Premium 座席 | 每座席 $100 |
| Team 共用上限 | $500 |
這些額度可用於 Claude Platform 工作負載,例如:
這些額度不會提高使用者的 Claude 或 Claude Code 訂閱使用上限;如果一般互動式 Claude Code 工作階段是透過訂閱方案計費,也不會涵蓋這些工作階段。
額度會綁定至單一 Claude Console 組織,且不會無限期累積。
原文以較輕鬆的比較作結。
Anthropic 宣布更便宜的模型、更低的 Sonnet 快取讀取價格與每月 API 額度之際,OpenAI Codex 與 ChatGPT Work 負責人 Thibault Sottiaux 宣布,付費帳戶再次獲得一次 可累積的重置額度,同時慶祝 Codex 與 ChatGPT Work 的活躍使用者達到 4,000 萬。
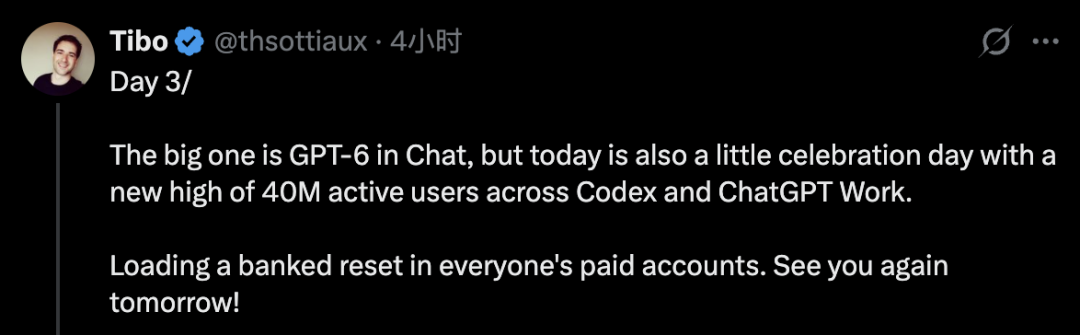
可累積的重置額度不同於永久性降價。
它是符合資格的使用者可以儲存並兌換的額外使用量重置,而不是模型持續 Token 定價的變更。
因此,這項比較在修辭上多於技術層面:
Anthropic 發布:
新小模型 + 更低的快取價格 + 每月 API 額度

OpenAI 更新:
付費 Codex / Work 帳戶的額外可累積使用量重置
兩者都試圖讓高頻使用者擁有更多試驗空間,但採用的是不同機制。
這次發布讓 Haiku 更加實用,但其理想角色仍然相對清晰。
可將 Haiku 5.5 用於:
以下情況應優先使用更大型的 Claude 模型:
最便宜的模型不一定是完成任務的最低成本方式。
對生產系統而言,請衡量:
每個成功任務的成本
=
輸入 + 快取 + 輸出 + 工具使用 + 重試 + 失敗
這項指標比模型的標示輸入價格更能說明問題。
Claude Haiku 5.5 是 Anthropic 最新的小型 Claude 模型,針對高使用量、成本敏感與延遲敏感的工作負載推出。它也是第一個支援可調整努力程度的 Haiku 模型,在程式設計、電腦操作與專業工作評測方面,明顯強於 Haiku 4.5。
對於不超過 100K Token 的提示詞,每百萬輸入 Token 收費 $0.10,每百萬輸出 Token 收費 $0.50。對於超過 100K Token 的提示詞,價格提高至每百萬輸入 Token $0.50、每百萬輸出 Token $2.50,快取讀取與快取寫入則另有價格。
以標準短上下文 Token 定價而言,兩者的標示輸入、快取輸入、快取寫入與輸出費率基本一致。Haiku 5.5 在提示詞超過 100K Token 後會提高價格,因此長上下文工作負載應分開比較。
不會。Anthropic 自行公布的 Terminal-Bench 4.0 結果顯示,Sonnet 5.5 為 70.6%,Haiku 5.5 為 39.2%。Haiku 更適合狹窄、可重複且高使用量的任務與子 Agent 工作,而 Sonnet 與 Opus 仍更適合複雜的自主程式設計。
Haiku 5.5 使用新的分詞器。Anthropic 的遷移指南表示,相同文字在 Haiku 5.5 上平均會產生約多 30% 的 Token,但實際增幅取決於內容。
需要。重要變更包括:以自適應思考取代手動 budget_tokens、調整取樣參數行為、移除 Assistant 預填、使用新的電腦操作工具組,以及依照 type 解析回應區塊。Anthropic 提供官方遷移指南與 Claude Code 遷移指令。
在 Claude API 上,模型 ID 是 claude-haiku-5-5。Anthropic 也為 Amazon Bedrock、Google Cloud、Microsoft Foundry 與 AWS 上的 Claude Platform 記錄了相應的 ID。
符合資格的 Max 與 Team 訂閱者可以申請每月 Claude Platform 額度。Max 5x 可獲得 $100,Max 20x 可獲得 $200;Team 額度則依座席類型計算,每月共用上限為 $500。
Claude Haiku 5.5 是 Anthropic 小模型層級的一次重大升級。它在電腦操作、專業工作、程式設計與推理方面大幅超越 Haiku 4.5,同時與 GPT-6 Luna 的短上下文標示 API 定價相當,並在 Anthropic 公布的多項基準比較中擊敗 Luna。
較低價格確實存在,但生產團隊不應忽略新的分詞器或 100K 提示詞定價邊界。相同文字可能比在 Haiku 4.5 上多消耗約 30% 的 Token,而長提示詞則會使用更高的定價層級。
遷移也包含真正的重大變更:自適應思考取代手動思考預算;自訂取樣控制受到限制;Assistant 預填被移除;電腦操作整合需要使用新的工具組。現有的 Haiku 4.5 應用程式應遵循遷移指南,而不是只更換模型名稱。
Haiku 5.5 最適合被理解為一個面向規模化與子 Agent 的快速、低成本執行模型,而不是 Sonnet 或 Opus 在複雜長期任務上的通用替代品。
從一句話開始,幾分鐘內拿到完整網站。



