For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
一個新的 Z.ai 模型名稱已悄然出現在 ZCode 中:**GLM-5.3 Highspeed**。
一個新的 Z.ai 模型名稱已悄然出現在 ZCode 中:GLM-5.3 Highspeed。
該模型在 ZCode 3.15.1 中浮現,部分訂閱者正被隨機選中參與 HighSpeed 試用。一名使用者 @leo114119 發布了一次執行結果,顯示輸出速度接近 每秒 490 個 Token,另一張截圖則顯示約 493 tok/s。
這是一個引人注目的數字。
若模型能持續維持每秒輸出 490 個 Token,生成 10,000 個輸出 Token 僅需約:
10,000 / 490 ≈ 20.4 秒
此計算僅涵蓋 Token 生成階段,未包括首個 Token 的時間、可見輸出前的推理、工具呼叫、網路額外負擔,或 Agent 工作流程中的停頓。
更重要的是,490 TPS 的結果目前仍是社群觀察,並非 Z.ai 官方保證的吞吐量。
可以確認的是,ZCode 3.15.1 已為訂閱者推出隨機 GLM HighSpeed 試用,而 glm-5.3-highspeed 識別碼已出現在 Pi 的公開模型目錄中。
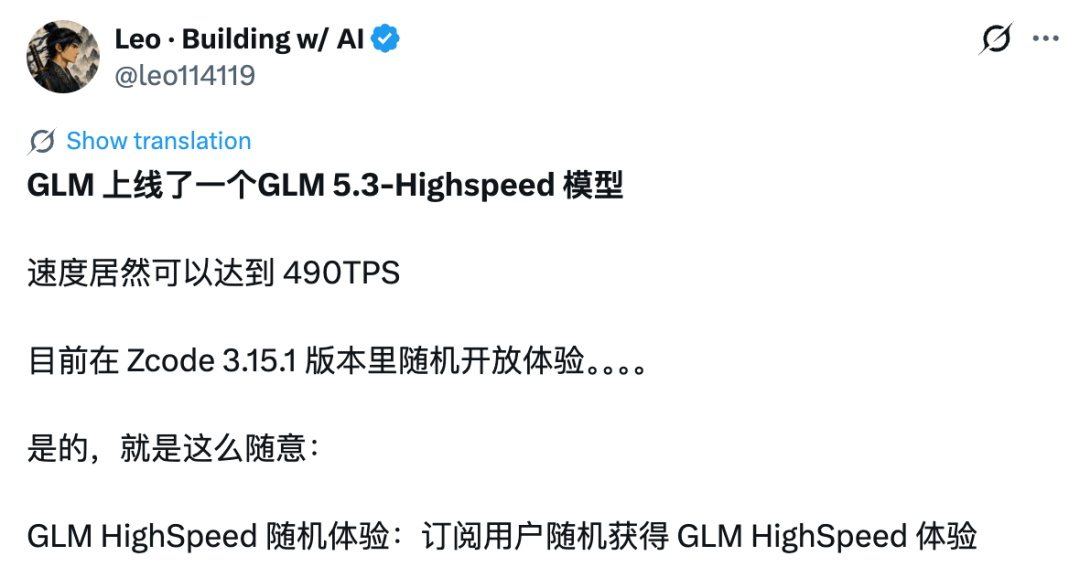
第一個線索不只是社群媒體截圖。
ZCode 3.15.1 的官方版本說明指出:
訂閱者現在可能被隨機選中參與 GLM HighSpeed 試用。
此措辭很重要,因為它解釋了為何不同帳號的存取權限並不一致。
來源文章指出,作者曾嘗試手動新增並切換至 GLM-5.3 Highspeed,但使用 Lite 訂閱方案時無法使用。
介面顯示模型確實存在,但目前方案並未包含存取權限。
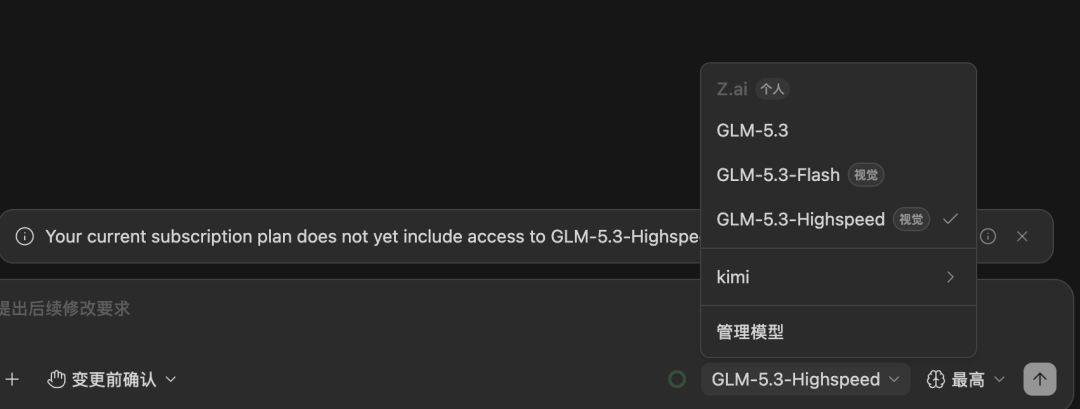
這與 ZCode 目前的推出策略一致:
更新至 ZCode 3.15.1
        ↓
訂閱者帳號
        ↓
隨機取得 HighSpeed 試用資格
        ↓
若被選中,客戶端中將出現試用存取權
目前並未將其描述為每一個付費方案都會自動取得的功能。
一張整理 ZCode 原始措辭的社群截圖也傳達了相同重點:HighSpeed 體驗是隨機分配給訂閱者的權益,而客戶端才是確認特定帳號是否被選中的依據。
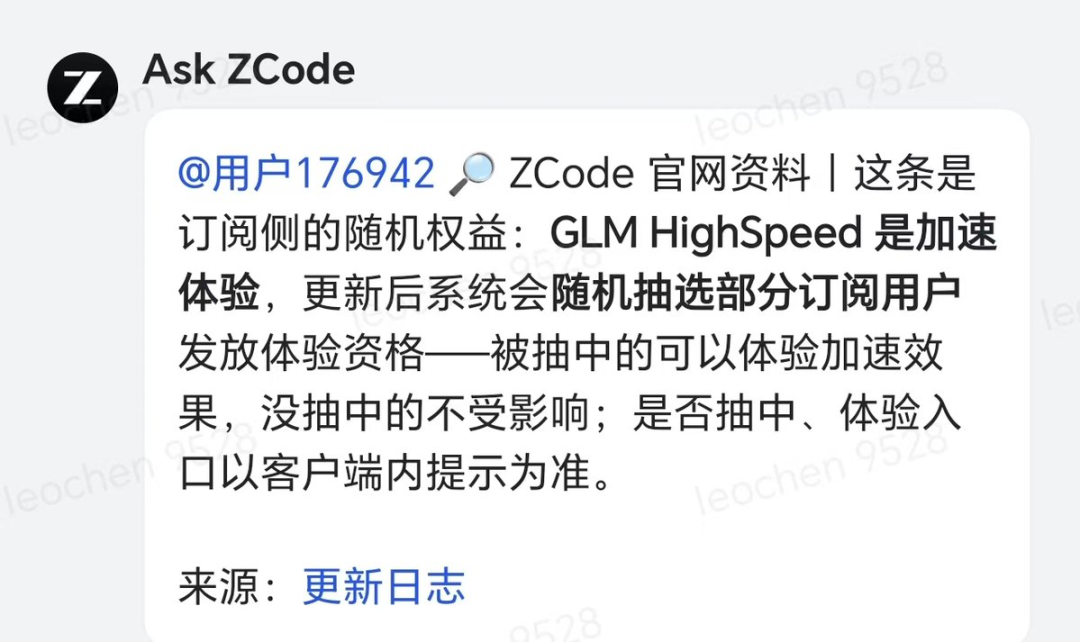
此模型受到關注的最大原因,是速度截圖。
來源使用者發布的一次執行結果顯示約 493 tok/s。
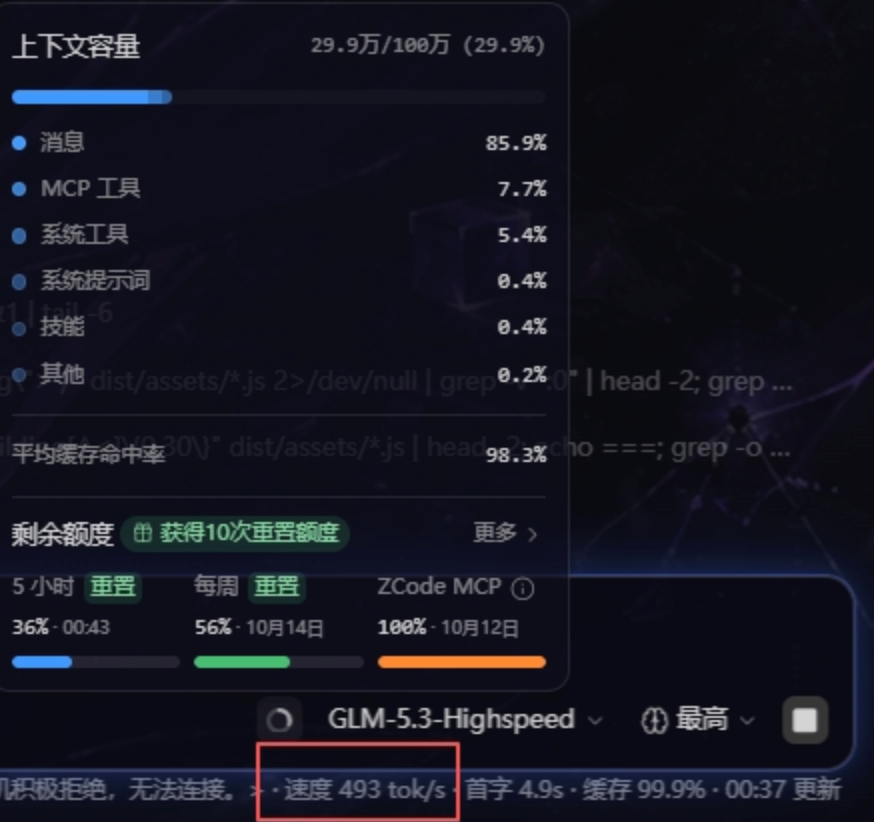
這與文章標題中的 490 TPS 已足夠接近,差異並不具實質意義。
但仍應精確理解這張截圖揭示了什麼,以及沒有揭示什麼。
GLM-5.3-Highspeed 的 ZCode 工作階段。吞吐量可能高度取決於:
因此,目前較正確的結論是:
GLM-5.3 Highspeed 至少已在一項公開 ZCode 測試中展現極高的輸出吞吐量,但 Z.ai 尚未發布正式的 490 TPS 規格。
這個數字之所以突出,是因為 GLM 系列本身已具備多種以速度為導向的服務選項。
Z.ai 的文件指出,GLM-5.3-FlashX 最快可達 每秒 200 個 Token。FlashX 是 GLM-5.3-Flash 的高速服務變體。
Pi 與 Z.ai 文件列出,GLM-5.3-Flash 具備 100 萬 Token 上下文視窗及約 128K 的最大輸出,而 FlashX 專注於降低服務延遲並加快生成速度。
原始文章亦引用 Artificial Analysis 的測量結果:在撰文時,GLM-5.3-Flash 在 Z.ai 第一方 API 上的速度約為每秒 60 個 Token。
獨立吞吐量測量會隨時間變動,後續快照會因供應商與日期不同而產生明顯差異,因此不應將單一數字視為永久不變。
因此,一個有用的比較如下:
| 模型/服務路徑 | 已回報或已記錄的速度 | 狀態 |
|---|---|---|
| ZCode 中的 GLM-5.3 Highspeed | 使用者截圖顯示約 490–493 tok/s | 社群觀察/隨機試用 |
| GLM-5.3-FlashX | 最快可達 200 tok/s | 公開記錄的速度導向變體 |
| Z.ai API 上的 GLM-5.3-Flash | 獨立第一方快照中的速度明顯較低 | 獨立測量會因日期/供應商而異 |
差距之大,足以讓人自然想知道「Highspeed」實際代表什麼。
glm-5.3-highspeed該模型名稱並非只出現在 ZCode 中。
Pi 的公開模型目錄已經有 GLM-5.3 Highspeed 的頁面。
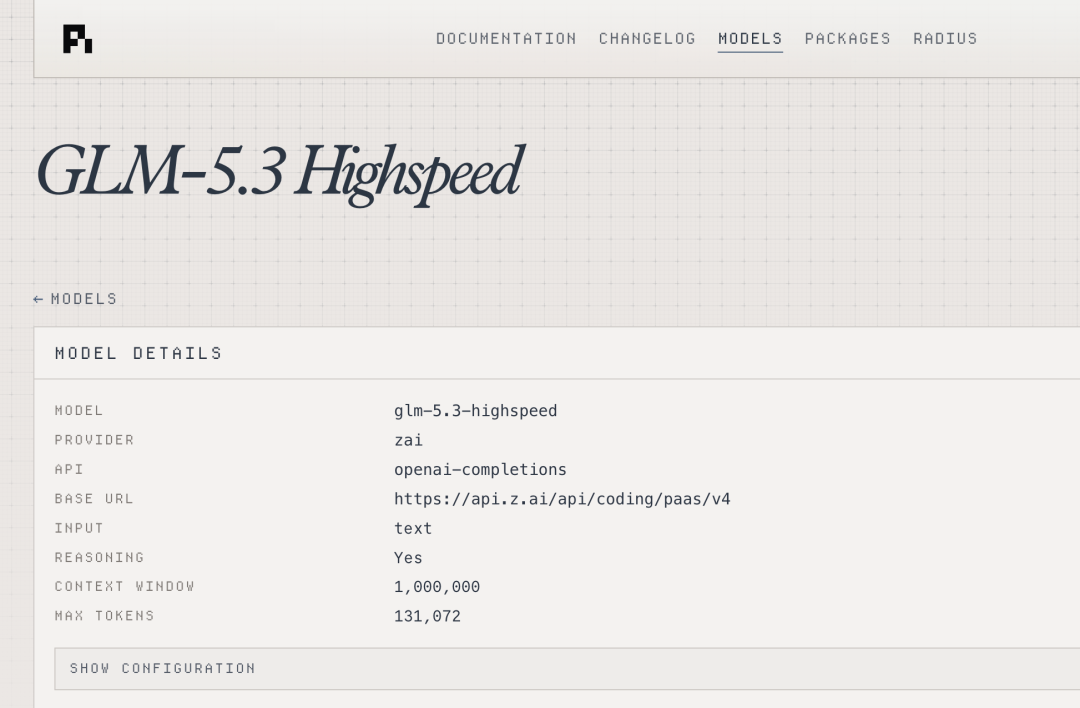
列出的設定如下:
| 欄位 | 值 |
|---|---|
| 模型 ID | glm-5.3-highspeed |
| 供應商 | zai |
| API 風格 | 相容 OpenAI 的 completions |
| 輸入 | 文字 |
| 推理 | 是 |
| 上下文視窗 | 1,000,000 個 Token |
| 最大輸出 | 131,072 個 Token |
| 推理等級 | low / high / max |
Pi 顯示的端點為:
https://api.z.ai/api/coding/paas/v4
Pi 也將此模型對應至 Z.ai 的程式設計 API 格式。
其中兩個細節尤其值得注意。
這與目前 GLM-5.3 系列工具中的長上下文設定一致。
對程式設計 Agent 而言,100 萬 Token 上下文可用於:
這約等於 128K 個 Token。
同樣地,這與多個 GLM-5.3 系列項目目前的長輸出設定一致。
因此,Pi 的列表並未顯示 Highspeed 具有與一般 GLM-5.3 系列明顯不同的上下文架構。
它主要確認了 Highspeed 識別碼確實存在,且已具備結構化的供應商設定。
Pi 對應了三個可用的推理設定:
low
high
max
來源文章指出,這些設定也常見於一般 GLM-5.3 設定。
這又提供了一個理由,說明不應假設 Highspeed 是一個完全新的基礎模型。
它可能是:
在 Z.ai 發布模型卡之前,無法有把握地區分這些可能性。
僅憑名稱並不足以判定。
故事在此進入推測階段。
在 ZCode 截圖出現之前,Reddit 使用者已在 Pi 的目錄中注意到 glm-5.3-highspeed,並詢問它是否可能與 Omen Alpha 有關。
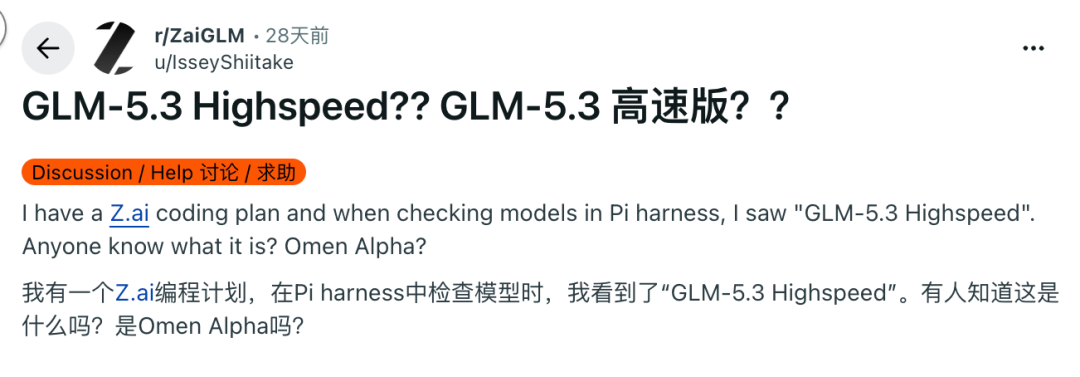
Omen Alpha 是一個出現在 OpenCode 測試中的匿名模型。
社群成員先前已根據觀察到的行為與基礎設施線索,將它與智譜/Z.ai 聯繫起來。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
一則 Reddit 回覆推測,它可能是一個新的高速 GLM 變體,品質接近 GLM-5.3-Flash,但吞吐量高得多。
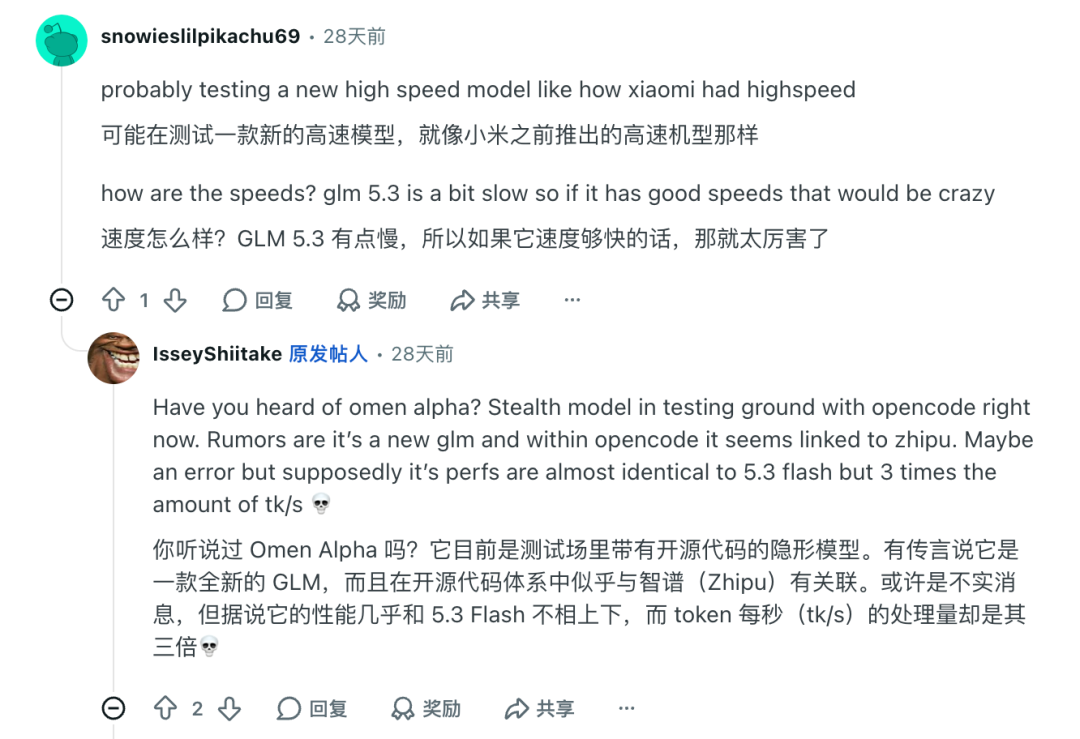
另一張來源截圖顯示,一個 omen-alpha 模型項目連結至帶有智譜關聯的供應商標籤,這進一步助長了該理論。
但這些資訊都無法確定其身分。
原始文章列出多種猜測:
在 Z.ai 發布官方對應關係前,這些名稱都應停留在社群推測的範疇。
即使兩個端點感覺非常相似,也不代表它們必定是同一個模型。
觀察到的行為可能受到以下因素影響:
因此,行為相似可作為證據,但不是證明。
對智譜而言,這個名稱本身並不罕見。
該公司先前曾推出 GLM 模型的高速版本。
來源文章提及 GLM-5.1-highspeed,該模型於 2026 年 5 月宣傳時的輸出速度約為每秒 400 個 Token。
較新的 GLM-5.3 系列也有 FlashX,這是一個公開的速度導向變體,文件記錄其速度最快可達 200 tok/s。
這顯示了一種更廣泛的產品模式:
基礎模型或旗艦模型
        ↓
高速服務路徑
        ↓
為互動型工作負載提供更低延遲/更高吞吐量
即使不假設存在新的模型權重,這種模式也使 GLM-5.3 Highspeed 產品在技術上具有合理性。
不過,這仍屬推論,並非官方產品描述。
為何要在意 490 TPS?
對只有 200 個 Token 的短回答而言,100 TPS 與 500 TPS 的差異只有幾秒。
對於長 Agent 輸出、程式碼生成或冗長推理,差異就會大得多。
例如:
| 輸出長度 | 100 tok/s | 200 tok/s | 490 tok/s |
|---|---|---|---|
| 1,000 個 Token | 10.0 秒 | 5.0 秒 | 約 2.0 秒 |
| 5,000 個 Token | 50.0 秒 | 25.0 秒 | 約 10.2 秒 |
| 10,000 個 Token | 100.0 秒 | 50.0 秒 | 約 20.4 秒 |
這些僅是簡化的解碼時間計算。
實際 Agent 任務還包括:
不過,更快的解碼速度仍能讓長時間的迭代工作流程顯得更即時。
這對 ZCode 等程式設計 Agent 尤其重要,因為使用者的一次請求可能會產生多個模型呼叫,而非只有一個最終回答。
約 493 tok/s 的截圖也顯示出極高的快取命中率。
這一點值得注意。
在長 Agent 工作階段中,高快取命中率可減少重複處理提示詞所需的工作量。
一個典型的程式設計工作階段可能重複攜帶:
系統指令
+ 程式碼儲存庫上下文
+ 工具定義
+ 先前對話
+ 最近的差異內容
若大量上下文能被有效重用,系統就能減少每一輪重新計算輸入端的時間。
不過,顯示的 tok/s 數值通常指的是輸出生成吞吐量,而非僅指提示詞快取吞吐量。
快取數字依然重要,因為在提示詞重用與快速解碼同時良好運作時,整體工作階段延遲可能會明顯改善。
這也是為何一張截圖無法完整描述該模型的原因。
GLM-5.3-FlashX 提供了最清楚的公開比較,因為 Z.ai 文件已將其描述為速度導向模型。
目前公布的 FlashX 資訊包括:
glm-5.3-flashx。因此,FlashX 證明了 Z.ai 已經願意建立專用的高吞吐量變體,而不將其描述為全新的智慧世代。
GLM-5.3 Highspeed 可能以更快的服務層級遵循相同產品邏輯。
這仍是一項推論,並非官方確認。
現有證據可區分為三個信心層級。
glm-5.3-highspeed 列為 Z.ai 模型。這樣的區分,是解讀目前推出情況最穩妥的方法。
GLM-5.3 Highspeed 是一個已出現在 ZCode 與 Pi 公開模型目錄中的 Z.ai 模型識別碼。ZCode 3.15.1 已正式確認面向訂閱者的隨機 GLM HighSpeed 試用,但在本文查核的來源中,Z.ai 尚未發布 GLM-5.3 Highspeed 的完整獨立模型卡。
一張公開使用者截圖顯示,在一次 ZCode 執行中速度約為 493 tok/s,這正是 490 TPS 標題的依據。這是一項有參考價值的觀察,但不是官方保證的持續吞吐量,且可能隨工作負載、快取行為、地區與伺服器狀況而變化。
Pi 目前為 glm-5.3-highspeed 列出 1,000,000 個 Token 的上下文視窗與 131,072 個 Token 的最大輸出。這些數值與其他目前 GLM-5.3 系列模型的長上下文設定相近。
不能。ZCode 官方 v3.15.1 更新日誌指出,訂閱者是被隨機選中參與 GLM HighSpeed 試用。若你的帳號未被選中,即使看到模型名稱,也不一定代表可以執行它。
目前沒有官方確認兩者是相同產品。FlashX 是 GLM-5.3-Flash 的公開高速變體,文件記錄速度最快可達 200 tok/s;GLM-5.3 Highspeed 則目前透過 ZCode 試用與 Pi 的程式設計供應商目錄出現。
這仍屬推測。Reddit 與 OpenCode 使用者曾將 Omen Alpha 與智譜/Z.ai 連結,但沒有官方來源確認 Omen Alpha 對應至 glm-5.3-highspeed。
程式設計 Agent 在讀取檔案、撰寫修補程式、執行工具與審查結果時,通常會進行多次長模型呼叫。更高的解碼吞吐量可縮短這些步驟之間的等待時間,尤其在模型每次呼叫會輸出數千個 Token 時。
請將 ZCode 更新至包含該試用功能的版本後,使用最新的 ZCode 客戶端查看。ZCode 自身的版本說明表示,存取權會隨機分配給訂閱者,因此帳號/客戶端介面是確認資格最實際的依據。
glm-5.3-highspeed 的供應商設定。GLM-5.3 Highspeed 已不再只是一個零星出現的模型名稱:ZCode 3.15.1 已正式確認面向訂閱者的隨機 GLM HighSpeed 試用,而 Pi 也已公開結構化的 glm-5.3-highspeed 設定,包括 100 萬 Token 上下文視窗與 131,072 Token 輸出上限。
吸睛的 490–493 tok/s 數字來自真實公開截圖,但它仍是使用者觀察,而非 Z.ai 的正式吞吐量保證。目前最穩妥的解讀是,Z.ai 正在測試一條速度極快的程式設計服務路徑,尚未公布完整的產品規格。
Omen Alpha 的關聯仍未解決。它未來可能被證實有關,但現有證據屬於間接且由社群驅動,而非官方資訊。
目前已確認的是推出安排與模型識別碼;尚未確認的是確切架構、公開定價、持續吞吐量,以及 Omen Alpha 是否為同一模型。
從一句話開始,幾分鐘內拿到完整網站。



