For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/gpt-6-1-sol-500k-context-codex-usage-and-f5e586e1.md.
長時間的程式設計工作階段累積的不只是聊天訊息。代理還需要容納原始碼檔案、命令輸出、測試失敗結果,以及任務稍早階段所做出的決策。當這些工作上下文填滿時,代理必須先將其壓縮,才能繼續執行。
長時間的程式設計工作階段累積的不只是聊天訊息。代理還需要容納原始碼檔案、命令輸出、測試失敗結果,以及任務稍早階段所做出的決策。當這些工作上下文填滿時,代理必須先將其壓縮,才能繼續執行。
中國 AI 新聞媒體新智元在 BAAI Hub 轉載的一篇報導指出,GPT-6.1 Sol 在 Codex 與 ChatGPT Work 中的預設上下文,已從 272K token 提升至 500K token。該報導將這項公告歸因於 OpenAI 的 Thibault Sottiaux,並稱此變更取消了訂閱使用情境下獨立的長上下文附加費。這比原始標題所暗示「升級完全免費」的說法更為具體。
OpenAI 的官方文件確認 GPT-6.1 Sol 可供使用,並說明使用量的計算方式。以下有關確切 500K 變更與附加費公告的內容,仍歸因於所引用的報導及公告截圖;本文章查閱的官方文件頁面並未獨立明示這項新的預設值。
從 272,000 提升至 500,000 token,容量約增加 84%。來源將此四捨五入為約 80%。其公告截圖也提到最大上下文可達 100 萬 token,並表示使用者可以覆寫預設值。
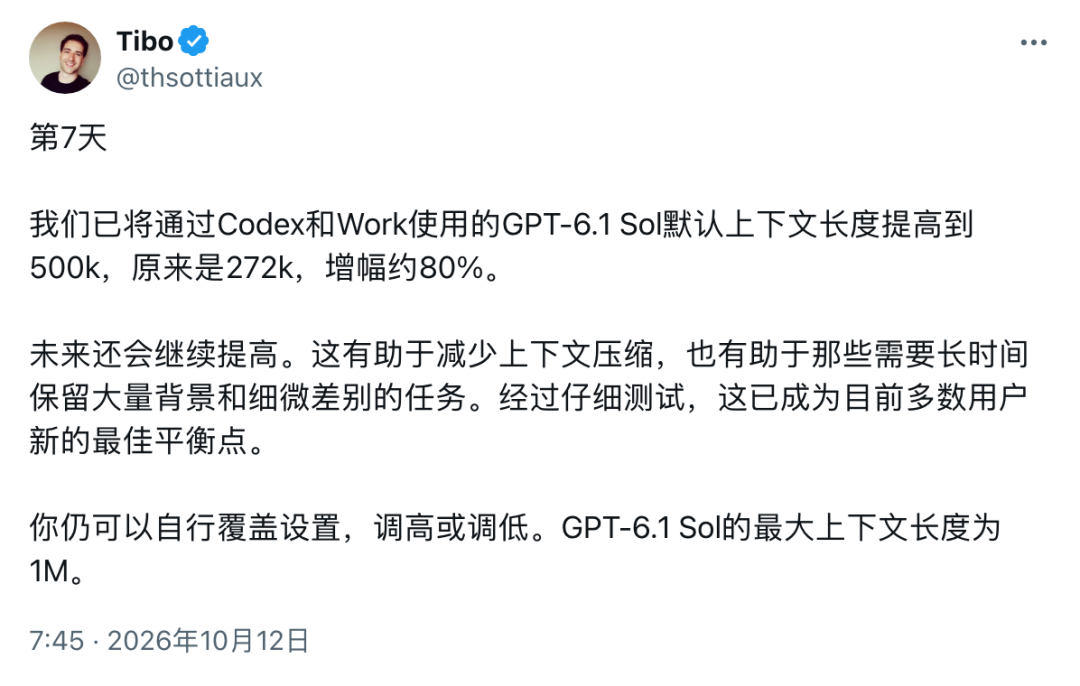
來源:新智元在 BAAI Hub 上轉載的 Thibault Sottiaux 公告中文截圖;英文描述由編輯撰寫。
實際好處是,在需要進行壓縮前,可以保留更多任務歷史於可用狀態。對於一項程式庫變更而言,這些內容可能包括原始相容性需求、已檢查過的檔案、失敗的嘗試方式,以及最新測試結果。
更大的視窗並不能保證代理會記住每一項需求,或做出正確變更。它改變的是可保留於活動上下文中的資訊量,而其決策品質仍需要檢查。
壓縮會以較短的表徵取代部分累積歷史。這讓代理無須完整保留每一行早期工具輸出,也能繼續工作。
其中的取捨是,經過濃縮的歷史可能遺失有用細節。一項程式設計任務看似已完成,卻可能漏掉較早提出的需求,例如保留舊版 API 回應格式。保留更多相關上下文,可能減少這類轉換的發生頻率,但並不會消除進行回歸測試的必要性。
OpenAI 的設定參考文件記錄了 model_context_window 與 model_auto_compact_token_limit。這是不同設定:前者描述模型可用的上下文,而後者決定何時觸發自動壓縮。這些設定的存在,並不表示每個模型或帳戶都支援相同數值。
來源區分了長上下文附加費與一般訂閱用量。即使因為上下文較長而不會套用特定的額外倍率,任務仍可能消耗額度。
OpenAI 的官方定價文件支持這項更廣泛的區分。文件指出,使用量取決於模型選擇、上下文、推理、工具使用、檢索與快取。保留更多資訊的長任務,可能比簡短、聚焦的請求消耗更多額度。
| 概念 | 說明 |
|---|---|
| 上下文容量 | 模型在一次請求或工作階段期間可容納的資訊量 |
| 訂閱使用量 | 任務如何消耗包含在方案中的額度或點數 |
| 快取輸入 | 先前已處理、可能以不同費率重複使用的輸入內容 |
| API 定價 | 透過 API 金鑰驗證與付費時所產生的獨立費用 |
像「繼續」這樣的簡短後續訊息,也可能導致另一次大量模型請求。代理可能需要先前的檔案、需求與工具結果,才能判斷下一步要做什麼。快取輸入的處理成本可能較低,但不一定不計入使用量。
來源也提到,先前曾將上下文提高至 372K,後來因訂閱使用量高於預期而回復原狀。這段說明有助於理解該公告的背景,但不應被解讀為目前的計費規則,也不是對任何單一任務成本的承諾。
來源將這項報導中的新預設值,與 Claude Code 的百萬 token 設定進行比較。一項有用的比較,不能只看模型卡上最大的數字:預設值、壓縮閾值、帳戶存取權限、定價,以及周邊代理軟體都可能不同。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
本文未針對來源所述的特定 Claude 模型限制與壓縮閾值,另外查核 Anthropic 文件。因此,這些資訊不應被視為目前的設定建議。
在日常工作中,請一併檢查以下三件事:
OpenAI 的官方模型指南也指出,可用性取決於方案、用戶端、推出進度與工作區設定。一項容量公告不會讓原本無法使用的模型自動獲得存取權限。
GPT-6.1 Sol 是 OpenAI 文件中針對程式碼、應用程式與文件等複雜工作所記錄的一個模型。官方指南將其描述為以較低成本提供接近 Astra 的效能,其可用性則取決於使用者的方案與用戶端。
這表示在該設定下,模型可以處理約 500,000 token 的上下文。Token 不只包含使用者最新的訊息,因此檔案、任務歷史、工具輸出與回應都可能納入其中。
來源報導指出,訂閱使用情境下不會收取獨立的長上下文附加費;這與不限量存取不同。任務仍會消耗適用額度,而 GPT-6.1 Sol 的存取權限取決於方案與推出進度。
它能透過提供更多可用空間,延後壓縮發生的時間。足夠長的工作階段仍可能達到上限,而設定的壓縮閾值也會影響何時進行濃縮。
不同。OpenAI 明確表示,API token 定價與訂閱使用量是分開的,不應以 API 價格估算包含在訂閱中的任務數量。
不應只因報導提到較大的設定就這樣做。請先檢查支援的模型與設定,接著在具代表性的任務上比較完成品質、延遲與使用量,再調整日常設定。
報導中的 500K 預設值,讓 GPT-6.1 Sol 在 Codex 與 Work 中有更多空間容納檔案、需求與工作歷史。其最明確的潛在好處,是在長任務期間減少壓縮造成的中斷。
更大的上下文容量很有用,但它不會消除訂閱限制、API 費用,或檢查最終結果的必要性。
從一句話開始,幾分鐘內拿到完整網站。



