For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/gpt-6-speed-boost-astra-and-6-1-sol-gain-90356630.md.
OpenAI 已啟動為期 28 天的產品改進計畫,並帶來使用者可立即感受到的變化:透過符合資格的 ChatGPT 訂閱使用時,**GPT-6 Astra 與 GPT-6.1 Sol 的預設速度現已提高約 50%**。
OpenAI 已啟動為期 28 天的產品改進計畫,並帶來使用者可立即感受到的變化:透過符合資格的 ChatGPT 訂閱使用時,GPT-6 Astra 與 GPT-6.1 Sol 的預設速度現已提高約 50%。
此改進適用於支援 使用 ChatGPT 登入 的 OpenAI 產品與合作夥伴工具,包括 OpenCode、Pi、Amp 與 Devin。
無需變更任何程式碼。
OpenAI 工程主管 Thibault「Tibo」Sottiaux 表示,預設訂閱速度已最佳化約 50%。社群測量顯示,實際提升約從 每秒 30 個 Token 提高至每秒約 50 個 Token,但確切吞吐量會隨模型、任務、產品與執行環境而有所不同。
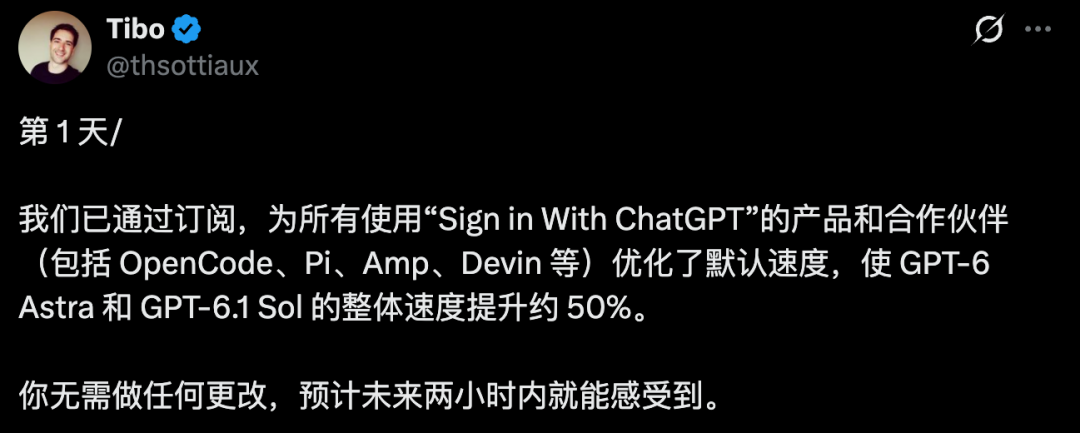
Tibo 在第 1 天的公告指出,透過訂閱存取的 GPT-6 Astra 與 GPT-6.1 Sol 速度約提高 50%。
此時機值得注意,因為另一項討論正在同時進行。
SemiAnalysis 發布了一項針對消費者 AI 訂閱方案的詳細極限測試研究。在其代理式工作負載假設下,Claude Opus 5.5 訂閱方案在相同月費下,提供的 API 等值價值超過 GPT-6.1 Sol 方案的五倍。
因此,OpenAI 確實讓模型變得更快。
更困難的問題是:對於執行長時間、自主式程式設計與代理工作流程的使用者而言,其訂閱經濟效益是否仍具競爭力。
OpenAI 為期 28 天發布計畫的第一項更新,瞄準進階程式設計與代理工作中最明顯的摩擦來源之一:生成延遲。
Tibo 寫道,OpenAI 已透過訂閱存取,將 GPT-6 Astra 與 GPT-6.1 Sol 的預設速度最佳化約 50%。
此次推出適用於:
使用者不需要變更設定或切換 API 端點。
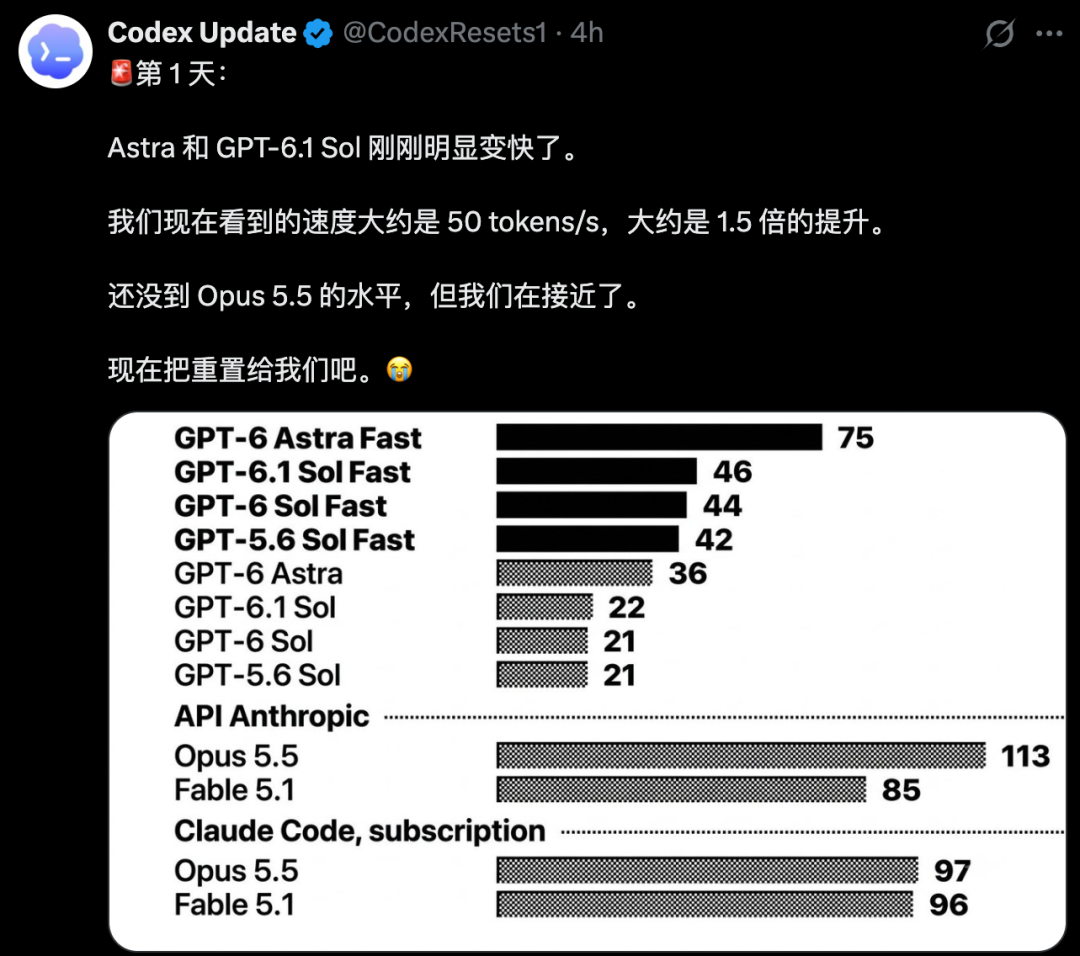
社群測量顯示速度明顯提升,但吞吐量會因模型與存取路徑不同而有所差異。
來源文章將此變化概括為大約從以下數值提升:
約 30 個 Token/秒
        ↓
約 50 個 Token/秒
這是一個實用的簡寫方式,但官方公告本身表述為 「速度提高約 50%」,而非保證提供固定每秒 50 個 Token 的服務等級。
不同測試者可能會看到不同數值。
這項速度改進是更廣泛的 28 天推進計畫中的第一項。
Tibo 表示,在接下來 28 天中,OpenAI 打算每天推出以下其中一項:
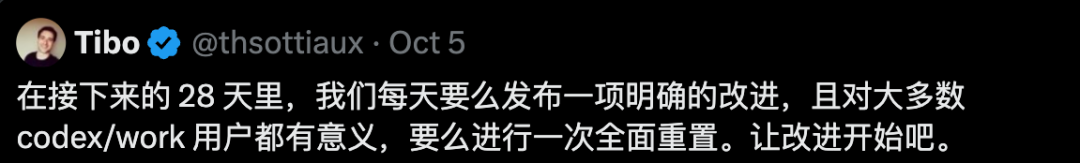
這項 28 天推進計畫聚焦於簡化、效率、全新能力與模型改進。
其公布的優先事項包括:
此訊息特別針對 Codex 與 Work 使用者,因為在這些產品中,長時間執行的任務會讓速度與使用限制變得比短暫聊天更明顯。
原始文章指出,這項變化部分源於一個「激進」的最佳化 Tokenizer,它能減少完成相同任務所需的 Token 數量。
對於這項具體說法,應採取審慎態度。
本文檢視的 OpenAI 員工公開聲明,將第 1 天更新描述為推論最佳化與預設速度提升。
這些公開聲明並未記載,GPT-6 Astra 或 GPT-6.1 Sol 有推出新的 Tokenizer,以作為這次 50% 提升背後的機制。
這項區別很重要。
改善實際體驗吞吐量有多種方法:
在沒有官方技術說明的情況下,更穩妥的說法是 OpenAI 已最佳化推論,而不應將改進歸因於特定的 Tokenizer 架構。
模型生成速度提高 50%,不代表每一個完整任務都會提早 50% 完成。
代理工作流程的耗時不只來自 Token 生成。
典型的程式設計任務可能包括:
模型推理
      ↓
工具呼叫
      ↓
Shell 指令或瀏覽器操作
      ↓
檔案讀取/寫入
      ↓
網路等待
      ↓
下一輪模型推理
如果工具、網站、建置、測試或外部 API 主導了實際經過時間,那麼更快的 Token 生成可能只會縮短整體任務時長的一部分。
來源文章也指出,部分開發者沒有立即感受到戲劇性的差異。
這是合理的。
感知速度取決於:
這項更新是真實的,但不應解讀為保證每個端到端任務都會在原先三分之二的時間內完成。
同一週,SemiAnalysis 發布了一份 AI 訂閱限制的詳細比較。
研究人員購買訂閱方案、執行受控工作負載,直到使用量計量表變動或達到限制,並將這些限制換算為 API 等值美元價值。
其方法論分別測量:
接著,他們使用具代表性的代理式工作負載來組合這些費率。
SemiAnalysis 測試了 OpenAI、Anthropic 與其他數家 AI 供應商的訂閱限制。
來源文章中的核心比較,是 GPT-6.1 Sol 與 Claude Opus 5.5。
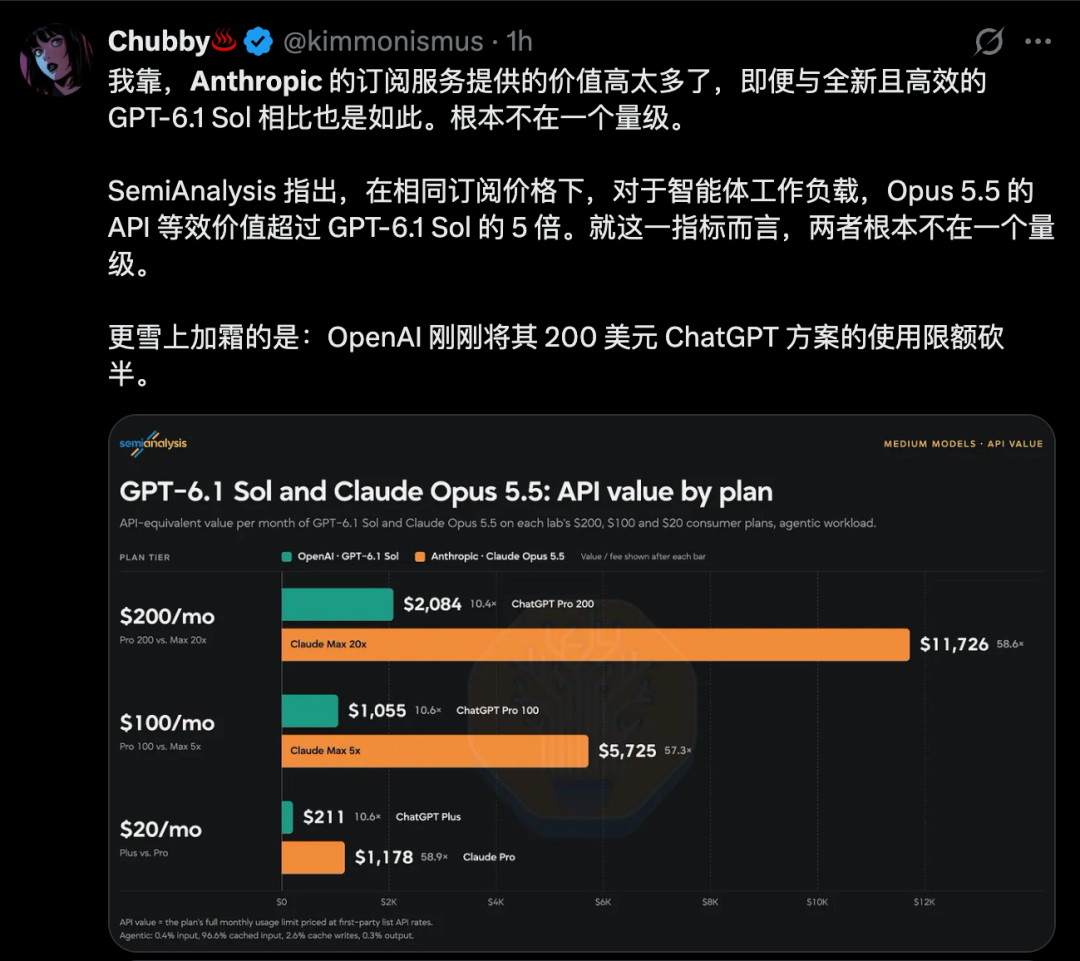
SemiAnalysis 根據其代理式工作負載假設,估計 Claude Opus 5.5 的優勢超過五倍。
已發布的圖表提供以下概覽:
| 月費方案 | OpenAI/GPT-6.1 Sol | Anthropic/Claude Opus 5.5 | 約略比例 |
|---|---|---|---|
| $200 | $2,084 API 等值價值 | $11,726 | 5.6 倍 |
| $100 | $1,055 | $5,725 | 5.4 倍 |
| $20 | $211 | $1,178 | 5.6 倍 |
這些數字不代表一項 $200 的 Anthropic 訂閱會實際支付客戶 $11,726。
它們的意思是,根據 SemiAnalysis 所測得的限制與假定的工作負載組合,若透過公開 API 價格消耗相同用量,理論上成本約為該數額。
一張針對 $200 級距的社群視覺化圖表,讓這項差異更容易理解。
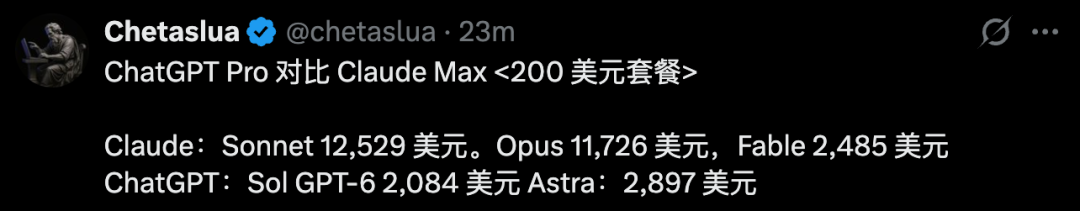
$200 方案的比較結果,會因實際使用的模型而有顯著差異。
重要的細節在於模型選擇。
SemiAnalysis 明確警告,訂閱價值不能用單一的通用數字來概括。
更正確的單位接近於:
(方案、模型、工作負載)
一項訂閱對某一模型而言可能看起來極為優厚,但對另一模型而言則可能低得多。
SemiAnalysis 表示,OpenAI 在該報告發布前不久做出了一項重大訂閱調整。
該公司的測試確認,對新購買的訂閱方案,OpenAI 的 $200 方案 Token 限制大約下調了 50%。
較舊的 $200 方案暫時沿用先前的限制,直到 10 月 29 日。
SemiAnalysis 也指出,OpenAI 推出了新的 $500 級距。
文章指出,$200 級距過去曾提供異常優厚的價值,尤其是對重度 Codex 使用者而言。
下調後,OpenAI Pro 100、Pro 200 與 Pro 500 級距的每美元 Token 經濟效益變得更加接近。
這也是 Anthropic 的比較結果看起來如此鮮明的部分原因。
傳統聊天使用模式通常是零散的。
使用者提出問題、閱讀回覆、思考,並在稍後回來。
代理式程式設計的行為可能非常不同。
單一工作可能會:
這會產生遠多於短篇對話交流的模型活動。
SemiAnalysis 主張,訂閱方案受到大量補貼,因為多數使用者不會消耗其理論上的最高額度。
重度代理使用者會挑戰這項假設。
來源文章將此描述為,從「多數使用者不會用完其完整額度」轉變為能夠消耗極大量推論資源的工作流程。
這與 SemiAnalysis 更廣泛的分析在方向上是一致的,但確切的損益兩平使用率仍取決於模型成本、API 利潤率、工作負載組合與供應商內部經濟效益等假設。
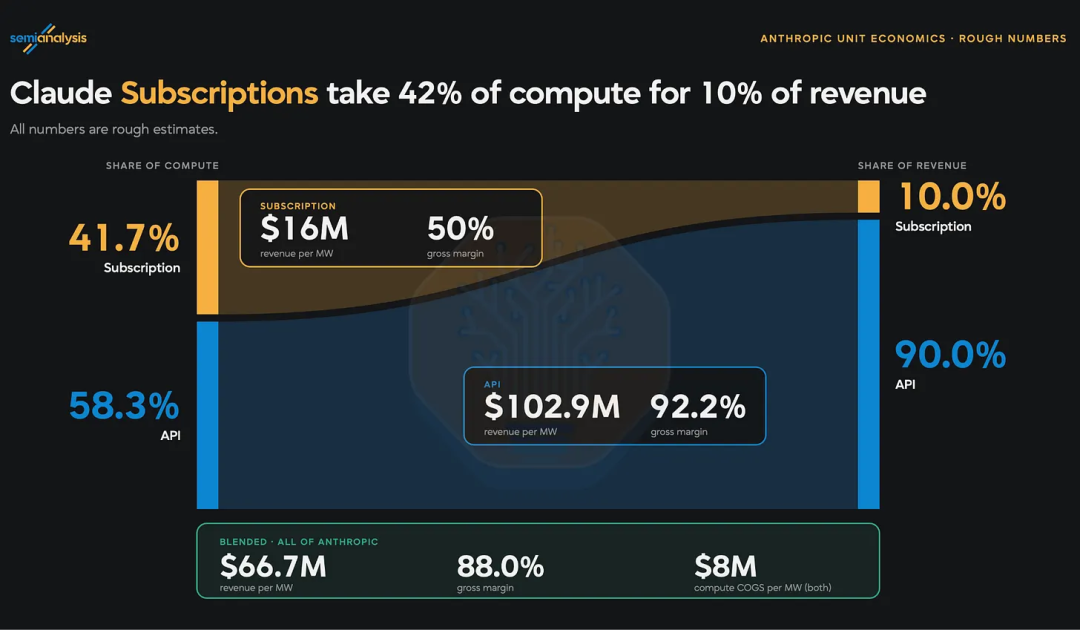
SemiAnalysis 也發布了 Anthropic 訂閱經濟效益的粗略模型。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
SemiAnalysis 估計,訂閱方案所消耗的推論運算資源占比,可能遠高於其營收占比。
其粗略數據顯示,訂閱方案的營收占比可能僅約 10%,但消耗的推論運算資源可能超過 40%。
這些是模型估算,而非 Anthropic 經審計的財務報表。
它們之所以有用,是因為其解釋了訂閱限制背後的張力。
AI 公司希望訂閱產品足夠吸引人以贏得使用者,同時也要防止最重度的代理工作負載無限制地消耗昂貴推論資源。
代理越趨自主,維持這種平衡就越困難。
原始文章隨後將焦點從模型速度與訂閱經濟效益,轉向更廣泛的產品敘事。
文章引用一篇社群貼文,宣稱 Chat、Work、Codex 與 Dots 最終將整合為一個統一的超級應用程式介面,且模型選擇器與推理控制項將對使用者隱藏。
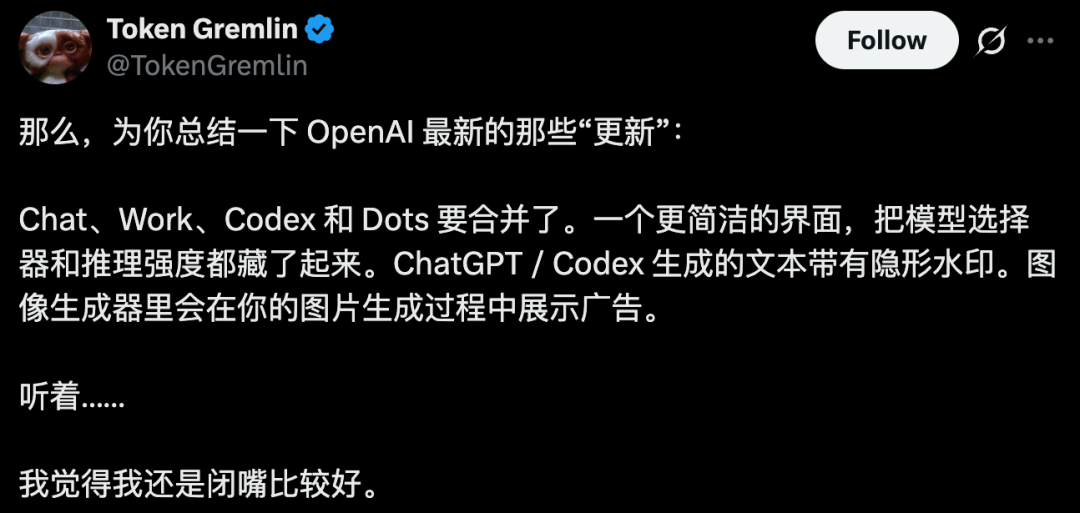
這則貼文概述了社群對未來產品整合的說法;並非所有說法都是官方資訊。
本節需要清楚區分傳聞與目前的產品現況。
OpenAI 目前的說明中心指出:
因此,完全整合 Chat + Work + Codex + Dots 的介面並不是已公告的當前產品狀態。
OpenAI 顯然正在簡化體驗,但來源文章中更強烈的「一切都在合併」說法,來自社群解讀,而非 OpenAI 已發布的產品路線圖。
官方產品方向依然值得關注。
OpenAI 現在將 ChatGPT 描述為同時包含:
專案可以為這兩種模式提供共用背景資訊。
Work 還可以:
這代表產品已經逐漸遠離「每項能力都存在於獨立應用程式」的世界。
整合確實正在發生。
但最終的確切形式尚未公開。
來源文章暗示 Codex 可能會消失並併入統一介面。
目前文件則顯示並非如此。
Codex 仍專注於軟體開發與技術工作。
在桌面版中,使用者可透過左上角選單在 ChatGPT 與 Codex 之間切換。
Codex 保有自身以開發為核心的工作流程與歷程記錄。
這在未來可能改變,但本文檢視的官方來源中,沒有任何資料表示 Codex 將不再作為獨立體驗。
Dots 代表 OpenAI 產品策略的另一部分。
Dot 是由 GPT-6 Astra 驅動的常駐代理。
它擁有:
Dot 也可以透過訊息管道工作,並且在取得權限後連線至使用者的本機電腦。
這讓 Dots 更接近持久化助理或受委派的工作者,而非一般聊天工作階段。
這也有助於解釋,為何使用者與觀察人士預期產品邊界會隨時間變得模糊。
Chat、Work、Codex 與 Dots 日益共用模型、工具、檔案、權限與代理基礎設施。
但共用基礎設施不等於已確認會合併成單一介面。
來源文章也報導,ChatGPT 與 Codex 生成的文字將獲得不可見浮水印。
這項說法部分正確,但適用範圍比原文措辭所暗示的狹窄得多。
OpenAI 已正式宣布一套名為 textGrain 的文字來源追溯系統。
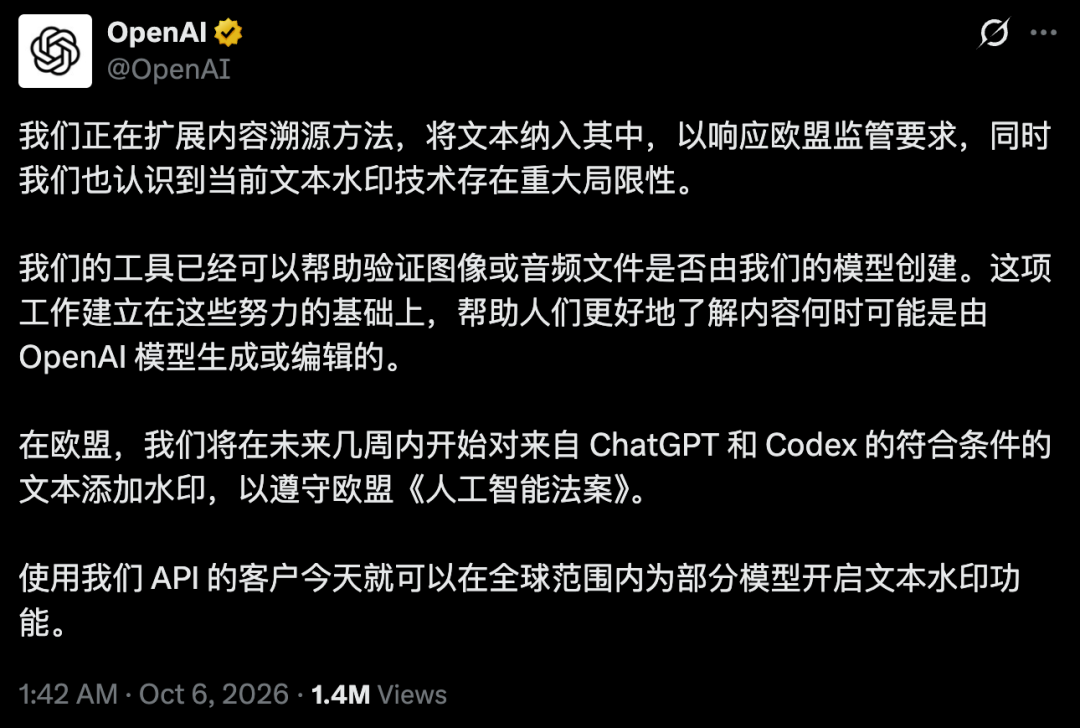
OpenAI 正針對歐盟 AI 法案的來源追溯要求導入文字浮水印。
目前政策如下:
因此,若說全球所有 ChatGPT 與 Codex 文字都會被強制加入浮水印,並不準確。
OpenAI 表示,textGrain 不會插入隱藏字元或不可見空格。
相反地,它會微妙地改變選擇詞語或詞片段時所使用的機率模式。
在足夠長的文字中,偵測器可以尋找該統計訊號。
這種方法有重要限制。
改寫、翻譯、大幅編輯或極短文字都可能削弱該訊號。
缺少浮水印也不代表文字一定由人類撰寫。
OpenAI 自身也強調這些限制。
廣告也是產品轉變的一部分,而且這部分已獲官方確認。
10 月 5 日,OpenAI 宣布在 ChatGPT 中推出新的視覺廣告格式。
該公司表示,初期將在圖像生成期間測試此格式。
第一波推出僅限於:
廣告會加上標示,並與生成圖像分開。
OpenAI 也表示,廣告不會影響 ChatGPT 的回答。
這比籠統地說「使用者在等待圖像生成時都會看到廣告」更為具體。
這是一項與方案、地區及推出狀態相關的有限測試。
該文章結合了多項在相近時間發生的真實發展。
最清楚的區分方式如下:
| 說法 | 狀態 |
|---|---|
| GPT-6 Astra 與 GPT-6.1 Sol 的預設訂閱速度提高約 50% | 已確認 |
| 此改進適用於 OpenAI 產品及使用 ChatGPT 登入的合作夥伴 | 已確認 |
| 使用者需要變更程式碼或設定 | 不需要;官方公告表示無需變更 |
| 預設吞吐量保證恰為每秒 50 個 Token | 未保證;每秒 50 個 Token 是實用的觀察/概括數字 |
| 速度提升來自新的激進 Tokenizer | 在本文檢視的官方資料中未獲公開確認 |
| SemiAnalysis 測得 Opus 5.5 相較 GPT-6.1 Sol 有超過 5 倍 API 等值價值 | 在其既定的代理式工作負載方法論下已確認 |
| OpenAI 將新購 $200 方案的限制大約減半 | 已由 SemiAnalysis 測試及所引用公告確認 |
| Chat、Work、Codex 與 Dots 正由官方合併為單一介面 | 未確認 |
| 模型選擇將被完全移除 | 未確認;目前 Work/Codex 文件仍描述模型選擇功能 |
| 全球所有 ChatGPT/Codex 文字都將加入浮水印 | 作為全球性說法是錯誤的 |
| 歐盟境內符合資格的 ChatGPT/Codex 文字將獲得不可見浮水印 | 已確認 |
| API 客戶可選擇啟用文字浮水印 | 已確認 |
| 圖像生成期間將測試廣告 | 已確認 |
| 圖像生成廣告初期鎖定美國的 Free/Go 使用者 | 已確認 |
這些區分讓原始故事更具實用性。
即使不將每一項產品傳聞都視為既定路線圖,真正的更新本身已相當重大。
是。OpenAI 工程主管 Tibo Sottiaux 表示,透過符合資格的訂閱存取,GPT-6 Astra 與 GPT-6.1 Sol 已最佳化為預設速度約提高 50%。
否。官方沒有公布固定每秒 50 個 Token 的保證。社群測量與摘要使用約每秒 30 至 50 個 Token 來說明這項改變,但實際吞吐量會隨模型、任務、產品與執行環境而變化。
第 1 天公告明確描述的是,透過 OpenAI 產品與使用 ChatGPT 登入的合作夥伴所提供的訂閱存取。這不應被泛化為所有 API 流量都獲得相同改進的說法。
SemiAnalysis 測量訂閱限制,並使用具代表性的代理式工作負載將其換算為理論上的 API 等值價值。對 Claude Opus 5.5 與 GPT-6.1 Sol 的比較,其 10 月快照顯示,在 $20、$100 與 $200 對應級距中,前者的 API 等值價值約高出 5.4 至 5.6 倍。
OpenAI 正在簡化並連結這些體驗,但尚未正式宣布四者將成為完全相同的單一介面。目前文件仍將 Codex 視為獨立的開發檢視模式,並將 Dots 視為常駐代理能力。
否。OpenAI 表示,歐盟境內符合資格的 ChatGPT 與 Codex 文字將獲得不可見的 textGrain 浮水印;全球 API 客戶則可針對特定模型選擇啟用。API 浮水印預設為關閉。
OpenAI 已宣布,將針對美國的 Free 與 Go 使用者,在圖像生成期間測試視覺廣告。初期測試將於 2026 年 10 月稍晚開始,廣告會加上標示並與生成內容分開。
Tibo 宣布了一個為期 28 天的期間,團隊計畫每天推出一項與多數 Codex/Work 使用者相關的明確改進,或進行更大範圍的重置。第一項已宣布的改進是 GPT-6 Astra 與 GPT-6.1 Sol 的速度提升。
OpenAI 在其 28 天發布計畫中的第一項更新非常直接:透過符合資格的訂閱存取,包括使用 ChatGPT 登入的支援合作夥伴工具,GPT-6 Astra 與 GPT-6.1 Sol 預設應會感覺快上約 50%。
同時,SemiAnalysis 的訂閱測試顯示,速度只是競爭的一部分。在其代理式工作負載假設下,Claude Opus 5.5 訂閱目前在相近月費下,提供超過 GPT-6.1 Sol 方案五倍的 API 等值價值。
來源文章也將此時刻連結至 OpenAI 更廣泛的產品變化。其中一些已獲官方確認,包括歐盟文字浮水印、圖像生成測試期間的視覺廣告、Work、Dots 與更深度的產品整合。另一些內容,例如完整的 Chat/Work/Codex/Dots 合併,以及模型選擇功能消失,仍是社群推測,而非已宣布的產品政策。
GPT-6 變得更快,但更大層面的競爭正轉向整體代理經濟效益:速度、限制、模型效率、工具存取,以及訂閱方案在計量額度耗盡前能完成多少真正的工作。
從一句話開始,幾分鐘內拿到完整網站。



