For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
Yann LeCun 的世界模型初创公司 **Advanced Machine Intelligence(AMI)** 发布了其首批重要研究成果之一。
Yann LeCun 的世界模型初创公司 Advanced Machine Intelligence(AMI) 发布了其首批重要研究成果之一。
在论文 H-JEPA:用于视觉规划的端到端分层世界模型(H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning)中,来自 AMI、纽约大学、巴黎 INRIA 和布朗大学的研究人员,提出了一种由多个动作条件化 JEPA 构成的分层世界模型。
其核心思路很直接:不要强迫同一个潜在表示同时处理即时运动控制与长期规划,而是让 H-JEPA 中的不同层级拥有不同的时间尺度和表示空间。
较高层级关注更远的未来,并以更粗粒度进行规划。它们预测出的中间状态会成为较低层级的子目标,随后由低层级逐步细化,直到系统生成可执行动作。
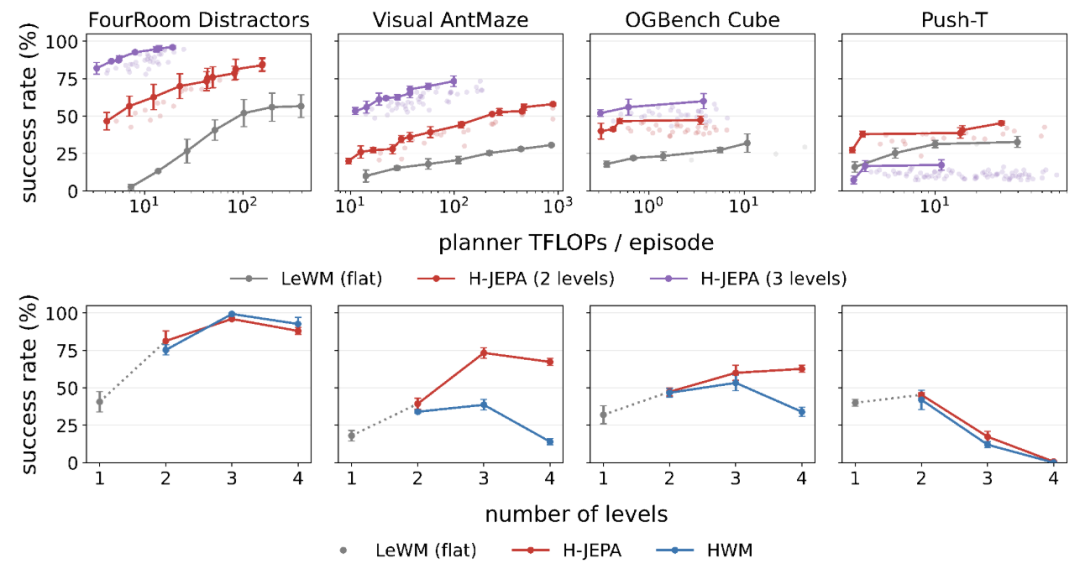
在 Visual AntMaze 上,三层 H-JEPA 达到了约 73.3% 的规划成功率,而扁平化的 LeWorldModel 基线为 18.0%;与此同时,H-JEPA 还取得了更优的成功率与计算量权衡前沿。
该项目延续了 AMI 自成立以来一直强调的开放研究方向。作者已经发布训练与评估代码、预训练检查点以及配套数据集。
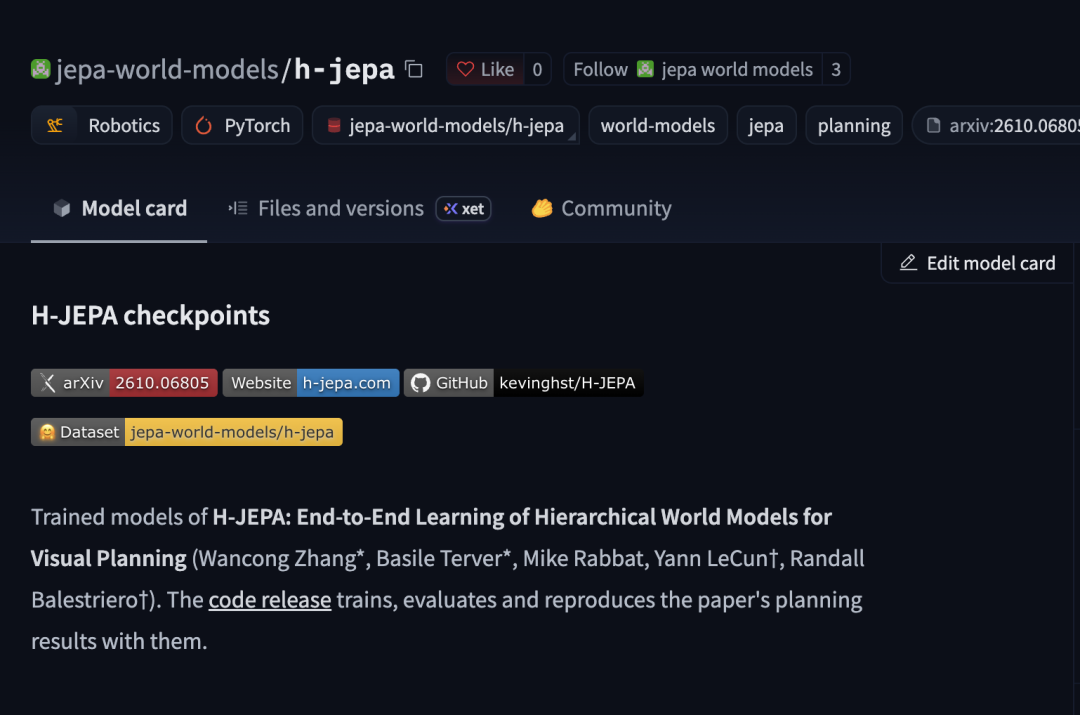
官方 GitHub 仓库采用 MIT 许可证。Hugging Face 上发布的 H-JEPA 检查点仓库同样标注为 MIT 许可证,而配套数据集仓库则采用 CC BY 4.0 许可证。
多年来,LeCun 一直在论述分层规划的重要性。
其底层直觉与人类规划复杂现实任务的方式相似。
想象一下,你坐在纽约大学的一间办公室里,决定前往巴黎。
在最高层级,重要信息是目的地、航班和时间表。一旦这些决定完成,下一层级会变得更加具体:离开办公室、下楼、前往机场、登机。
到了最低层级,注意力再次转移。走下楼梯需要了解地面、下一步落脚位置以及身体运动。在选择跨大西洋航班时无关紧要的细节,此时突然变得至关重要。
机器人系统也面临同样的问题。
高层规划器需要理解任务目标、空间关系以及长期移动方向。低层控制器则需要关于即时运动和身体构型的精确信息。
如果一个表示必须在每个时间尺度上保留所有细节,规划就会变得不必要地困难。
例如,一台四足机器人可能已经处于正确位置,但腿部姿态与目标图像不同。如果一个表示过度强调快速变化的腿部细节,就可能错误地判断机器人距离目标还很远,尽管与任务相关的位置实际上已经正确。
H-JEPA 论文通过提出一个更具体的问题来应对这一挑战:
每个层级能否学习在自身时间尺度上重要的信息,同时仍然允许高层计划被转换为低层动作?
H-JEPA 为层级结构中的每一层分配三个主要组件:
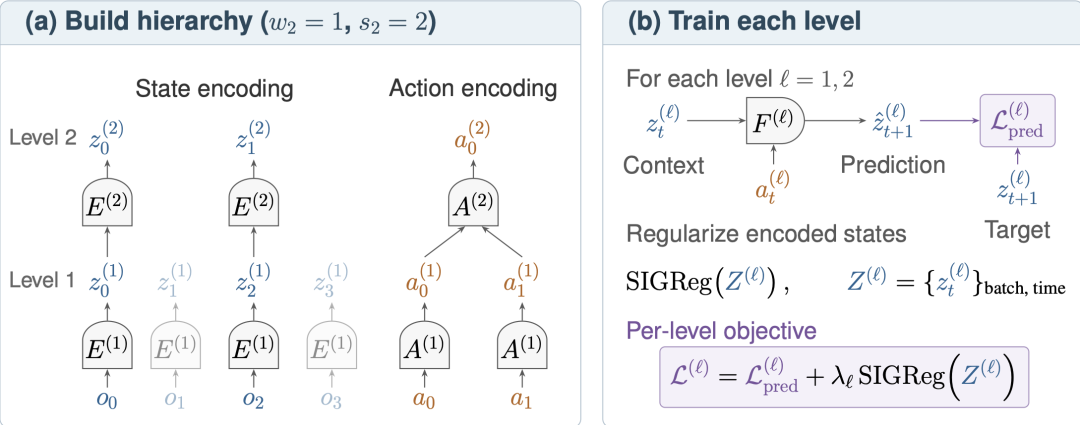
状态编码器提取环境的潜在表示。
在最低层级,编码器直接处理视觉观测。更高层级接收低层级表示,并逐步学习更加抽象的状态版本。
这样一来,更高层级可以舍弃变化速度快、难以在长时间范围内预测,或与长期规划无关的细节。
在 Visual AntMaze 实验中,随着层级升高,模型会逐渐抑制关于蚂蚁腿部姿态的信息,同时保留关于蚂蚁位置和迷宫布局的信息。
这正是该层级结构希望学习的抽象方式。
动作编码器描述不同时间尺度上的动作效果。
在最低层级,动作对应相对具体的控制变化。在更高层级,多个低层级动作会被压缩为更粗粒度的表示,用于描述状态在更长时间内如何变化。
这使每一层拥有不同的时间分辨率。
在论文报告的设置中,高层级的一次预测步骤会跨越比其下一层更多的环境步数。
预测器将当前潜在状态与编码后的动作结合起来,从而估计未来潜在状态。
因此,每个层级都会学习自己的动作条件化世界模型。
它与扁平化世界模型的关键区别在于,H-JEPA 不要求每个层级都在同一个共享潜在空间中进行预测。
相反,每个层级都可以发展出适合自身时间范围的表示。
在推理阶段,规划从层级顶部向下进行。
顶层首先搜索一条通往最终目标的粗粒度路径。
它预测出的中间状态随后会成为下一层级的子目标。下一层级搜索一条更精细的计划以到达该子目标,流程持续进行,直到最低层级生成原始动作。
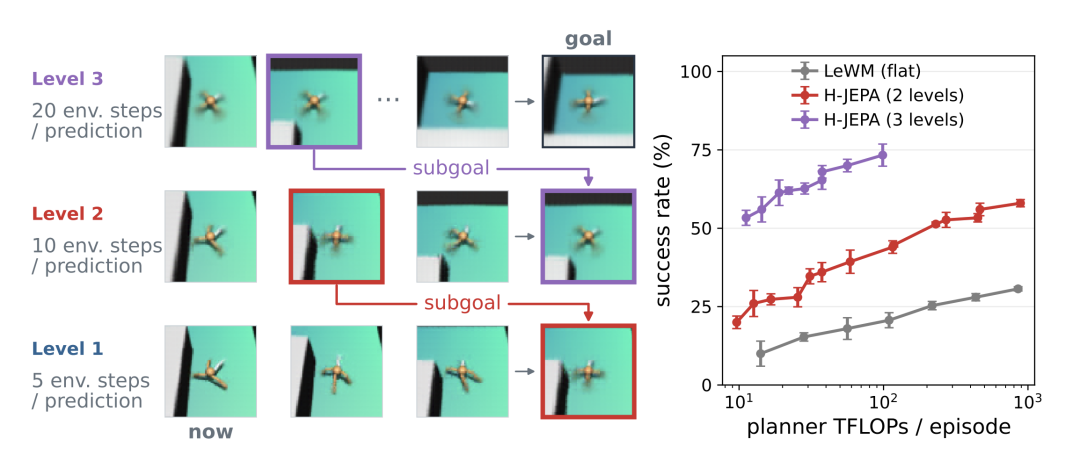
这会形成一个由粗到细的规划流程:
执行一段动作前缀后,系统会观测新的状态并再次进行规划。
这种反复重新规划的机制,让层级结构能够根据实际环境作出响应,而不是提交一份很长的开环计划后一直执行到底。
该层级结构采用端到端方式训练。
这意味着各层并不是作为彼此隔离的模块进行训练。高层级目标可以影响低层级编码器,使整体表示层级能够共同发展。
然而,世界模型训练存在一个经典失效模式:表示坍缩。
如果编码器将所有输入状态映射到同一个潜在向量,预测器就可以直接输出同一个向量,并在没有真正学习环境信息的情况下获得较低的预测误差。
H-JEPA 通过使用 SIGReg,即“草图各向同性高斯正则化”(Sketched Isotropic Gaussian Regularization),来应对这一问题。SIGReg 最初由 Randall Balestriero 和 Yann LeCun 在更早的 LeJEPA 工作中提出。
SIGReg 约束潜在分布,使不同观测不会坍缩到同一个表示上。
早期的 LeWorldModel 将这种正则化方式应用于从像素进行端到端世界模型训练。H-JEPA 以 LeWorldModel 作为最低层基础,并在其上增加额外的 JEPA 层级。
这保持了 JEPA 的基本原则:预测有用的未来表示,而不是重建未来的每一个像素。
论文在四个模拟导航与操作环境中评估了 H-JEPA:
论文还使用 DROID 数据集中的真实机器人轨迹,评估了离线规划能力。
Visual AntMaze 展示了最明显的分层优势。
根据官方仓库,三层 H-JEPA 达到了 73.3% 的规划成功率,而扁平化 LeWorldModel 基线为 18.0%。
该层级结构还改善了成功率与规划器计算量之间的权衡。
这一点很重要,因为只有当新增层级不会让规划成本变得高得难以接受时,分层规划器才真正有用。
在其他模拟环境中,分层模型同样优于扁平化基线,但层级更深并不总是更好。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
原文特别强调了 Push-T 这一重要反例:两层模型优于扁平化基线,而增加第三层或第四层反而可能降低性能。
论文认为,这部分原因在于任务长度。较短的轨迹无法为运行在长时间范围上的超高层级提供足够多的有效样本。
这说明了一个重要限制:
当任务确实包含跨多个时间尺度的结构时,分层才有用。机械地增加层级并不能保证性能更好。
真实机器人数据带来了另一个表示问题。
在多样化视频中,纯预测目标可能会高度关注稳定的背景信息,因为背景很容易预测。实际上对控制很重要的运动机器人,反而可能获得较少的表示容量。
为了解决这一问题,研究人员在 DROID 实验中加入了逆动力学监督。
模型不仅需要预测未来潜在状态,还需要推断连接连续潜在状态的动作。
这会促使表示保留有关机器人运动和可控状态的信息。
H-JEPA 项目页面报告称,与扁平化基线相比,学习到的第二层提高了离线规划保真度,同时降低了规划器计算量。
DROID 评估是离线进行的:论文将预测的末端执行器路径与专家轨迹进行比较,并没有声称实现真实机器人闭环任务成功。
在解读这些结果时,这一区别非常重要。
作者已经在 GitHub 上发布了 H-JEPA 的实现。
官方仓库包含以下任务的训练与规划代码:
仓库还提供了用于复现论文部分图表和表格的脚本。
目前,Hugging Face 检查点仓库包含扁平化 LeWorldModel、两层、三层和四层 H-JEPA 变体,以及模拟任务中的共享空间 HWM 基线模型,同时还提供 DROID 检查点。
配套的 H-JEPA 数据集仓库包含模拟数据、规划评估任务、探测数据集以及发布版本所需的 DROID 相关数据。
这使该工作不只是论文层面的演示:研究人员可以检查实现、加载训练好的模型,并尝试复现论文报告的规划结果。
H-JEPA 延续了 LeCun 多年来推动的更广泛研究方向。
JEPA 是 Joint-Embedding Predictive Architecture 的缩写,即“联合嵌入预测架构”。
标准语言模型通过预测未来词元进行学习。视觉 JEPA 则学习观测的表示,并在潜在空间中预测目标表示。
对于 H-JEPA 这样的世界模型,动作会被加入这一过程,使模型能够预测执行动作后,其内部世界表示将如何变化。
随后,规划器可以比较不同动作的预测后果,并搜索一条通往目标的路径。
这体现了 LeCun 长期以来的观点:智能所需要的不只是语言生成。在他的研究议程中,系统需要理解世界、预测动作后果、记忆相关状态,并在时间维度上进行规划。
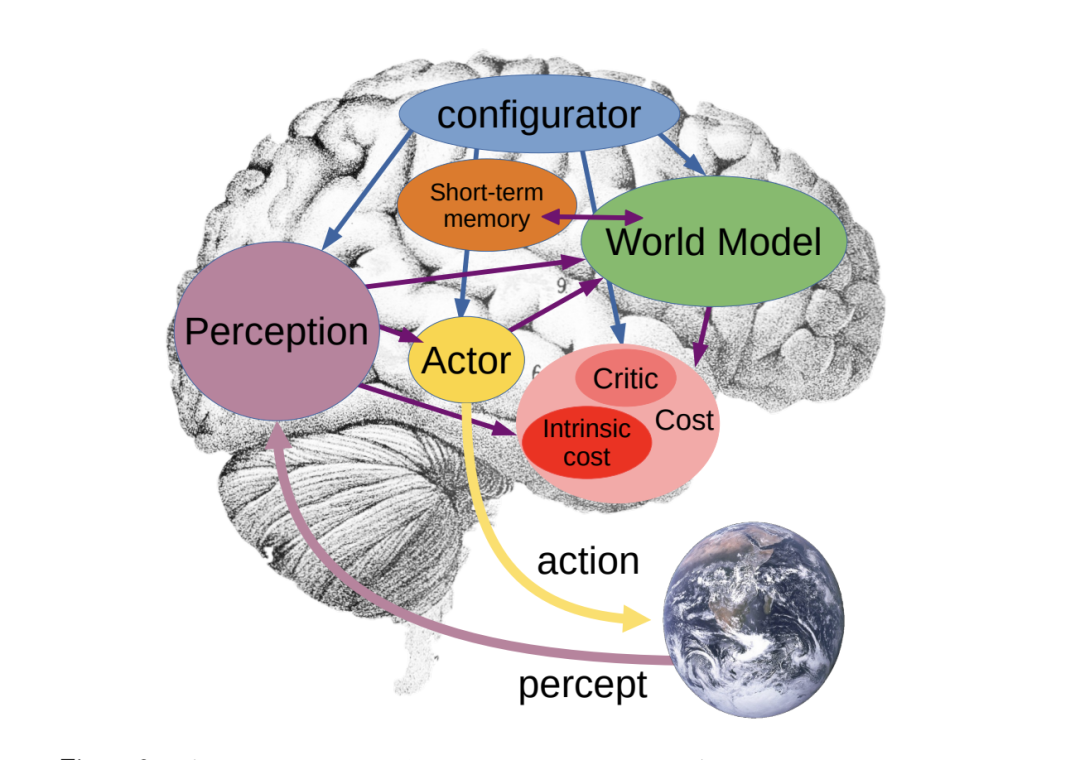
原文还提到,LeCun 多次批评“仅仅扩大 LLM 规模就必然带来人类水平智能”这一观点。与此同时,他也承认基于 LLM 的工具在实践中极其有用。
因此,H-JEPA 最好被理解为对 LeCun 一直倡导的另一种架构的一项具体实验,而不是试图在今天取代所有语言模型。
如今,这一研究方向已经成为 AMI 商业战略的一部分。
据 Reuters 及同期其他报道,AMI 于 2026 年 3 月融资 10.3 亿美元,投前估值为 35 亿美元。
公司团队成员包括:
Michael Rabbat 也是 H-JEPA 论文作者之一。
AMI 将其目标描述为:构建能够理解世界、维持持久记忆、进行推理与规划,并保持可控性与安全性的系统。
在 BAAI 源文章发布时,该公司仍主要通过研究成果、团队和招聘来展现自身,而不是通过一个面向公众广泛提供的产品。
因此,H-JEPA 的意义部分在于,它为这家初创公司的世界模型理念提供了一个具体的技术成果。
原文最后将 AMI 与另一家备受关注的世界模型公司进行比较:Fei-Fei Li 创立的 World Labs。
2026 年 9 月 28 日,AMD 宣布已达成收购 World Labs 的最终协议。
根据 AMD 提交给美国证券交易委员会(SEC)的文件,这项全股票交易的估值约为 82 亿美元,具体金额仍需进行惯常调整。
两家公司选择了不同的组织路径,但都体现出世界模型、空间智能、机器人、仿真和物理 AI 日益增长的重要性。
AMI 正在继续围绕分层预测模型发展自己的研究计划,而 World Labs 则正在走向与一家大型 AI 计算公司整合。
对于 H-JEPA 而言,眼下更重要的问题是技术问题,而不是公司层面的变化:这种架构能否从模拟控制和离线机器人视频,扩展到更加丰富的闭环现实世界系统?
这将是对该架构的下一项考验。
H-JEPA 是一种用于视觉规划的端到端分层世界模型。它叠加多个动作条件化 JEPA,使更高层级能够预测更远的未来,并将潜在子目标逐层传递给低层级。
扁平化世界模型使用一个表示和一个规划时间尺度。H-JEPA 则在多个时间尺度上学习独立的潜在空间,使高层级能够关注变化较慢且与任务相关的结构,同时让低层级保留控制所需的细节。
官方 GitHub 仓库报告称,三层 H-JEPA 的规划成功率约为 73.3%,而扁平化 LeWorldModel 基线为 18.0%。在成功率与规划器计算量之间的权衡方面,分层模型也表现更好。
SIGReg 是“草图各向同性高斯正则化”(Sketched Isotropic Gaussian Regularization)的缩写。它在 LeJEPA 中被提出,用于约束潜在分布并防止表示坍缩,即编码器将许多不同状态映射到几乎相同的嵌入。
是的。官方 GitHub 代码采用 MIT 许可证,预训练检查点可在 Hugging Face 上获得。配套的 H-JEPA 数据集仓库采用 CC BY 4.0 许可证发布。
论文使用逆动力学监督,将该方法扩展到来自 DROID 的多样化真实机器人视频。这些实验评估的是离线规划保真度,并非完整的机器人闭环任务成功,因此不应将其夸大为已经实现自主现实世界部署。
不能。论文表明,当任务包含跨多个时间尺度的有意义结构时,更深的层级有帮助;但对于 Push-T 等较短任务,过深的层级可能损害性能,因为更高层级可能获得过少的有效训练信号。
它遵循 LeCun 的 JEPA 与世界模型理念:学习世界的紧凑表示,预测未来潜在状态而不是每个像素,并利用这些预测进行规划。H-JEPA 增加了明确的层级结构,使不同层级能够在不同的时间尺度和抽象层次上运行。
H-JEPA 将 JEPA 世界模型理念转化为明确的规划层级。高层级在更长的时间范围和更抽象的表示上运行,而低层级则将这些计划逐步转换为更加具体的子目标和动作。
最强的结果出现在 Visual AntMaze 上:三层 H-JEPA 的规划成功率约为 73%,而扁平化 LeWorldModel 基线为 18%,同时规划效率也有所提升。该工作还表明,分层并非自动有效:任务时间尺度和数据可用性决定了额外层级是否能够带来帮助。
对于一项刚刚发布的研究工作而言,该项目具有较高的可复现性,代码、检查点和数据集均已公开。
H-JEPA 的主要贡献并不只是取得更高的迷宫得分,而是具体展示了世界模型可以针对不同的规划时间范围学习不同的表示。
從一句話開始,幾分鐘內拿到完整網站。



