For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/meta-s-muse-wonder-bet-zuckerberg-and-wan-276b832c.md.
Meta 在尚未看到預期能為投資提供合理依據的模型之前,就承諾投入龐大的 AI 基礎設施支出。在 10 月 13 日發布的 [Cheeky Pint 訪談](https://cheekypint.substack.com/p/muse-wonder-zuckerberg-and-...

Meta 在尚未看到預期能為投資提供合理依據的模型之前,就承諾投入龐大的 AI 基礎設施支出。在 10 月 13 日發布的 Cheeky Pint 訪談中,Mark Zuckerberg 與 Alexandr Wang 描述了該決策背後的不確定性,以及隨之而來的產品雄心。
這段對話有助於說明 Meta 如何看待 Muse Wonder:它既是一個能力強大的模型,也是打造能記住脈絡、做出決策,並最終參與商業交易之助理的基礎。相較於「令人失望的模型會自動讓公司破產」這種說法,它也以更清楚的方式呈現了財務風險。
祖克柏回憶道,前一年稍晚時,團隊尚未看到其押注的模型,便在考慮規模約為 1,000 億至 2,000 億美元的支票。他描述自己曾詢問 Wang,是否對研究方向有足夠信心,以支持這項承諾。
這些數字描述的是投資討論的規模。不應將其表述為 Muse Wonder 已披露的訓練帳單、單一實驗的價格,或一筆範圍明確且已最終確定的採購。訪談在基礎設施容量、建設支出與營運成本之間切換;這些是相關但不同的財務類別。
Wang 回憶起在夏威夷的一場高階主管聚會,CFO Susan Li 多次強調,失敗在財務上將會非常糟糕。這確立了嚴重壓力與巨大的下行風險,但並未證實無力償債,也未證實公司預測單一模型失敗就會導致破產。
後續對話提供了更多脈絡:祖克柏表示,需要經過幾次迭代才能成功是可以承受的,而 Wang 則形容 Meta 具有韌性。在解讀這場訪談時,這些說法應與財務警告一併考量。
這兩位高階主管描述 Meta Superintelligence Labs 內一個規模相對精簡、人才密度很高的研究組織。依其說法,研究團隊人數少於 200 人,更接近 100 人,而不是將每位參與基礎設施與產品工作的員工都描繪為同一個模型訓練團隊的一部分。
這項區分很重要。一個小型研究實驗室仍可仰賴龐大的組織提供運算能力、資料中心營運、安全工作、發行能力與產品整合。研究人員數量並不等同於投入該計畫的總資源。
這場討論也將預訓練與後訓練工作連結至最終使用者體驗。目標不只是打造能完成孤立基準測試題目的模型,而是一個在請求需要多個步驟,或涉及較早互動中的資訊時,行為仍能維持實用性的系統。
Meta 在 10 月 12 日的公告中,將 Muse Wonder 描述為使用千兆瓦規模 Prometheus 基礎設施訓練的大型模型。該公告將其定位為與較小型的 Muse Spark 並列,而非將兩者描述為可相互替代的產品。
Meta 表示,Wonder 可透過 Meta 模型 API 與 Muse Code 使用,而 Wonder Full 則提供給 Muse Code 訂閱者。其助理功能將先向訂閱者推出。這些是不同的存取路徑,因此不能將某一模型或訂閱體驗的可用性,泛化為每一位 Meta 使用者或開發者帳戶都能使用。
獨立評測為模型定位提供了另一個視角。Artificial Analysis 的 Muse Wonder 評測指出,在所評估的最高設定下,Wonder 的 Intelligence Index 分數為 52,Wonder Full 為 56。這些結果僅適用於所列出的評估設定與基準測試版本,而非對所有可能工作負載的永久排名。
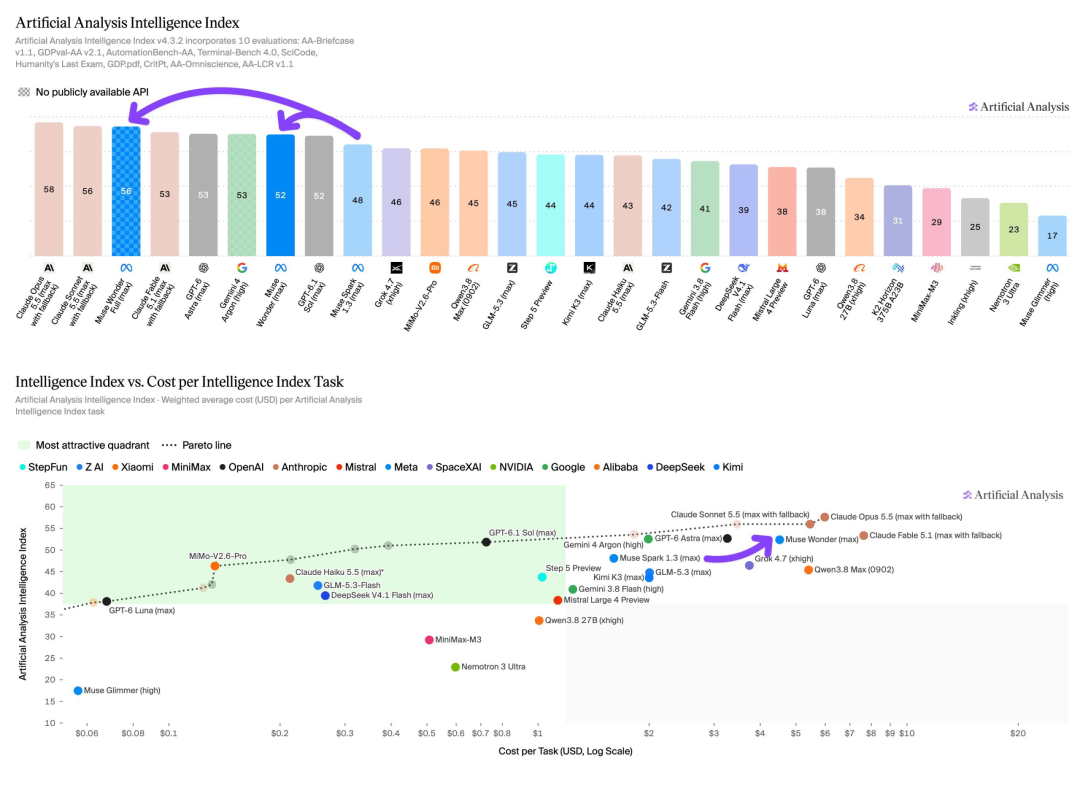
來源:Artificial Analysis 圖表,由新智元在 BAAI Hub 的報導中重製並加註。該圖比較了所示時間點的基準測試效能與任務成本;它並未衡量 Meta 的財務回報。
一個模型可能在基準測試中名列前茅,但對特定任務而言仍未必合適。來源報告中對視覺示範的不同反應,說明了為何應直接檢查生成產物,包括其功能性與一致性,而不應只依據排行榜名次判斷。
祖克柏的核心觀點之一是,模型行為本身就是產品決策。助理需要做的不只是正確回答:它還必須判斷哪些脈絡重要、何時應提問,以及在替使用者行動時該分享多少資訊。
Meta 的公告列出了兩項相關能力:
這些是 Meta 對系統的描述,而非每一項行動都必然恰當的獨立保證。儘管如此,它們顯示出產品正從單次提示與回答的互動,轉向必須做出更具後果性決策的持續型助理。
訪談以餐廳訂位為例說明判斷力。助理可能需要為某人尋找符合其健康或過敏需求的餐廳,同時不應不必要地向餐廳洩露私人細節。記住正確事實與決定揭露哪些資訊,是兩項不同的責任。
這個例子使記憶成為一個實際的信任問題。保留更多脈絡可以提升實用性,但成功的助理服務也取決於是否能選取相關資訊,並尊重任務的邊界。
對話轉向由代理人代表使用者購買商品或服務。祖克柏將商業交易與訂閱並列為可能的營收來源,而不是假定每一次消費者 AI 互動都必須以同一種方式獲利。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
協助選擇並購買商品的助理,其價值可能超越回答購物問題。困難之處在於如何讓最終行動可靠:理解請求、處理取捨,以及避免不受歡迎的購買結果,對使用者都很重要。
這場訪談並未證實存在通用交易費、已推出且規格完整的購物功能,或該未來模式已帶來經證實的營收貢獻。它描述的是 Meta 領導者認為具有前景的一個方向。
對開發者與企業而言,這項區分很有用。現有模型存取能力可以在今天評估;而擬議的商業交易模式,則需要採用率、交易行為與經濟效益方面的獨立證據。
兩位高階主管也談到超越智慧型手機的發展。智慧眼鏡讓助理能夠在日常活動中隨時存在,而有用的脈絡未必會以精心撰寫的提示形式出現。
這為記憶與判斷的討論提供了實體情境。能在現實世界活動中提供協助的助理,除了理解底層資訊外,還必須決定何時回應,以及應主動採取多少行動。
訪談將此呈現為產品願景。它並未證實所討論的每項能力都已在現有眼鏡上推出,或相關可靠性問題均已解決。
祖克柏與 Wang 認為,AI 不一定會成為贏家通吃的市場。他們的推理將不同的使用者需求、產品體驗與機會,連結到多家供應商可能共同成功的前景。
這是他們的預測,而不是已被觀察證實的最終市場結構。單一強勢模型發布、有利的基準測試成績,或龐大的基礎設施承諾,都無法單獨證實長期商業結果。
更有用的結論較為聚焦:Meta 正在打造一項結合研究、基礎設施、訂閱產品、潛在商業交易與硬體發行的策略。評估這項策略時,需要檢視每一個組成部分,而不能把單一模型分數視為完整的商業成果。
這場訪談並未證實此說法。Wang 回憶了 CFO Susan Li 發出的嚴重財務警告,但祖克柏與 Wang 也談到公司承受挫折與持續迭代的能力。
這些數字出現在 Meta AI 投資承諾規模的討論中。它們不應被描述為訓練單一模型的已披露帳單,因為基礎設施建設、容量與營運成本屬於不同類別。
Meta 的公告說明,可透過模型 API 與 Muse Code 使用 Wonder,而 Wonder Full 則提供給 Muse Code 訂閱者。讀者應查閱目前的產品條款,因為訂閱服務與 API 模型是不同的存取安排。
Meta 將 ActiveMemory 描述為在不同對話之間保留相關脈絡,並在有用時加以擷取。這描述的是預期能力,而非保證每項被記住的事實都會被正確選取或使用。
不是。基準測試衡量的是特定設定下的一組既定任務。在對工作流程做出結論前,應以具代表性的工作比較模型,包括輸出品質、可靠性、延遲與成本。
這場訪談將商業交易與訂閱並列為潛在營收來源。它沒有提供證據證明,所提出的代理人購物模式已經帶來特定的財務成果。
這場訪談說明了一項高風險投資決策:Meta 在能夠檢視預期打造的模型之前,就已做出該決策。它也將 Muse Wonder 連結至一項更廣泛的計畫,包括持續型助理、訂閱、商業交易與智慧眼鏡。
財務壓力十分龐大,但這場訪談支持的是對投資風險與產品策略的討論,而非一個已被證實的破產情境。
從一句話開始,幾分鐘內拿到完整網站。