For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7 將一個 350 億參數的混合專家模型帶到包括手機在內的本地裝置。ModelBest 與 OpenBMB 表示,透過最佳化部署堆疊,該模型在 iPhone 17 Pro Max 上可在約 3 GB 記憶體占用下達到每秒超過 13 個生成權杖。

MiniCPM-V 4.7 將一個 350 億參數的混合專家模型帶到包括手機在內的本地裝置。ModelBest 與 OpenBMB 表示,透過最佳化部署堆疊,該模型在 iPhone 17 Pro Max 上可在約 3 GB 記憶體占用下達到每秒超過 13 個生成權杖。
這個數字需要放在脈絡中理解。它並不表示完整的 35B 模型可裝進 3 GB 的下載檔案中,也不代表任何配備 3 GB RAM 的手機都能以宣稱的速度執行。該模型會從儲存空間串流載入專家權重,並利用排程、量化及推論最佳化,讓活躍工作集維持在較小規模。
此版本有兩個主要變體:
| 變體 | 設計 | 預定用途 |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | MoE,總參數量為 35B,且每個權杖約有 3B 活躍參數 | 更強的本地影像、文件、多影像與影片理解能力 |
| MiniCPM-V 4.7 1B | 小型稠密模型;QbitAI 將其描述為約 1.3B 參數 | 較低資源需求的視覺任務、OCR 與文件擷取 |
35B-A3B 模型是 MiniCPM-V 系列中的首個 MoE。專案於 2026 年 10 月 12 日發布 4.7,接著於 10 月 15 日為兩個變體發布 DSpark 推測式解碼頭。
儲存庫列出對 iOS、Android 與 HarmonyOS 的部署支援,也描述支援 Intel、AMD、Arm、Rockchip 與 Houmo 平台。實際效能取決於裝置、模型格式、推論後端與設定,因此不應將平台支援解讀為各種硬體均可取得相同速度。
官方 35B-A3B 評測表在 Instruct 模式下報告以下結果:
| 基準測試 | 4× 視覺壓縮 | 16× 視覺壓縮 |
|---|---|---|
| MMBench | 91.72 | 90.87 |
| MMStar | 80.67 | 80.13 |
| MMMU | 80.22 | 80.00 |
| MathVista | 88.00 | 87.30 |
| OCRBench | 91.20 | 90.40 |
| OmniDocBench v1.6 | 94.24 | 93.25 |
| Video-MME,無字幕 | 76.40 | 74.70 |
| LongVideoBench | 68.90 | 67.60 |

來源:OpenBMB,MiniCPM-V 儲存庫。其表格結合公開報告與團隊使用 Instruct 模式官方檢查點進行的本地評測。
該表顯示,切換至更高的視覺壓縮後,多項任務的下降幅度相對較小。例如,MMBench 下降 0.85 分,而 OCRBench 下降 0.80 分。其他任務的損失較大,因此開發者仍需確認小字、圖表或視覺細節是否對自身工作負載很重要。
這些是模型評測結果,而非證明行動裝置設定可重現每一項分數,或保證每張使用者影像都能被正確理解。它們是選擇測試項目的有用參考點。
MoE 透過僅啟用一個權杖所選定的專家來減少運算量。但它並不消除儲存其他專家的需求,因為後續權杖與層可能選擇不同專家。
在記憶體受限的手機上,將這些權重儲存在快閃儲存中可使模型可用,但反覆等待儲存空間回應可能讓解碼速度變慢。將路由限制為固定的專家子集可減少載入量,卻會改變模型可使用的專家。MiniCPM-V 4.7 則嘗試在保留路由器實際決策的同時,讓載入與運算重疊進行。
前瞻專家排程(Lookahead Expert Scheduling,LES)會預測下一層可能需要哪些專家,並預先載入其權重。當實際路由器選擇專家時,推論引擎會先計算已可用的選定專家,同時載入其餘必要專家。
此預測會改變準備與執行順序,但不會取代模型的路由決策:預測未命中的專家仍會在被選中時載入並評估。這項差異說明,該技術能夠提升速度,而不必依賴永久縮減的專家池。
官方指南將 LES 與細粒度、逐層量化結合。更小的專家權重可減少儲存空間與記憶體之間的資料傳輸,而最佳化版面配置使載入更有效率。團隊表示,其裝置端最佳化工作在實際裝置上帶來五倍解碼提升;這是針對其測試設定的結果,而非通用倍數。
DSpark 增加了一個草稿模型,先提出權杖供主模型驗證。此版本為兩種尺寸均提供專用草稿頭。這也是最佳化堆疊的一部分,因此不應假設在通用後端執行的標準檢查點能達到相同速度。
在視覺方面,模型基於 LLaVA-UHD v4,在視覺編碼器內使用早期壓縮。提早合併視覺權杖可減少後續編碼器層的工作量。可選的 4× 與 16× 設定,呈現視覺細節與推論成本之間的取捨。
官方行動應用程式文件對完整部署提供了更清楚的說明:
| 行動部署項目 | 文件所列需求或大小 |
|---|---|
| 已驗證的 35B-A3B 手機 | 配備 12 GB RAM 的 iPhone 17 Pro Max |
| 35B-A3B 示範建議裝置 RAM | 至少 12 GB |
| 35B-A3B 模型總下載大小 | 約 16.6 GB |
| 建議可用儲存空間 | 模型檔案約 17 GB |
| 專家儲存 | 獨立的 experts/ 目錄,包含 40 個分片與一份資訊清單 |
| 預設示範上下文視窗 | 4K 權杖 |
拆分後的行動套件不同於標準的完整模型 GGUF。其主要 -les 檔案依賴相符的專家目錄,且應用程式會檢查檔案是否一致。更大的上下文視窗會增加 KV 快取記憶體用量;而在較低 RAM 裝置上使用較小的專家快取,可能使生成速度顯著下降。
較小的工作記憶體數字,並不代表無需大量且高速的本地儲存空間。
QbitAI 的文章展示本地手機與平板範例,接著另行展示 API 測試。維持這項區分很重要:API 結果並不能證明相同任務是在手機上離線執行。
在開頭的 iPhone 示範中,模型檢視米納爾(Minard)描繪拿破崙俄國戰役的圖表。當被詢問最低溫度及其日期時,它辨識出 1812 年 12 月 6 日的 −30° Réaumur,並以 °C = °Ré × 1.25 將其換算為 −37.5°C。
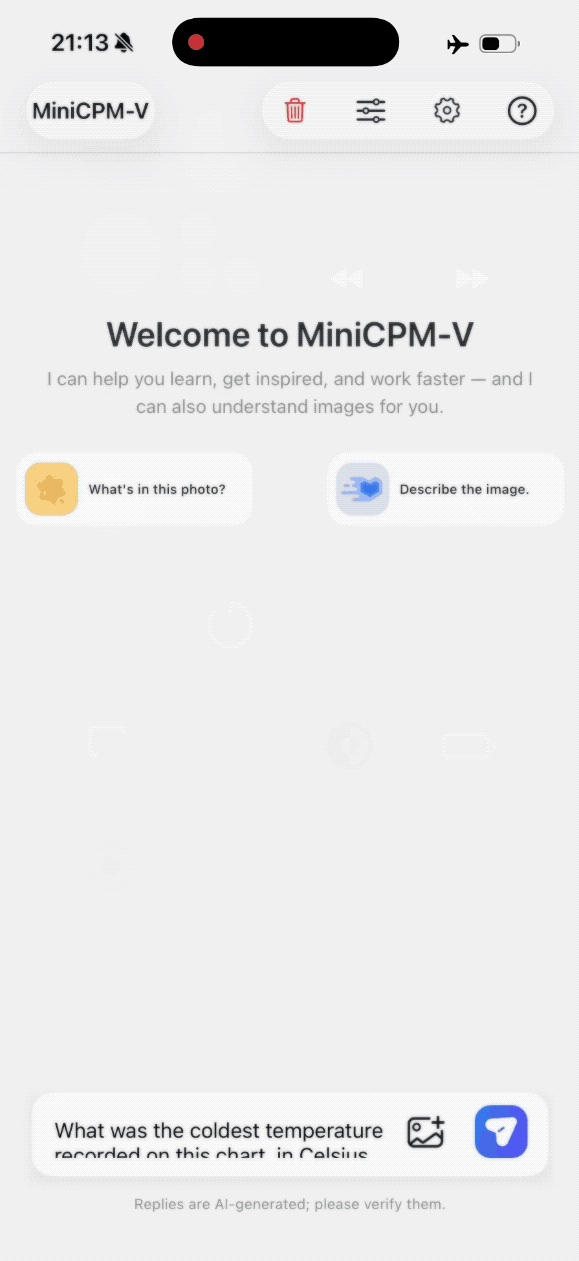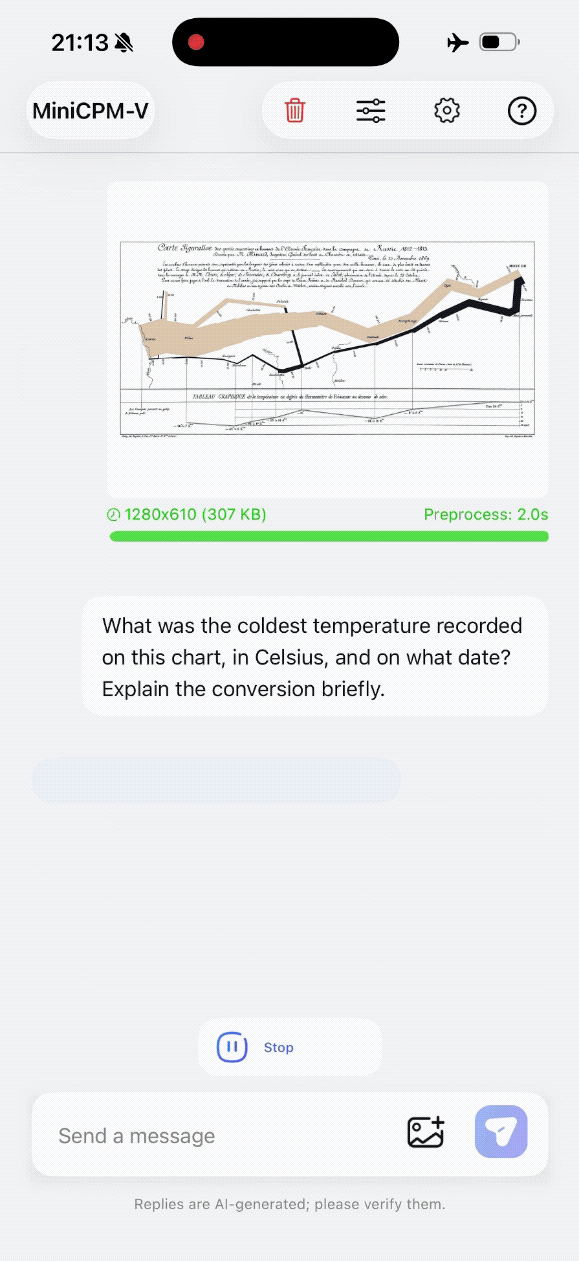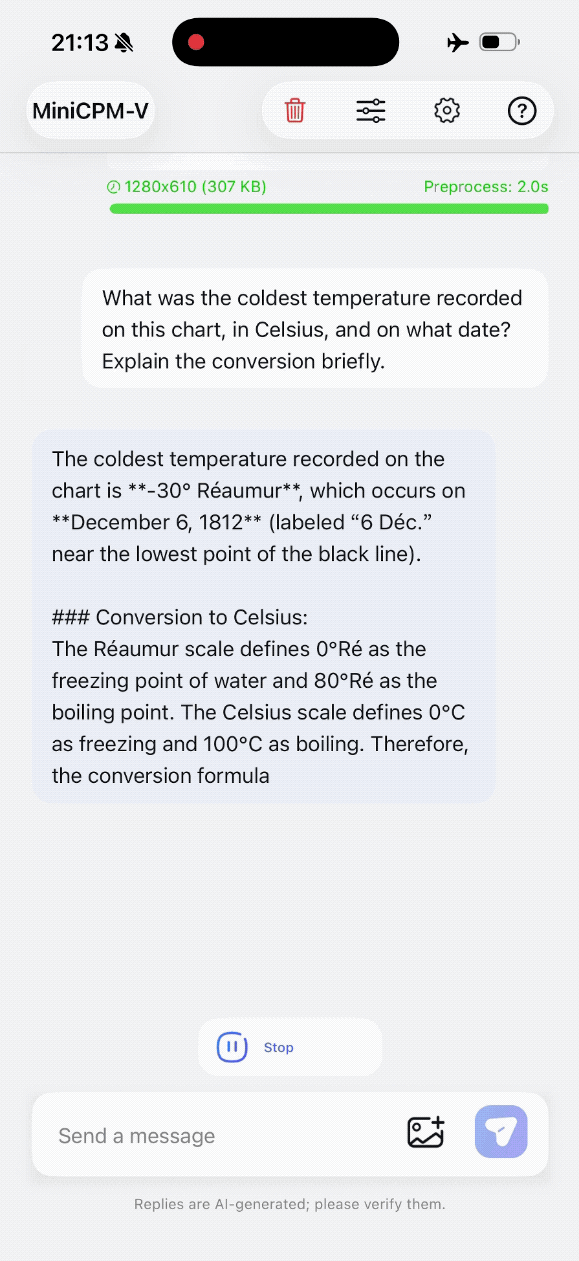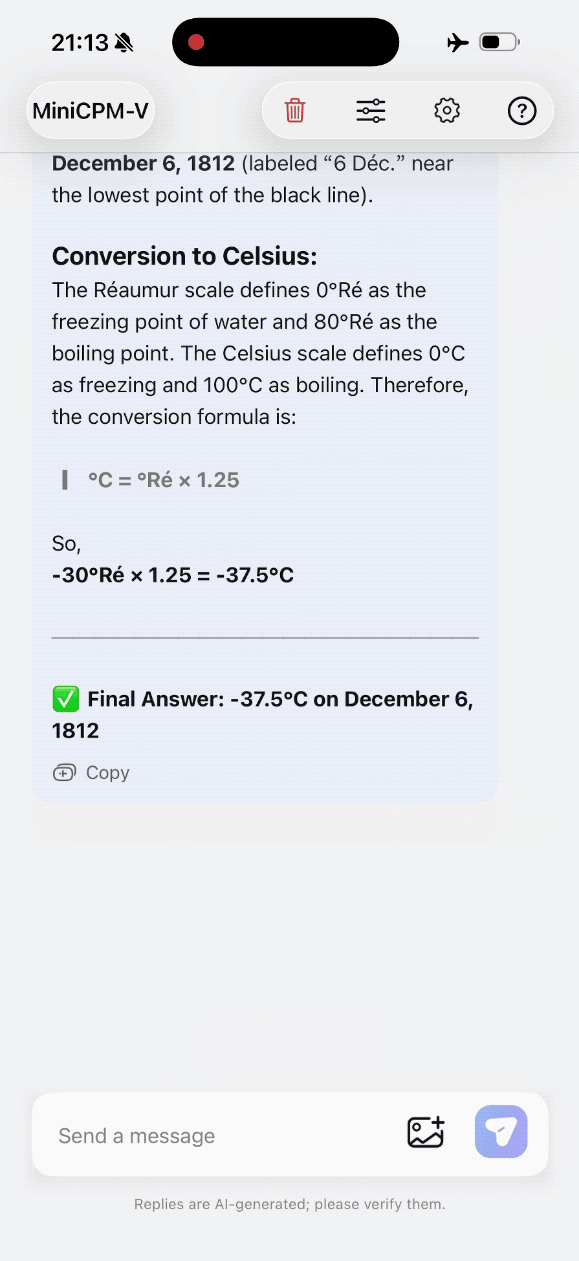
來源:QbitAI 經由 BAAI;手機螢幕的動畫錄影。該來源亦報告在 M4 iPad 上得到相同答案。
這個範例測試的不只是文字辨識。模型必須讀取圖表、將日期與相關資料點關聯、辨識溫度刻度,並進行換算。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
另一個範例結合電器瓦數與使用時間,以及每月 420 kWh、費用 ¥126 的帳單。所報告的輸出估計,列出的電器共使用 213.63 kWh,約占帳單的 50.9%,並在三個節能方案中判定減少空調使用為最佳方案。
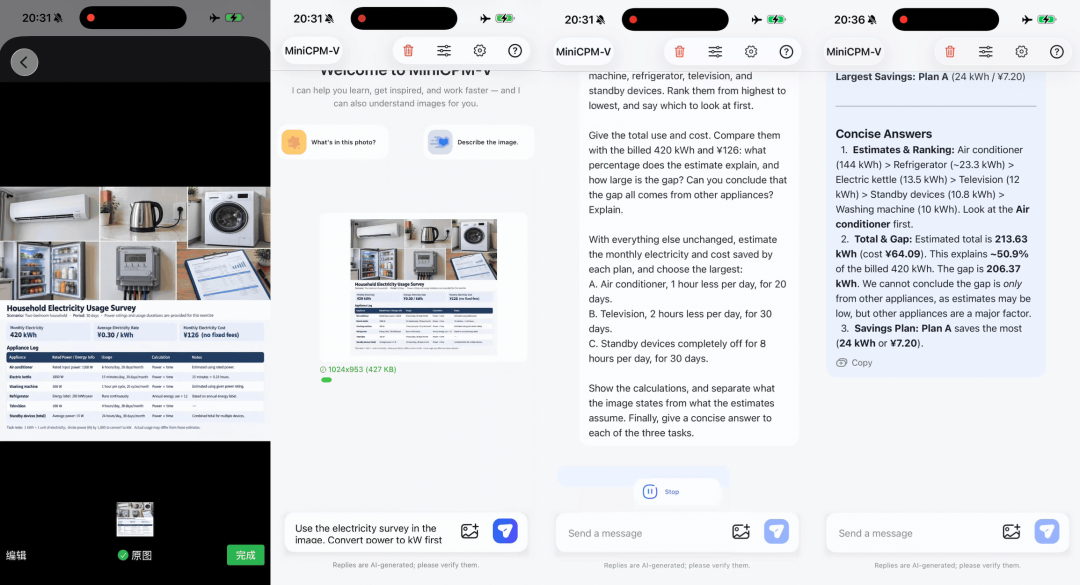
來源:QbitAI 經由 BAAI。顯示的答案將未解釋的耗電量視為不確定因素,而不是自動歸因於其他電器。
這項限定很有用:估算的使用時數、實際功率,以及未列入的裝置都可能影響帳單比較。僅有正確的算術總和,並不能證明其餘耗電量的成因。
較小模型被展示可將論文頁面轉換成 Markdown,包括標題、表格與數學符號。QbitAI 表示,該示範耗時不到半分鐘。
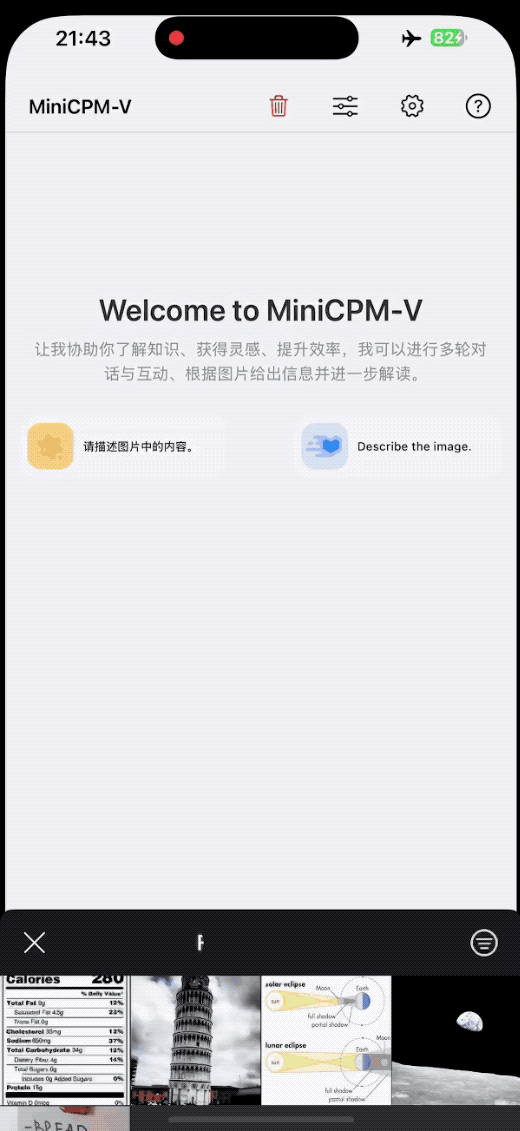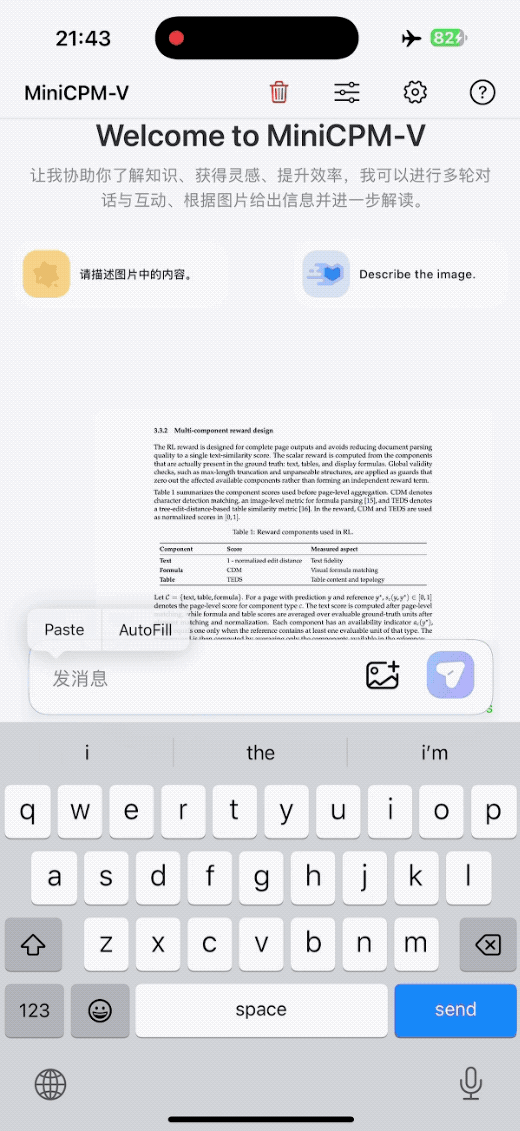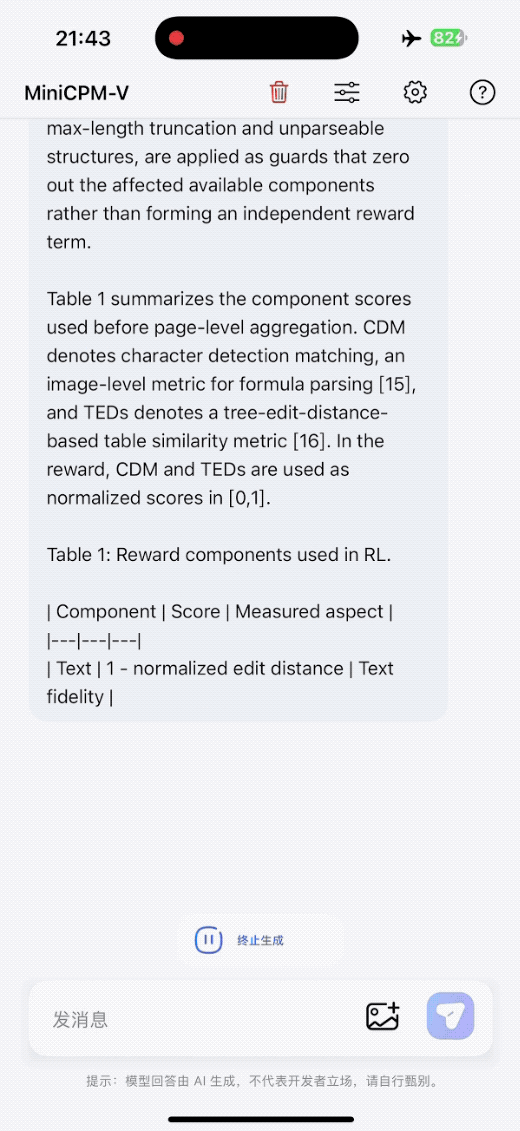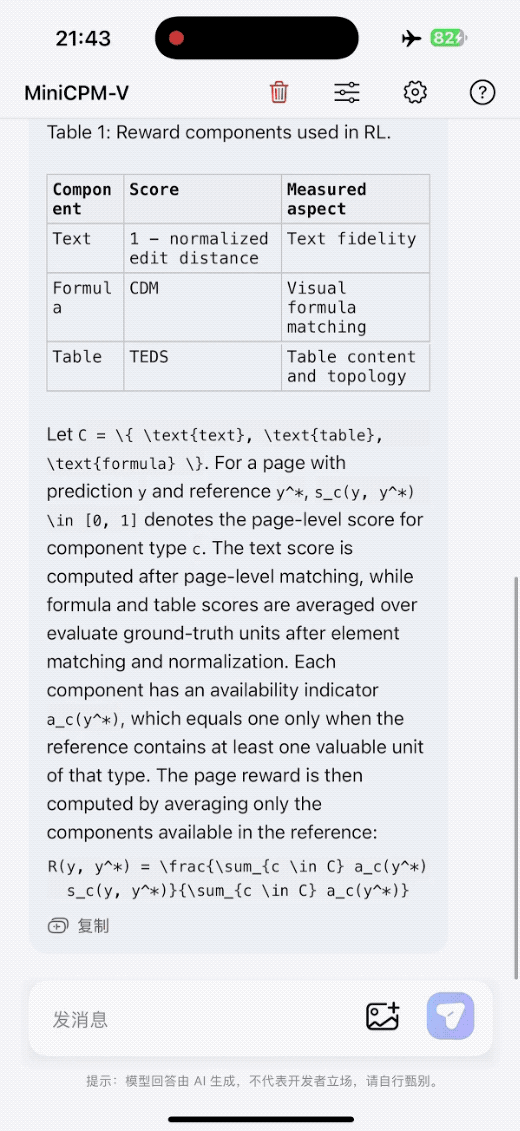
來源:QbitAI 經由 BAAI;本地文件示範動畫。
在其另行進行的 API 測試中,文章報告一筆收據計算為 ¥86.40 減去 ¥8 折扣,與 ¥78.40 的付款金額相符。文章也描述一項停車規則任務,該任務會依據清潔限制、兩小時上限、居民豁免及重新進場條件,檢查 90 分鐘停留時間。這些是說明性測試,並非系統性的準確率研究。
另一項相關發布針對客製化期間的遺忘問題。自我重播微調(Self-Replay Fine-Tuning)會從原始模型生成通用領域回應,依品質進行篩選,並在標準監督式微調期間,將保留的範例與新任務資料混合。
該方法改變的是訓練資料,而非模型架構或損失函數。重播範例可在訓練前生成並重複使用,減少每次執行時對全新線上 rollout 的需求。
OpenBMB 的文章報告在計數與文件 OCR 實驗中有令人鼓舞的保留結果,包括對早期 MiniCPM 模型及其他模型家族的測試。這些結果不應被表述為對每一個 4.7 微調都適用的全面保證。提示覆蓋範圍、篩選品質與任務資料對重播資料的比例,仍屬實驗性選擇。
行動應用程式儲存庫提供 iOS、Android 與 HarmonyOS 示範。對於手機 MoE 路徑,其應用程式內模型管理器會下載相符的主檔案、視覺投影器與專家分片;儲存庫警告,普通未拆分的桌面 GGUF 檔案不能與此行動套件互換。
對於其他部署方式,4.7 指南列出 SGLang、vLLM、llama.cpp 與 Ollama,以及用於微調的 SWIFT 與 LLaMA-Factory。它連結到包括 GGUF、BNB、AWQ、GPTQ 與 FP8 的量化選項。應依預定執行環境選擇對應產物,而非將每種受支援格式都視為可直接替換的行動模型。
必要的應用程式與模型檔案已存在本地後,即可開始離線推論。這免除了將每次推論請求傳送至雲端模型的需求,但應用程式權限、本地資料處理、儲存空間與硬體效能,仍是實務上的部署考量。
這是由 ModelBest 與 OpenBMB 推出的多模態模型版本,提供 35B-A3B MoE 與小型 1B 變體。它支援影像、文件、多影像與影片相關任務。
該專案展示了 iPhone 17 Pro Max 上經最佳化的 35B-A3B 部署。它將較小的工作集保留在記憶體中,同時從本地儲存空間串流載入專家,而不是一次將所有 35B 參數載入 RAM。
不是。官方行動示範列出 35B-A3B 套件總下載大小約為 16.6 GB,並建議保留約 17 GB 可用儲存空間。其已驗證的 iPhone 配備 12 GB 裝置 RAM。
不會,LES 會預測需預取的專家,並優先排程已可用的專家。模型的實際路由器仍會選擇要計算的專家,包括任何未被預測命中的專家。
可以,一旦所需檔案已下載或安裝,本地示範會在裝置上執行推論。來源中的 API 範例是獨立測試,不應與離線操作混淆。
不可以,該示範需要相符的拆分套件,包括其 -les 主檔案、視覺投影器與專家分片。應用程式文件說明了為何標準完整模型 GGUF 檔案無法提供相同的手機部署行為。
MiniCPM-V 4.7 結合稀疏運算、專家串流、前瞻排程、量化與視覺壓縮,讓更大的多模態模型能在特定本地裝置上實際運作。示範涵蓋圖表解讀、文件轉換與日常計算,而已發布的基準測試則提供評估的起點。
部署的關鍵限制在於工作記憶體、裝置總 RAM 與已儲存權重之間的差異。手機結果可視為特定最佳化設定下可信的成果,而不是完整 35B 模型可裝入 3 GB,或可在每部裝置上同樣良好執行的承諾。
從一句話開始,幾分鐘內拿到完整網站。