For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/nvidia-vera-rubin-at-ocp-2026-mgx-1-2-dsx-6b3d7f12.md.
隨著 AI 工廠從百萬瓦等級邁向吉瓦級基礎設施,挑戰已不再僅限於在資料中心部署更快的加速器。電力傳輸、液冷、網路、可維護性、電網行為,以及可互通的機櫃設計,都必須同步擴展。
隨著 AI 工廠從百萬瓦等級邁向吉瓦級基礎設施,挑戰已不再僅限於在資料中心部署更快的加速器。電力傳輸、液冷、網路、可維護性、電網行為,以及可互通的機櫃設計,都必須同步擴展。
在聖荷西舉行的 2026 Open Compute Project Global Summit 上,NVIDIA 宣布一系列合作夥伴關係、開放式規格與軟體貢獻,旨在為下一代 AI 基礎設施建立更共通的基礎。
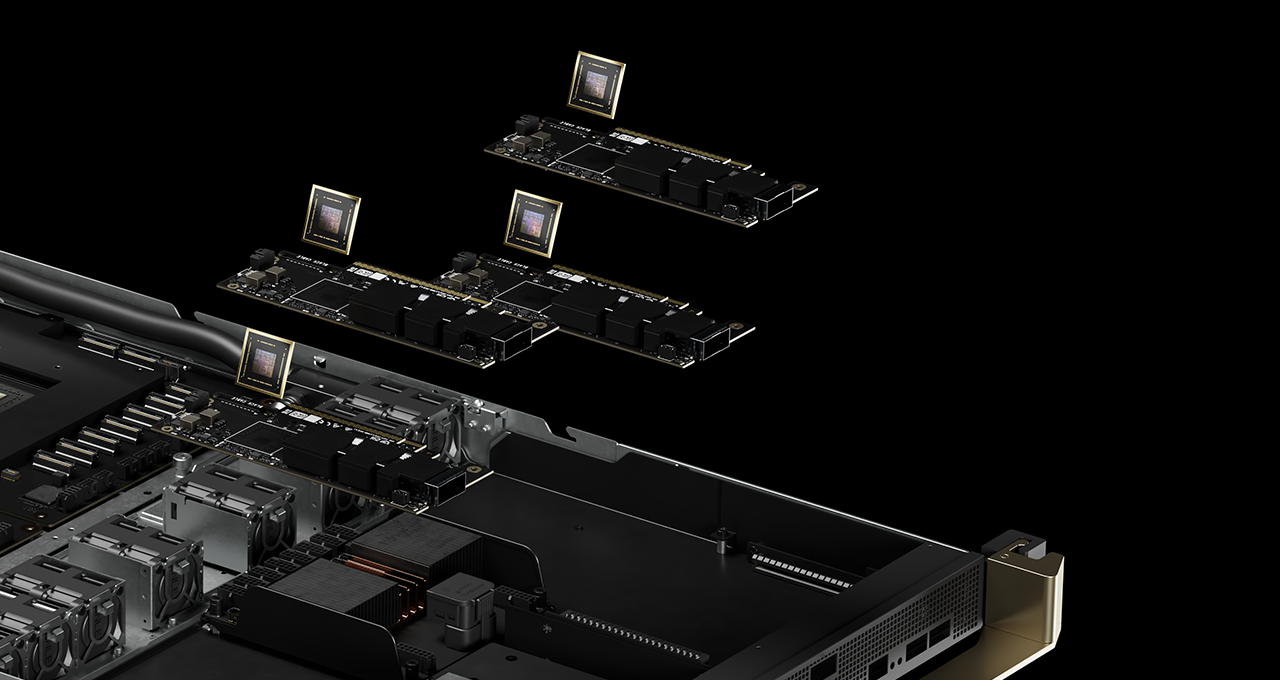
核心是 NVIDIA Vera Rubin。NVIDIA 透過開放式 NVIDIA MGX 架構,向 OCP 貢獻了關鍵的 Vera Rubin 機櫃與運算托盤設計,讓系統建置商與基礎設施合作夥伴能基於共享參考設計進行開發,而非各自獨立建構每一個層級。
這些公告涵蓋 AI 工廠彼此相連的三個層面:
其結果是朝向更開放、可重複部署的基礎設施邁進,讓合作夥伴能在全球規模下進行製造、部署與維護。
在 OCP Global Summit 2026 上,NVIDIA 與其生態系合作夥伴宣布多項圍繞 Vera Rubin 的基礎設施計畫。
重點公告包括:
在活動中,NVIDIA 超大規模運算與高效能運算副總裁 Ian Buck 表示,開放式基礎設施正成為在全球擴展 AI 工廠日益重要的一環。
這些公告的共同主軸是協同設計。運算、網路、電力、冷卻與軟體,正被視為單一系統的組成部分,而非彼此孤立的層級。
NVIDIA 與其他產業參與者共同透過 OCP 的 Open DC Initiative,貢獻第三代 MGX AI 資料中心參考設計。
更新後的 MGX 1.2 規格,將此架構延伸至更高功率、採液冷的 AI 工廠。
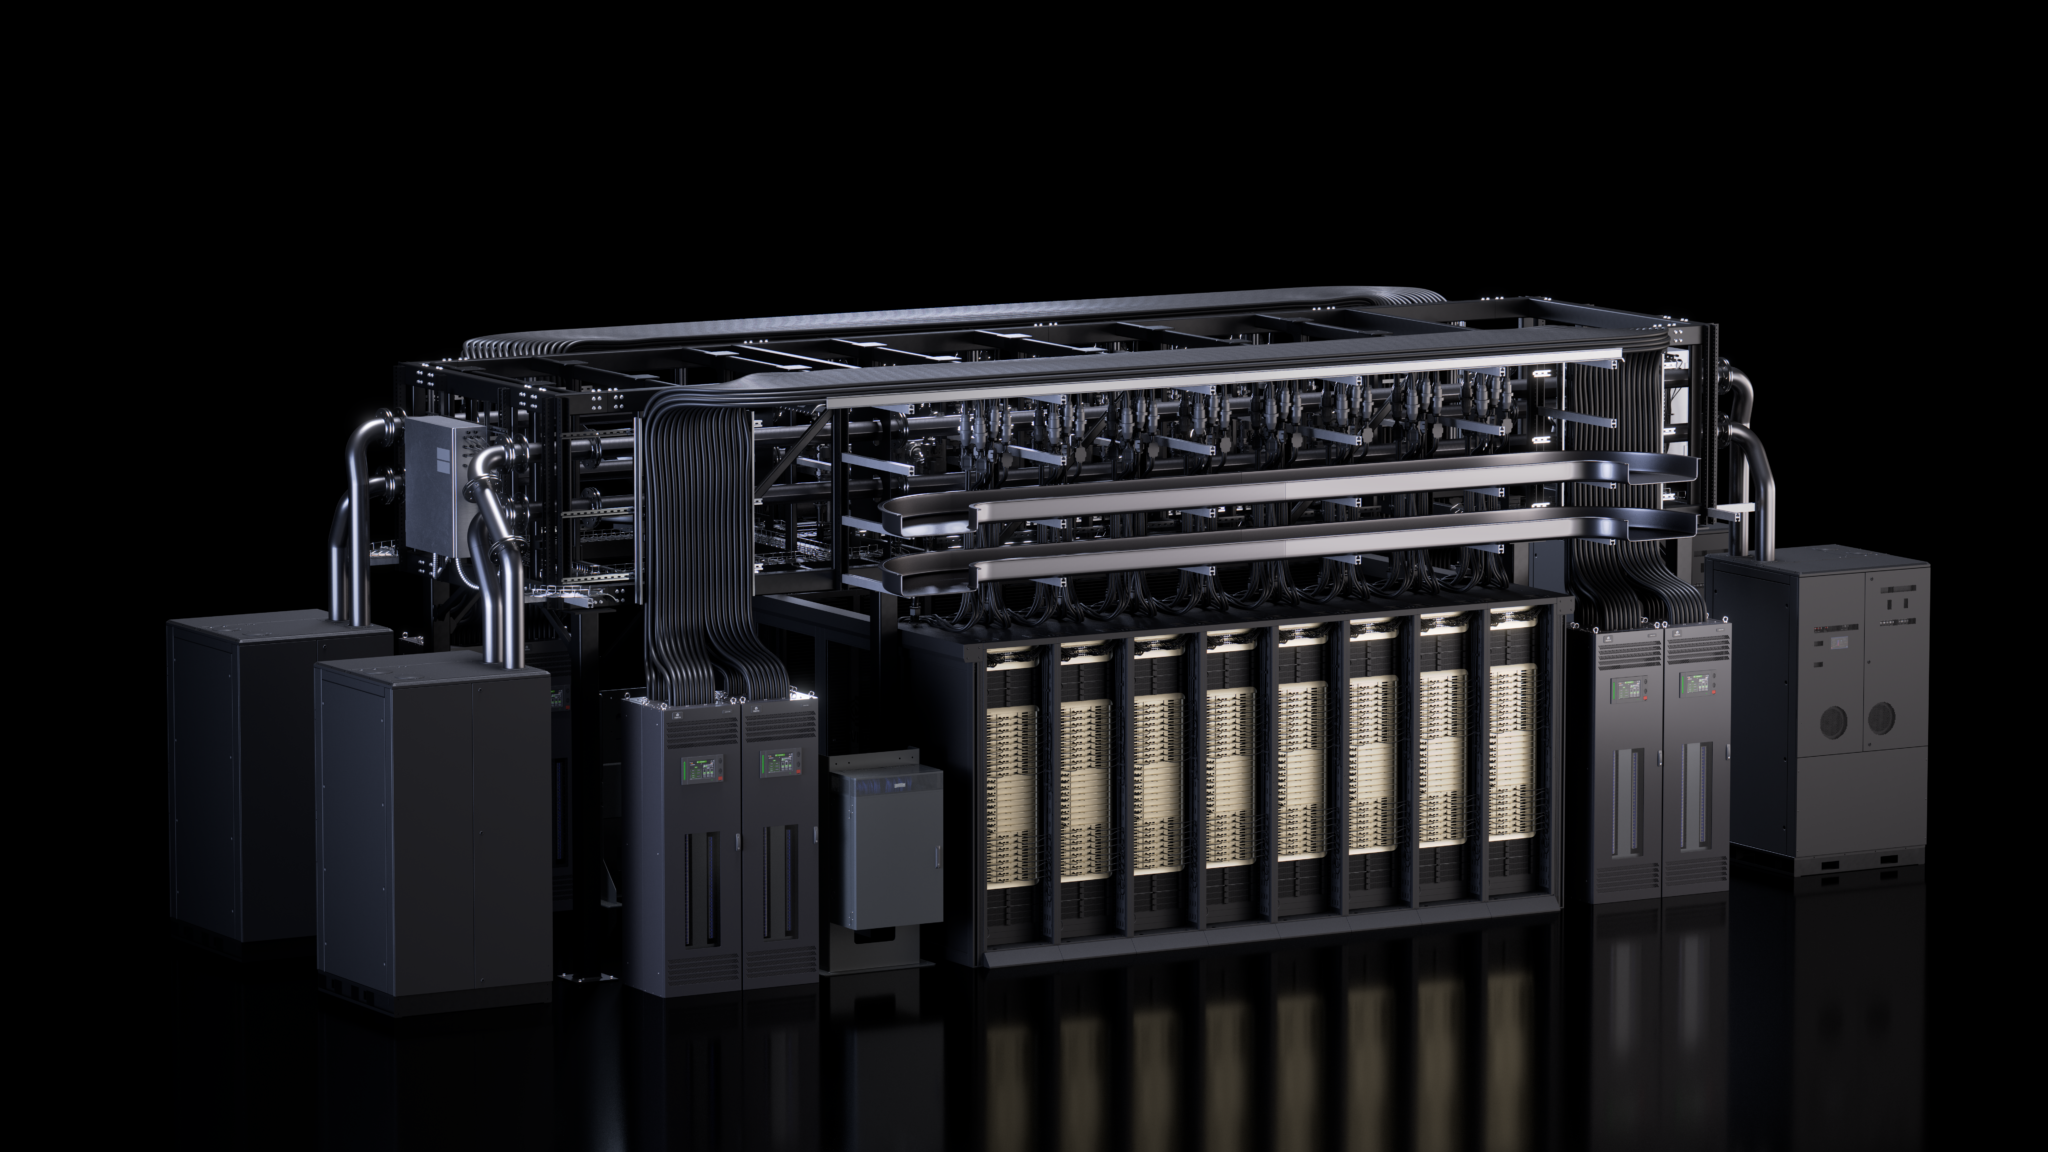
主要新增項目包括:
NVIDIA 表示,該架構可支援最高 250kW 的機櫃部署,同時改善可維護性與基礎設施重複利用能力。
MGX 是一種模組化參考架構,而非單一固定的伺服器設計。
這讓 OEM、ODM 與基礎設施合作夥伴能在共享的機械、電氣與冷卻基礎上建置,同時仍可採用不同的 CPU、GPU、網路與儲存組合。
對 Vera Rubin 而言,這代表合作夥伴能以既有的機櫃級設計為基礎進行建置,而不必每次都從專有平台重新開始。
Vera Rubin NVL72 平台整合:
它可再透過 NVIDIA Quantum-X800 InfiniBand 或 Spectrum-X Ethernet 擴展。
NVIDIA 也正將相同的 MGX 設計原則延伸至專用的 Vera CPU 機櫃。
Vera Rubin NVL72 專為大規模訓練與推論設計,Vera CPU 機櫃則面向 CPU 密集型代理工作負載,例如:
更廣泛的概念是,即使 AI 工作負載的不同部分需要不同的運算資源,實體基礎設施仍保持一致。
NVIDIA 的 DSX AI Factory 平台旨在將運算、網路、電力、冷卻、設施與軟體協調為一套最佳化系統。
軟體層的核心是 DSX OS,NVIDIA 將其描述為支援可重複 AI 工廠營運的開放式作業層。
在 OCP 上,NVIDIA 為 DSX OS 擴增四個開放原始碼元件。
NVIDIA Config Manager 可大規模自動化交換器設定。
其用途是協助營運商部署、驗證與維護一致的網路織構,盡可能減少手動設定。
NVIDIA Cluster Readiness Engine 在正式訓練開始前,透過工作負載模擬對 GPU 叢集進行壓力測試。
目標是及早發現硬體或基礎設施問題,避免代價高昂的訓練作業失敗。
NVIDIA Rack Management Service 提供機櫃級硬體抽象與營運層。
此軟體不再將每台伺服器視為獨立單位,而是將機櫃作為韌體管理與大規模基礎設施控制的一級營運單位。
NVIDIA Infrastructure Controller 的 Cluster API Provider 旨在加速裸機佈建與租戶上線。
NVIDIA 表示,其目標是將原始 AI 硬體在數小時內轉換為可投入生產的叢集,而非需要數天。
這些元件源自 NVIDIA 營運 DGX Cloud 的經驗,旨在讓 AI 工廠能力更容易整合至多租戶雲端平台。
大型 AI 部署不僅需要共享的機櫃設計。設施、冷卻系統、電力架構與公用電網行為,也需要共同的預期標準。
在 OCP 上,NVIDIA 與 AMD、Google 及 Meta 共同發布更新後的下一代 AI 基礎設施開放式資料中心規格。
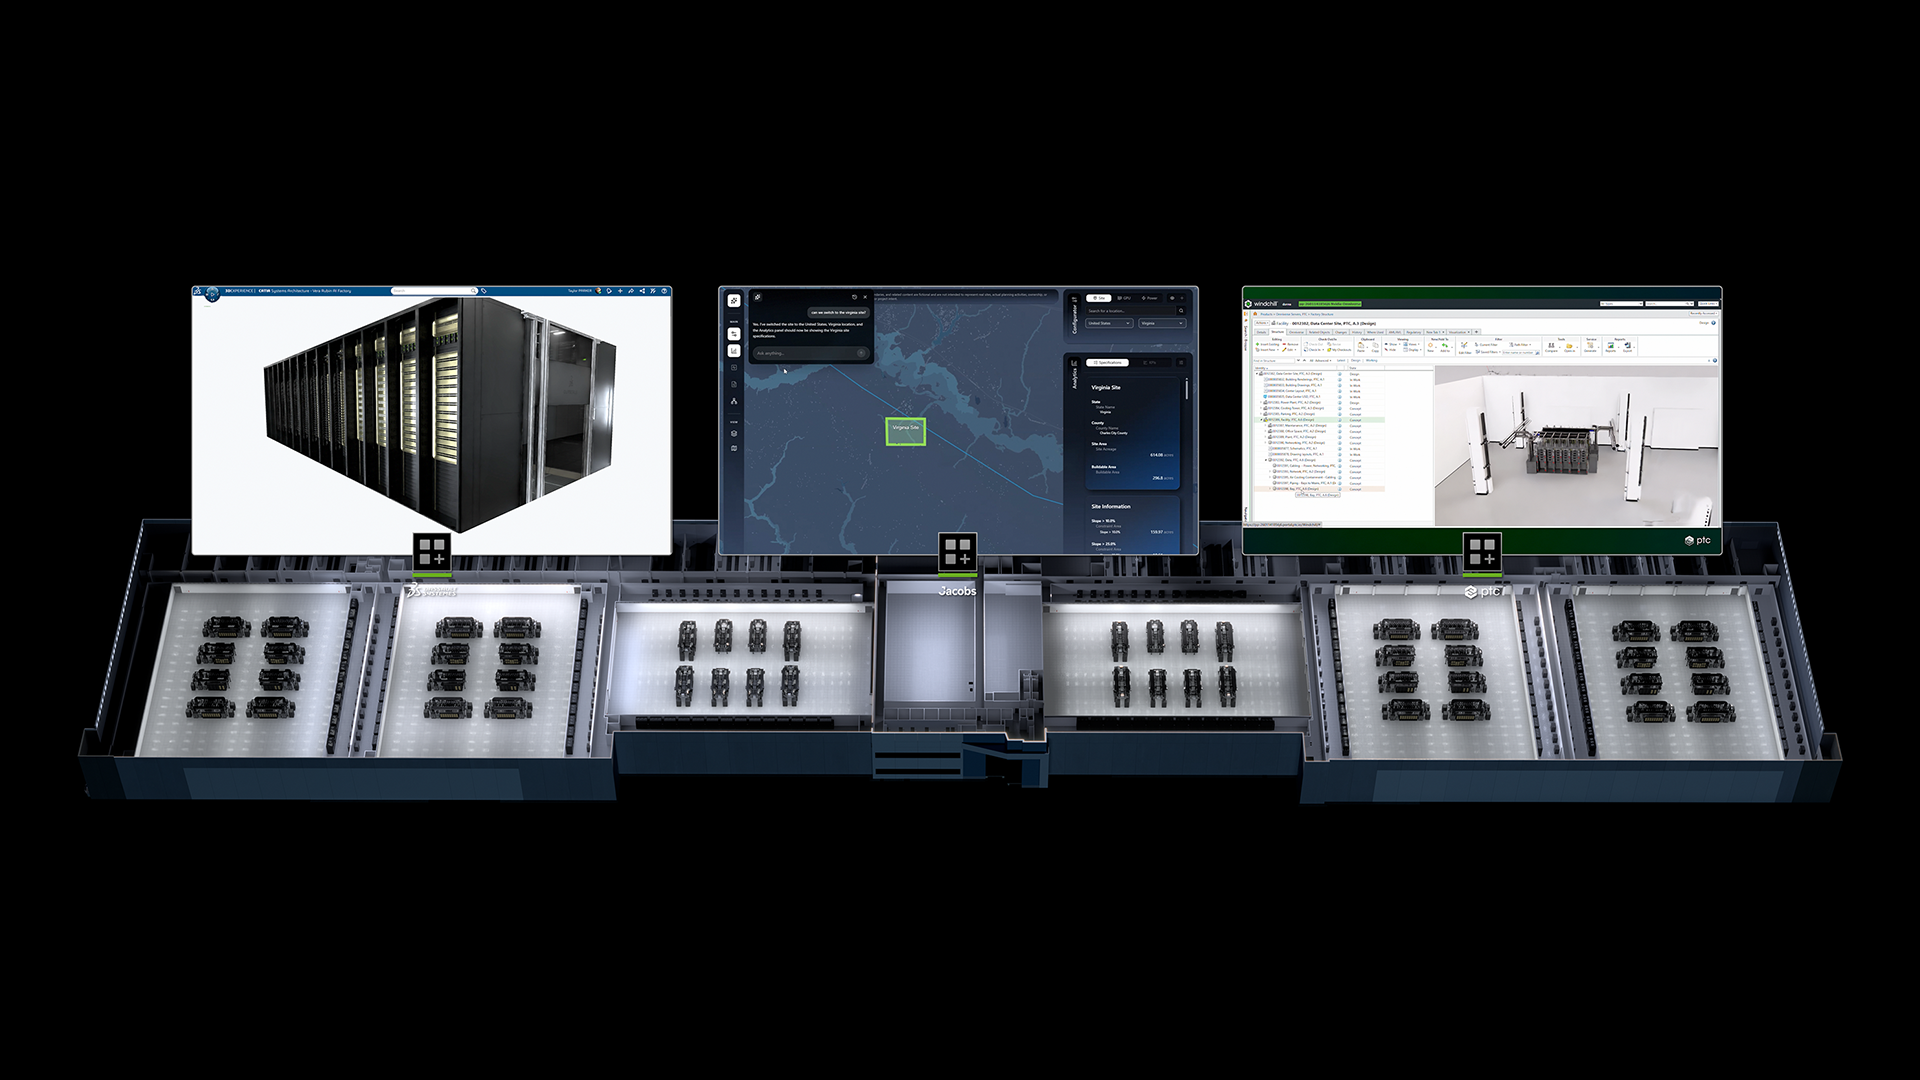
Open Data Center Specification v0.7 為 AI 工廠設施設計定義共同藍圖。
其涵蓋領域包括:
其目的在於為製造商、共置資料中心服務商與營運商提供共同目標,而非要求他們等待每位客戶各自提出專有規格。
Google、Meta、Microsoft 與 NVIDIA 也共同發布 OCP Grid Resilience Specification。
這份規格定義了超大型 AI 基礎設施在公用電網發生擾動時應有的行為方式。
設計目標是讓 AI 設施能夠:
隨著 AI 設施規模大到足以讓電力負載突然變化影響周邊電網,這一點正變得愈來愈重要。
NVIDIA 表示,其 DSX 參考設計提供了一條可部署的實作路徑,能將這些開放標準轉化為實際的 AI 工廠基礎設施。
功率密度正成為 AI 工廠設計中最大的限制因素之一。
隨著訓練、推論與推理叢集持續擴大,傳統低電壓配電需要愈來愈多的銅材、纜線與轉換硬體。
在 OCP 上,Visionbay.ai 發表 K-1 的規劃。這是一個以 800 VDC 架構為基礎、並針對未來 Vera Rubin 部署設計的 AI 工廠平台。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
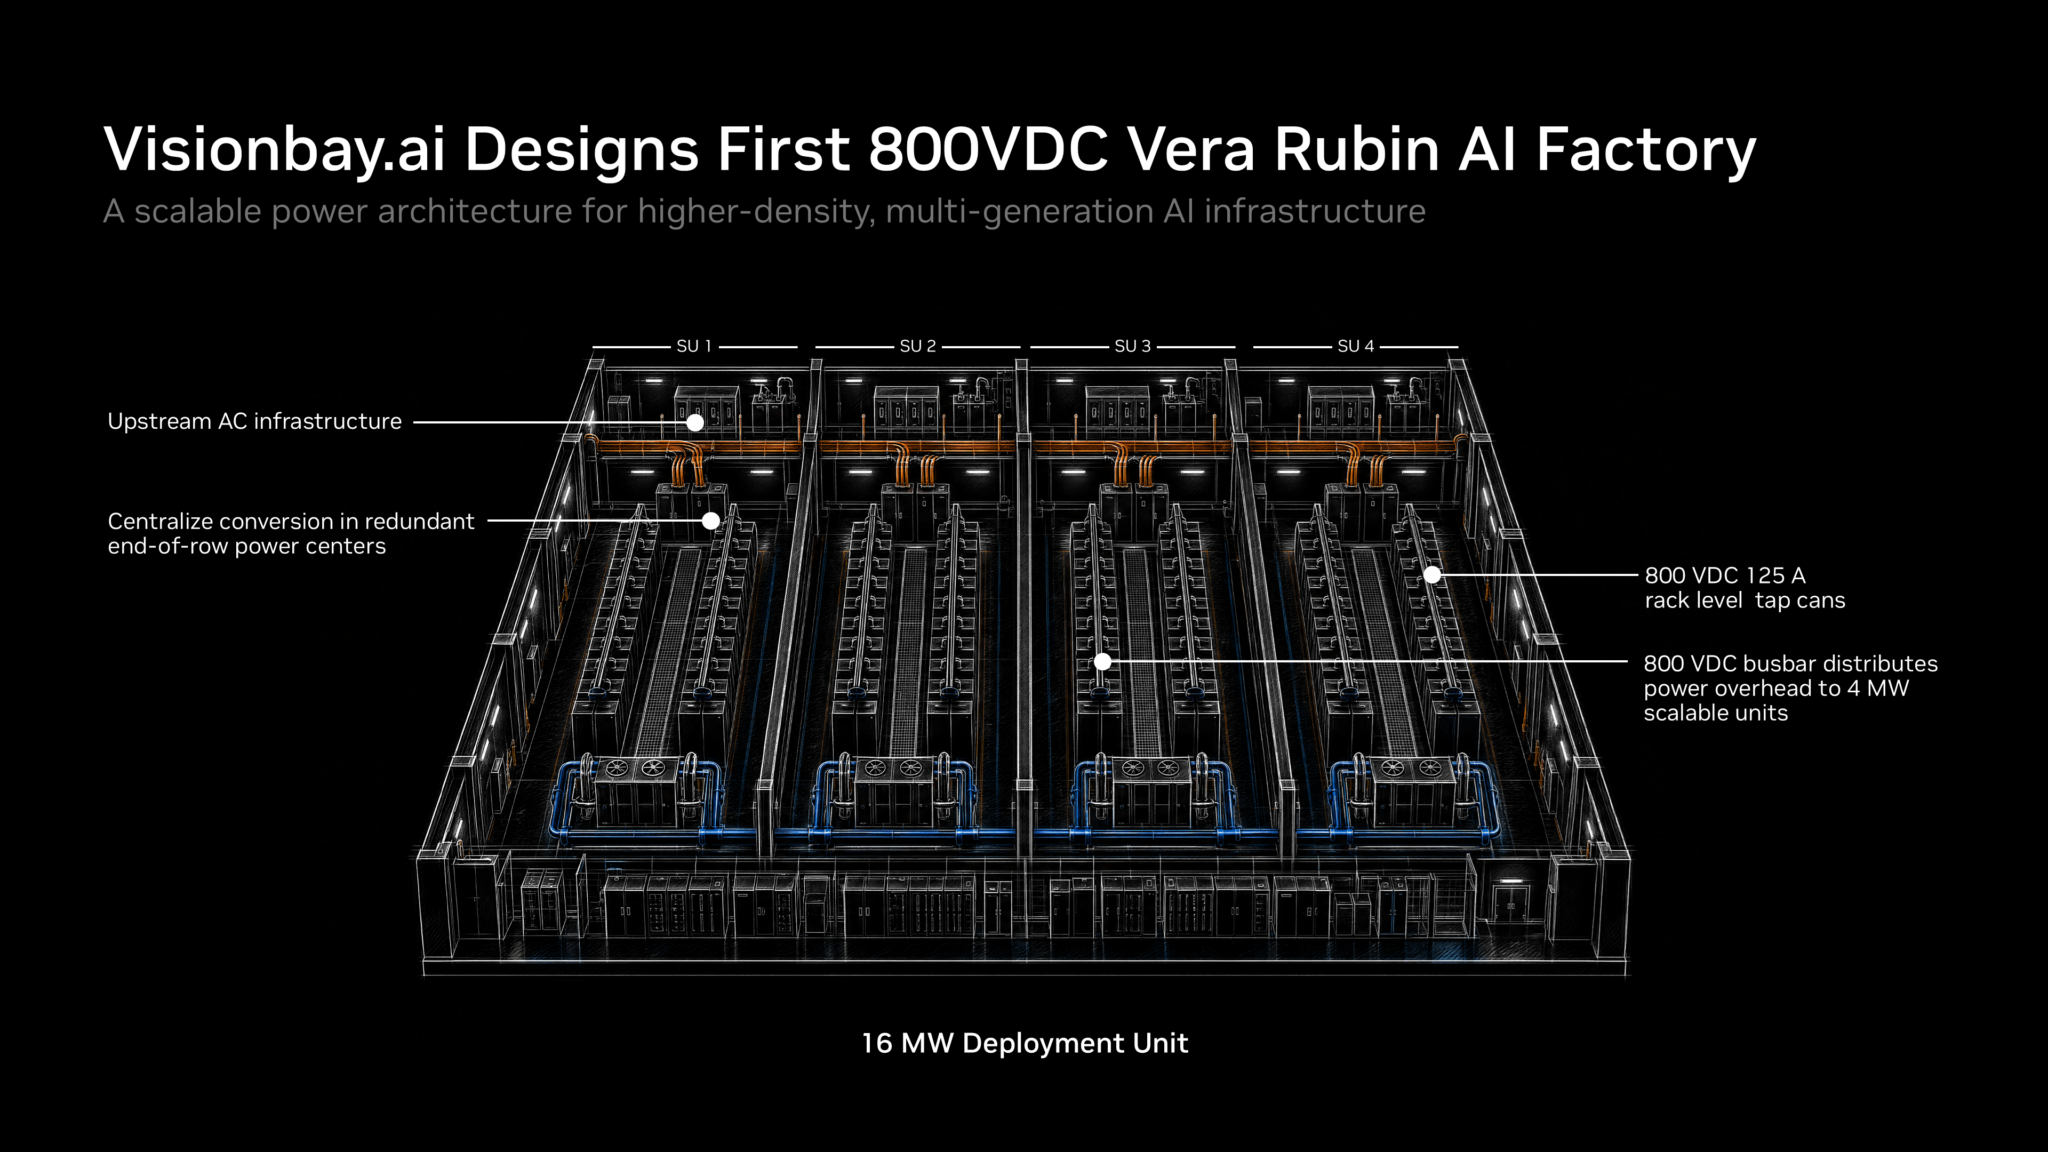
此設計結合 NVIDIA 的 800 VDC 參考架構,以及 Vertiv 的電力與熱管理技術。
此架構旨在將高電壓直流配電推進至更接近運算層的位置。
K-1 不再透過大量銅材反覆轉換與分配低電壓電力,而是使用叢集級電力中心集中進行 AC 至 DC 轉換,接著將 800 VDC 配送至更靠近機櫃的位置。
根據 NVIDIA,此做法可以:
此平台也設計為可漸進採用,而不要求整座設施一次全面轉向 800 VDC。
這讓營運商可在最具價值的區域導入高電壓直流電,同時保留與既有基礎設施的相容性。
在 OCP 上,Meta 與 NVIDIA 宣布其網路合作的下一步。
Meta 正為採用開放網路基礎設施的大型 Vera Rubin AI 工廠,導入 NVIDIA Spectrum-6 102.4Tb/s Ethernet 交換器。
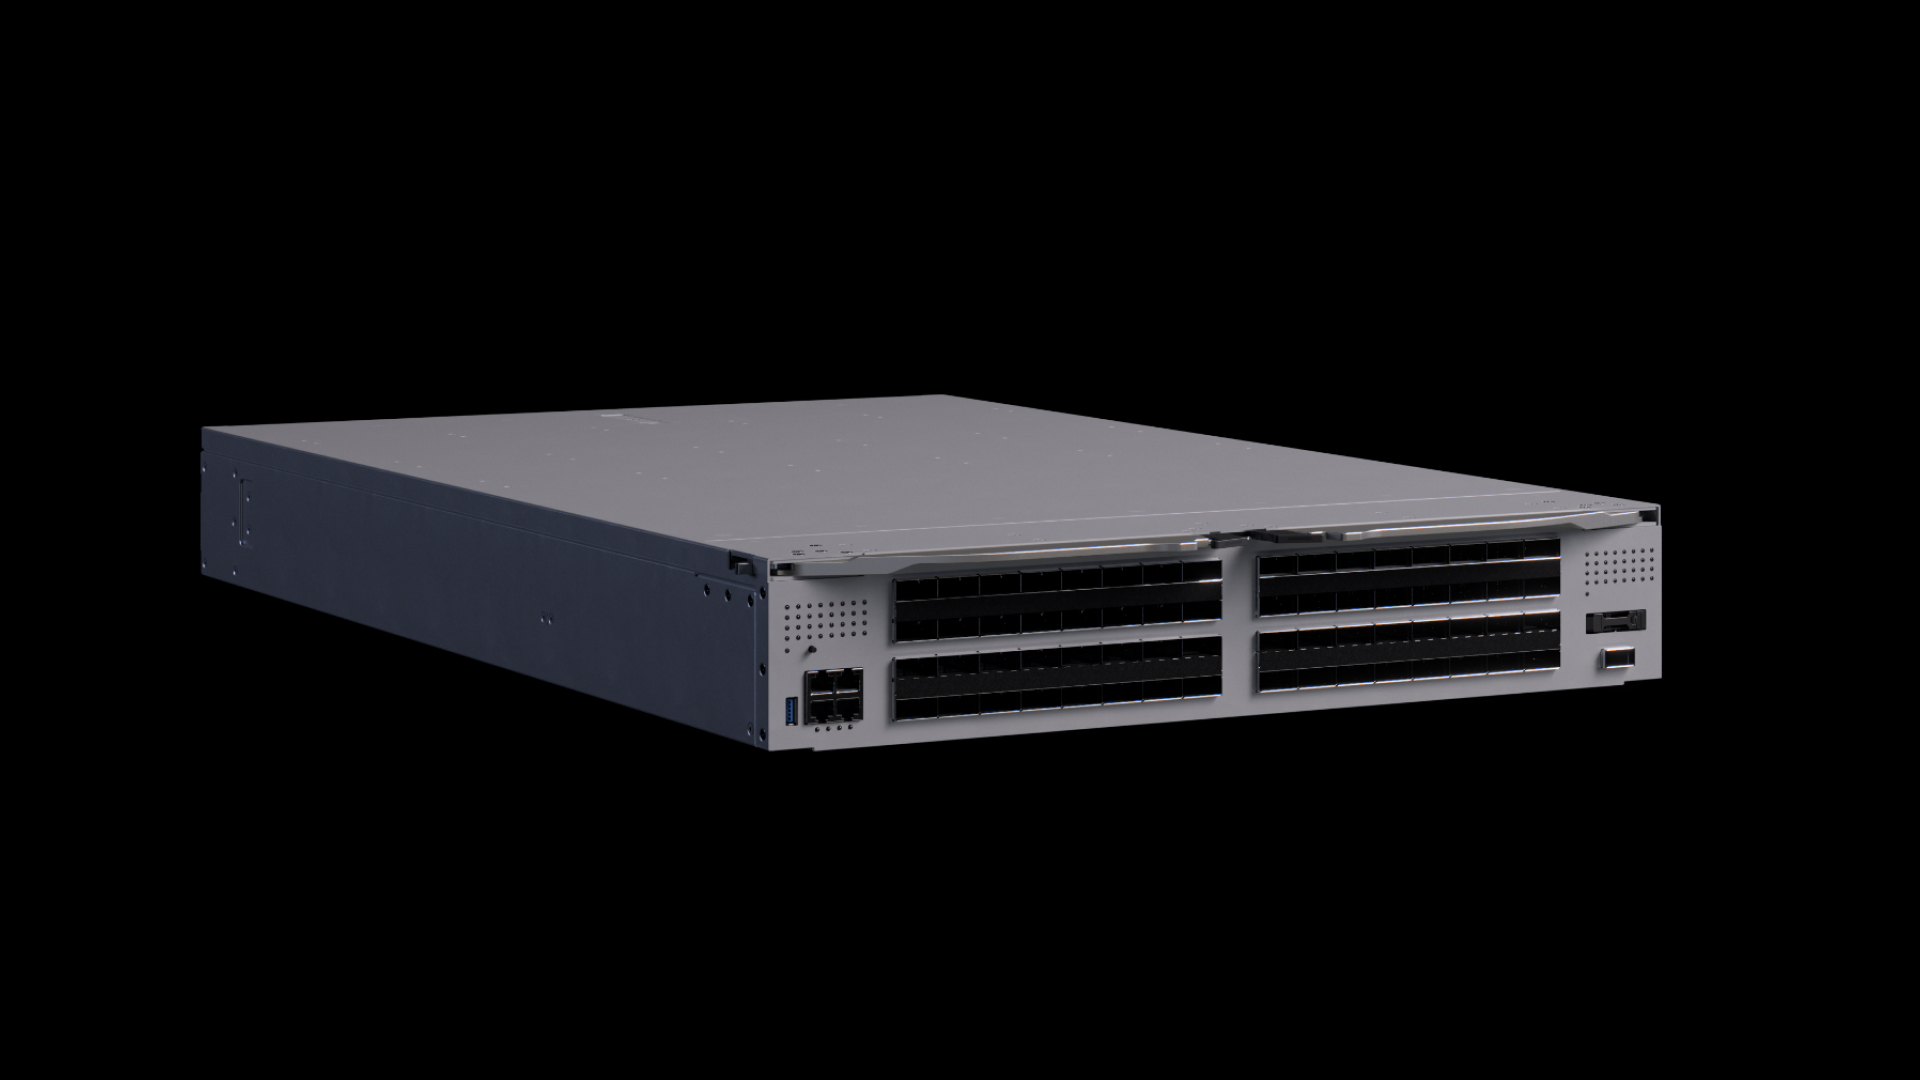
Spectrum-6 提供:
Meta 採用 Spectrum-6 的交換器名為 N-IceCube。
它設計為可安裝於 IcePack,也就是 Meta 的 100T 液冷網路機櫃。
N-IceCube 運行 Meta 的開放原始碼網路作業系統 FBOSS。
FBOSS 使用 Switch Abstraction Interface(SAI),這是一項 OCP 標準,可為控制交換器硬體提供與供應商無關的介面。
這讓 Meta 在採用 Spectrum-6 交換晶片的同時,仍可使用熟悉的軟體控制平面。
這項合作的一大核心是 Spectrum-X Multiplane 技術。
Multiplane 使用 Spectrum-6 交換器與 ConnectX-9 SuperNIC,可透過硬體將 GPU 流量分散到多達八個彼此獨立的網路平面。
此設計旨在支援超過 100,000 顆 GPU 的 AI 工廠,同時降低所需交換器層級數量。
多條路徑也能提升韌性。
若某個網路元件故障,流量可切換至其餘平面。工作負載可能以降低的頻寬持續運作,而不會失去整個網路織構。
其結果是一種網路架構,旨在同時具備高度可擴展性,以及在真實生產環境中更易於營運的特性。
隨著 AI 叢集規模擴大,實體光學連接本身也成為限制因素。
NVIDIA 與 Cisco 宣布 Ultra-Dense Small Form Factor Pluggable(USFP) 的規劃,這是一種面向下一代 AI 網路的新型可插拔光收發模組。
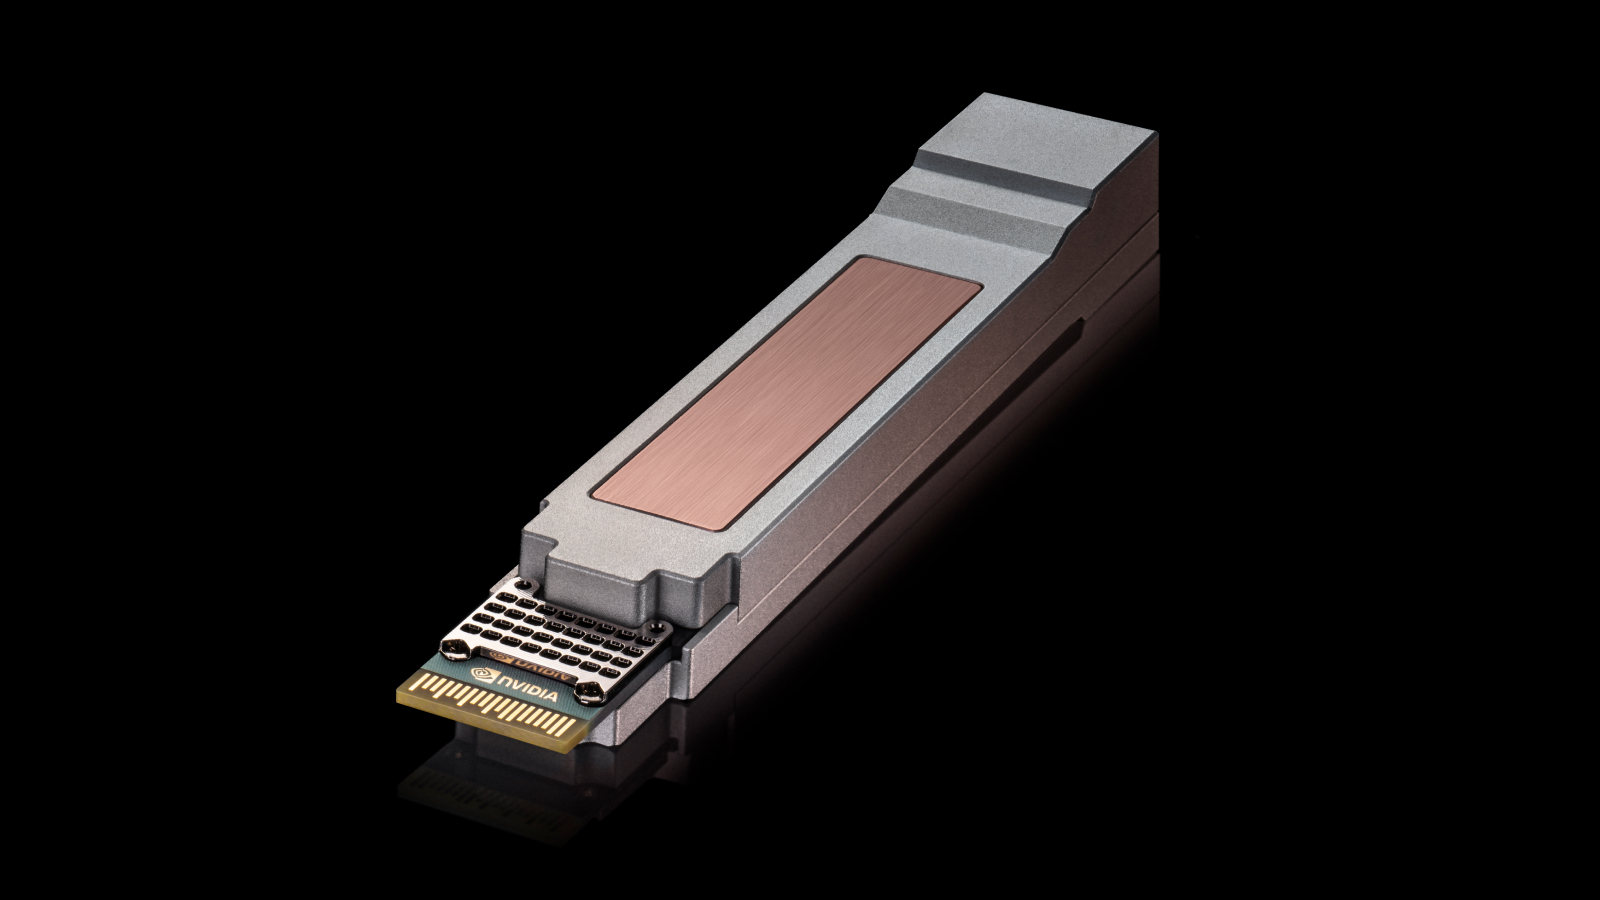
USFP 旨在為每通道 400Gb/s 網路提供發展路徑,同時維持與廣泛使用、每通道 200Gb/s 的 OSFP 外形規格大致相同的尺寸。
規劃中的設計包括:
目標是在不增加額外網路層級的情況下連接更多運算資源,避免增加延遲、耗電與營運複雜度。
NVIDIA 與 Cisco 正與 TE Connectivity 及 Amphenol 合作開發插槽、連接器與模組,並計畫透過由社群主導、多來源供應的方式推進 USFP。
這讓設計符合 OCP 更廣泛的可互通性主軸,而不是形成單一供應商的光學元件生態系。
NVIDIA 與 Google 也宣布,Falcon Transport 將支援未來的 NVIDIA ConnectX-10 SuperNIC 與 BlueField DPU。
Falcon 是一種傳輸協定,專為 Ethernet 網路上的可靠高效能通訊設計,尤其適用於壅塞情況。
它支援:
此合作結合 NVIDIA 硬體加速與 DOCA 軟體來實作 Falcon,同時保留供應用程式使用的標準 RDMA 程式設計介面。
這一點很重要,因為它讓 NVIDIA 與 Google 的網路硬體擁有共同的傳輸層,同時讓軟體繼續使用熟悉的 RDMA API。
在大型 AI 網路織構中,Falcon 可將流量分配至不同路徑、因應壅塞並從封包遺失中復原,而不需要應用程式直接管理這些細節。
NVIDIA 透過開放式 MGX 架構向 OCP 貢獻關鍵的 Vera Rubin 機櫃與運算托盤設計,並參與新的設施、電網與網路標準制定。它也發布四個新的 DSX OS 開放原始碼基礎設施元件。
MGX 1.2 是用於高密度加速運算的更新版機櫃級參考架構。它新增盲插式液冷、5,000A 匯流排、原生 19 吋支援、可配置 I/O 插槽,以及最高 250kW 機櫃的支援。
新推出的重點元件包括 NVIDIA Config Manager、Cluster Readiness Engine、Rack Management Service,以及 NVIDIA Infrastructure Controller 的 Cluster API Provider。它們分別涵蓋網路設定、叢集健康測試、機櫃級營運與裸機佈建。
隨著機櫃功率提高,高電壓直流配電可減少所需的銅材、纜線與轉換設備。NVIDIA 的設計旨在支援未來百萬瓦級 AI 機櫃,同時允許既有設施逐步導入。
Spectrum-6 是 NVIDIA 面向 AI 工廠的 102.4Tb/s Ethernet 交換器平台。它提供每通道 200Gb/s 網路能力,Meta 正將其作為 N-IceCube 與 Spectrum-X Multiplane 架構的一部分導入。
USFP 是 NVIDIA 與 Cisco 正在開發的一種新型可插拔光學模組外形規格,面向每通道 400Gb/s 網路。它旨在提高頻寬密度與能源效率,同時保留可插拔光學元件的可維護性。
Falcon 是 Google 的高效能 Ethernet 傳輸協定。未來的 ConnectX-10 SuperNIC 與 BlueField DPU 預計將透過 NVIDIA 硬體加速與 DOCA 軟體支援它,同時保留 RDMA 程式設計介面。
是。NVIDIA 於 2026 年 5 月宣布,Vera Rubin 正在進入全面量產階段,全球系統與供應鏈合作夥伴正以規模化方式製造相關系統。
在 OCP Global Summit 2026 上,NVIDIA 將 Vera Rubin 從一個運算平台擴展為更開放的基礎設施藍圖。MGX 1.2 將更多機櫃、冷卻與電力設計標準化,而 DSX OS 則增加用於設定、驗證與營運大型 AI 叢集的開放原始碼工具。
周邊生態系也正朝相同方向發展。新的 OCP 設施與電網規格定義大型 AI 工廠應如何建造,以及在電力擾動期間應如何運作。Visionbay 的 800 VDC 設計因應日益提升的機櫃密度;Meta、Cisco 與 Google 則透過 Spectrum-6、USFP 與 Falcon Transport 擴展網路堆疊。
核心主題是可互通性:Vera Rubin 正逐漸不只是 GPU 平台,而是涵蓋運算、網路、電力、冷卻與營運的共享參考架構。
從一句話開始,幾分鐘內拿到完整網站。



