For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/openai-s-gpt-7-and-gpt-8-research-focus-w-75b1c0ac.md.
GPT-6 仍屬新一代模型,但 OpenAI 已經在思考遠超 GPT-6 的未來。
在 2026 年 9 月 23 日的 Fellows Forum AI Summit 上,OpenAI 應用研究主管 Boris Power 估計,公司約有 80% 至 90% 的研究已聚焦於:
GPT-7
GPT-8
以及後續世代
這番言論來自他與 Zachary Lipton 的公開對談,主題是前沿模型如何從研究走向 Agent 與真實世界系統。
Power 的觀點並不是 GPT-6 已不再重要。
OpenAI 仍在積極改進當前世代。9 月稍早,該公司推出了能力最高的 GPT-6 模型 GPT-6 Astra。9 月 22 日,公司再以速度更快、成本更低的 GPT-6 Sol 與 GPT-6 Luna 擴展了該模型家族。
這造成了一個看似矛盾的情況:
Power 的解釋將兩者連結起來。
OpenAI 可以持續改進今天的模型,因為這些修正能改善現有產品,並讓研究團隊獲得有價值的經驗。同時,最大的長期進展可能來自建立能力強得多的下一代模型,再利用該模型協助訓練成本更低的系統。
結果是一種雙軌策略:
推動能力前沿持續向前
+
讓實用能力沿著成本曲線向下普及
Power 對當前世代系統的部分工作,使用了不同尋常的強烈措辭。
他表示,某些針對今日模型的投資,在內部被視為 「極其短視」。
這並不代表這些工作毫無意義。
假設一個當前模型難以進行工具呼叫。
團隊可能會:
這可以立即讓產品變得更好。
它也能讓研究人員了解模型為何失敗,以及哪些介入措施有所幫助。
Power 的警告在於修正方案的生命週期。
在 GPT-6 中需要細緻介入才能解決的問題,可能會在 GPT-7 中自然消失,因為下一代模型在底層能力上本來就更強。
換句話說:
今天的補丁
可能成為
明天過時的權宜措施
這正是研究組織必須持續判斷哪些問題值得深度投入的原因。
修正可能過時,並不代表使用者可以等待。
人們今天就在使用現有產品。
如果模型反覆失去目標焦點、無法正確使用工具,或需要過多人工監督,這個問題仍然重要。
因此,Power 的區分在於:
什麼能立即改善產品
以及:
什麼能創造最高的長期研究價值
OpenAI 的 GPT-6 Astra 發布說明顯示,該公司仍在第一類工作上投入大量資源。
在官方 Astra 公告中,OpenAI 描述了針對實務工作的改進,包括更快的電腦操作能力,以及在 Codex 中更好的協作能力。
Astra 可以在持續進行不依賴答案的工作時,向使用者提出一個聚焦問題。如果該決策影響重大,它會等待;如果缺少的是例行細節,它可以基於合理假設繼續執行。
OpenAI 也表示,當使用者在任務期間加入新要求時,Astra 更擅長維持原始目標與限制條件。
這些細節聽起來可能不如基準測試分數那樣引人注目,但它們直接影響 AI 系統的行為更像是一項工具,還是一位有能力的同事。
Power 論點的另一半與模型大小有關。
如果許多使用者最終希望得到更快、更便宜的模型,為何要如此重度投資昂貴的前沿模型?
因為更強大的模型可以成為教師。
Power 描述了一種如下的模式:
訓練一個能力極強的通用模型
→ 使用它生成高品質範例
→ 選擇或篩選有用的輸出
→ 使用這些範例訓練較小模型
→ 以更低成本部署較小模型
這是 模型蒸餾 的一種形式。
學生模型不需要複製教師的每一項能力。
它只需要繼承足夠的教師實用行為,以完成目標任務。
這也是為何前沿模型的工作,即使客戶從未直接使用該前沿模型,仍然具有價值。
OpenAI 曾在較早的產品世代中公開說明蒸餾技術。
2025 年 3 月,該公司推出新一代音訊模型時表示,它使用先進蒸餾方法,將較大音訊模型的知識轉移到更小、更有效率的系統中。
該公司也描述使用自我對弈資料來捕捉更真實的對話動態,讓較小模型仍可維持實用性與回應能力。
另一個 OpenAI Cookbook 範例讓教師—學生的概念更容易理解。
該範例在葡萄酒葡萄品種分類任務上,使用 GPT-4o 作為 GPT-4o mini 的教師。
在一個包含 300 個範例的驗證集上,報告的準確率為:
GPT-4o:
79.67%

GPT-4o mini:
64.67%

蒸餾後的 GPT-4o mini:
79.33%
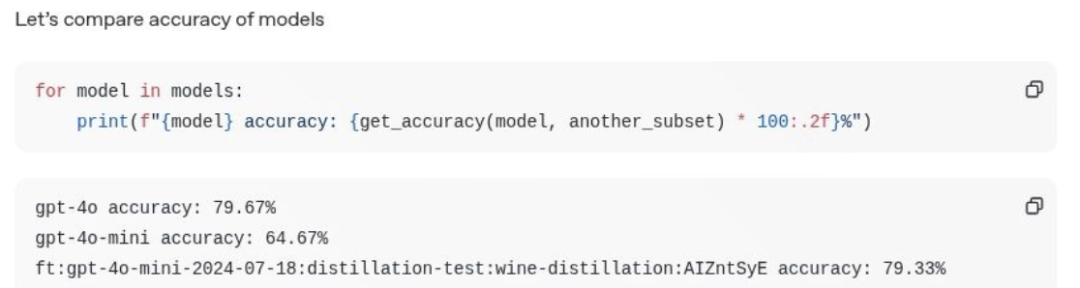
蒸餾後的學生模型在這項特定任務上幾乎與教師模型相當。
這 不代表較小模型在整體能力上變得與 GPT-4o 相同。
它表示,有能力的教師可以有效轉移目標行為,使較小模型在狹窄的工作負載上變得更有用。
GPT-6 模型家族以產品規模應用了類似理念,儘管 OpenAI 尚未公開完整訓練方法,因此不足以將 Luna 簡單稱為「蒸餾版 Astra」。
OpenAI 表示,GPT-6 Sol 與 GPT-6 Luna 採用了與 GPT-6 Astra 類似的方法進行訓練,將 Astra 世代的進展帶入更快、更實惠的模型。
該公司對此模型家族的定位如下:
GPT-6 Astra
最高能力

GPT-6 Sol
以較低成本提供強大的通用效能

GPT-6 Luna
適合高吞吐量工作的超低成本模型
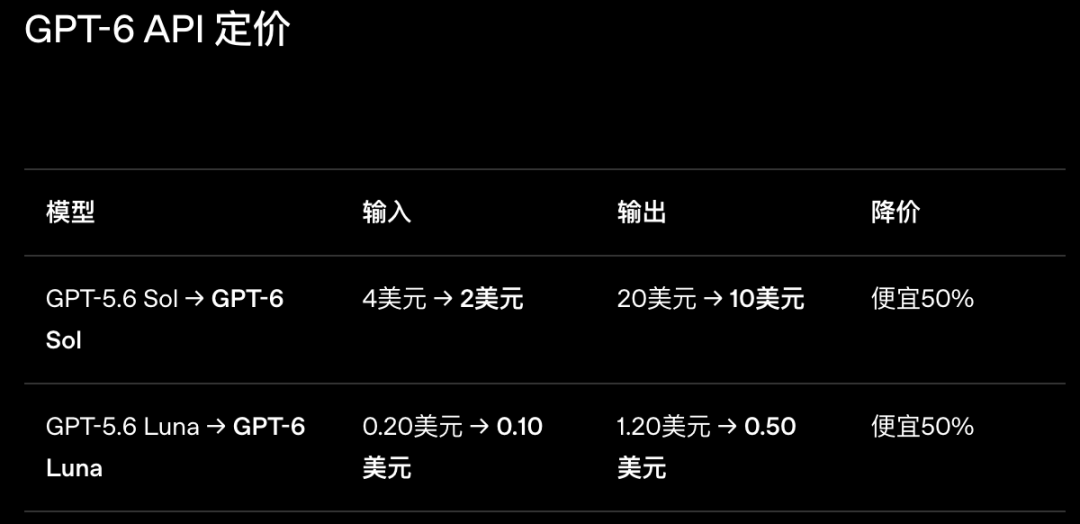
OpenAI 在 9 月 22 日發布時公布的 GPT-6 官方定價如下:
| 模型轉換 | 輸入 | 輸出 | 降幅 |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2 / 100 萬 tokens | $20 → $10 / 100 萬 tokens | 50% |
| GPT-5.6 Luna → GPT-6 Luna | $0.20 → $0.10 / 100 萬 tokens | $1.20 → $0.50 / 100 萬 tokens | 50% |
OpenAI 明確表示,其目標是在不同預算與工作負載之間分配前沿智慧能力。
較大的模型提高能力上限。
較小的模型則將更多能力帶入日常使用。
因為大多數工作流程從頭到尾的難度並不相同。
專案報告是一個有用的例子。
想像有數份來源文件,它們:
工作的第一部分需要更強的判斷力。
有能力的模型可以:
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
一旦方向確定,許多剩餘步驟就會變得更例行化。
較小的模型可能完全足以執行以下工作:
如果出現新的模糊情況,任務可以升級交回較強的模型。
因此,實務工作流程可能如下:
強大模型
→ 困難判斷

小型模型
→ 重複執行

強大模型
→ 例外處理
較便宜的 token 並不會自動代表工作成本較低。
小型模型每次請求的成本可能較低,但如果它需要使用者投入更多工作,整體成本反而可能增加,例如:
因此,有用的問題並不是:
哪一個模型的 token 價格最低?
而是:
整個已驗收結果的成本是多少?
此總成本同時包括機器成本與人力時間。
如果使用者必須成為全職 AI 專案經理,才能讓較便宜的模型成功完成任務,較低的 API 帳單並不算真正的成果。
因此,最佳的分工取決於任務。
當小型模型能以低成本可靠完成定義明確的工作時,它就有價值。
當任務確實需要更強判斷力時,較大模型的較高價格就值得。
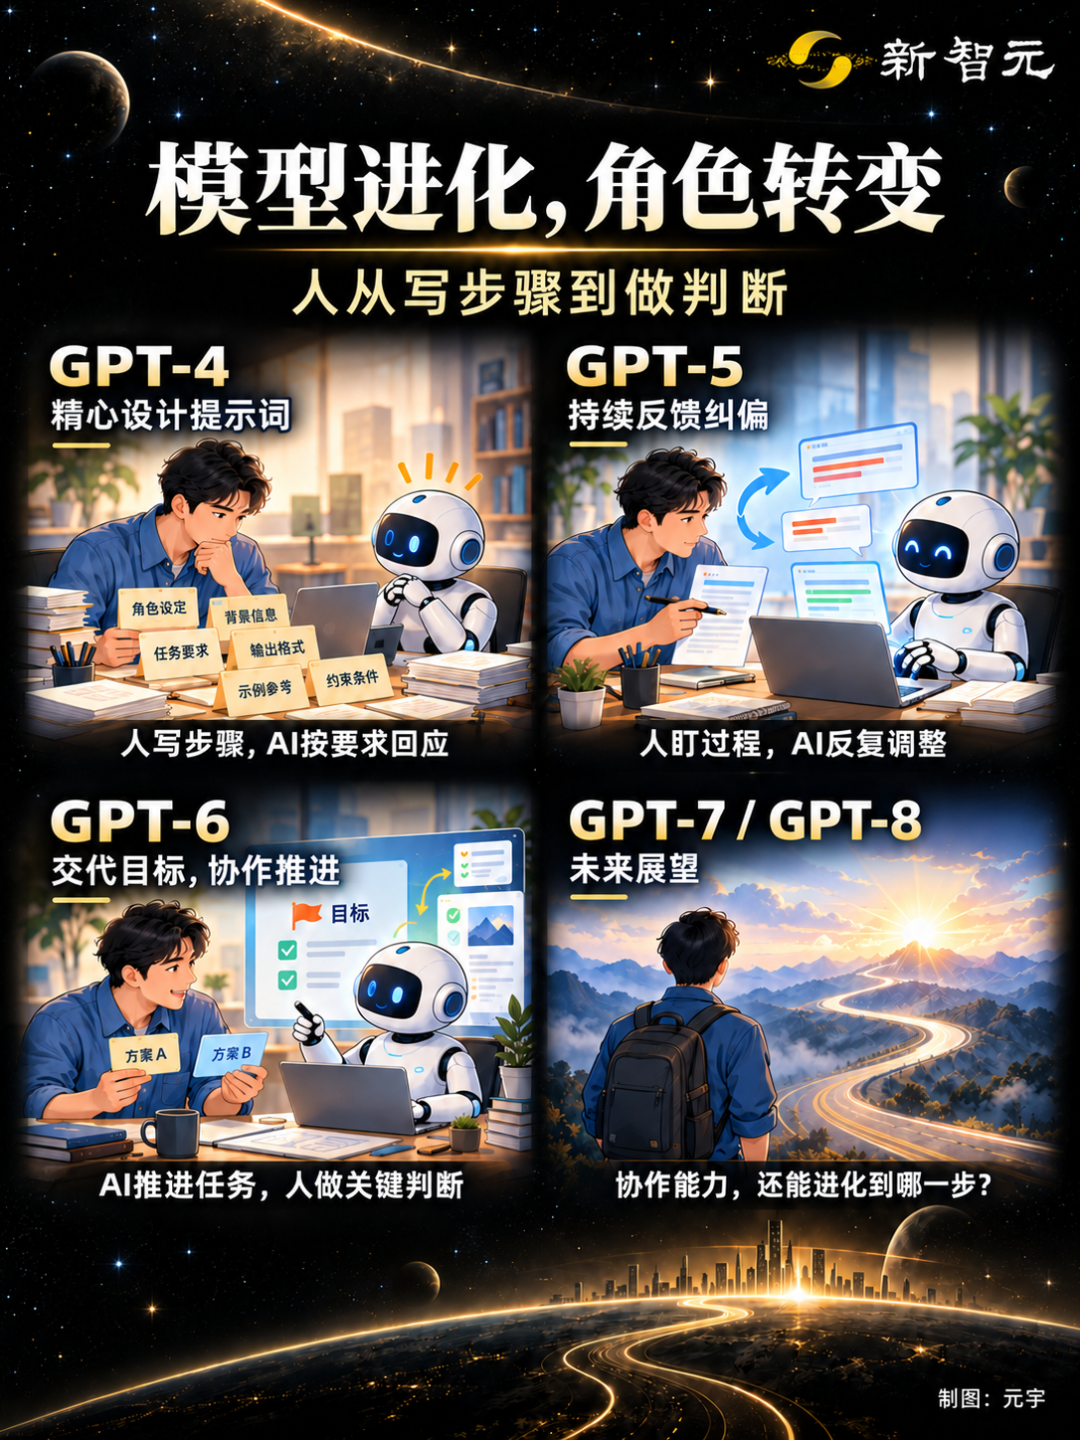
Power 也描述了人們與連續模型世代互動方式的轉變。
來源文章大致將這一演進概括如下:
GPT-4:
人類仔細設計每個步驟

GPT-5:
人類引導過程並持續修正

GPT-6:
人類愈來愈多地陳述目標並監督關鍵決策
這是一種簡化描述,並非對每項任務的保證。
但 OpenAI 自己的 Astra 文件描述了相同的整體方向。
Astra 可以:
這改變了人類的角色。
使用者不再手動指定每一步,而是愈來愈接近於:
設定目標
→ 定義限制條件
→ 審查具重大影響的選擇
→ 檢視結果
對 GPT-7 與 GPT-8 而言,關鍵問題是這種轉變還能走多遠。
模型進展通常透過基準測試分數呈現。
但對日常工作來說,另一個指標可能更重要:
使用者仍必須提供多少監督?
向模型給定目標後:
如果 GPT-7 或 GPT-8 能減少這些負擔,這可能比小幅基準測試提升更有價值。
這也是為何大型模型研究與小型模型工作彼此強化。
前沿模型嘗試發現更有能力的行為。
較便宜的模型則嘗試讓足夠多這類行為能以可負擔的成本大規模使用。
這個標題數字需要一項重要限定。
Power 所說的「80% 至 90%」是他在公開對談中提出的估計。
它不是:
Fellows Forum 的議程確認,Power 以 OpenAI 應用研究主管身分,在 9 月 23 日名為 「Where Models Meet Reality」 的爐邊談話中發表演說。
對錄影內容的獨立報導指出,80–90% 的說法約出現在完整活動錄影的 1:32:52 處。
因此,最穩妥的解讀是:
Power 認為,OpenAI 絕大多數研究注意力都指向 GPT-6 以後的模型世代,因為他預期那裡將帶來最大的根本性進展。
它不應被理解為逐字精確的會計陳述。
Power 在 9 月 23 日發表上述言論。
六天後的 9 月 29 日,OpenAI 發布了 GPT-6.1 Sol。
由於討論聚焦於 Power 在活動中說明的 Astra → Sol/Luna 教師—學生邏輯,該模型不是原始文章論點的核心。
不過,對現在發布這篇文章的讀者來說,這仍是有用的背景資訊。
OpenAI 將 GPT-6.1 Sol 描述為 GPT-6 系列中的最新模型家族;它以遠低於標準 API 的價格,提供接近 Astra 的程式設計、電腦使用與專業工作能力。
它的存在強化了訪談中所討論的相同模式:
前沿能力持續進步
→ 低成本模型吸收更多能力
→ 使用者以更低成本獲得更強效能
它也顯示,個別中間版本的名稱,遠不如整體研究策略來得重要。
OpenAI 應用研究主管 Boris Power 在 Fellows Forum 2026 上估計,OpenAI 約有 80–90% 的研究聚焦於 GPT-7、GPT-8 與後續世代。此數字是他公開提出的估計,並非經審計的公司資源配置報告。
沒有。Power 的發言中沒有宣布 GPT-7 或 GPT-8 的公開發布日期或詳細產品路線圖。他使用這些名稱來指稱 GPT-6 之後的世代,並認為這些世代正獲得大部分長期研究注意力。
當前世代的工作能讓今天的產品更好,並讓研究人員獲得更快速的回饋。Power 的觀點是,某些修正的生命週期可能很短,因為能力更強的下一代模型可讓底層問題變得更容易解決,甚至完全消失。
模型蒸餾是一系列技術,讓較強的教師模型協助訓練較小的學生模型。常見工作流程是由教師生成高品質範例、篩選這些範例,再訓練較小模型重現目標任務所需的行為。
OpenAI 表示 Sol 與 Luna 採用與 Astra 類似的方法進行訓練,並繼承同一世代的進展,但它尚未公布足夠細節,無法將 Luna 或 Sol 簡單描述為 Astra 的壓縮副本。較準確的說法是,它們將相關能力進展帶到成本更低的層級。
在 9 月 22 日發布時,OpenAI 將 GPT-6 Sol 定價為每 100 萬輸入 tokens $2、每 100 萬輸出 tokens $10;GPT-6 Luna 的定價則為每 100 萬輸入 tokens $0.10、每 100 萬輸出 tokens $0.50。OpenAI 表示,兩者均比各自 GPT-5.6 對應模型的促銷定價低 50%。
當任務需要困難判斷、模糊推理、例外處理或重要決策時,應使用較強的模型。在主要方向確定後,較小模型通常更適合高吞吐量、規格清楚且重複性的工作。
趨勢正從撰寫每一步指令,轉向設定目標、定義限制條件與審查重要決策。OpenAI 的 Astra 文件特別描述了非同步提問、等待答案時持續工作,以及在長任務中更好地保留原始目標等能力。
Boris Power 對 80–90% 的估計,讓 OpenAI 的研究策略更容易理解。該公司可以持續改進今天的 GPT-6 產品,同時將大部分長期研究注意力導向未來世代,因為它預期在那裡會出現更大的能力進展。
這項策略的另一半同樣重要。更強大的前沿模型不僅作為高階產品有價值;它們也可以作為教師與研究平台,協助將實用能力帶入更快、成本更低的系統,例如 Sol 與 Luna。
對使用者而言,實際問題不是哪個模型最大,而是如何分配工作:將困難判斷交給能勝任的模型,並將例行執行交給能可靠完成工作的最低成本模型。
OpenAI 的長期押注看來很直接:持續推高能力上限,接著讓更多這些能力變得足夠實惠,以便每天使用。
從一句話開始,幾分鐘內拿到完整網站。



