For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/typesafe-jev-vs-openai-decisions-api-fast-7c48d620.md.
一家新成立的 AI 公司在推出一款不試圖撰寫文章、程式碼或友善聊天回覆的模型後僅數週,就籌集了 **8.7 億美元**。
一家新成立的 AI 公司在推出一款不試圖撰寫文章、程式碼或友善聊天回覆的模型後僅數週,就籌集了 8.7 億美元。
這家公司是 TypeSafe AI。
其模型名為 Jev。
TypeSafe 於 2026 年 10 月 9 日宣布完成 A 輪融資,估值達 75 億美元。Andreessen Horowitz 領投,Sequoia Capital、現有投資者 DCVC 以及其他投資者參與了本輪融資。
該公司的創始團隊同樣受到關注。
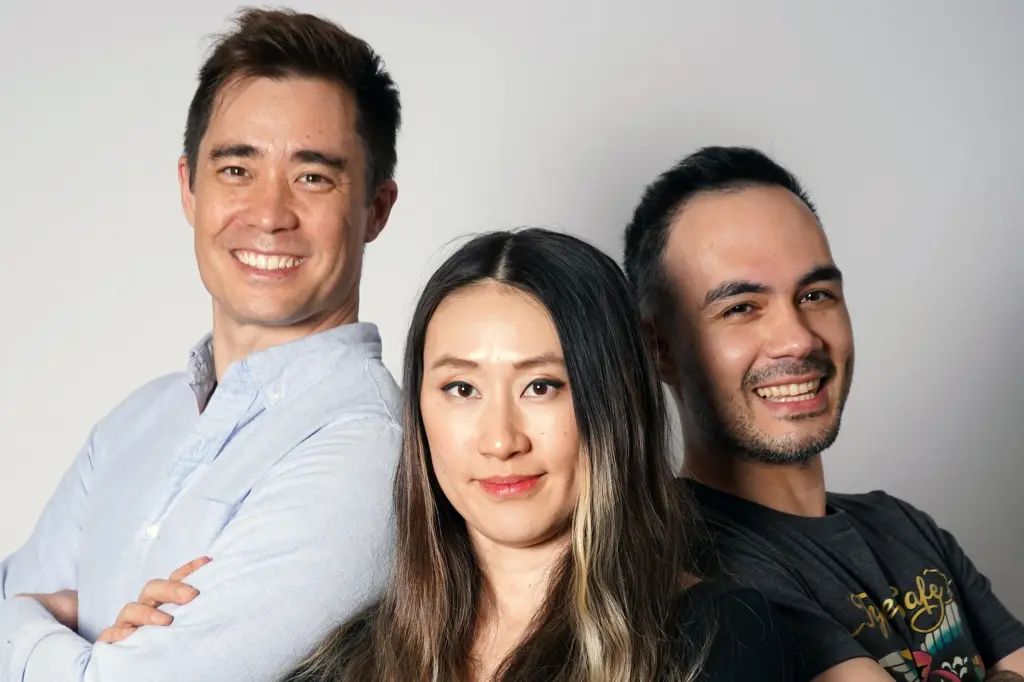
TypeSafe 由 Erik Gafni、Sasha Sheng 和 Diogo Almeida 創立。Almeida 曾任職於 OpenAI,參與開發 ChatGPT 時代指令遵循系統背後的研究。Sheng 曾在 Meta/FAIR 工作,而 Gafni 則具有工程與創業背景。
Jev 於 9 月 15 日公開推出。
僅兩週後,OpenAI 宣布有限預覽一項方向顯著相似的產品:一個快速 API,用於返回機率、選項和分數,而不是長篇生成文字。OpenAI 於 10 月 6 日將該產品 Decisions API 推出公開測試版。
OpenAI API 產品負責人 Nikunj Handa 後來公開表示,Jev 啟發了這一產品類別。
這使 Jev 之所以值得關注,主要有兩個原因。
首先,它提出了一種在軟體內使用 AI 的不同方式。
其次,它促使一家前沿模型公司以異常迅速的速度做出回應。
Jev 並不試圖成為你交談的 AI。
它試圖成為你的軟體可以呼叫數千次或數百萬次、而你甚至不必看見答案的 AI。
開啟電子郵件收件匣,你會看到數百個等待處理的小判斷。
這封訊息重要嗎?
它是否包含即將到期的帳單?
是否需要緊急回覆?
會議時間是否發生變更?
應該封存、升級處理,還是忽略?
通用型語言模型已經可以回答這類問題。
問題在於,傳統 LLM 通常是為生成語言而設計的。
對單封電子郵件而言,這些額外成本可能並不重要。
但在大規模場景下,情況就不同了。
如果應用程式每天要執行數千次或數百萬次同類型決策,延遲和成本上的微小差異,就會轉化為高昂的營運支出。
Jev 是專門為這些重複性判斷而設計的。
TypeSafe 將 Jev 稱為 System One Model。
這個名稱指向 Daniel Kahneman 推廣的快速、直覺式「System 1」認知模式。
應用程式不是要求 Jev 生成一個段落,而是向它提供一些狀態以及一組預先定義的問題。
Jev 會返回具型別的值,例如:
應用程式可以直接使用結果。
簡化後的流程如下:
收到電子郵件
      ↓
Jev 評估多個問題
      ↓
urgent_reply = 0.91
billing_related = 0.74
meeting_change = 0.03
      ↓
應用程式套用自身規則
      ↓
提醒/封存/分流/審查
關鍵差異在於介面。
使用通用語言模型時,開發者通常會要求模型輸出 JSON 或其他結構化格式,然後再驗證生成的回應。
而對 Jev 而言,具型別的決策輸出本身就是核心產品設計。
TypeSafe 的 API 提供一個 systemone 端點,允許開發者針對同一份共享狀態提交多個問題。
TypeSafe 強調並行決策。
如果應用程式希望根據多項獨立標準評估同一個輸入,可以將這些問題一併送出,而不必將每個問題拆成獨立的對話回合。
這對需要回答以下問題的軟體很有用:
應用程式接著可以使用一般程式碼組合這些輸出。
這也是 Jev 感覺上不像聊天機器人,而更像智慧型條件判斷式的原因之一。
TypeSafe 目前列出的 Jev 價格如下:
| 用量 | Jev 價格 |
|---|---|
| 輸入 | 每百萬 Token 0.042 美元 |
| 輸出 | 免費 |
TypeSafe 表示,由於 Jev 不會以自回歸方式生成長篇文字序列,因此輸出成本低到無需計費。
這項價格之所以重要,是因為 Jev 針對的是可能極高頻率發生的決策。
一項若每次使用者操作都呼叫 AI、成本高到難以自動化的決策,在成本降低一個數量級後,可能就變得切實可行。
這會帶來不同的部署問題。
軟體團隊不再只是問:
這件事重要到值得呼叫 AI 模型嗎?
而可以開始問:
為什麼不也讓 AI 評估這個小步驟?
這就是該產品背後的經濟論點。
標題式的 Token 價格只是生產成本的一部分。
團隊仍然需要衡量:
一項價格便宜、但錯誤率過高的決策,仍然可能十分昂貴。
這一點在後文介紹的獨立 Jev 評估中尤其重要。
Vercel 在 Jev 推出後幾乎立即將其加入 AI Gateway。
首日反應異常強勁。
Vercel 表示,在 24 小時內,Jev 已被 接近 13% 的付費 AI Gateway 團隊使用。
這是該平台此前任何模型推出首日觸及率的兩倍以上。
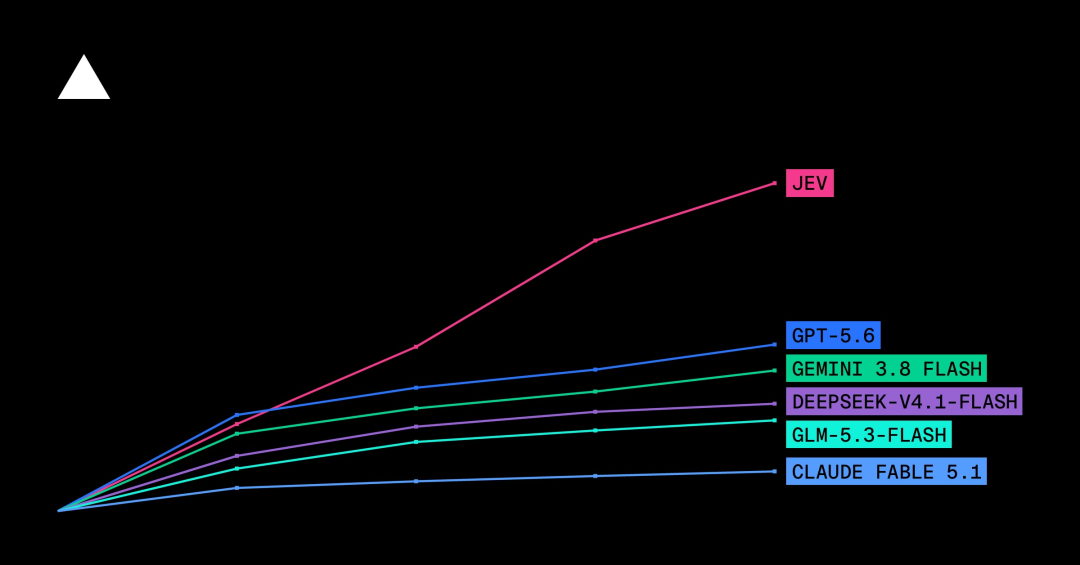
Vercel 後來稱 Jev 是 AI Gateway 歷史上採用速度最快的模型。
首日爆發並不能證明長期留存率。
但它確實表明,開發者立刻認識到一類適合使用窄域決策模型的任務。
Vercel 列出的案例包括:
這些並不是光鮮亮麗的任務。
但它們正是生產環境軟體持續執行的任務。
Jev 背後的想法並非一夜之間出現。
Diogo Almeida 曾表示,他在 OpenAI 工作期間,越來越關注一個基本問題:
如果 AI 改變了經濟,未來誰會發出大部分模型請求?
是人類手動開啟聊天視窗嗎?
還是軟體在背景中自動呼叫智慧?
他的答案是後者。
這會改變 AI 介面應該優化的方向。
面向人類的模型受益於自然對話、靈活散文、解釋能力和創造力。
面向軟體的模型則受益於:
Almeida 曾將 Jev 描述為對以下差距的回應:有些模型在對話方面令人印象深刻,但不容易作為可靠的軟體原語使用。
TypeSafe 表示,該公司在公開推出前,約花了兩年開發這套系統。
Jev 的推出沒有被 OpenAI 忽視。
在 OpenAI DevDay 前後錄製的 Latent Space 訪談中,API 產品負責人 Nikunj Handa 直接表示,Jev 啟發了 Decisions API 的推進。
他解釋,使用者和內部團隊都要求一個速度快得多的分類系統。
他也確認,幾週前該專案尚未出現在產品路線圖上。
OpenAI 並沒有只為第一版重新訓練一個全新的基礎模型。
相反地,它使用 GPT-6 Luna,並在其上建構專用的決策介面與推理路徑。
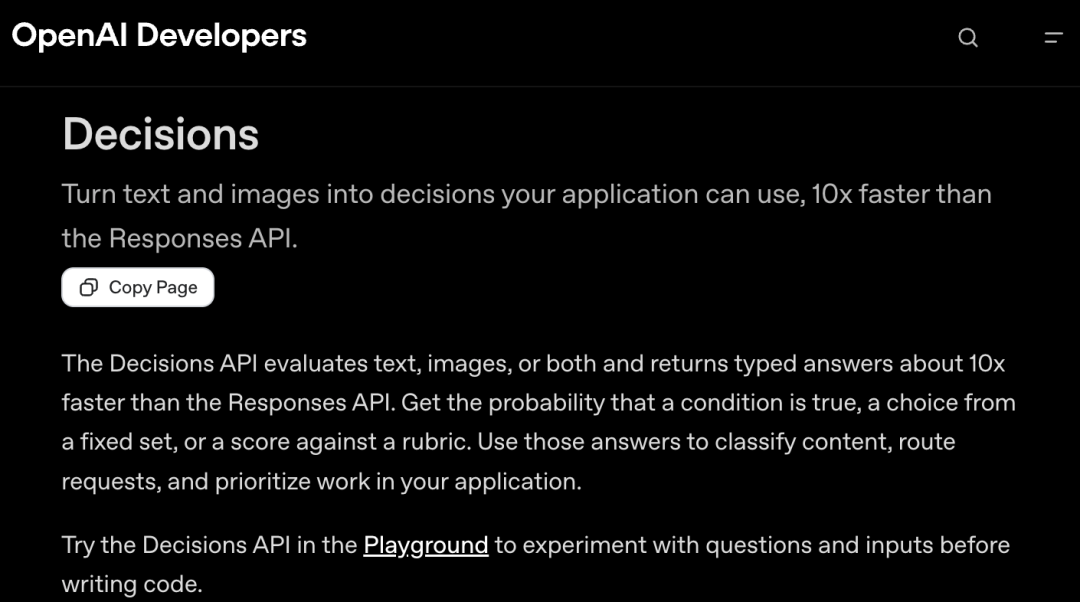
目前,該產品已透過以下端點提供公開測試版:
POST /v1/decisions
Decisions API 接受共享證據以及一個或多個問題,並返回具型別的答案。
OpenAI 目前支援三種問題型別:
| 問題型別 | 結果 |
|---|---|
predicate | 某項條件為真的機率 |
choice | 一個選定選項及其機率/信心度 |
score | 跨有序級別的分數 |
這與 Jev 所針對的使用案例高度重疊。
這是目前公開產品之間最大的架構差異。
TypeSafe 表示,Jev 使用專門的模型架構以及一種稱為 用於校準決策的強化學習(Reinforcement Learning for Calibrated Decisions,RLCD) 的訓練方法。
OpenAI 第一版 Decisions API 則使用現有的 GPT-6 Luna 權重,並配合專用的決策服務介面。
概念上可以表示為:
TypeSafe:
專用決策模型
→ 具型別的機率輸出

OpenAI:
GPT-6 Luna
→ 專用 Decisions API 路徑
→ 具型別的機率輸出
這表示,兩種產品對開發者而言可能看起來相似,但底層採用的方式不同。
其中一項實際差異是輸入模態。
目前的 OpenAI Decisions API 接受 文字、影像或兩者兼具的輸入。
TypeSafe 公開推出 Jev 時,重點放在文字/狀態輸入。
OpenAI 的文件包含一個案例:API 檢查產品照片,估計是否存在可見損壞,例如裂痕、撕裂或凹痕。
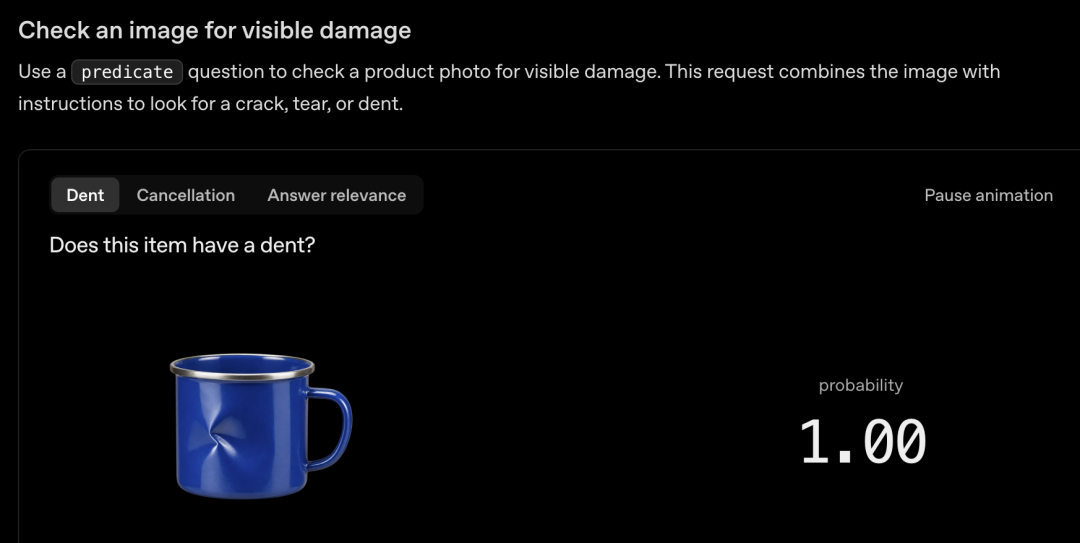
電子商務應用程式可以使用這種模式,自動將影像分流至審查流程。
例如:
產品照片
→ Decisions API 檢查可見損壞
→ 機率 = 高
→ 分流至人工檢查
這很好地說明了決策 API 為何可以嵌入一般軟體,而不必產生面向使用者的答案。
使用者可能永遠不知道是哪個模型評估了這張照片。
他們感受到的只是由此產生的工作流程。
目前公開的價格十分直接。
| 產品 | 輸入價格 | 輸出價格 |
|---|---|---|
| TypeSafe Jev | 每百萬 Token 0.042 美元 | 免費 |
| 使用 GPT-6 Luna 的 OpenAI Decisions API | 每百萬 Token 0.10 美元 | 免費 |
以基本輸入 Token 價格而言,Jev 更便宜。
OpenAI 的 Decisions 文件表示,該 API 返回具型別答案的速度約為 Responses API 的 10 倍。
這項 10 倍的說法,特指與 OpenAI 自家的 Responses API 路徑比較。
它不是已發布的、針對 Jev 的正面速度優勢比較。
同樣地,TypeSafe 在自身的工作流程評估中公布了更大的速度與成本倍數,但也明確承認,這些測試採用的是其自身方法,實際增益可能位於現實世界結果的高端。
在生產環境中選型時,團隊應針對自己的實際工作負載進行基準測試。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
這個產品故事之所以不同尋常,在於 OpenAI 直接承認了其靈感來源。
在 Latent Space 訪談中,Handa 表示 Jev 啟發了這一產品類別,而 OpenAI 的使用者和內部團隊很快開始要求類似的快速分類能力。
他描述了一個小型內部團隊如何迅速建立原型,接著再優化延遲。
這並不代表 Jev 與 Decisions API 完全相同。
但它確實表明,TypeSafe 找到了一個真實的產品缺口。
競爭焦點已從:
誰擁有能力最強的通用模型?
轉向另一個問題:
針對軟體內某項特定的重複性決策,
哪個模型原語最便宜、最快?
這與傳統聊天機器人基準測試所代表的市場不同。
Jev 的低價在推出後不久便受到有價值的獨立檢視。
9 月 29 日,波昂大學和 Lamarr Institute 的研究人員提交了一篇預印本,評估 Jev 1.13.0。
研究涵蓋:
Jev API 的總成本 低於 10 美元。
這是一個引人注目的數字。
但論文更重要的部分,在於它對可靠性的說明。
研究人員發現,Jev 的選項機率可用於選擇性預測。
用簡單的話說:
如果系統只回答最有信心的案例,準確率可以更高。
當應用程式接受更多低信心案例時,準確率會下降。
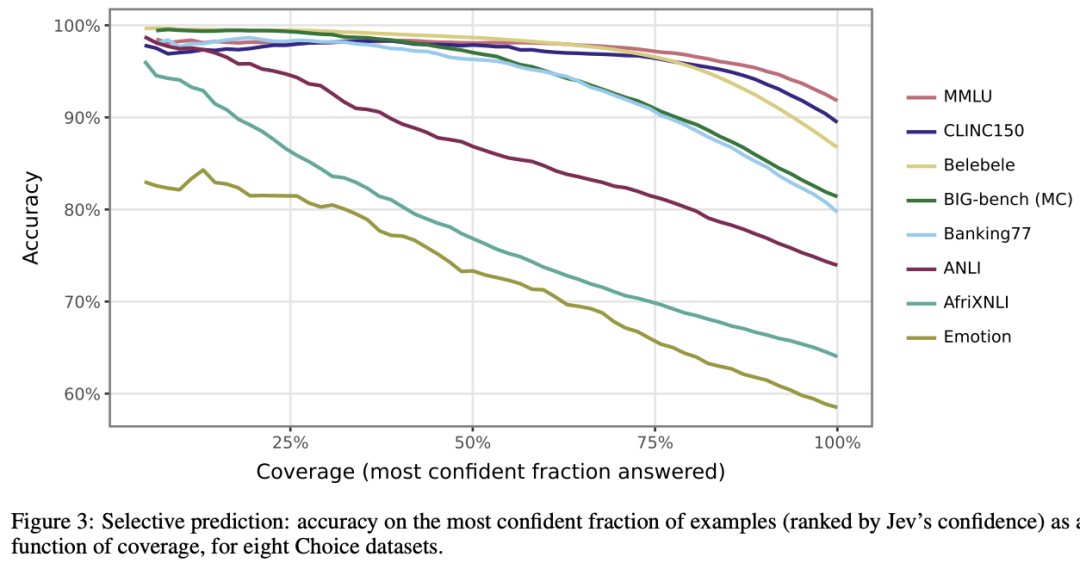
這正是機率對自動化有用的原因。
生產環境工作流程可以針對不同信心度設定不同的行為。
例如:
信心度 >= 0.95
→ 自動處理

0.70 <= 信心度 < 0.95
→ 要求二次驗證

信心度 < 0.70
→ 人工審查
確切閾值應該來自評估資料,而不是直覺。
該研究針對二元決策發現了一項重要限制。
Jev 的機率可以很好地對案例進行排序,但在固定的 0.5 閾值附近,校準情況可能仍然不佳。
這表示以下規則:
如果機率 >= 0.5:
    執行操作
並不一定適合每項任務。
在一項 UNFAIR-ToS 評估中,研究人員報告稱,在訓練資料上調整閾值後,micro-F1 從 0.50 提升至 0.75。
一般教訓很簡單:
機率很有用,但應用程式仍然需要決定多高的機率才足以採取行動。
這並非 Jev 獨有的問題。
它是負責任地部署機率分類器的基本要求。
回到電子郵件的例子。
假設模型錯誤地將一封促銷電子郵件標記為重要。成本只是造成些許困擾。
但假設它漏掉了一封必須在當天結束前回覆的電子郵件。成本可能高得多。
因此,正確閾值取決於偽陽性與偽陰性之間的不對稱性。
實際系統可能會針對不同決策使用不同規則:
| 決策 | 更安全的預設做法 |
|---|---|
| 促銷電子郵件偵測 | 積極自動化 |
| 帳單截止日期偵測 | 使用較低閾值進行提醒 |
| 法律/合規分類 | 將不確定情況升級處理 |
| 高風險帳戶操作 | 要求人工確認 |
| 低價值內容標記 | 自動化處理大部分案例 |
強大的決策模型並不會消除產品政策。
它會讓產品政策更容易在軟體中表達。
TypeSafe 強調 Jev 的輸出具有型別安全性。
這是一項真正的工程屬性。
如果開發者定義了一組允許的輸出,模型就不需要在該結構描述之外臆造任意字串。
但正確性有兩種不同形式:
輸出符合允許的型別。
所選答案確實正確。
決策模型能比語意正確性更有力地保證前者。
獨立基準測試清楚呈現了這項差異:即使 Jev 的回應作為具型別值完全有效,它仍然可能選出錯誤答案。
因此,最安全的生產環境解讀是:
Jev 消除了大量格式化與解析失敗,但不會消除模型錯誤。
原始內容正確指出,不是每項判斷都應該交給 Jev。
TypeSafe 自身的資料也承認,專用 System One 模型的角色比通用語言模型更窄。
一種有用的分工方式如下:
例如:
例如:
例如:
例如:
便宜的模型不應該透過產生大量需要人工持續清理的決策,反而創造新的支出。
Jev 這個名稱源自經濟學家 William Stanley Jevons。
Jevons 與現在稱為 Jevons 悖論的概念相關。
其簡化版本是:
資源效率提高
→ 每次使用成本下降
→ 需求增加
→ 資源總消耗量可能上升
TypeSafe 將這個邏輯套用到機器智慧上。
如果每次 AI 呼叫的成本都大幅下降,軟體可能不只是為相同工作負載減少支出。
開發者可能會創造過去因成本過高而不值得實施的全新工作負載。
以下案例已經呈現出這種趨勢:
結果可能是每項決策的成本降低,但決策總數大幅增加。
這就是 Jev 背後的 Jevons 悖論押注。
這一趨勢最重要的部分,可能是使用者看不見的。
今天,人們通常會明確地與 AI 互動:
開啟聊天機器人
→ 貼上內容
→ 撰寫提示詞
→ 閱讀答案
→ 將結果複製回另一個工具
機器原生決策模型則暗示了另一種模式:
使用者照常使用軟體
→ AI 在背景中評估小型決策
→ 軟體自動分流、評分、檢查或篩選
→ 人類只看到真正重要的案例
收件匣可以只顯示緊急郵件。
寫作工具可以只標記需要審查的句子。
Agent 可以自動選擇下一個工具。
客服系統可以在人員看到工單前完成分流。
市集可以在候選人註冊後立即進行排序。
到了這個階段,使用者可能不在意底層系統使用的是 Jev、GPT-6 Luna,還是另一種決策模型。
使用者在意的是軟體感覺更快,且需要的手動步驟更少。
從這個角度看,TypeSafe 的融資就更容易理解。
該公司押注的不是人們想要另一個聊天機器人分頁。
它押注的是軟體本身將發出海量模型請求。
TypeSafe 表示,《財星》500 強企業中已有三分之一在使用 Jev,但這是公司公布的採用數字,且該公司尚未公開列出所有這些客戶的名稱。
8.7 億美元的 A 輪融資為 TypeSafe 擴大這項策略提供了大量資本。
其融資公告表示,公司計畫打造:
OpenAI 迅速推出 Decisions API,表明大型模型公司也看到了同一機會。
下一個競爭問題不只是誰最便宜。
而是哪個系統能產生足夠可靠的決策,讓開發者放心讓軟體根據這些決策自動採取行動。
Jev 是 TypeSafe AI 推出的第一款「System One Model」,專為快速、機器可讀的決策而設計,而不是自由形式的文字生成。它接受共享狀態與具型別的問題,並返回選項、分數或機率,供軟體直接使用。
TypeSafe 目前列出的 Jev 價格為每百萬輸入 Token 0.042 美元,輸出免費。實際應用成本取決於請求量、輸入大小、重試、評估額外成本,以及需要升級交由更大型模型或人工處理的案例數量。
TypeSafe 將 Jev 描述為基於 Transformer 的 System One 模型,而不是用於文字生成的傳統大型語言模型。其核心產品特徵是:不生成任意散文,而是返回具型別的機率決策。
會。型別安全的輸出可以防止某些格式與結構描述錯誤,但選出的決策仍可能在語意上不正確。獨立評估顯示,Jev 在許多資料集上表現良好,同時也存在取決於任務的錯誤與閾值校準問題。
OpenAI Decisions API 是一個由 GPT-6 Luna 驅動的公開測試版端點,可將文字或影像轉換為具型別的謂詞、選項或分數。OpenAI 宣稱,與透過 Responses API 處理同類工作相比,該 API 的速度約快 10 倍。
目前 Decisions API 的價格為每百萬輸入 Token 0.10 美元,不收取輸出 Token 費用。Jev 公布的基本輸入價格較低,為每百萬 Token 0.042 美元,輸出同樣免費。
單靠一個機率並不能告訴應用程式應採取什麼行動。團隊應該根據標註評估資料,以及偽陽性、偽陰性和人工審查的實際成本選擇閾值,而不是假設 0.5 永遠是正確的分界點。
決策模型最適合高頻率的分類、分流、評分、驗證與分支判斷,且這些任務的可能輸出可以預先定義。當任務需要開放式推理、解釋、內容生成或複雜規劃時,應使用通用模型。
TypeSafe Jev 採取了一種刻意收窄的 AI 路線:它不為人類產生語言,而是為軟體產生具型別的決策。這項設計讓高頻率的分類、分流、評分和驗證變得更便宜,也更容易整合到程式碼中。
Jev 的早期採用表現強勁,促使 OpenAI 很快以 GPT-6 Luna 驅動的 Decisions API 進入同一產品類別。Jev 在公開的基本輸入價格上仍然更便宜,而 OpenAI 則提供影像支援,以及現有通用模型平台的規模優勢。
主要工程挑戰在於可靠性,而不是格式。具型別輸出消除了一類錯誤,但決策準確率仍取決於資料集、閾值、錯誤成本和升級處理政策。獨立 Jev 研究尤其清楚地說明了這一點。
更大的變化在於,AI 可能不再是使用者明確「交談」的工具,而會成為一個低成本決策層,安靜地運行在一般軟體之中。
從一句話開始,幾分鐘內拿到完整網站。



