For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-TW/articles/vpp2-world-action-model-robodojo-1-58-5-a-707959ef.md.
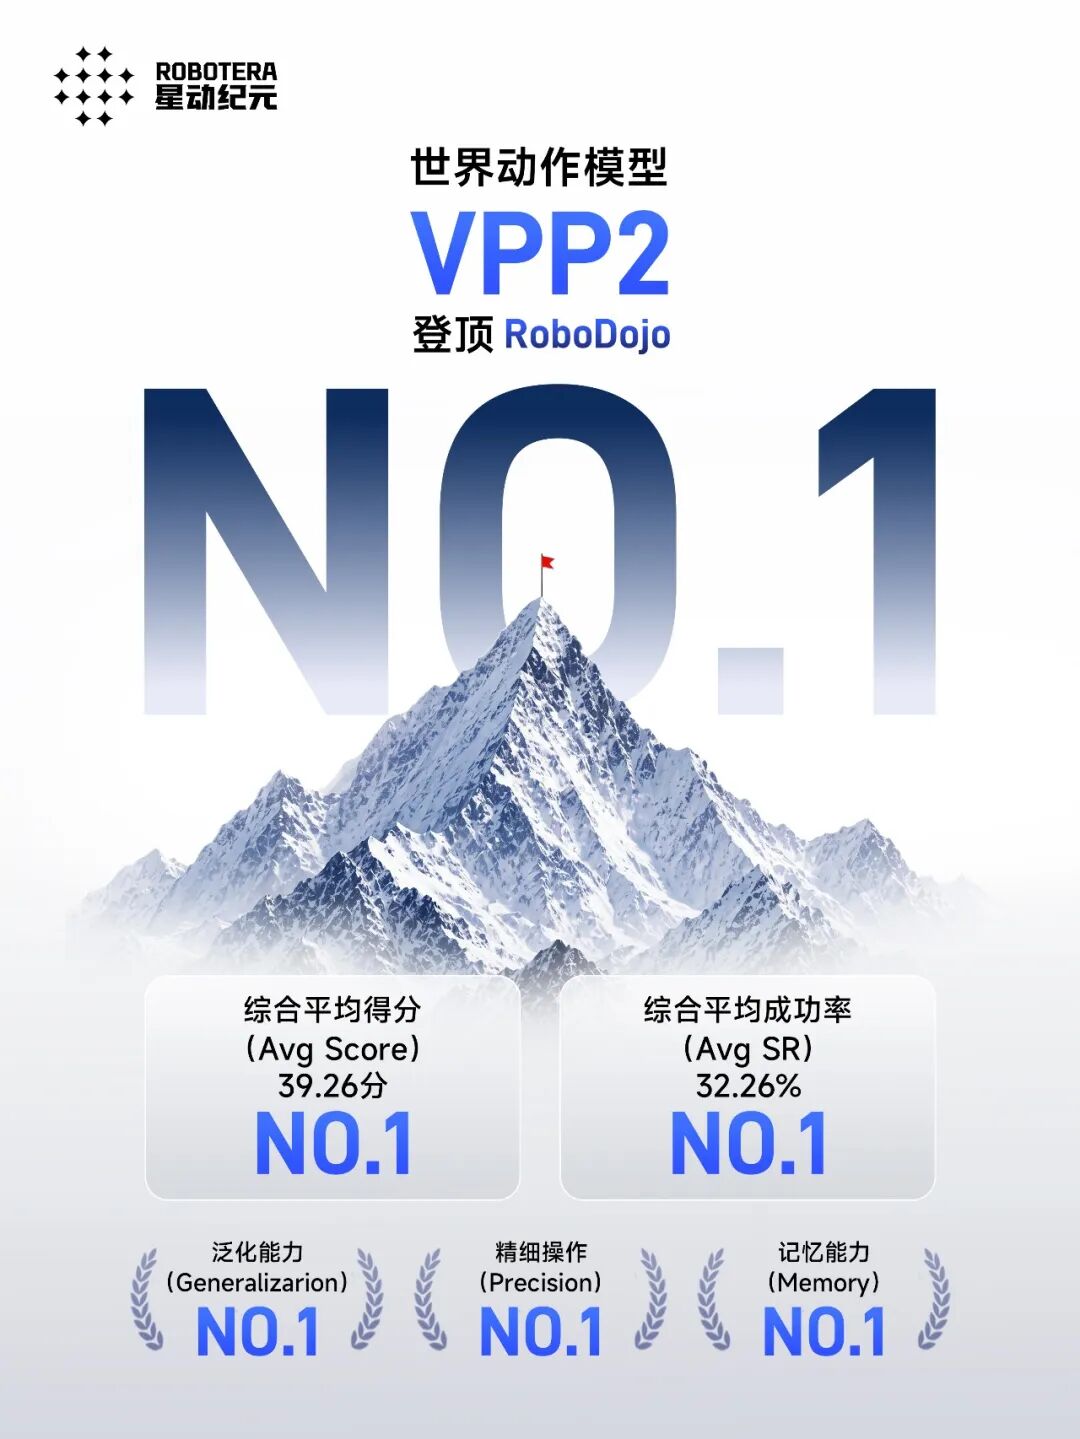
RobotEra 推出的新世界動作模型,已登上 RoboDojo 模擬排行榜首位。
該模型是 VPP2——Video Prediction Policy 2:更好地預測,更好地行動。
在官方 RoboDojo-Sim 排行榜上,VPP2 目前的成績為:
平均分數:
39.26

平均成功率:
32.26%
截至本文發布時,這兩項數據使其位居排行榜總榜第一。
這項結果值得關注,因為 RoboDojo 並不是圍繞某一項狹窄的操作任務設計。其模擬基準包含 42 項任務,涵蓋五個能力維度:
RoboDojo 還包含一套真實世界基準,涵蓋多種機器人形態的 18 項任務。
RobotEra 表示,這次 VPP2 提交使用了標準基準數據,沒有額外加入評估專用數據,也沒有使用 Agent RSI 類型的增強方法。
這項說法應理解為針對本次 RoboDojo 提交的描述,而不是說該模型沒有使用大規模預訓練數據。VPP2 的論文清楚說明,模型曾使用多樣化的機器人、人類以及通用操作影片進行大規模預訓練。
更值得關注的是,VPP2 如何取得這樣的性能。
其核心理念很簡單:
更好地預測物理世界將如何變化,可以讓機器人的動作更加可靠。
VPP2 並不是從一開始就將影片生成與機器人動作學習混合訓練,而是分階段進行訓練。
RoboDojo 於 2026 年 7 月發布,定位為一套統一的模擬與真實世界通用機器人操作基準。
目前公開的模擬排行榜顯示,VPP2 位居首位:
| 排名 | 模型 | 平均分數 | 成功率 |
|---|---|---|---|
| 1 | VPP2 | 39.26 | 32.26% |
| 2 | PhysicalRSI | 36.27 | 31.38% |
| 3 | Awomo-0.5 | 35.34 | 29.64% |
| 4 | Simate-beta | 33.95 | 27.96% |
| 10 | GPT-6 Astra | 28.97 | 22.48% |
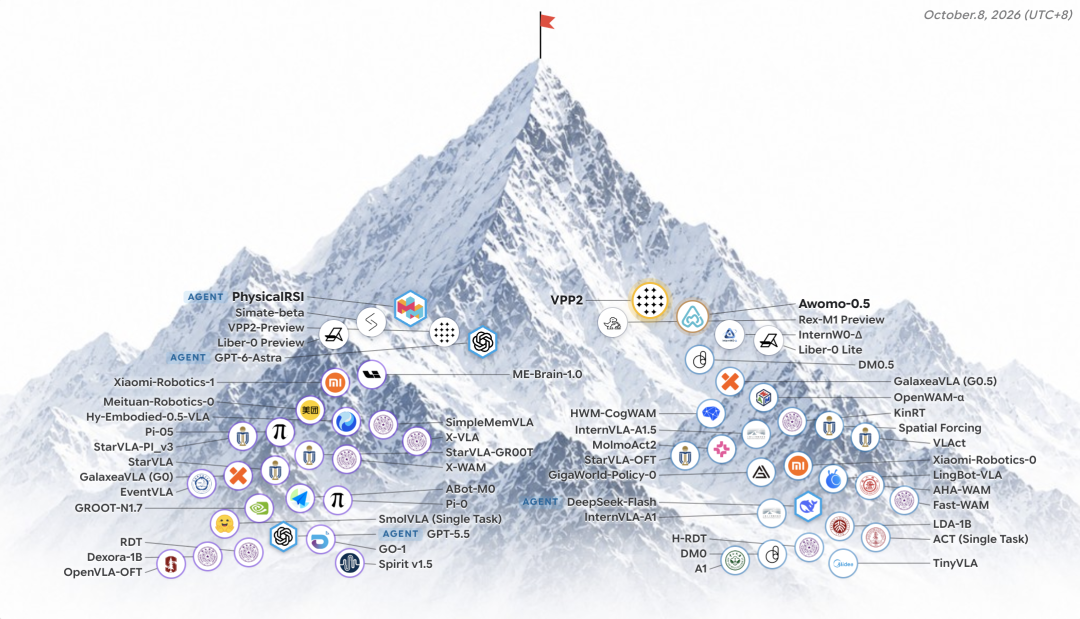
BAAI 來源特別強調了 VPP2 與 GPT-6 Astra、Physical Intelligence 的 π0.5、NVIDIA GR00T-N1.7 及其他具身模型的比較。
最準確且範圍更嚴謹的表述是:
VPP2 目前在官方 RoboDojo-Sim 排行榜上,以平均分數和平均成功率兩項指標均排名第一。
這與宣稱 VPP2 是全球「最佳機器人模型」並不相同。
沒有任何單一基準可以證明這一點。
不同的具身模型使用了不同的:
RoboDojo 的價值在於,它提供了一個標準化且可重現的比較環境。
論文提供了一張表格,按照 RoboDojo 的設定,直接比較 VPP2 與多個基線模型。
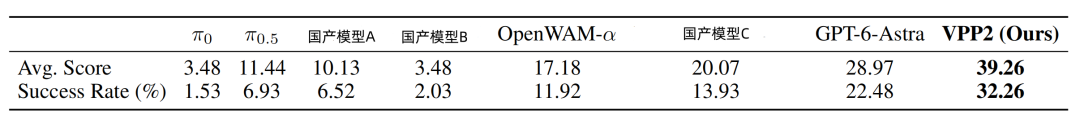
報告數值如下:
VPP2:
39.26 平均分數
32.26% 成功率

GPT-6 Astra:
28.97 平均分數
22.48% 成功率
因此,兩者差距為:
成功率:
+9.78 個百分點

平均分數:
+10.29 分
這兩項指標衡量的是不同內容。
成功率衡量機器人是否完成整項任務。
平均分數則會在任務未完全完成時,根據完成進度提供部分分數。
對於長時程或高難度操作任務而言,這一點很重要,因為策略可能在失敗前正確完成多個階段。
RoboDojo 的總分整合了五個能力維度。
VPP2 並不是在每個維度都排名第一。
目前其領先的維度包括:
在每一個長時程或開放詞彙類別中,它都不是最高分模型。
這其實提供了有用的背景資訊。
這些優勢與 VPP2 的設計方向一致:模型高度重視學習物理場景如何變化,並在加入機器人動作後保留這種預測能力。
結果表明,影片預測品質可能正轉化為更可靠的操作能力,使模型能夠應對物體位置、場景布局、任務措辭、動作順序以及先前任務狀態的變化。
RoboDojo 雖然具有挑戰性,但模擬終究仍是模擬。
真實機器人還會面臨摩擦力、物體變形、攝影機噪聲、校準誤差、夾爪滑動、機械延遲以及放置位置細微差異等額外問題。
因此,RobotEra 也在真實的 ALOHA 雙臂平台上測試了 VPP2。
評估涵蓋十個零樣本任務類別:
VPP2 的成績為:
平均成功率 58.5%
Physical Intelligence 的 π0.5 達到:
40.0%
FastWAM-14B 則達到:
20.5%
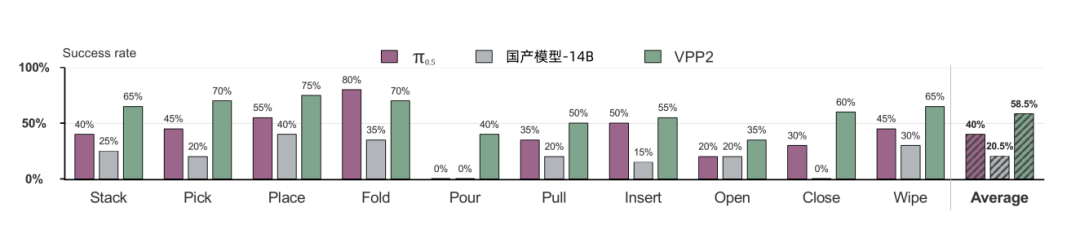
VPP2 在十個類別中的九個取得最佳結果。
例外是 摺疊,π0.5 在該類別的分數更高。
這是一項重要細節,因為它讓比較更加客觀:VPP2 並沒有在每一項任務中都占據優勢。
VPP2 屬於通常被稱為 **世界動作模型(World Action Models,WAM)**的一類系統。
其一般理念是:
觀察當前世界
→ 預測世界應如何變化
→ 將預測轉換為機器人動作
這種方法很有吸引力,因為大型影片模型已經具備關於物體運動、人類活動、物理互動以及場景動態的有用知識。
但其中存在一個重大問題。
一段影片看起來合理,並不代表它對機器人而言是正確的。
假設指令是:
拿起左邊的杯子
影片模型可能生成一段完全逼真的影片,內容是機器人拿起右邊的杯子。
從視覺上看,這段影片是連貫的。
但作為機器人計畫,它是錯誤的。
第二個問題更加微妙。
如果將動作模組與影片模型過度同步訓練,動作目標可能會損害影片模型原本的泛化能力。
機器人可能學會特定的訓練任務,卻在陌生任務上的表現變差。
VPP2 正是針對這兩種失敗模式設計的。
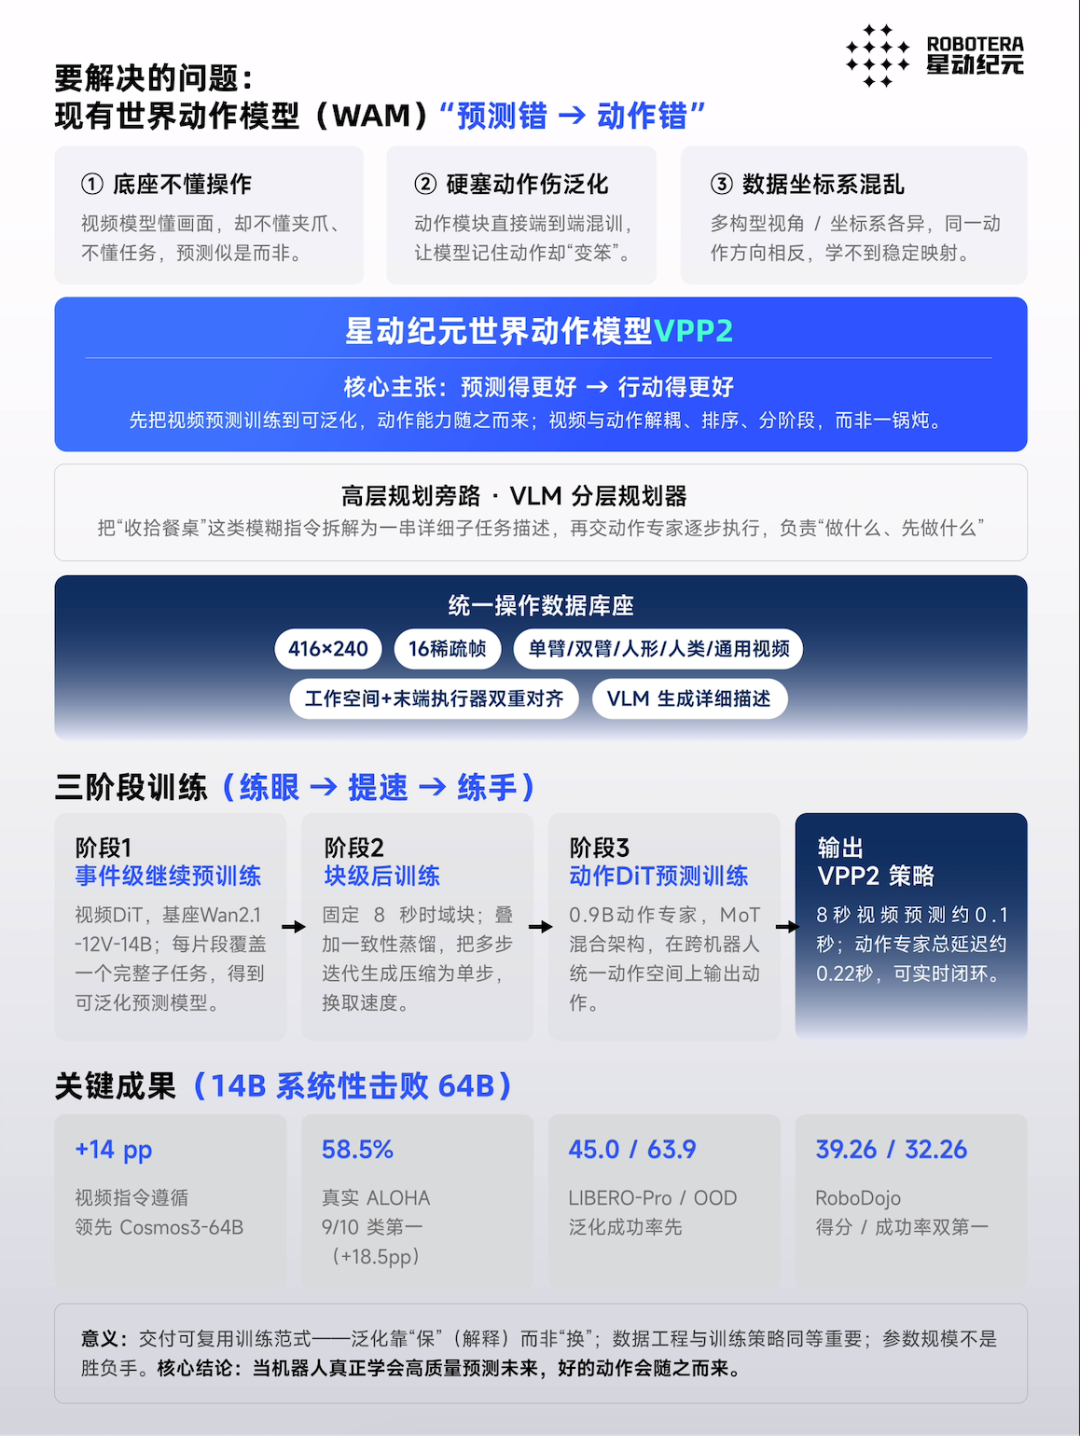
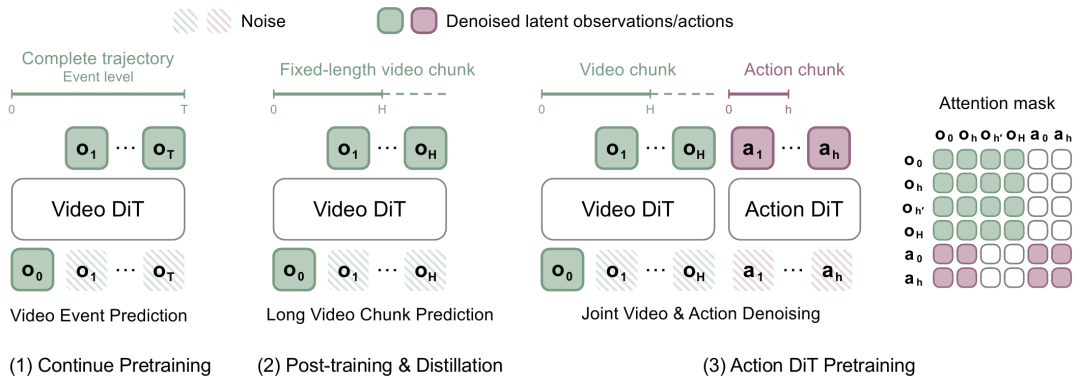
VPP2 論文介紹了一套三階段流程。
VPP2 從 Wan2.1-I2V-14B 開始。
團隊在一套大型、多樣化的操作影片數據集上繼續訓練,數據包含機器人操作、人類操作、通用影片、不同機器人形態以及不同動作風格。
關鍵不只是數據量。
更重要的是影片如何被標註。
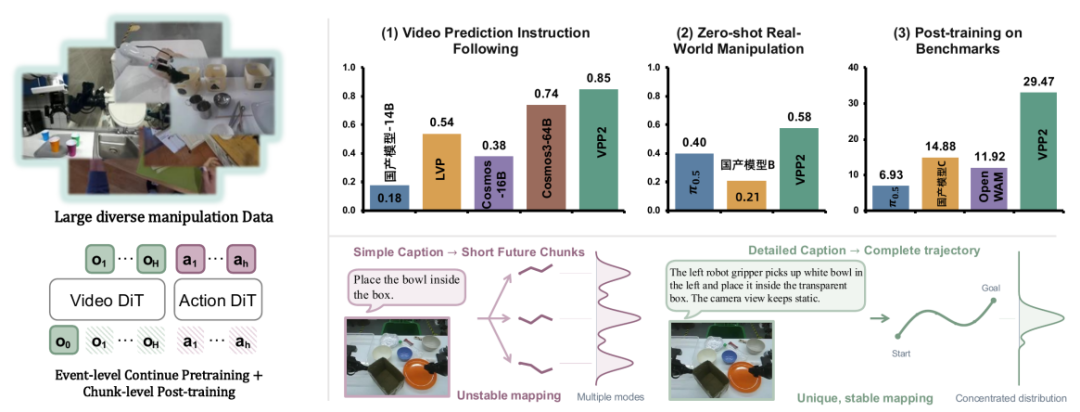
團隊沒有使用模糊的描述,而是採用更詳細的說明,明確指出哪一隻手臂正在動作、哪個物體是目標、物體應該移動到哪裡、正在執行什麼完整操作,以及所使用的攝影機視角。
這可以降低語言與動作之間的歧義。
許多影片預測系統只學習預測一個短暫的未來窗口。
這可能造成多個看似合理的未來結果。
VPP2 則強調事件級預測。
模型不是只學習接下來幾幀畫面,而是以完整的操作事件作為訓練對象。
例如:
靠近杯子
→ 抓住杯子
→ 抬起杯子
→ 移向盒子
→ 將杯子放入盒子
模型會學習整個事件的完整軌跡。
這使語言到動作的映射更加具體。
論文評估了影片預測器是否真正遵循操作指令。
在機器人操作影片指令遵循方面:
VPP2:
0.90

Cosmos3-64B:
0.78
在人手操作方面:
VPP2:
0.80

Cosmos3-64B:
0.70
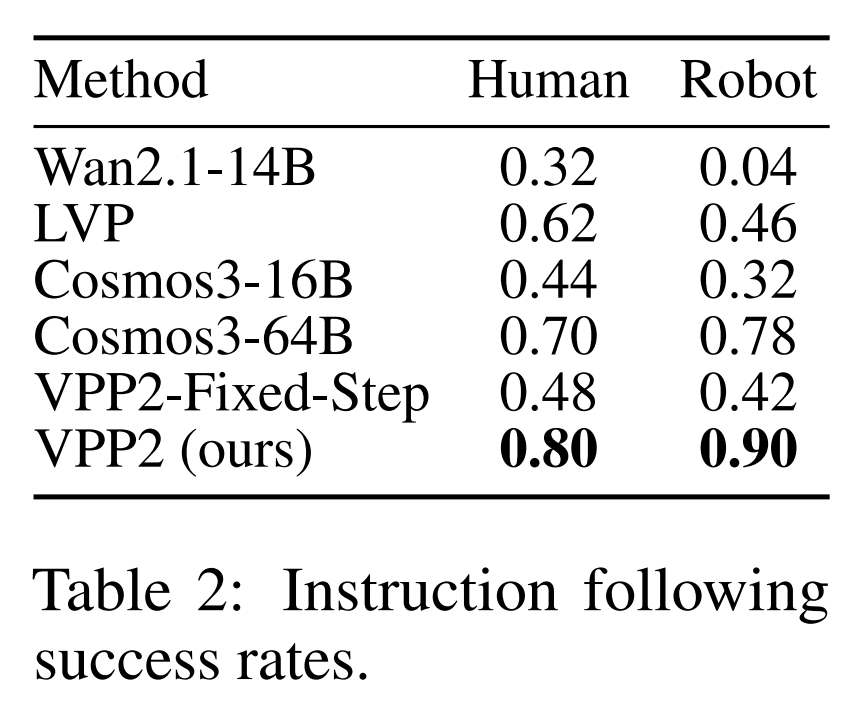
論文將 VPP2 相較 Cosmos3-64B 的平均提升總結為約 11 個百分點。
重要的教訓並不只是「14B 勝過 64B」。
在這項比較中,參數量本身並不是受控變量。
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
兩個模型在訓練數據、目標函數、架構、後訓練方式以及任務專門化程度上都存在差異。
更有力的結論是,在這項評估中,面向操作的事件級訓練與詳細標註,可能比單純增加模型規模更重要。
準確的預測對機器人而言還不夠。
它還必須足夠快速。
機器人不可能在每個動作之前都等待數秒鐘,讓影片生成器完成計算。
因此,VPP2 將事件級預測器轉換為固定時域的視覺規劃器。
系統大約預測:
8 秒
的未來視覺變化。
接著,團隊使用一致性蒸餾,將多步驟生成流程壓縮為單步預測。
論文報告未來影片預測大約需要:
約 0.12 秒
這使影片模型從緩慢的生成器轉變為更接近即時的視覺規劃器。
當影片模型成為快速預測器後,VPP2 再加入動作模組。
動作專家是一個採用 **混合 Transformer(Mixture-of-Transformers,MoT)**架構的擴散 Transformer。
BAAI 來源將論文配置中的該模組描述為一個 0.9B 參數的 Action DiT。
其工作本質上是逆動力學:
當前狀態
+
預測的未來狀態
→ 機器人動作序列
關鍵的訓練選擇是,RobotEra 並沒有將整個影片模型與動作模組從頭開始一起重新訓練。
在動作訓練開始時:
這樣做的目的是保留影片模型已經學到的預測泛化能力。
來源報告的數據約為:
影片預測:
0.12 秒

動作專家:
0.10 秒

動作區塊總延遲:
約 0.22 秒
這些是作者在其實驗配置下報告的測量結果,並不代表所有硬體都能達到相同延遲。
VPP2 也在源自 LIBERO 的泛化基準上接受測試。
LIBERO-Pro 改變物體位置與任務條件,使依賴記憶的行為變得不那麼有效。
VPP2 達到:
整體成功率 45.0%
表中表現最強的基線模型達到:
11.0%
LIBERO-OOD 將熟悉的物體、布局與目標重新組合成未曾見過的組合。
VPP2 達到:
整體成功率 63.9%
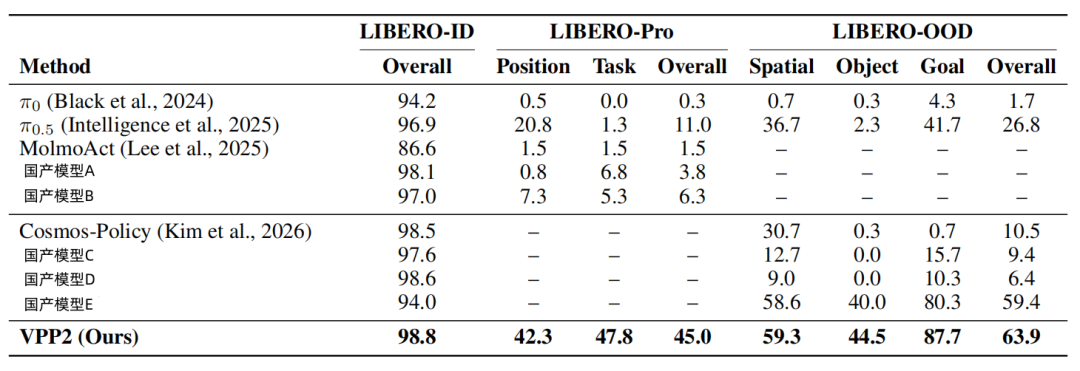
這些結果支持論文的核心論點:
保持強大的視覺世界模型,能在機器人遇到熟悉概念的新組合時,提升動作泛化能力。
VPP2 在物理執行方面表現強勁,但許多長時程任務不只需要快速操作。
機器人還需要決定什麼應該先做、接下來要做什麼、哪些子目標已經完成,以及哪一條指令對應哪個物體。
因此,論文也測試了分層式架構。
高階視覺語言模型規劃器負責語義理解、記憶、任務分解與子目標生成。
VPP2 則執行這些較小的物理任務。
在 RoboDojo 選定的長時程任務組中,報告的平均成功率從:
僅使用 VPP2:
27.6%

VPP2 + 高階 VLM 規劃:
57.6%
在選定配置中,平均成功率超過翻倍。
這帶來了一種有用的架構:
高階 VLM
→ 理解並分解

VPP2
→ 預測物理變化並執行動作

環境回饋
→ 更新下一步決策
BAAI 來源將其總結為:
GPT 思考
VPP2 行動
論文本身使用的是 VLM 規劃器,並不要求特定使用 GPT,因此「GPT + VPP2」應理解為認知規劃器與物理執行模型組合的概念示例。
這種分工指向一種更廣泛的物理 AI 架構。
大型多模態語言模型擅長語言理解、推理、規劃、記憶以及拆解模糊目標。
世界動作模型則針對物理預測、操作動力學、快速動作生成以及閉環執行進行優化。
完整的機器人系統可能將兩者結合:
意圖
→ 推理
→ 規劃
→ 物理預測
→ 動作
→ 回饋
→ 重新規劃
這也是 WAM 正受到關注的原因之一。
它們不必取代大型推理模型,而是可以提供這些模型所缺少的物理執行層。
RobotEra 已發布官方 VPP2 實作。
儲存庫包含:
官方儲存庫還表示,截至 2026 年 10 月 8 日,VPP2 在 RoboDojo-Sim 排行榜上位居總榜第一。
公開模型權重託管於 Hugging Face,並透過 ModelScope 提供額外分發。
目前儲存庫包含評估基準階段所需的資產,但大規模事件級影片預訓練程式碼以及相應的預訓練骨幹模型,仍被列為未來發布項目。
這項區分很重要。
該專案採用開源方式發布,但完整預訓練流程的每個階段目前尚未全部公開。
來源多次表示,VPP2「沒有額外數據」便取得了 RoboDojo 第一名。
這種說法可能被誤解。
VPP2 確實使用了大量訓練數據。
論文描述了用於持續預訓練的大規模多樣化操作影片。
該說法指的是基準提交:
RobotEra 表示,排行榜結果是在沒有額外加入評估專用數據,且沒有使用超出該基準提交標準設定的 Agent RSI 的情況下取得的。
這與模型只使用 RoboDojo 數據訓練完全不同。
來源還指出,RobotEra 正與中國郵政及順豐合作,並已有機器人在中國多個城市和省份的物流場地運行。
這是 RobotEra 正在推進真實部署的相關證據。
但不應將其解讀為 VPP2 本身已經在所有這些生產場地大規模部署的證明。
來源也作出了相同區分。
商業機器人部署可能涉及不同的軟體版本、策略、安全層以及特定任務系統。
VPP2 在大量實體環境中的長期生產穩定性,仍需要更多證據。
| 主張 | 最準確的解讀 |
|---|---|
| VPP2 在 RoboDojo-Sim 排名第一 | 已由官方排行榜確認 |
| 39.26 平均分數 / 32.26% 成功率 | 已確認 |
| VPP2 在該基準上勝過 GPT-6 Astra | 已確認 |
| VPP2 是全球所有機器人模型中最好的模型 | 尚未證明 |
| VPP2 在真實 ALOHA 零樣本任務上取得 58.5% | 已由論文確認 |
| VPP2 在 LIBERO-Pro 上取得 45.0% | 已確認 |
| VPP2 在 LIBERO-OOD 上取得 63.9% | 已確認 |
| VPP2 採用預測—蒸餾—行動三階段流程 | 已確認 |
| VPP2 採用開源方式發布 | 已確認 |
| 所有大規模預訓練程式碼都已公開 | 否;儲存庫待辦清單中仍有部分項目 |
| RobotEra 現有物流部署證明 VPP2 已大規模部署 | 尚未證明 |
VPP2,即 Video Prediction Policy 2,是 RobotEra 與清華大學、香港科技大學(廣州)、加州大學柏克萊分校及上海交通大學合作推出的世界動作模型。它將影片預測作為物理規劃先驗,然後把預測的未來狀態轉換為機器人動作。
是。官方 RoboDojo 模擬排行榜目前將 VPP2 列為第一名,平均分數為 39.26,成功率為 32.26%。
在 RoboDojo-Sim 上,是的。GPT-6 Astra 的平均分數為 28.97,成功率為 22.48%,低於 VPP2 的 39.26 分與 32.26%。
該模型分為三個階段:事件級影片預訓練、固定時域後訓練與單步蒸餾,以及採用混合 Transformer 架構的 Action DiT 動作學習。這種設計旨在加入機器人控制能力的同時,保留視覺泛化能力。
影片骨幹模型以阿里巴巴的 Wan2.1-I2V-14B 為起點。RobotEra 隨後使用帶有詳細標註、面向操作的影片繼續預訓練,然後進行蒸餾與動作訓練。
在十個零樣本 ALOHA 任務類別上,論文報告的平均成功率為 58.5%,π0.5 為 40.0%,FastWAM-14B 為 20.5%。VPP2 在十個類別中的九個取得最高結果。
官方實作、基準配置、評估程式碼以及多個模型檢查點已公開。儲存庫仍將大規模事件級影片預訓練程式碼與機器人影片預訓練骨幹模型列為未來發布項目。
VPP2 針對物理預測與動作進行優化,而 VLM 可以處理高階語言理解、記憶與任務分解。在選定的 RoboDojo 長時程任務中,論文報告顯示,加入高階 VLM 規劃後,平均成功率從 27.6% 提升至 57.6%。
VPP2 的主要成果不只是登上 RoboDojo-Sim 榜首。更值得關注的是其背後的訓練策略:先讓影片模型準確預測操作行為,再加速預測流程,最後才訓練動作專家。
這種分離式方法似乎有助於保留泛化能力。同一模型系列在 RoboDojo、ALOHA 零樣本、LIBERO-Pro 與 LIBERO-OOD 上都報告了良好結果,而高階 VLM 規劃器還能進一步提升長時程任務完成率。
不過,仍需謹慎解讀這些結果。RoboDojo 第一名是一項基準結果,而不是跨所有機器人與環境的通用排名;現有物流部署也不能證明 VPP2 本身已經在生產環境中大規模運行。
VPP2 最重要的貢獻,是提供了證據表明更好的物理預測可以轉化為更好的零樣本動作,而且與從一開始就將預測和動作混合訓練相比,先後分階段訓練預測與動作可能更加有效。
從一句話開始,幾分鐘內拿到完整網站。