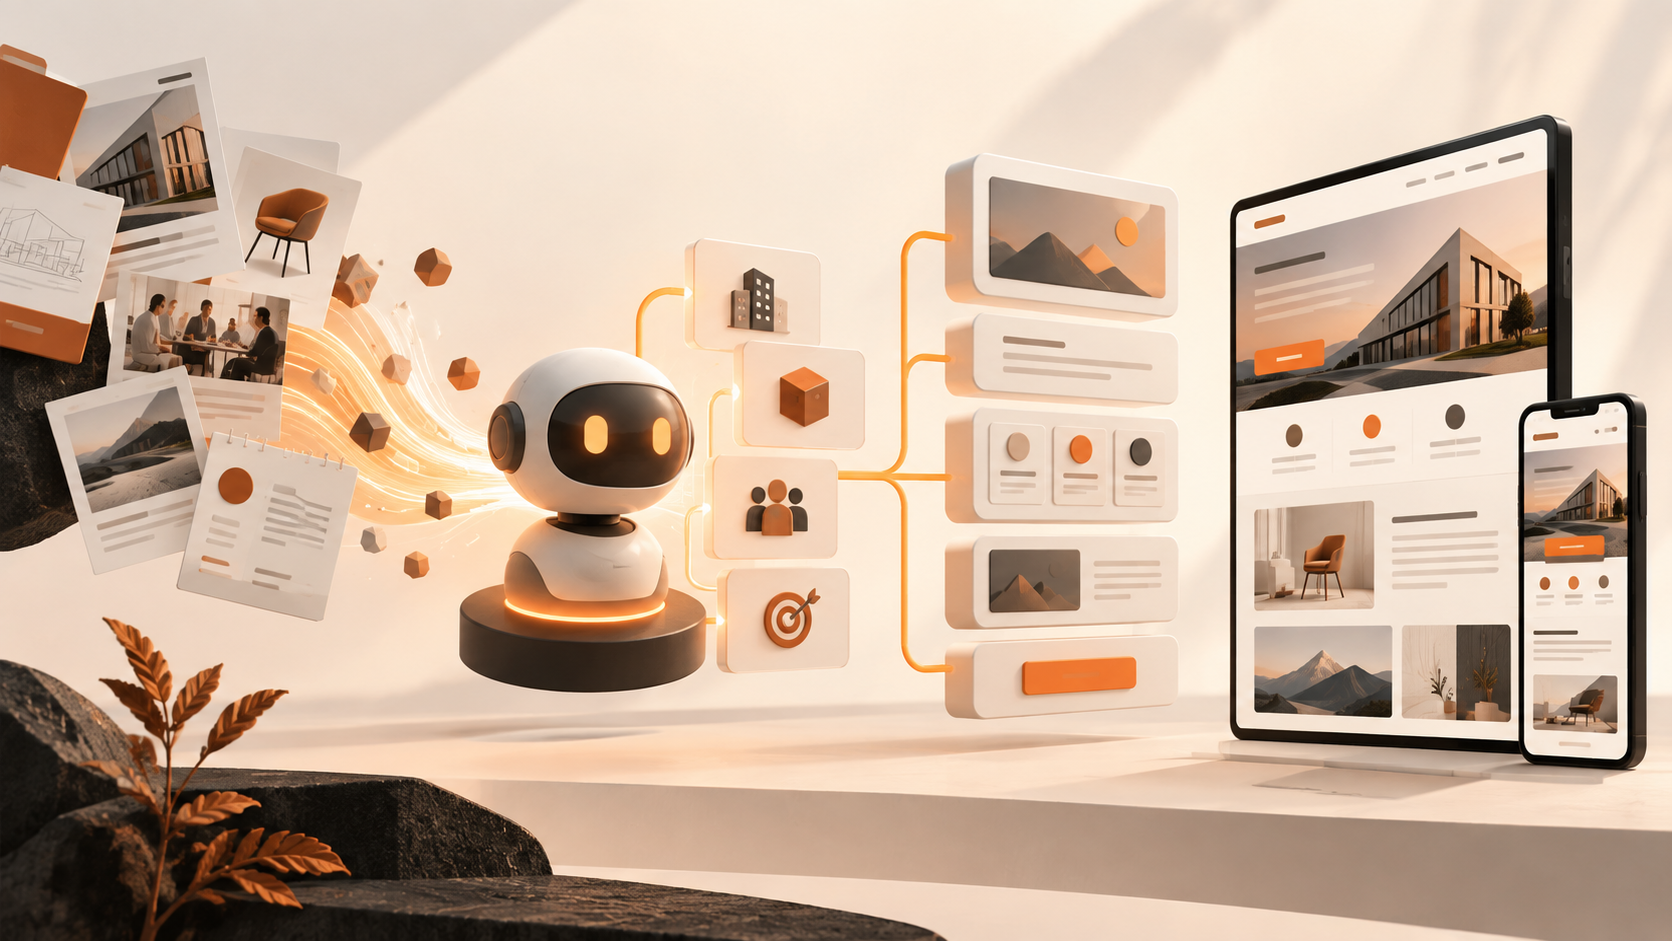
AI 建站原理可以拆成一条清晰链路:把品牌资料解析成结构化实体,把自然语言需求追问成字段,由多 Agent 分工生成页面与内容,再通过智能排版渲染成响应式页面,最后部署上线并持续迭代。本文按环节解释每一步在做什么、品牌资料如何影响页面骨架、可引用性(Schema、FAQ、意图标注...
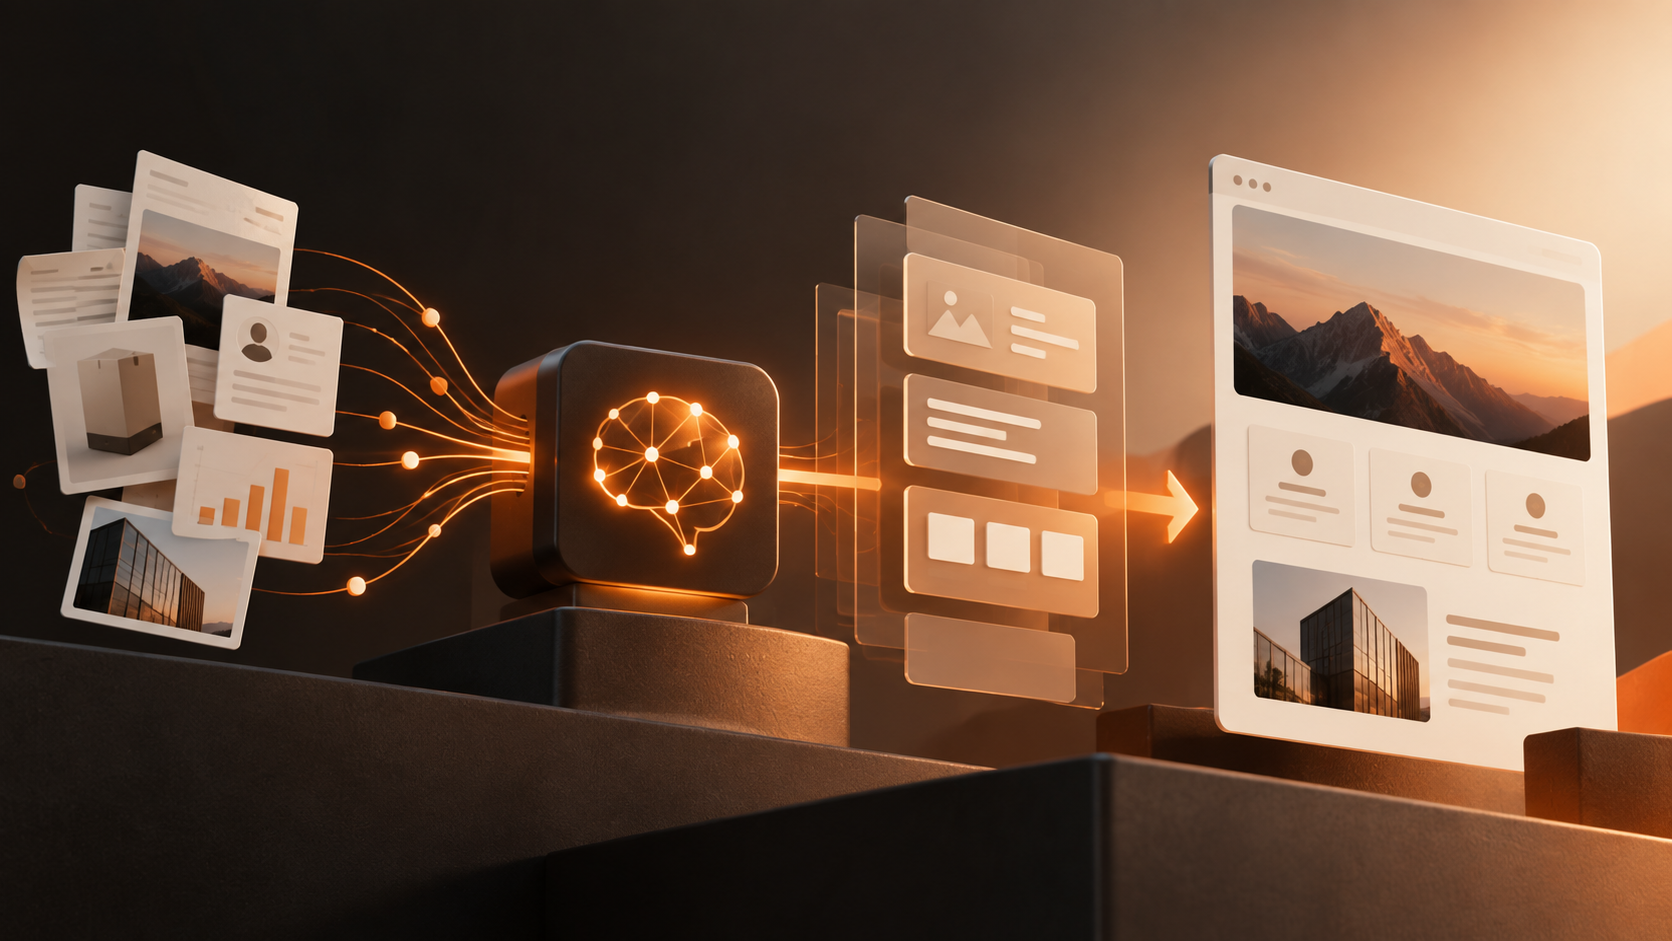
同一套 AI 建站工具,有人十分钟拿到能用的初稿,有人改了一下午还是不能用。差别通常不在模型大小,而在两件事:品牌资料有没有被结构化,页面结构有没有被当成可控对象来生成。
传统建站是一条人力流水线:产品经理写需求文档,设计师出 UI 稿,前端还原页面,后端搭数据库与接口,测试验收后部署上线。慢的根源不在某个环节不够努力,而在需求到成品之间的每一次翻译——业务语言译成设计稿,设计稿再译成代码——都依赖人力,且基本不可逆。AI 建站原理做的事情,是把这些翻译动作替换成机器可执行的结构化转换:输入是品牌资料加一句需求描述,输出是可发布的页面结构。
这条链路并不神秘,它可以被拆成四个可观察的环节,而且每个环节的输入质量都会直接决定最终页面的上限。
理解这条链路,先要分清两类完全不同的输入。
非结构化输入是原始素材:一份公司介绍 PPT、几张产品图、一段口述需求。它信息密度高,但机器无法直接把它映射到页面模块。
结构化输出是页面结构:页面清单、模块顺序、字段定义、组件类型、样式变量、语义标记。它可以直接被渲染成 HTML,也可以被 CMS 接管维护。
AI 建站原理,就是在两者之间建立一条可复用的映射链路:
| 环节 | 输入 | 机器动作 | 输出 |
|---|---|---|---|
| 资料解析 | 公司介绍、产品资料、案例 | 抽取实体与字段 | 结构化实体集 |
| 需求补全 | 一句自然语言描述 | 对话式追问,补齐缺失字段 | 结构化需求单 |
| 分工生成 | 结构化需求单 + 实体集 | 多角色协作生成页面与内容 | 页面骨架与初稿 |
| 智能排版 | 页面骨架 | 套用版式规则与断点策略 | 响应式页面 |
| 语义标注 | 页面事实与问答 | 注入结构化数据 | 可被机器读取的站点 |
如果只记住一句话:AI 建站不是"让模型直接写出一个网站",而是让模型把资料翻译成结构,再把结构渲染成页面。结构这一层是否可控,决定了后续所有修改的成本。
AI 不会直接"读懂"一份 PPT。它做的是把非结构化资料切成可字段化的实体,通常分四类:
这一步的质量决定后面所有页面。资料里写"我们是一家创新型企业",AI 只能生成一句通用口号;资料里写清"服务跨境电商卖家、交付周期 15 天、不承接纯代运营",AI 才能生成有边界的服务说明和与之匹配的落地页结构。
这也是很多"生成结果很空"的真实原因:不是排版不好,而是没有实体可排。实体定义页之所以重要,是因为它承担了向人类和机器同时说明"你是谁"的职责——如果官网事实层不完整,AI 更容易引用第三方解释,甚至产生错误归因(官网作为 AI 证据层|Global Gravity)。
自然语言描述天然信息不全。用户说"我要一个餐饮官网,能在线订座、门店导航",模型需要把它拆成三类字段:页面清单(首页、菜单、门店、订座)、功能模块(订座表单、地图组件)、业务流程(选门店→选时段→留手机号→确认)。
对话式追问的价值就在这里:把模糊描述补成可执行的结构化需求,而不是让模型去猜(AI 建站是怎么工作的|搜狐)。追问通常会补三类缺口:
写需求时可以直接套一个模板:「面向 [目标客户] 的 [站点类型],需要 [页面清单],包含 [功能模块],风格参考 [参考站点或品牌规范]」。这一句往往比十分钟自由发挥的描述更有效。
成熟的 AI 建站平台不会用一个模型包打天下。以多 Agent 架构为例,引擎会拆分为需求解析、方案设计、页面生成、代码构建、内容创作、质量校验等角色,不同智能体分工完成建站各环节(新版阿里云万小智 AI 建站全解|阿里云开发者社区)。
分工带来的直接好处是"可局部返工":文案不满意只重跑内容环节,配色不满意只重跑设计环节,而不是整站重来。同时资源与安全边界也需要在这一层处理——如果后续用 API 或 CLI 做自动化集成,访问密钥不应硬编码在代码里,应通过环境变量读取(新版阿里云万小智 AI 建站全解|阿里云开发者社区)。
排版层解决的是"同一份结构如何在手机、平板、桌面上都合理"。它依赖一套版式规则:栅格与间距体系、字号层级、模块优先级、断点策略。生成结果通常会自动适配 PC 与移动端响应式布局(新版阿里云万小智 AI 建站全解|阿里云开发者社区),人工只需要在可视化画布里做微调。
排版在 AI 时代承担两个目标,而不是一个。
对人类访客:清晰的视觉层级、合理的留白、明确的行动按钮。这决定停留与转化。
对 AI 与搜索引擎:页面需要同时提供结构化事实、实体定义、证据数据和问答覆盖(官网作为 AI 证据层|Global Gravity)。一段"看起来很酷但读不出信息"的全屏视频背景,对人类可能是加分项,对机器解析却是噪声。
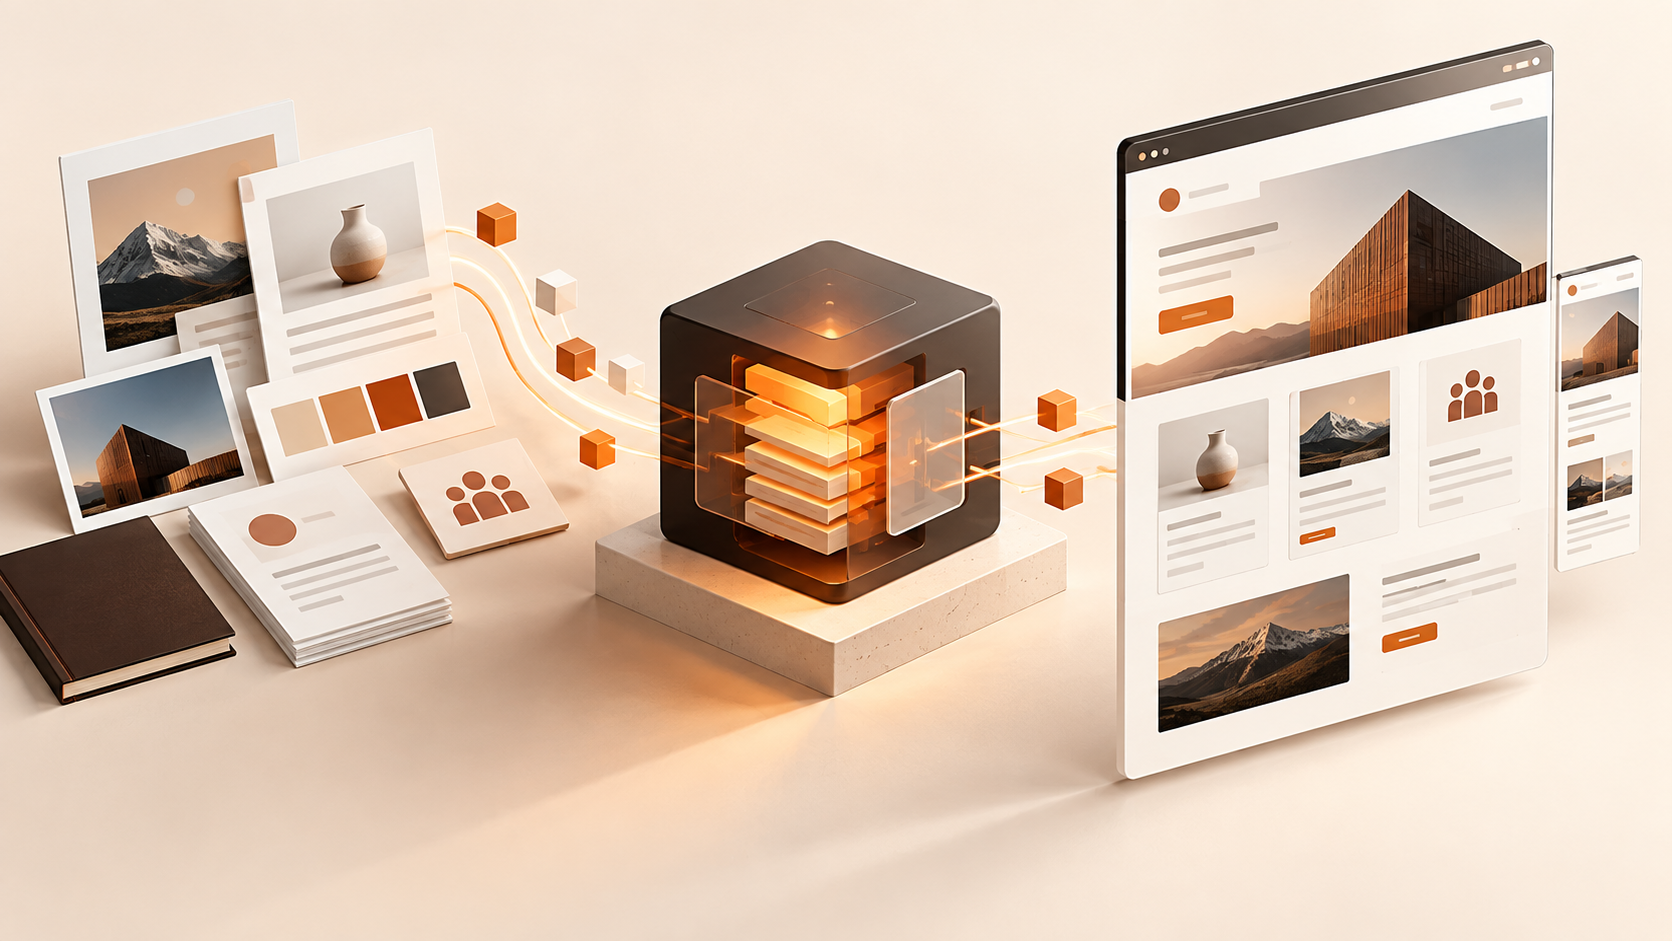
想把资料一次性准备对,可以按下面这张表整理。左侧是资料类型,右侧是它直接影响的页面结构。
| 资料类型 | 具体内容 | 直接决定的页面结构 |
|---|---|---|
| 实体事实 | 公司全称、成立时间、总部、核心业务、服务市场 | 关于我们、实体定义页、页脚 |
| 产品信息 | 名称、参数、价格区间、交付边界 | 产品页、定价页、对比表 |
| 信任证据 | 客户名单、资质、案例过程与结果数据 | 案例页、信任条、客户证言区 |
| 行动入口 | 咨询方式、表单字段、预约流程 | 转化区、联系页、CTA 模块 |
| 视觉资产 | Logo、主色、字体、真实产品图 | 全站样式变量、Banner 区 |
| 内容素材 | 常见问题、行业术语、长文 | FAQ 模块、博客/知识库栏目 |
补齐顺序也有讲究:先补实体事实和行动入口,再补视觉资产。反过来做,往往会得到一个好看但说不清"你是谁、怎么找你"的站点。
资料结构化之后,下一步是映射成站点骨架。一个可运营的官网骨架通常包含四类页面:实体定义页、价值证明页(产品与服务、案例)、信任与合规页(隐私政策、资质声明、服务边界)、转化页(联系、预约、报价申请)。映射完成后做一次自查:站点层级不超过三层,主导航条目控制在 5–7 个,每个页面只承担一个主要意图。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
如果官网的目标不只是被看到,还要在 AI 回答里被正确描述,页面结构需要多补三件事。
第一,补齐结构化数据。 Organization、Product、Service、FAQPage、Article 等类型应尽量标注完整。Schema.org 是 Google、Microsoft、Yahoo、Yandex 共同发起的开放词表,覆盖实体、实体关系与动作,支持 RDFa、Microdata 与 JSON-LD 多种编码(Schema.org);FAQ 页面同时配置 FAQPage 标注,能让问答结构被机器直接读取(官网作为 AI 证据层|Global Gravity)。跨页面实体建议通过 URI 引用建立关联,避免出现"产品页标了 Product 却没有 Offer、新闻页只有 Article 却没有 Organization"这类标记孤岛(官网如何让 AI 看懂|涛飞网络)。
第二,标注可执行意图。 不要只描述"我们提供咨询服务",还要声明可执行动作节点,让 AI 能识别"用户想做咨询"并定位到真实可提交的入口;声明时注意 target 必须指向真实可用、经 HTTPS 可访问的表单地址,不要声明尚未上线的功能(官网如何让 AI 看懂|涛飞网络)。
第三,为多模态内容设置统一锚点。 同一产品的文字、参数表、演示视频若各自独立标注,机器会视为无关内容;用同一个根 ID 关联起来,任一模态被解析时都能带出其余维度(官网如何让 AI 看懂|涛飞网络)。
一个最小可用的 FAQ 结构化标注示例:
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "AI 建站生成的网站可以绑定自己的域名吗?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "可以。生成完成后可在平台内绑定自有域名,并按目标市场要求完成相应的备案或解析配置。"
    }
  }]
}
第一,官网的定位从展示页变成证据层。 它不只是给人看的门面,也是 AI 判断企业身份、服务范围、案例与可信度的信息来源(官网作为 AI 证据层|Global Gravity)。
第二,资料质量开始直接影响获客质量。 过去资料潦草可以靠销售话术补,现在机器读到的就是它转述的。把交付边界、适用客户和不适用场景写清楚,反而能过滤掉不匹配的询盘。
第三,迭代速度应当成为选型标准。 判断一套方案是否真用 AI,可以看三点:能否用你的真实需求现场演示、交付物是否可运营(支付、表单、后台管理真实可用)、改需求是否需要重新排期(AI 建站是怎么工作的|搜狐)。
AI 建站不是无人值守。以下事项仍需人工判断:
把这套原理对应到具体工具,可以直接用三个问题做判断:资料能否被结构化输入、结构能否被局部修改、上线后能否持续运营。
we0 的流程与上面的链路基本重合:用自然语言描述想法,也可以附上参考图和文档,多 Agent 协作把描述转成可运行的网站,然后在可视化画布里微调,再一键部署到自有域名(We0 官网)。对需要长期获客的团队来说,更值得关注的是生成之后的环节——页面结构、内容维护与搜索优化如果分散在几套工具里,官网就很容易退回成一次性交付物。把建站与增长执行放在同一个工作台里,官网才更可能变成持续运营的获客入口。
对创业者和中小团队而言,务实的做法是:先把品牌资料结构化,用 AI 快速得到一份可信的页面骨架,再在这个骨架上持续补案例、FAQ 与结构化标注,让站点同时服务访客和 AI。
取决于平台。模板型方案往往只产出展示型页面;支持后端管理与数据模型的方案可以生成包含前端页面、后端管理与数据库结构的完整站点,表单、会员、支付等模块按需配置(新版阿里云万小智 AI 建站全解|阿里云开发者社区)。选型时应确认交付物是否可运营,而不只是能否打开。
可以启动,但页面结构的上限会被资料量限制。建议至少先补齐四类最小信息:公司实体事实、产品参数与价格区间、一条可验证的信任证据、明确的咨询入口。缺什么,AI 生成的对应模块就会偏空泛。
主流方案支持局部调整。多 Agent 分工的架构下,需求解析、页面生成、内容创作和质量校验由不同角色承担(新版阿里云万小智 AI 建站全解|阿里云开发者社区),因此文案、素材、版式可以分模块返工;对话修改与可视化编辑通常并存。
基础设施可以在生成阶段就内建:TDK、Sitemap、Schema 标记与面向 AI 的站点声明可随生成一并完成(AI 建站是怎么工作的|搜狐)。但内容质量、案例证据和服务边界声明仍需人工补齐,这些才是被稳定引用的前提(官网作为 AI 证据层|Global Gravity)。
建议看趋势而不是单次结果:品牌是否更常被正确描述、核心场景是否被覆盖、错误引用是否减少。不同模型的引用本身存在波动,单次回答不宜当作排名报告(官网作为 AI 证据层|Global Gravity)。
对展示型官网、落地页、作品集和活动页,AI 建站可以明显压缩从需求到上线的时间。涉及复杂业务系统、深度定制交互或强合规要求的场景,仍然需要开发与法务参与;AI 更适合承担结构生成与内容初稿的部分。
AI 建站原理是一条「资料结构化 → 需求结构化 → 多 Agent 分工生成 → 智能排版与语义标注 → 部署迭代」的转换链路,本质是把传统建站里多次人力翻译压缩成一次可复用的结构化生成。真正决定成色的不是模型参数,而是输入资料的完整度与页面结构的可控性:实体事实决定"关于我们"能否说清你是谁,行动入口决定访客能否找到你,结构化数据与 FAQ 决定机器能否准确转述你。对企业而言,官网的角色正在从展示页转向证据层,越早把品牌事实整理成机器可读的结构,后续的内容运营与获客成本越低。工具负责把结构快速变成可上线的页面,业务判断、合规口径与品牌调性仍需人来做最终把关。
从一句话开始,几分钟内拿到完整网站。