AI 建站让官网上线变得很快,但"被 AI 理解""被访问""产生咨询"是三件不同的事。本文给出一套三层分流框架与可执行的自查步骤,帮助创业者和营销团队用不同信号分别判断内容是否进入 AI 答案、页面是否真的有人看、咨询是否真实发生,并说明在 we0 这类一体化建站平台上如何把这...
传统建站时代,官网的反馈链条相对单一:改标题、发外链、看排名和访问量,有流量就大概率有咨询。生成式搜索改变了这个链条。
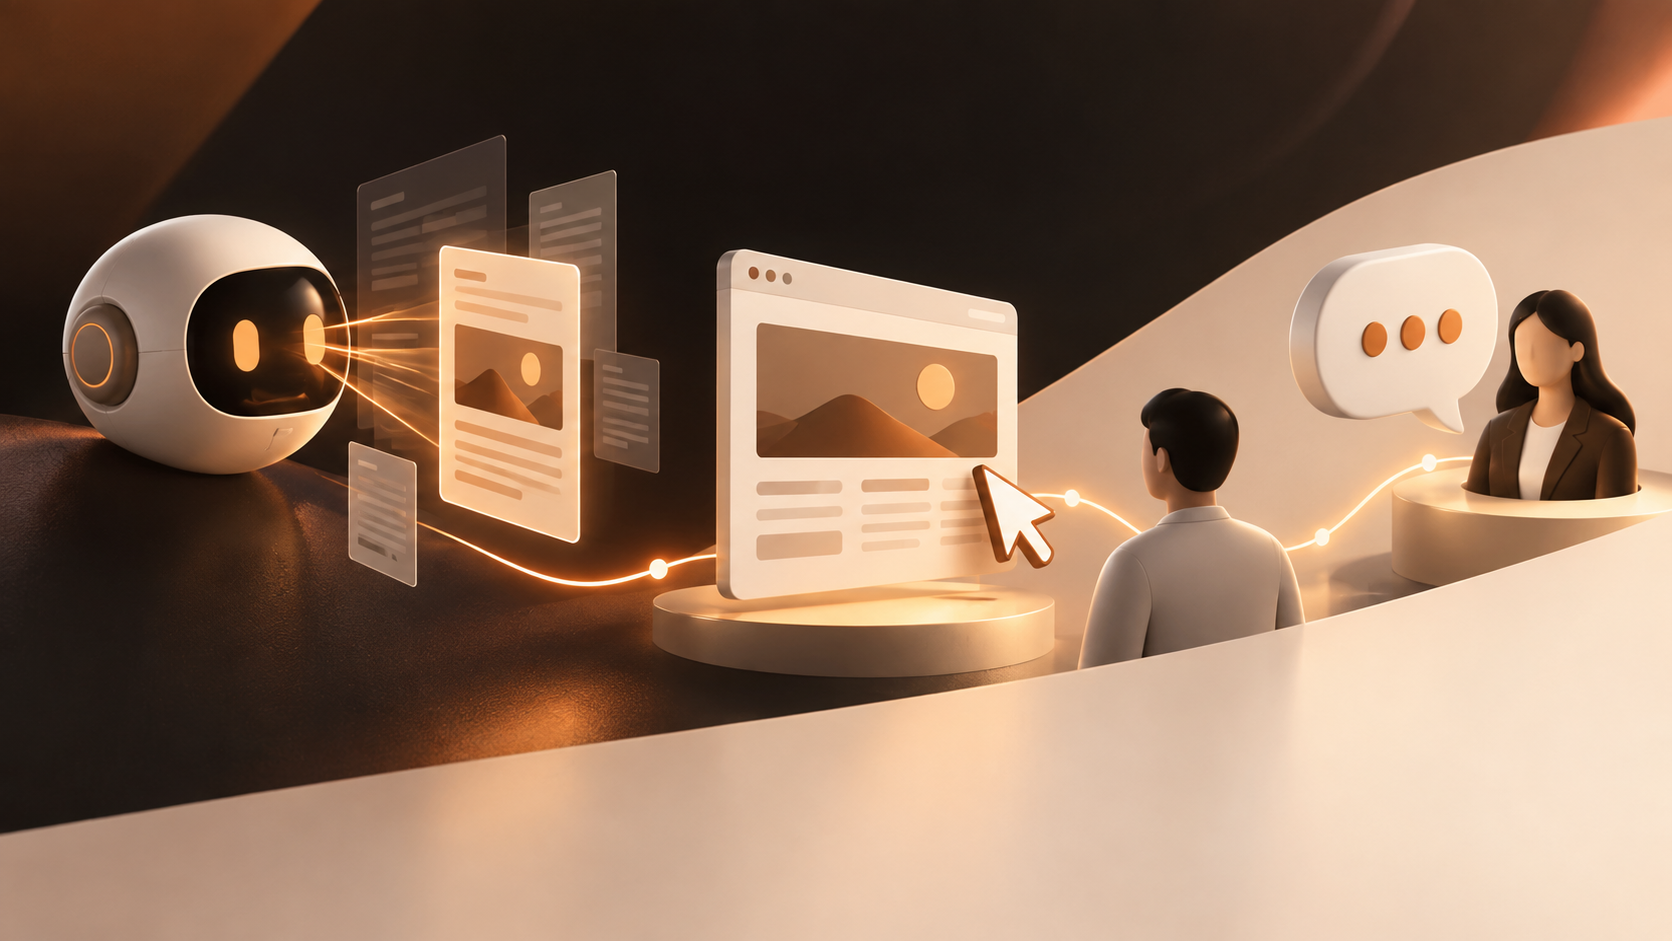
用户向 AI 提问时,大模型不再返回一串链接列表,而是综合检索后直接生成答案。品牌面临的挑战从"如何出现在结果第一页"转向"如何被 AI 推荐给用户"(新京报)。这意味着:
三条路径各自成立,却常常被同一张"网站分析报表"混在一起统计。这正是误判的来源。
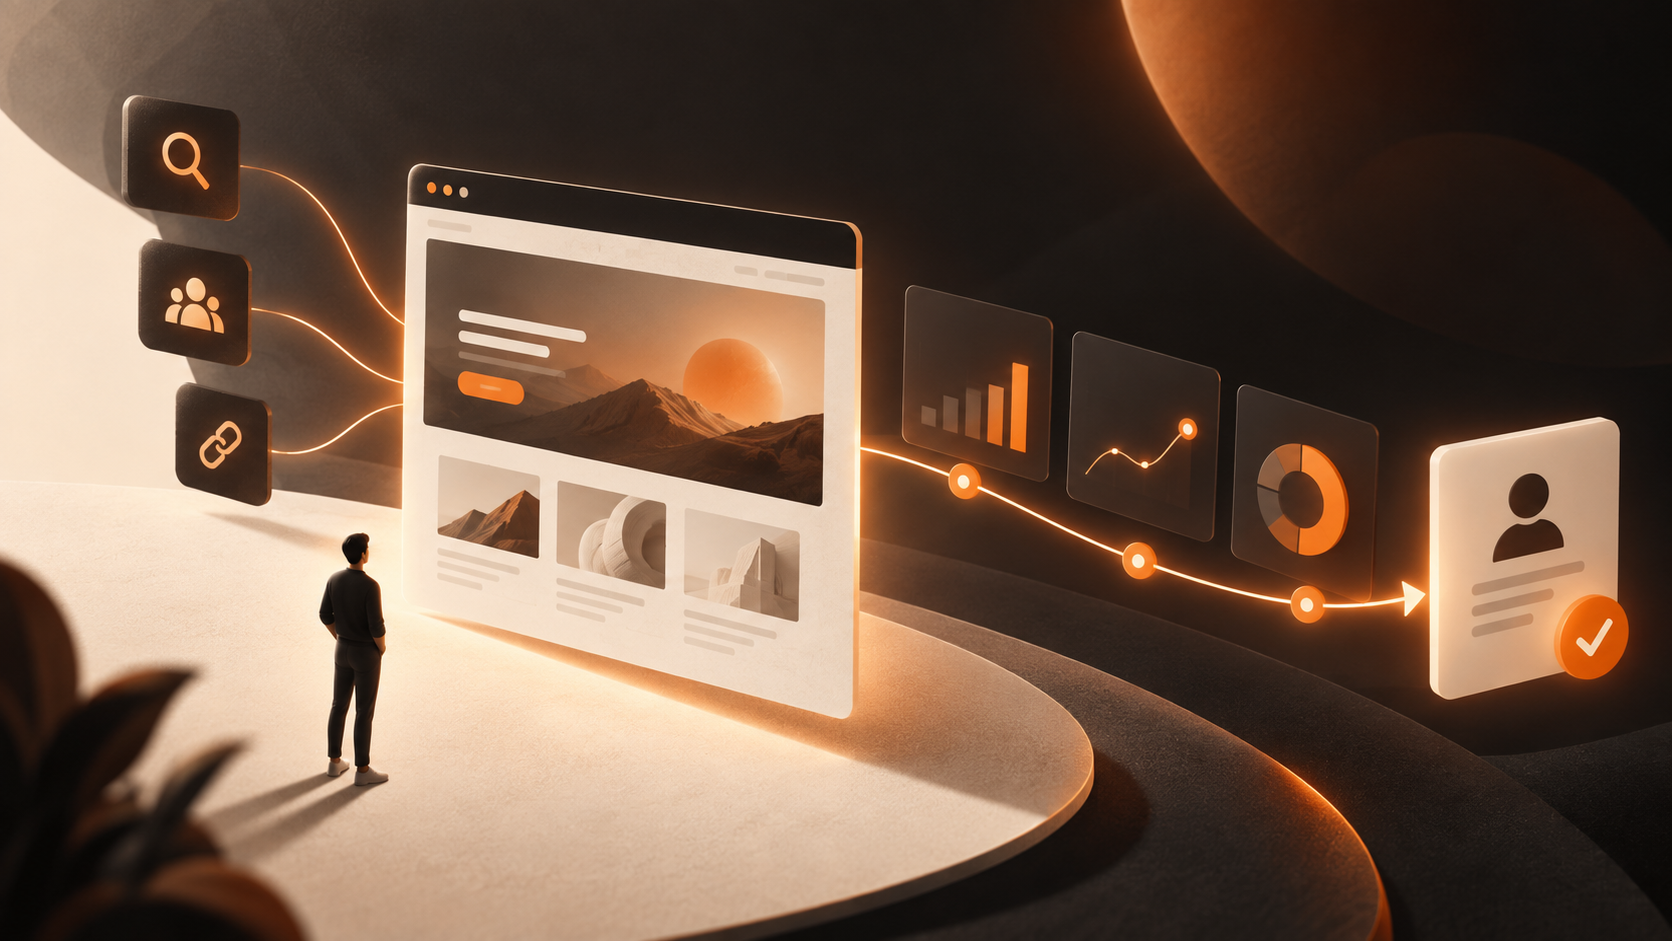
判断体系可以按下面的顺序自检:内容先要被机器读到,再被人访问,最后才有转化。任一层断裂,下一层都不会凭空出现。
| 层次 | 核心问题 | 主要判断信号 | 常见失败原因 |
|---|---|---|---|
| 第一层:AI 理解 | 内容是否被大模型检索并采信 | AI 回答中出现品牌与正确事实;实体信息在全网一致 | 核心文字写在图片里、缺少结构化标记、实体描述各处冲突 |
| 第二层:页面访问 | 是否有人真正打开页面 | 落地页会话数、来源渠道构成、停留与跳出 | 抓取通道受阻、页面噪声大导致答案里不给链接 |
| 第三层:咨询发生 | 是否产生有效线索 | 表单提交、咨询渠道留言、线索来源自述 | 转化入口不明显、缺少承接页面、线索未归因 |
这张表的关键价值在于:它把"没效果"这个模糊结论,拆成了三个可以分别验证的假设。 下面逐层展开。
这一层的本质是"机器可读性"。生成式引擎受上下文预算限制,读取页面时通常经历候选生成、挑选页面、渲染正文、剪枝、注入上下文的链路,页面越大、噪声越多,核心内容越容易被截断(腾讯云开发者社区)。
判断这一层是否成立,用三个动作即可:
动作一:直接向多个 AI 工具提问。 用你希望被回答的真实问题去问,比如"做外贸独立站的建站平台有哪些",观察品牌是否被提及、被提及的事实是否准确。记录的是"提及"和"准确性",而不是排名。
动作二:核对实体一致性。 实体包含企业名称、业务范围、产品参数、项目案例、资质信息等要素。如果全网多个渠道出现相互冲突的信息,大模型会降低该实体的可信度,相关内容可能被排除在候选素材池之外(腾讯云开发者社区)。
动作三:检查页面的机器可读结构。 核心业务文字不要放在图片、弹窗或视频里;用 JSON-LD 标注企业、产品、FAQ 等实体;把结论放在段落开头,保持一段只讲一件事。
一个可直接使用的 FAQ 结构化标记示例:
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "AI 建站生成的网站能自己改内容吗?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "可以在可视化画布中调整页面结构与文案,并通过后台管理持续维护内容。"
    }
  }]
}
这一层最容易出现的错误是"把所有访问当成有效访问"。建议按来源拆分观察:
一个实用的判断条件是:如果某个页面在 AI 回答中被引用,但对应落地页几乎零会话,说明"理解"和"访问"之间断了——这是正常的,因为 AI 答案常常直接满足用户,不必然导流。此时不该去优化页面体验,而应把目标改成"让品牌与联系方式出现在答案里"。
反过来,如果访问量健康但咨询为零,问题在第三层,与 AI 搜索优化无关。
咨询是唯一需要"人"参与验证的一层。有效的判断方式不是看总量,而是看归因:
传统 SEO 面向网页爬虫,目标是网页在搜索列表获得排名,衡量指标以曝光、点击量为主;AI 搜索优化面向大模型的检索采信机制,指标侧重引用频次与实体识别准确度(腾讯云开发者社区)。用点击量考核 AI 搜索优化,本身就是指标错配。
按顺序执行以下检查,遇到第一个"否"就是当前该解决的问题:
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
llms.txt 或等价的页面清单,指明哪些页面最重要?前 5 项属于第一层,第 6 项属于第二层,后 2 项属于第三层。
三个落地原则:
第一,分开设指标,不要合并汇报。 给第一层设"AI 提及率与事实准确率",第二层设"分渠道会话数",第三层设"有效咨询数与来源分布"。三张表,三套负责人。
第二,先修底层,再修上层。 实体不一致、内容不可读的情况下加大投放或堆内容,只会放大噪声。
第三,把 AI 搜索优化当成持续运营而非一次性项目。 业务变更时同步更新旧素材,消除过时信息带来的实体冲突,并周期性复盘词库、内容与信源表现(腾讯云开发者社区)。
对于刚用 AI 建站工具上线官网的团队,比较务实的做法是:上线后第一周只做第一层检查,确认内容能被正确读取和识别;第二周接入访问分析并拆分来源;第三周补齐咨询入口和归因字段。不要在上线第一天就期待咨询量。
we0 是面向展示型网站的 AI 建站与获客增长平台,产品链路覆盖从自然语言描述需求、多 Agent 协作生成、可视化画布调整到域名部署,并在同一工作台内提供 SEO 与 GEO 优化、CMS 后台和内容持续运营能力(we0.ai)。
对于本文讨论的三层判断,它的实际意义在于减少工具切换成本:官网生成、结构化信息维护和内容更新在同一处完成,实体信息不容易因为分散在多个系统而出现口径冲突——而实体一致性正是第一层能否成立的基础。
需要说明的是,AI 是否引用某个页面、引用后是否带来访问与咨询,取决于大模型的检索与生成机制、内容本身的信息密度以及用户的实际需求,建站平台只能影响"机器能否准确读到"这一段,无法决定结果。把三层指标分开观察,比期待某个工具直接解决问题更可靠。
需要。AI 建站解决的是"网站能否快速上线",AI 搜索优化解决的是"内容能否被模型正确读取和采信"。上线只是起点,实体信息一致性、结构化标记、核心文字可提取性都需要单独处理。
不一定。生成式引擎常常直接给出答案而不导流,被引用本身就是认知层面的收益。如果目标是访问量,应把重点放在答案中是否包含可点击的落地页链接;如果目标是获客,则应确保品牌与联系方式完整出现在答案中。
看问题具体程度。询问具体方案、报价、交付周期的属于高意向;只问"你们是做什么的"的属于早期认知。同时用表单的来源自述字段做归因,避免把所有咨询都算作同一个渠道的成果。
两者解决不同问题。Schema 帮助模型识别页面上的实体和关系,降低识别错误;llms.txt 用于在有限的上下文预算内指出哪些页面最重要。建议先保证核心文字可提取、实体信息一致,再补这两项配置。
自查层面可以立刻验证:用真实问题向多个 AI 工具提问即可观察是否被提及。但 AI 答案的更新受检索与训练机制影响,存在滞后,通常需要连续观察数周才能判断趋势,不宜用单次结果下结论。
不能直接套用。传统 SEO 面向网页爬虫,指标以曝光和点击为主;AI 搜索优化面向模型的检索采信机制,关注的是引用频次和实体识别准确度。用排名工具衡量后者会造成指标错配。
AI 建站上线后判断效果,关键是把"理解、访问、咨询"拆成三层独立指标。第一层看内容能否被模型正确读取:用真实问题向 AI 提问验证提及与准确性,核对全网实体信息是否一致,检查核心文字是否可提取并配备结构化标记。第二层看访问是否真实:按来源渠道拆分会话,接受"被引用但不导流"是常态。第三层看咨询是否可归因:用来源自述字段区分渠道,用问题具体程度区分线索质量。三层各有独立负责人和独立报表,先修底层再修上层,才能避免用一张混乱的流量表掩盖真正的问题。
从一句话开始,几分钟内拿到完整网站。