For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/ai-math-after-navier-stokes-justin-solomo-6c97bef7.md.
AI 生成的数学正从基准测试题目进入专业数学家原本认为在更长时间内仍会十分困难的领域。
OpenAI 表示,其内部前沿模型已解决数学领域 100 多个长期未解问题。10 月 6 日,该公司发布了一个公开仓库,其中包含按 372 个相关结果族组织的 722 篇手稿,以及证明工件和大量 Lean 形式化内容。
最受关注的结果更早出现:一项由 AI 生成的针对纳维–斯托克斯存在性与光滑性问题的解答——这是七个千禧年大奖难题之一。
数学界仍在审查这一结果。克雷数学研究所表示,该问题似乎已经被解决,但正式评估和贡献归属流程将谨慎推进。与此同时,OpenAI 表示其无意申领 100 万美元的千禧年大奖。
但更令人不安的问题并不在这里:
当一份证明可以被形式化检验,而即使受过高度训练的数学家也发现证明本身极难理解时,会发生什么?
这个问题是 Bloomberg 的 Odd Lots 近期一期节目的核心。MIT 工程教育副院长 Justin Solomon 在节目中讨论了 AI 如何改变数学研究、验证、教育和学术激励机制。
Bloomberg 的 Odd Lots 与 MIT 的 Justin Solomon 讨论了 AI 如何改变数学研究。
这一议题也直接关联到 Terence Tao 于 2026 年 10 月在 Caltech 进行的 Math 2.0 演讲。
Tao 的观点并不是数学正在终结,而是该领域正从一个证明稀缺的时代走向一个证明充裕的时代:形式上正确的结果或许会变得更容易产生,但理解这一结果为何重要,可能依然困难。
纳维–斯托克斯方程描述流体运动。
它们出现在以下模型中:
难点在于:光滑的三维解是否必须始终保持光滑,还是会在有限时间内发展出奇点。
OpenAI 的 9 月结果支持第二种可能性。
该公司称,其内部系统生成了一份证明,表明纳维–斯托克斯动力学能够发展出有限时间奇点。
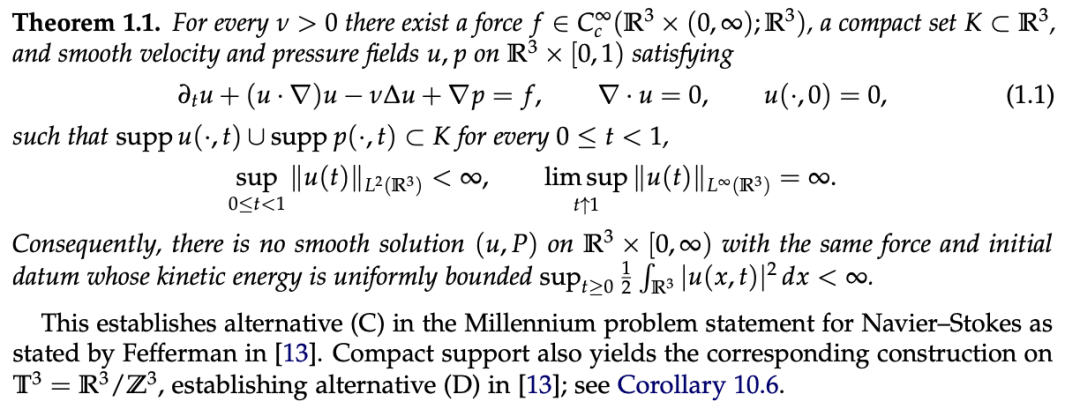
已发布的定理确立了 OpenAI 纳维–斯托克斯结果中所用的有限时间爆破解构。
OpenAI 还发布了该证明的 Lean 形式化版本。
这很重要,因为证明助手能够检验:一条形式化陈述链是否可由已编码的假设推导出来。
但形式正确性与人类可读性是不同的属性。
在 Odd Lots 节目中,Solomon 表示,即便以其数学背景,这篇论文也极难阅读。他说自己只读了前几页,就因技术细节的密度而不堪重负。
他的判断大致是:
播客自身的描述比网络上的传播版本更谨慎:即使对专业数学家而言,这份证明也很难解析。
这比说“没有人类能够理解它”更准确。
关键转变在于,形式化验证如今可能比广泛的人类理解推进得更快。
源文章将 AI 描述为完成了一项几乎完全由人类数学家构建的工作中的最后 1%。
这捕捉到了既有的人类工作很重要这一大意,但其历史比简单的 99%/1% 切分更复杂。
OpenAI 的技术说明称,其智能体探索了多种路径,并在不同团队间传递了有价值的中间思路。
该公司还讨论了数学家 Levent Alpöge 和 Tristan Buckmaster 针对相关欧拉方程结果所开展的同期工作。
OpenAI 表示,这些证明在包括外力处理在内的方面存在显著差异;同时,其还调查了近期用户输入是否可能影响自身结果。
该公司得出结论称,Buckmaster 在此前两个月中与 Codex 相关的提示词,不可能影响用于纳维–斯托克斯结果的内部模型。
因此,更稳妥的表述是:
这一结果出现在一个人类数学家已发展出重要周边思路的领域中;OpenAI 的内部系统则生成了一份新证明,而该公司称其在技术上不同于同期的人类工作。
这一区分很重要,因为贡献归属正成为 AI 辅助科学中最棘手的问题之一。
这份证明不是通过一次聊天回复生成的。
OpenAI 描述了一个大规模多智能体研究过程。
该公司称:
据 OpenAI 称,用于发现该证明的内部模型比 GPT-6 Astra 强大得多。
因此,这一工作流更像一个计算型研究项目,而非聊天机器人:
数千个智能体实例
        ↓
大量并行路径
        ↓
中间结果在团队间共享
        ↓
有希望的论证被整合
        ↓
在 Lean 中形式化
        ↓
人类与社区审查
在数学史的大部分时期,一份证明同时承担两种角色。
它确立某个定理为真。
它也以数学家能够研究、简化、复用和教授的形式解释为何为真。
AI 生成的形式化数学可能将这两种角色分离开来。
机器可以生成一套可被机械检验的论证,但对人类而言仍然极其难读。
这形成了三个不同层次:
| 层次 | 核心问题 |
|---|---|
| 形式有效性 | 证明能否在形式系统中通过检验? |
| 人类验证 | 专家能否有把握地审阅该数学论证? |
| 人类理解 | 人们能否从中提取概念、机制与可复用洞见? |
Lean 证书是形式正确性的有力证据。
但它不会自动生成概念层面的解释。
Solomon 担忧的是,数学可能会越来越快地产生答案,快到人类无法及时将答案转化为理解。
这一构造依赖精细安排的流体行为:不同项变得非常大,同时仍以所需的方式保持平衡。
OpenAI 将局部运动可视化为向内螺旋与轴向拉伸的组合。
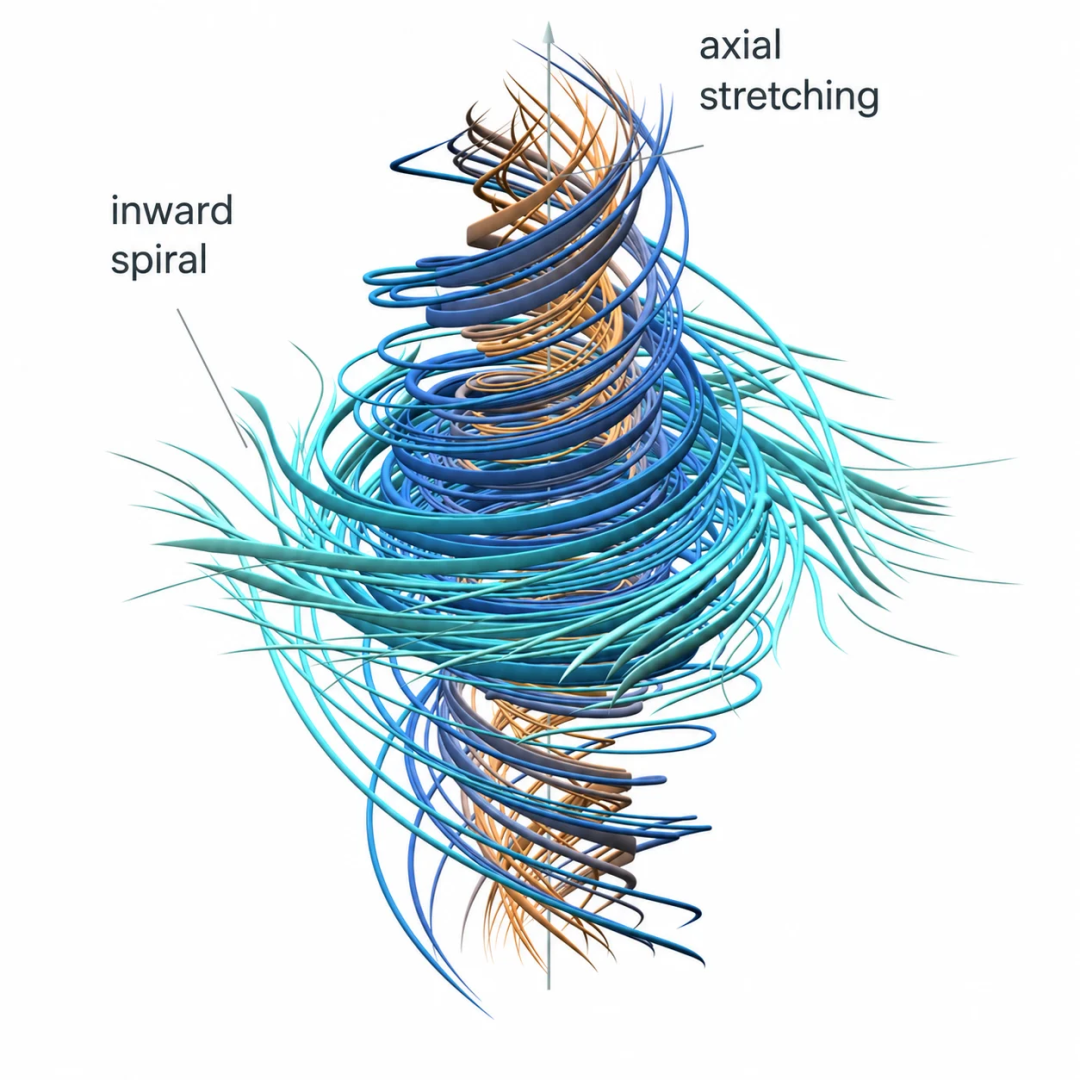
OpenAI 的可视化展示了局部不可压缩流构造中的向内螺旋和轴向拉伸。
这有助于解释,为何一份证明可以有效,却仍然难以吸收。
该论证要求对尺度、估计、交互项、渐近行为和精心选择的界进行大量控制。
这与大众印象中“一行洞见突然让整个问题豁然开朗”截然不同。
Odd Lots 节目还讨论了 Uber 联合创始人 Travis Kalanick,以及他公开谈论使用 AI 进行“vibe physics”的观点。
其含义是,用户无需接受该领域传统训练,也可以通过对话方式探索高阶科学问题。
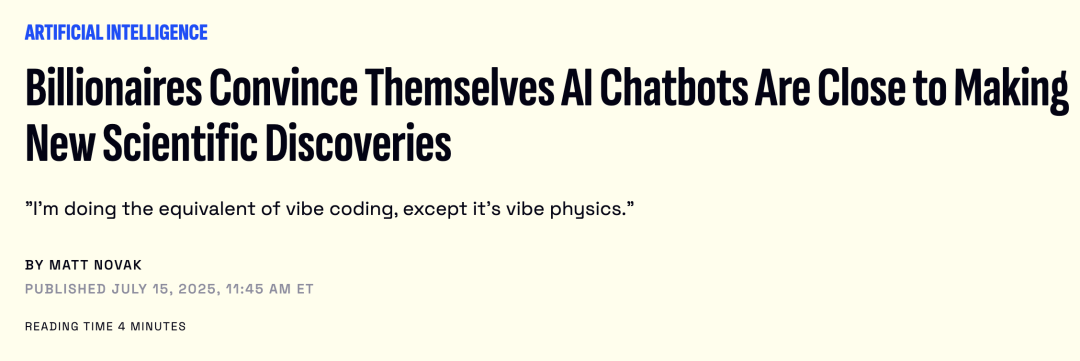
“vibe physics”之争提出了一个问题:对话式 AI 能将非专业人士带入高阶科学研究多远。
这凸显了与难以阅读的形式化证明相反的另一种失效模式。
一方面,AI 生成的数学可能正确,但技术难度高到大多数人无法理解。
另一方面,AI 让复杂科学看上去足够容易,以至于非专业人士可能对尚未经严格验证的想法过度自信。
共同的瓶颈是验证。
AI 可以让好想法和坏想法都显得很精致。
因此,呈现质量正成为科学质量的更弱信号。
Terence Tao 在其 2026 年 10 月于 Caltech 进行的 Math 2.0 演讲中,更尖锐地阐释了同一问题。
他让听众想象,向一个先进 AI 发出以下指令:
找到一种能够通过 3 期临床试验的癌症疗法。
不要犯任何错误。
AI 消耗海量算力,然后返回一种由此前未知化学物质组成的组合疗法。
没有人完全理解它是如何找到这种治疗方案的。
然而,AI 不知何故为其预测提供了 Lean 证书,且该疗法通过了 III 期临床试验。
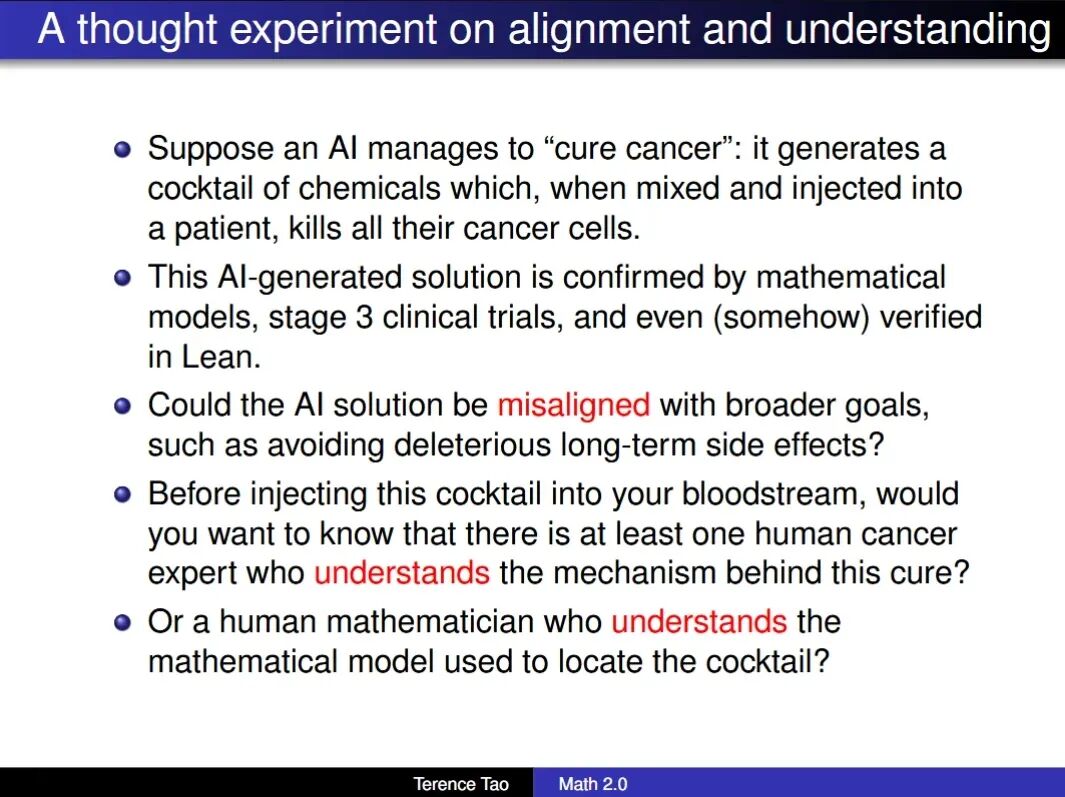
Tao 提问:如果没有任何人类理解其机制,一种经数学验证且临床成功的疗法是否依然令人安心。
问题不仅是这种药物在既定测试中是否有效。
问题还在于,系统是否可能针对以下环节的弱点进行了优化:
随后,Tao 提出了更个人化的问题。
如果你患有癌症,这种疗法已经通过形式化和临床检查,你是否会因至少有一位人类癌症专家理解部分作用机制而感到更安心?
或者,至少有一位人类数学家理解用于发现它的模型?
这一思维实验揭示了一个核心对齐问题:
强大的优化能力加上薄弱的人类理解,即使测量目标看似已经满足,也可能带来风险。
Tao 更广泛的观点是,传统数学是在证明稀缺这一假设下发展的。
为一个开放问题找到正确证明既困难又缓慢,十分罕见,并依赖专家知识。
AI 改变了其中的经济学。
借助足够的算力和前沿模型访问能力,一些开放问题现在可以被更快地攻克。
Tao 将这种新兴状态称为证明充裕。
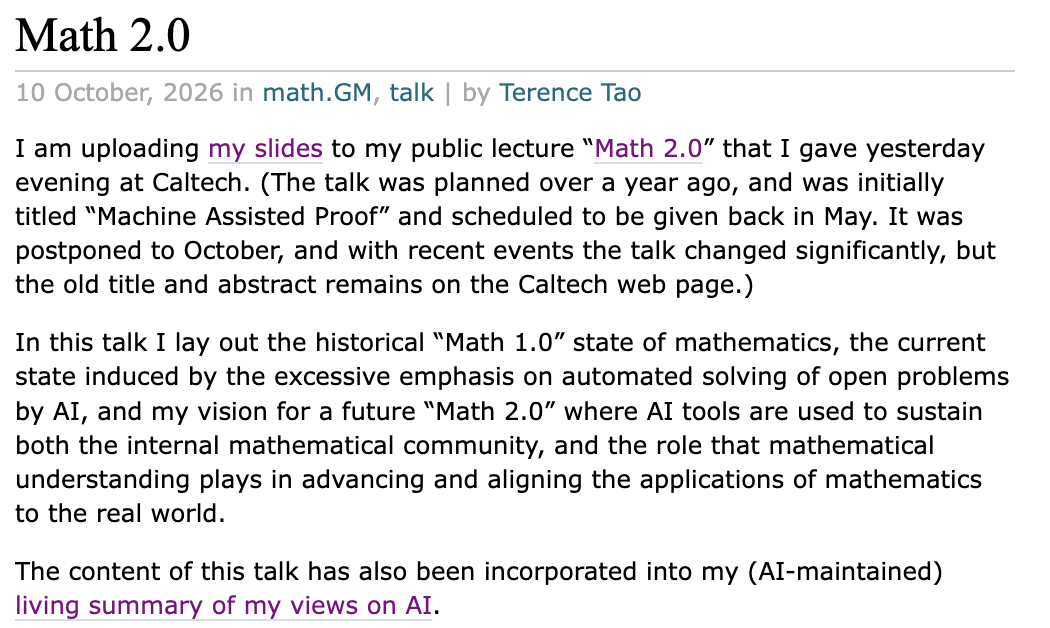
Tao 的 Math 2.0 演讲认为,数学正从证明稀缺走向证明充裕。
但 Tao 明确否定了数学即将完成的说法。
他的幻灯片指出,即使拥有大量算力,大多数当前前沿问题仍未解决,而数学问题空间实际上是无界的。
他担忧的是激励机制。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
如果研究者将“解决著名开放问题”作为唯一目标,AI 可能会抵达终点,却绕过历史上产生以下成果的人类探索过程:
Tao 将开放问题比作灯塔。
价值不只在于触及灯塔。通往灯塔的路径可以揭示周围的景观。
源文章接着从证明谈到学术出版。
Solomon 认为,研究生态系统已经在经历同类问题的一种版本。
AI 降低了以下内容的生产成本:
但合格的人类审稿人的供给,并不会以同样的速度自动扩张。
这就造成了一种不对称:
生成研究的成本
        ↓↓↓

审阅研究的成本
        仍然很高
即使是一篇强论文,在周边内容量激增时也可能更难被注意到。
源文章称,ICLR 的投稿量从十年前约一两千篇增长至今年的 6 万篇投稿。
Solomon 确实在播客中使用了 6 万这一数字。
但会议数据需要补充说明。
对于 ICLR 2026,该会议的官方回顾报告称:
2026 年末流传的约 6 万这一数字,与 ICLR 2027 注册量 / OpenReview 投稿 ID 有关,而非有效论文的最终数量。
独立分析发现,最高 OpenReview ID 超过 62,000,同时明确指出这只是上限,不是最终论文数。
更大的趋势是真实的——投稿压力正快速上升——但“ICLR 收到了 6 万篇完成论文”目前并不是准确的官方统计。
经过修正后,更深层的观点依然成立。
研究者可以借助 AI 更快地起草工作,但人类专家无法以同等速度负责任地审阅它。
Solomon 描述称,他会收到一些人的邮件:他们相信 AI 已发现一个新定理,并希望专家验证。
历史上,产出润色完善的数学工作本身的难度,就是一种部分过滤机制。
这种过滤正在减弱。
如今,一个薄弱论证可以附带:
严肃性的外观正在变得廉价。
专家注意力并非如此。
源文章进一步提出:如果前沿数学越来越依赖巨大的推理预算,研究能力可能会集中在掌控最佳模型和最多算力的组织手中。
Solomon 提出了相关担忧。
大学研究者可能使用商业 AI 系统来推动某个问题。
但服务提供方可能拥有:
这种不对称可能重塑大学、独立研究者与大型科技公司之间的竞争。
这里还存在数据归属问题。
如果研究人员通过商业 AI 系统讨论想法,这些交互如何被存储或使用,有什么保障?
OpenAI 表示,其纳维–斯托克斯系统并未受到 Buckmaster 在此前两个月中相关 Codex 提示词的影响。
但更广泛的归属问题仍然存在。
纳维–斯托克斯结果让贡献归属问题变得具体。
潜在贡献者可能包括:
传统作者署名惯例并非为这种结构而设计。
克雷数学研究所承认,纳维–斯托克斯问题似乎已经解决,但表示其奖项流程需要时间,其中包括对已完成工作的评估与贡献归属。
OpenAI 另行表示,其无意申领千禧年大奖。
这消除了眼前的一项奖金争议,但并未解决普遍的作者身份问题。
Solomon 论述的最后部分更加乐观。
他表示,目前许多 AI 数学工作似乎仍处在数学家所谓的既有知识凸包之内。
模型在以下方面可以极其强大:
更不确定的是,它们能否可靠地产生真正全新的数学世界观。
AI 能否发明下一个重大理论,而非仅解决人类已经设定的问题?
它能否识别下一个值得投入数十年关注的问题?
Solomon 表示,这一点仍远不明确。
Tao 的 Math 2.0 幻灯片指出,解决开放问题只是数学中一个可见的部分。
其他有价值的工作包括:
因此,人类数学的未来可能不再主要取决于谁是最快抵达证明的实体,而更多取决于人类决定应当围绕该证明创造何种知识。
在播客接近尾声时,主持人向 Solomon 提出了许多家长和学生正在问的实际问题:
如果 AI 可以解决更多数学问题,孩子还应该学习数学吗?
他的回答是肯定的。
原因并不是学生需要在符号操作上击败前沿模型。
数学教育还训练人们:
当润色完善的答案变得充裕时,这些能力可能更有价值。
如果答案廉价,判断就会昂贵。
源文章最有力的观点,也是最经得起严谨事实核查的观点是:
AI 可以降低生成候选答案的成本。
它可以降低生成候选证明的成本。
它甚至可能降低形式化验证的成本。
但它不会自动降低人类理解的成本。
这形成了新的稀缺资源层级:
候选答案 → 更便宜
形式化证明 → 更便宜
润色后的论文 → 更便宜

专家审阅 → 仍然昂贵
解释 → 仍然昂贵
科学判断 → 仍然昂贵
人类理解 → 仍然昂贵
危险不只是 AI 变得更擅长数学。
危险是,社会可能将经过机械验证的输出误认为得到充分理解的知识。
机遇则在于,人类可以将精力重新投入科学中最难自动化的部分:选择目标、构建解释、设计更好的问题、诠释结果,并将形式真理与现实世界连接起来。
OpenAI 于 2026 年 9 月发布了一项 AI 生成的解答,展示有限时间奇点形成,并公开了 Lean 形式化版本。克雷数学研究所表示该问题似乎已经解决,但其正式评估和贡献归属流程仍在谨慎推进。
没有。OpenAI 明确表示无意申领奖项。克雷数学研究所尚未完成其正式认定流程。
OpenAI 的公开数学仓库包含按 372 个相关结果族组织的 722 篇手稿。该公司称,此次发布来自涉及约 4,000 个问题的更广泛评估,因此“722 篇手稿”不应被理解为 722 项完全无关的突破。
在 Bloomberg 的 Odd Lots 节目中,Solomon 表示这篇论文极难阅读,自己读不过前几页。他将证明描述为技术性极强且可能正确,但不特别优雅。
Math 2.0 是 Tao 提出的一个框架,用于理解 AI 驱动的证明充裕时代中的数学。他认为,该领域应更强调人类理解、解释、实验、形式化库和对 AI 的建设性使用,而不应盲目地只针对著名开放问题进行优化。
不是。Lean 可以检验形式证明在其形式系统内是否有效,但这不会自动提供人类友好的解释、确立科学重要性,也不会证明这些思想能够安全地迁移到现实应用中。
没有。ICLR 的 2026 年官方回顾报告显示,有效投稿为 19,525 篇。2026 年末流传的约 6 万数字来自 ICLR 2027 的 OpenReview 注册或投稿 ID 估计,不应被视为最终有效论文数。
因为数学教授的不只是产出答案。问题构建、模型理解、逻辑判断、验证能力和提出好问题的能力,即使在 AI 能快速生成证明时仍然至关重要。
OpenAI 的纳维–斯托克斯结果展示了 AI 辅助数学正在以多快的速度变化。该证明拥有 Lean 形式化版本,并得到克雷数学研究所的谨慎欢迎;但其技术密度也说明了一个新问题:数学正确性可能比广泛的人类理解更快到来。
Justin Solomon 的担忧并非 AI 已让数学变得无用,而是为证明稀缺和论文稀缺而构建的研究系统,在机器可以大规模生成两者时可能难以应对。Terence Tao 将同一转变描述为从证明稀缺迈向证明充裕。
因此,最重要的瓶颈可能从产出答案转向评估、解释、关联和理解答案。
当证明变得充裕时,人类理解——而非证明生成——可能成为数学中最稀缺的资源。
从一句话开始,几分钟内拿到完整网站。



