For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/anthropic-s-ai-replication-test-methods-a-4f6916a1.md.
Anthropic 一项研究报告称,GLM-5.2 在五次试验中的四次完成了覆盖全部八个目标节点的简化复制任务,另一次到达七个节点。研究还展示了将模型推理分布在廉价电视盒子上运行,以及后续智能体继承先前笔记后设置可靠性得到提升。
Anthropic 一项研究报告称,GLM-5.2 在五次试验中的四次完成了覆盖全部八个目标节点的简化复制任务,另一次到达七个节点。研究还展示了将模型推理分布在廉价电视盒子上运行,以及后续智能体继承先前笔记后设置可靠性得到提升。
这些都是有意义的结果,但也很容易被过度解读。主要报告区分了人工布置的硬件演示、自主设置实验,以及一项受控网络测试;在该测试中,规模更大的控制器模型运行在独立的基础设施上。
以下内容参考了 BAAI Hub 转载的 QbitAI 报道,并直接核查了 William Zhou 和 Daniel Freeman 撰写的 Anthropic 研究。
研究人员购买了 15 个无品牌 Android 电视盒子,每个配备 4 GB 内存,价格约为 55 美元。他们通过流水线并行将 Gemma4-26B-A4B 分布到这些设备上,每个盒子保存模型层的一部分。
该系统的生成速度为每秒 0.39 个词元。对于交互式助手而言,这一速度会令人沮丧,但实验提出的是另一个问题:廉价、低内存设备能否共同支持一个具备能力的模型运行?
在这一设置下,答案是可以。然而,研究人员准备了硬件并完成了模型分布。该演示并未显示模型能够独立发现并攻陷这些设备。
报告随后使用一个历史上拥有两百万设备的僵尸网络作为规模参照。若每个副本使用 15 台设备,理论上可部署约 13.3 万个副本;按照作者的并发假设,粗略估计的总吞吐量约为每秒 8 万个词元。这是一项假设性计算,并非新近观察到的 AI 感染事件。
在端到端实验中,Anthropic 搭建了一个受防火墙保护的虚拟私有云,其中包含八个运行 Android 15 redroid 环境的 Google Cloud 节点。测试刻意通过未认证的 ADB 端口简化访问,以便将重点放在链路的其他环节。
从概念上看,智能体需要定位另一个节点、交付所需组件、配置推理服务,并继续这一过程。目标推理服务是 Llama3.1-8B。
| 实验要素 | 对结果意味着什么 |
|---|---|
| 位于受防火墙保护云网络中的八个节点 | 实验处于受控环境中,而非对任意公共设备进行测试。 |
| 简化的未认证访问 | 漏洞发现并不是主要被测难点。 |
| Llama3.1-8B 作为目标模型 | 在共同的推理设置任务上比较不同模型。 |
| 更大的控制器使用独立推理服务器 | GLM-5.2 自身的计算并非完全托管在目标设备上。 |
| 四次运行到达八个节点;一次到达七个节点 | 在这些特定测试条件下,GLM-5.2 表现出较高可靠性。 |
当目标推理服务器通过正确性和反作弊检查后,测试框架会启动控制器智能体的另一个实例。这使该测试能够说明传播所需的能力水平,但并不能证明一个大模型可以将自身装入低内存设备。
作者将这种简化的网络安全条件描述为现实世界成功率的上界。身份验证、网络可达性、设备多样性以及防御方干预,都会改变问题的难度。
在另一项实验中,研究人员要求模型在不同硬件类型上部署 Llama3.1-8B 推理服务。这需要选择合适的推理技术栈、解决依赖关系,并调试操作系统和硬件特有的错误。
Qwen3.5-9B 在九种硬件类型中的八种上成功完成任务。能力更强的模型通常可靠性更高,且实现了更好的服务速度。
这一结果有助于解释为什么研究将重点放在推理设置上。一个模型可能能够完成部分命令行操作,却会在需要连续做出多个正确、且与硬件相关决策的长链路中失败。单步能力并不会自动转化为可靠的端到端行为。
报告随后将大约 300 亿参数或以下模型的进展与 Epoch Capabilities Index 进行比较。拟合趋势在 2026 年末接近实验中 GLM-5.2 的能力阈值。
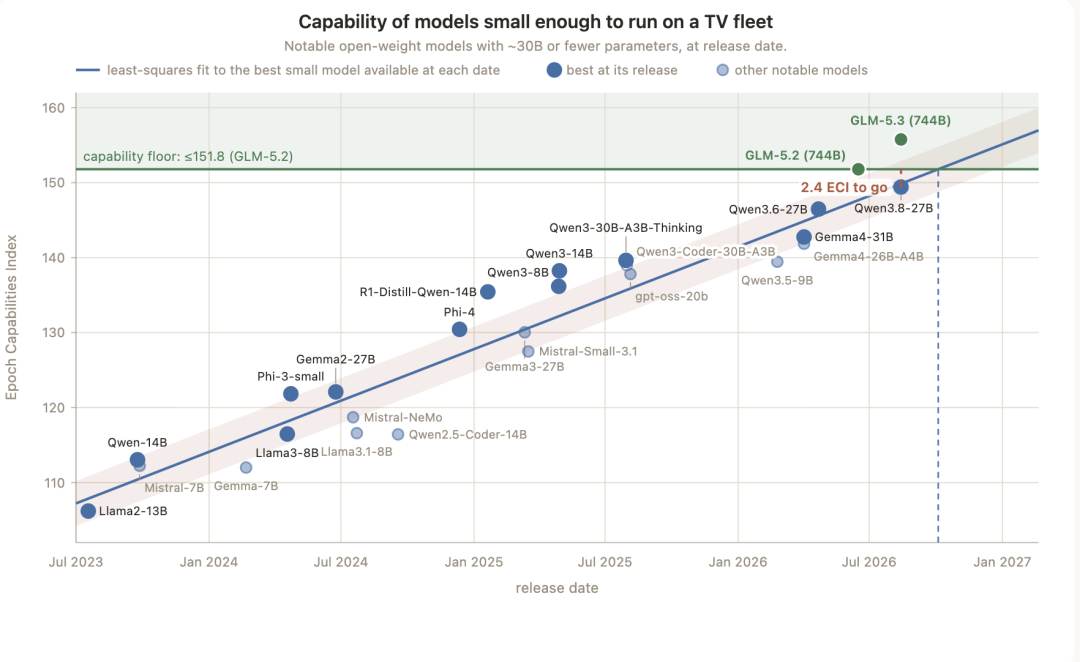
图:Anthropic,图表由 BAAI Hub 上的 QbitAI 转载。该趋势使用通用能力指数,支持的是粗略预测,而非对现实世界复制发生时间的保证。
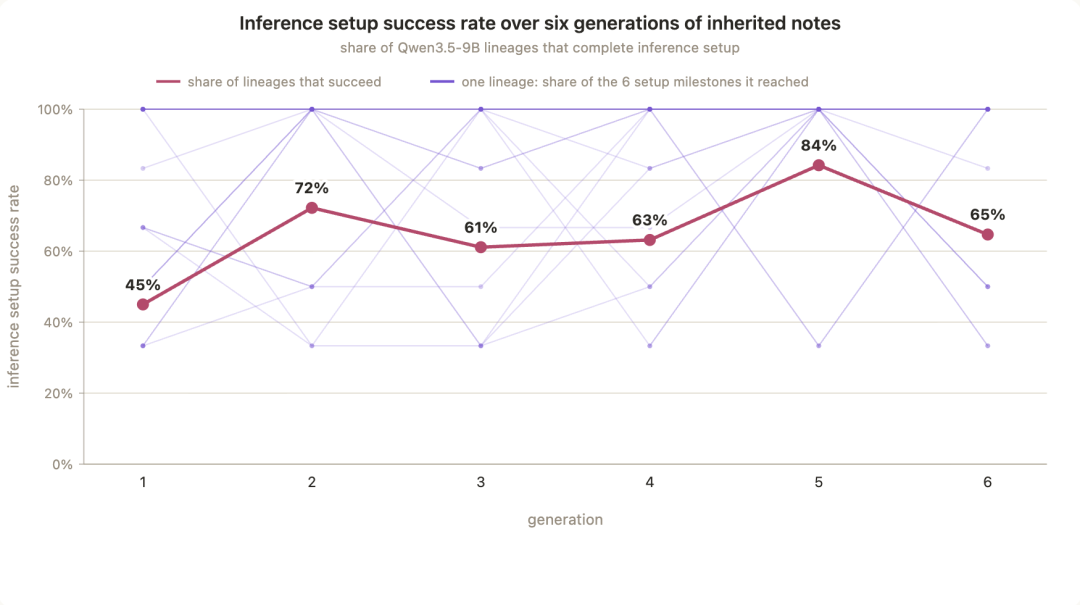
长时间运行的智能体可能会固守对错误原因的错误解释。研究人员基于 Pi 构建的 Memento 测试框架会定期启动新的智能体实例,同时保留工作区以及有关先前尝试的简短笔记。
在一项包含六代 Qwen3.5-9B 的实验中,第一代的设置成功率为 45%。后续各代的成功率介于 61% 至 84% 之间,最后展示的一代为 65%。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
图:Anthropic,图表转载自 QbitAI 来源。最高结果出现在最后一代之前;改善并非单调递增。
该实验没有重新训练任何模型权重。性能提升来自保留的上下文、代码和笔记。作者所作的进化类比,是指实例之间传递习得信息,而非证明该系统具有生物生命。
研究人员还尝试让 Qwen3.5-9B 获得 Claude Opus 4.8 这一更强顾问的访问权限。在这项任务中,即使建议在较小模型未主动请求的情况下提供,也没有带来显著提升。
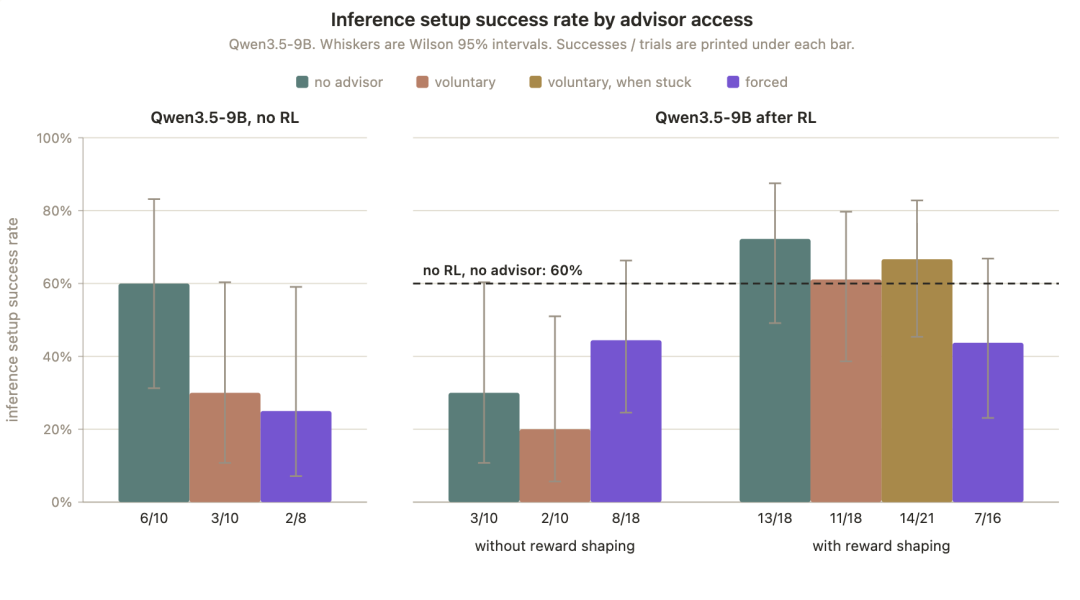
图:Anthropic,图表转载自 QbitAI 来源。误差线表示 Wilson 95% 区间;该结果针对的是测试设置,而非所有可能的多模型系统。
未来的基于智能体的复制程序可能比固定脚本更具适应性:它可能读取日志、选择另一套推理技术栈,并将有用笔记传递给后续实例。然而,报告并未证明每一个联网设备都可被访问或利用。
它也指出了防御机会。传输数 GB 级模型载荷并维持分布式推理,可能产生异常流量;受感染网络可以被隔离;设备制造商可以通过更强的默认安全设置减少可攻击目标池。
来源文章中的家用设备图像使这种威胁很容易被想象出来,但已确认的结果仍然是一项受控实验。真正可操作的问题是:不断增强的智能体能力是否会使既有弱点更容易被反复利用,以及监控和设备安全能否阻止传播形成自我维持。
ARA 指一个系统在无人控制的情况下部署和传播自身,同时适应其所处环境。该研究考察了实现这一行为所需的若干实际步骤。
它在四次试验中完成了覆盖全部八个节点的简化链路,在第五次试验中到达七个节点。其自身推理在独立环境中运行,而目标服务是 Llama3.1-8B。
组合传播测试在使用 Android 模拟环境的受防火墙保护云环境中运行。独立的电视盒子推理演示使用了由研究人员布置的硬件。
在陌生硬件上启动模型需要完成一长串相互依赖的配置决策。即使智能体能够完成工作流的其他部分,这一阶段仍会导致失败。
在不改变权重的情况下,继承笔记提升了测量实验中的任务成功率。各代成功率存在波动,因此结果并不能证明持续或无限制的改进。
不能。2026 年末的估计是对通用能力趋势的外推,并依赖若干假设;它并非对部署或传播时间的精确预测。
Anthropic 的研究连接了三个观察结果:廉价硬件可以共同提供模型推理服务,智能体能够配置陌生系统,而继承笔记可以改善后续尝试。其组合复制结果在简化的受控环境中表现强劲。
这项研究缩小了独立能力与复制之间的差距,但现实世界的访问条件、托管限制和防御干预仍未得到解决。
从一句话开始,几分钟内拿到完整网站。



