据报道,字节跳动正在讨论训练一个超过 5 万亿参数的基础模型,后续报道甚至指向最高 10 万亿,但项目仍处于早期阶段,能否落地尚无定论。本文梳理相关消息来源,比较 Qwen3.8-Max、Kimi K3 等模型规模,并分析超大模型竞赛的技术与资源挑战。
中国前沿模型竞赛正深入万亿参数时代。
阿里巴巴的Qwen3.8-Max已达到2.4万亿参数,而月之暗面的Kimi K3已将公开披露的规模推至2.8万亿参数。
字节跳动可能正准备下一次跃升。
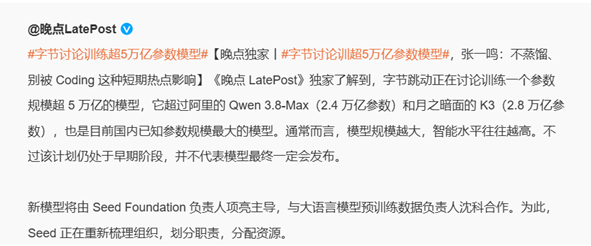
AIBase援引晚点LatePost的报道称,字节跳动于2026年8月7日正在讨论训练一个超过5万亿参数的基础模型。据该报道称,该项目仍处于早期阶段,尚无法保证最终模型会发布。
仅从规模来看,该项目将成为中国公开报道中最大规模的AI模型项目之一。
然而,当天还有一项重要更新。
8月7日晚些时候,路透社援引英国《金融时报》及知情人士的消息报道称,字节跳动正在训练一个多达10万亿参数的模型,且该模型已进入预训练阶段。字节跳动当时尚未对此报道做出公开回应。
这两份报道并非必然矛盾。一个最初讨论为"超5万亿"的项目,最终可能会瞄准更大的配置。但由于字节跳动尚未正式披露模型架构或参数数量,本文中所有数字均应视为报道中的计划,而非已确认的模型规格。
晚点LatePost的原始报道称,字节跳动正在讨论一个超过5万亿参数的模型。
这将使其远超目前多家中国前沿模型已披露的规模。
| 模型 | 公开报道的总参数 | 状态 |
|---|---|---|
| Qwen3.8-Max | 2.4万亿 | 阿里巴巴已发布 |
| Kimi K3 | 2.8万亿 | 月之暗面已发布 |
| 报道中的字节跳动模型 | 超过5万亿 | 报道中的计划 |
| 后续FT/路透社数据 | 最高10万亿 | 据报道,未经官方确认 |
月之暗面官方将Kimi K3描述为2.8万亿参数的混合专家模型,每个token激活1040亿参数。
路透社8月3日报道称,阿里巴巴的Qwen3.8-Max包含2.4万亿总参数。
如果字节跳动最终训练并部署一个5万亿至10万亿参数的模型,这将代表模型总规模的显著提升。
但这并不自动意味着该模型的能力会是原来的两到三倍。
AIBase的消息来源将5万亿参数模型描述为与美国领先前沿系统(如GPT-5.6或Anthropic最新高端模型)处于同一量级类别。
这种比较需要加一个重要的限定条件。
OpenAI 和 Anthropic 并未公开披露 GPT-5.6、Claude Fable 5 或 Claude Mythos 5 的确切参数量。
路透社在其8月7日的报道中也提出了同样的观点:与美国领先系统的直接规模比较很困难,因为这些实验室不公布其模型的参数量。
参数量只是衡量模型能力的一个维度。
性能还取决于:
这一点对于混合专家模型尤为重要。
一个稀疏 MoE 模型可能包含数万亿的总参数,但每个 token 只激活其中很小的一个子集。
Kimi K3 就是一个很好的例子。
其官方规格说明列出:
因此,权重的总数与每次推理步骤所使用的计算量并不是一回事。
字节跳动尚未公开披露所报告的模型是否使用类似的稀疏架构,也没有披露每个 token 会激活多少参数。
原始报道以 NVIDIA H100 GPU 为例说明了其规模。
其估算表明,训练一个5万亿参数的模型大约需要:
这两种场景的总加速器时间大致处于同一数量级:
| 场景 | GPU数量 | 时长 | 约计 GPU 天数 |
|---|---|---|---|
| 长期集群 | 100,000 | 347天 | 3,470万 |
| 大规模短期集群 | 1,000,000 | 35天 | 3,500万 |
这些数字应被理解为来自消息源的粗略场景估算,而非通用的工程公式。
实际训练需求在很大程度上取决于:
NVIDIA 官方 H100 规格说明显示,SXM 版本的 TDP 最高可达 700W,并通过 Hopper 的 Transformer Engine 和 NVLink 基础设施支持大规模 transformer 训练。
在数十万个加速器的规模下,仅 GPU 集群就达到了电力、网络、冷却和数据中心容量成为首要约束条件的体量。
AIBase 的消息源正确地指出,同时运行100万块 H100 级加速器将是一种极端的基础设施配置。
更现实的项目可能会将训练分散到一个更小但仍然巨大的集群上。
消息源建议更接近的方案是:
这仍将是最大规模的训练集群之一。
人类有史以来最具雄心的模型训练工程之一。
而预训练仅仅只是一个阶段。
一个前沿模型还需要时间和算力来完成以下步骤:
因此,AIBase 的原始文章估计,整个流程至少需要半年时间,而在成熟模型问世之前,总耗时可能接近一年。
后来英国《金融时报》的报道(路透社摘要)称,该模型已进入预训练阶段,并指出这一阶段通常需要大约三到六个月,之后才会进入微调和发布阶段。
两种描述都指向同一个实际结论:如此规模的项目是一项长期的基础设施工程,而不是第一个训练集群上线后就能立刻出现的模型。
如此规模的训练不仅仅是一个研究问题。
它更是一个基础设施和资本问题。
字节跳动是为数不多的几家中国科技公司之一,拥有足够的财力、消费者分发渠道、云基础设施、数据中心容量以及AI工程团队,能够认真尝试如此规模的项目。
该公司官方的 Seed 组织已覆盖以下领域:
字节跳动的基础设施团队明确将其工作描述为涵盖分布式训练、强化学习系统、高性能推理以及面向基础模型的编译器技术。
其招聘材料中也明确提到了以下工作内容:
这些正是在以万亿参数规模训练模型时变得至关重要的系统工程问题。
AIBase 还引用了第三方对几家前沿实验室可用 AI 算力规模的估算。
文章中提到的大致数量为:
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这些数字不应被视为经审计的库存数据。
OpenAI 和 Anthropic 并不会公开维护其自有设施、云合作伙伴以及预留容量中所有可用加速器的实时数量。
DeepSeek 约 6 万块加速器的数字最早来自 SemiAnalysis 的估算,此后在各种报道中被广泛引述。这些估算包含的是 A100、H100、H800 和 H20 等多种加速器的混合组合,而非单一型的机队。
比任何确切的库存数字更可靠的,是更宏观的关键点:
前沿模型的开发越来越依赖于获取超大规模的加速器算力,而当模型规模不断增大时,拥有超大规模基础设施的公司与较小实验室之间的差距可能会变得非常悬殊。
使用H100等效算力能让计算讨论更容易理解,但字节跳动未必会依赖单一类型的加速器。
大型AI公司可以组合使用:
更新的加速器可以改变完成相同训练计算量所需的物理GPU数量。
软件同样重要。
以下方面的改进:
可以显著改变模型总规模与训练成本之间的关系。
因此,“X模型恰好需要Y块GPU”应始终被视作一种场景假设,而非固定法则。
消息源主要将该计划框定为推动豆包智能水平迈向全球前沿的一次尝试。
这很可能只是动机的一部分。
更大的基础模型可能为字节跳动AI生态的多个部分提供支撑。
豆包是字节跳动在中国市场的主要消费级AI产品之一。
更强的基座模型可以提升:
超大规模模型也将为Seed团队提供新的研究平台,探索:
字节跳动还可以通过企业服务和云服务将模型能力商业化。
因此,前沿模型在消费级聊天机器人之外也具有潜在价值。
AIBase文章中最后一个问题最为关键。
一个训练成本极高的模型能否产生相应的回报?
前沿实验室不仅要为最终训练运行买单。
总支出可以包括:
随后,模型必须通过以下某种组合创造价值:
参数规模只有在以可接受的推理成本转化为有用能力时,才具有经济意义。
这就是为什么当前一代前沿模型越来越强调扩展效率,而不仅仅是总参数量。
例如,Kimi K3总参数量达2.8万亿,但每个token仅激活1040亿参数。月之暗面表示,与上一代相比,其架构在扩展效率方面有所提升。
因此,真正的竞争不是:
谁的参数最多?
而更接近:
谁能用最少的资源转化出最强的能力?

以可持续的训练和推理成本,转化为最有用的智能?
AIBase 援引《晚点 LatePost》报道称,字节跳动正在讨论一个超过 5 万亿参数的模型。当天晚些时候,路透社援引《金融时报》报道称,字节跳动已经在预训练一个可能高达 10 万亿参数的模型。字节跳动尚未公开确认确切数字。
消息源预计该模型将增强字节跳动的豆包生态系统,但字节跳动尚未正式宣布该报道中的模型将如何部署。前沿模型也可能支持企业 API、智能体、研究及字节跳动的其他产品。
不一定。总参数量并不直接决定模型质量。架构、激活参数、训练数据、后训练、强化学习、推理时思考以及工具使用都可能同样重要。
月之暗面官方公布 Kimi K3 总参数量为 2.8 万亿,激活参数为 1040 亿。它采用稀疏混合专家(MoE)架构。
根据阿里巴巴和路透社的报道,阿里巴巴的 Qwen3.8-Max 总参数量为 2.4 万亿。它也基于稀疏模型设计,而非对每个 token 激活全部参数量。
消息源给出了一个粗略的场景,相当于约 3500 万 H100 GPU·天,例如 10 万块 H100 运行 347 天,或 100 万块 H100 运行约 35 天。实际需求可能因架构、精度、利用率、token 数量、硬件和训练效率而有很大差异。
OpenAI 未公开披露 GPT-5.6 的参数量。任何关于 GPT-5.6 与报道中的字节跳动模型之间的直接数值比较都只能算推测。
目前尚未公布正式发布日期。路透社基于英国《金融时报》的报道称,该模型正处于预训练阶段,这一阶段可能需要数月时间,之后才能进行微调、评估和部署。
据报道,字节跳动正在准备一个超大规模基础模型,规模将超过目前公开披露的中国模型。AIBase和晚点LatePost最初将该项目描述为超过5万亿参数,而当日稍后路透社/英国《金融时报》的报道则称该模型可能达到10万亿参数,且已处于预训练阶段。
如此规模的项目将需要巨大的计算资源。消息来源举例的H100计算量约相当于3500万GPU天,但实际训练需求取决于架构、激活参数、硬件代际、利用率和训练效率。
更大的问题不在于字节跳动能否构建最大的模型。总参数是衡量智能的不完整指标,尤其是对于稀疏混合专家系统而言。
真正的考验在于
字节跳动能够将万亿级的计算量转化为一个在性能上显著更优、效率足以支撑服务、且价值足以证明其背后基础设施合理性的模型。
从一句话开始,几分钟内拿到完整网站。



