For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/claude-code-feels-worse-model-vs.md.
即便底层模型未变,Claude Code 有时仍可能显得能力下降。本文解析模型选择与努力水平之间的区别,说明努力如何影响文件读取、测试、工具调用和任务完成,以及何时应提升努力程度或切换模型。
当 Claude Code 产出结果较弱时,许多开发者会立刻切换到更大、更昂贵的模型。
这种反应可以理解,但往往针对了错误的设置。
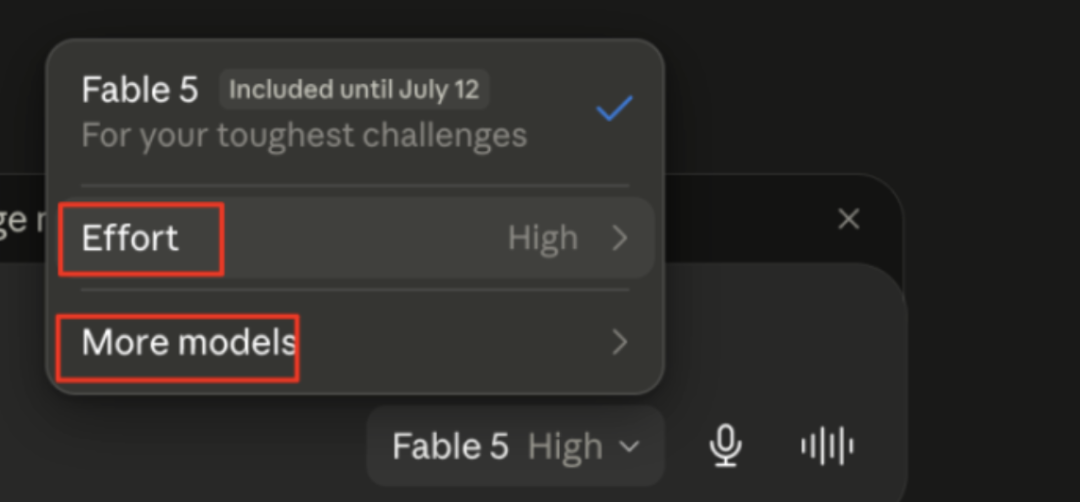
Claude Code 提供了两种可以改进输出的控制项:模型和努力水平。两者相关,但职责不同。模型选择更改的是系统底层能力,而努力水平调整的是 Claude 在当前任务中愿意投入多少工作量。
这一区别解释了为什么即使模型本身没有改变,Claude 却突然感觉不够细致。它也解释了为什么一个较小模型在高努力水平下的表现,有时可以超越一个大型模型在低努力水平下的表现。
这种混淆在开发者注意到 Claude Code 的行为发生变化时变得尤为明显。
用户报告说,Claude 跳过了它应该读取的文件,回避运行测试,在多步骤工作中途停止,或者转而向用户寻求更多信息而不是自行探索。
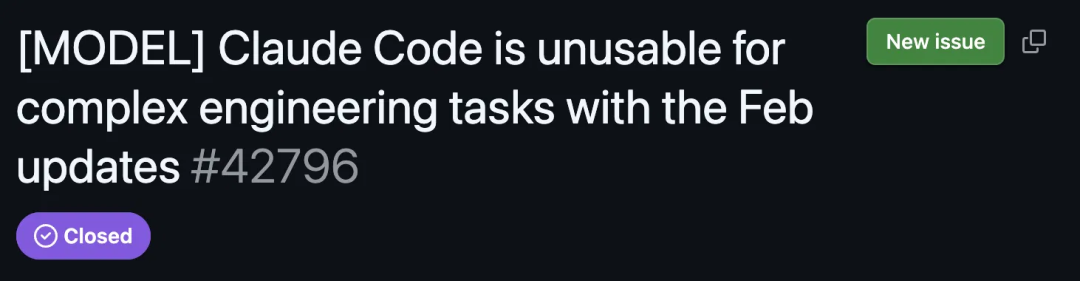
一个被广泛讨论的 GitHub issue 将 Claude Code 描述为"对于复杂工程任务不可靠"。原始文章中引用的分析审查了数千个会话,并报告了推理或执行工作量的急剧下降。
许多用户最初以为他们的提示词、仓库指令或本地配置出了问题。原始来源文章指出,更直接的原因是默认努力水平设置发生了变化。
为了降低延迟,Anthropic 暂时将部分 Claude Code 用户的默认努力水平从 high 降低到 medium。模型权重并没有变弱,但 Claude 被鼓励在每个任务上花费更少的时间、更少的 token 和更少的工具调用。
可见效果很容易被误读:
Anthropic 后来恢复了受影响用户的更高默认设置。但到那时,这一事件已经表明了一个重要观点:即使模型本身没有变化,当努力策略改变时,模型也会让人感觉"变笨"了。
Anthropic的解释可以归结为一句实用的话:
模型改变大脑。努力程度决定这个大脑在当前任务上工作的彻底程度。
一个模型由一组固定的训练权重定义。
训练完成后,这些权重决定了模型的通用知识、学习到的模式、推理能力、编程经验以及能力范围。提示词、仓库文件、CLAUDE.md 和上下文中的文档可以引导模型,但无法重写这些权重。
这意味着模型选择主要回答了这个问题:
这个模型能否解决这类问题?
如果某个库是在模型训练数据截止日期之后发布的,你可以在当前会话中提供文档让模型使用。但这并不会永久教会模型这个库。相关知识仅存在于当前上下文之内。
同样的限制也解释了为什么模型可能会自信地编造一个不存在的 API。它是在根据学到的模式生成最可能的后续内容,而不是在查询一个保证函数有效性的内部数据库。
在 Claude 处理代码或文本之前,输入会被分割成 token。
例如这样一行代码:
const x = await fetch(...)
会从模型的词表中被转换为 token ID。模型使用这些数值表示进行处理,而不是像人类那样读取字符。
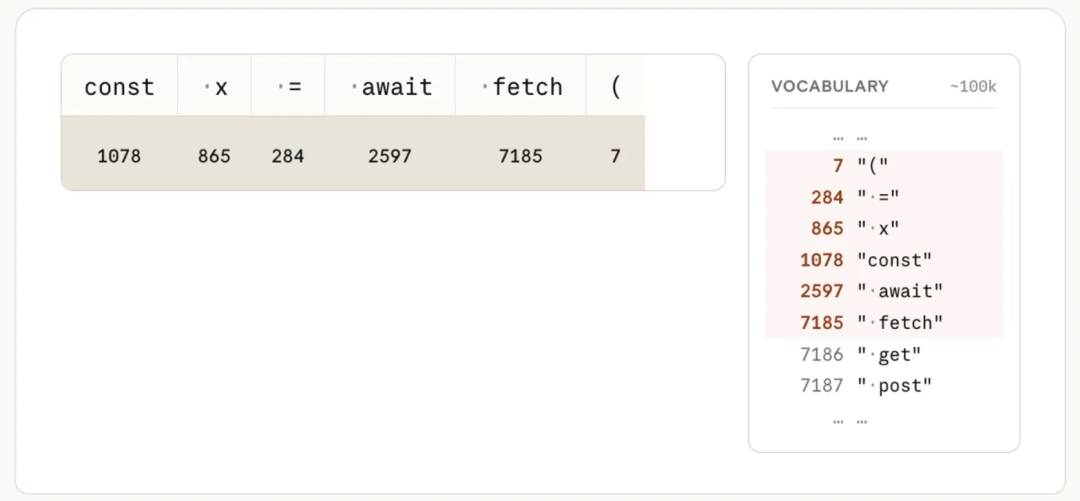
然后模型一次预测一个 token。每生成一个 token 后,序列会被重新处理以预测下一个。
这个重复生成的过程是延迟和成本的主要来源之一。能力更强的模型可以产生更好的预测,但这并不意味着模型会自动检查每个文件、运行每个测试,或者持续完成每个长任务的每个阶段。
而这类行为正是努力发挥作用的地方。
许多用户将更高的努力度理解为“让模型多思考几秒钟”。
这种理解不完整。
Anthropic 的努力参数会影响模型整体上愿意花费 token 和执行工作的意愿。它可以影响:
在低努力度下,Claude 为速度和 token 效率进行了优化。它可能只读取最明显的文件,做一个狭窄的修改,然后快速返回。
在高努力度下,Claude 更可能检查周围代码、读取配置、运行测试、验证结果,并持续到任务更完成为止。
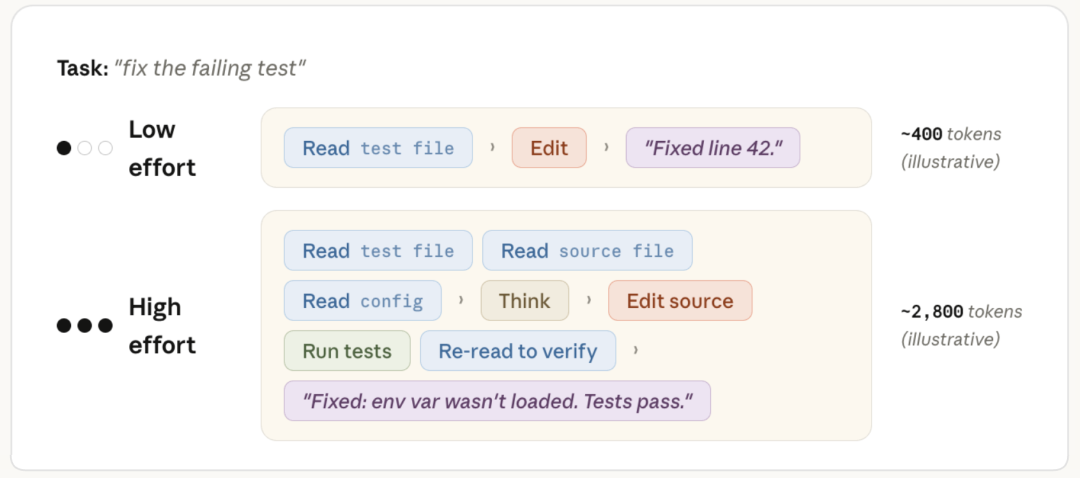
Anthropic 指南中的图表使用了一个说明性示例:
具体的倍数并非固定规则。投入是一种行为信号,而非严格的 token 预算。不同的任务可能产生不同的消耗模式。
关键在于,额外的 token 不仅用于隐藏推理。它们也可以用于读取文件、生成工具参数、运行验证步骤以及编写更完整的回复。
这得出一个乍看反直觉的结果:
一个拥有足够上下文且投入度高的小模型,其表现可以超越一个只允许浅层处理的大模型。
设想两位开发者:
专家可能有更好的直觉,但通才有更多机会收集证据。
这类似于模型能力与投入之间的差异。
大模型确立了更高的质量上限。更高的投入决定了模型在当前任务中愿意朝这个上限移动多远。
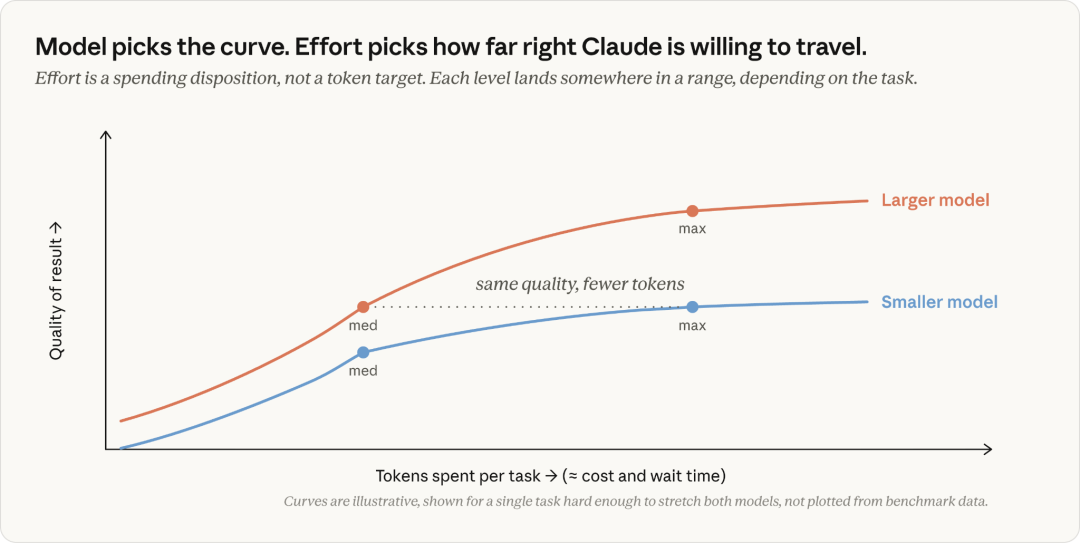
这并不意味着模型大小不重要。有些任务仍然超出了小模型的能力范围,无论投入多少。模型无法仅通过花费更多 token 来弥补缺失的能力。
这确实意味着,增大模型并不总是第一选择或最便宜的解决方案。
Anthropic 最有用的建议是一个诊断框架。
当 Claude 产生糟糕结果时,不要立即更换模型。首先确定失败类型。

在更改任何设置之前,验证任务本身。
问:
CLAUDE.md 准确吗?许多看似是模型的问题,实际上是上下文的问题。
如果模型获得了不完整的需求、过时的指令或错误的文件,那么无论是更高的投入还是更大的模型都无法可靠地解决问题。
当 Claude 出现以下情况时,问题很可能是投入不足:
在这些情况下,应提高投入水平。
模型可能已经具备足够的能力。
只需要一个更强的信号,表明任务需要更彻底地完成。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
当出现以下情况时,问题更可能出在模型本身:
在这些情况下,请切换到更强大的模型。
更高的努力为相同的权重提供了更多发挥作用的空间,但它并不会用更强的能力集来替换这些权重。
具体的模型阵容和默认设置会随时间变化,因此请始终查看 Anthropic 的当前文档。实用的选择逻辑比任何特定的模型名称都更持久。
对于以下任务,通常使用 Sonnet 等更快的模型就足够了:
如果任务涉及多个文件或需要验证,在转向更昂贵的模型之前,请先提高努力水平。
当出现以下情况时,使用 Opus 等更强的模型更为合适:
优势不仅仅在于更多的 token。更大的模型可能已经学习了更强的模式,并且拥有更高的能力上限。
来源文章将 Fable 描述为当其他模型仍然卡住时应调用的专家模型。
这类模型对以下任务最有价值:
由于最高能力的模型也具有最高的 token 成本,因此应仅在它的额外能力能改变结果时使用。
| 任务类型 | 起始模型策略 | 建议的努力水平 |
|---|---|---|
| 重命名、格式化、小型文本编辑 | 快速或均衡模型 | 低或中 |
| 带有清晰测试的狭小 bug | 均衡模型 | 中 |
| 多文件 bug 修复 | 均衡模型 | 高 |
| 需求明确的大型重构 | 均衡或更强模型 | 高或极高 |
| 不明确的架构失败 | 更强模型 | 高 |
| 长自主编码工作流 | 强模型 | 极高或最大 |
| 全面调查后仍然反复失败 | 转向更强大的模型 | 保持足够高以进行验证 |
这是一个起点,而非固定法则。
最佳设置取决于:
为每个 prompt 不断更改努力水平会使成本和延迟难以预测。
Anthropic 建议从所选模型的默认努力水平开始,然后将努力水平调整为一个更广泛的工作偏好。
例如:
为快速问题和大量子任务使用较低的努力。
为常规开发使用中等的努力。
为困难的编码和 Agent 工作流使用较高的努力。
仅在需要额外周全性时才使用 xhigh 或 max。
对于 API 用户,effort 参数适用于可见文本、工具调用、工具参数和扩展思考。它不限于单一的隐藏推理预算。
这使得 effort 成为对模型尝试投入多少工作的直接操作控制。
源文章还提到了 Claude Code 的 ultracode 模式。
一个重要的思路是,某些长任务能从多个智能体线程中受益。与其让一个 Claude 实例顺序检查大型任务的每个部分,不如让一个协调者将独立工作委托给专用智能体。
示例包括:
Anthropic 的 Managed Agents 文档描述了多智能体会话,其中智能体可以并行操作,拥有独立的对话历史。这可以在任务分解得当的情况下提高覆盖范围并减少完成时间。
多智能体执行并非自动更优。
它可能增加:
仅在任务包含独立工作流时使用,而不是仅仅因为它可用。
更广泛的启示是,AI 编码正超越模型排名。
过去,工作流程很简单:
现代的智能体编码需要更积极的调度。
一个团队可能使用:
这更接近管理一个技术团队,而不是使用搜索框。
操作该系统的人需要理解:
目标不是消耗最多的 token,而是将 token 花费在能提高结果被接受概率的地方。
当 Claude Code 产生弱结果时,按以下顺序排查:
模型选择会改变底层的训练权重,从而改变整体的能力范围。Effort 控制 Claude 在当前任务中被鼓励投入多少工作,包括推理、文件读取、工具调用、测试和验证。
在某些任务上确实可以。拥有足够上下文和高努力程度的小型模型,可能比低努力程度的大型模型研究得更深入。然而,努力无法突破真实的能力上限。
Claude 可能以较低的努力程度运行,任务范围定义不清晰,或者缺少所需的工具和上下文。请先检查提示词和仓库说明,如果 Claude 在完成可用验证前就停止,再提高努力程度。
当 Claude 拥有正确的上下文、清晰地研究任务、运行了相关检查,却依然得出错误结论时,可以切换模型。如果它只是跳过了工作,提高努力程度通常是更好的优先步骤。
不相等。Anthropic 将努力描述为一种行为信号,而非严格的 Token 限制。它会影响 Claude 在响应、工具调用、函数参数和扩展思考中投入 Token 的意愿程度。
日常任务使用默认或中等努力程度,困难编码和代理型任务使用高努力程度,长时间运行或特别高要求的工作流使用极高或最高努力程度。根据自身任务重新评估成本和延迟。
源文章将 ultracode 描述为 Claude Code 的高强度模式,它结合了非常高的努力程度,并在必要时允许协调多个代理。由于产品行为可能变化,在依赖特定实现前,请查阅当前的 Claude Code 文档。
不会。努力程度仅改变请求或会话的行为。它不会更新模型权重,也不会永久教会 Claude 新知识。
如何选择 Claude 模型与努力程度: Anthropic 关于 Claude Code 中模型选择和努力程度的官方说明。
Claude 努力程度文档: 关于努力程度、支持模型和 API 行为的官方文档。
如何选择正确的 Claude 模型: Anthropic 针对能力、成本和任务类型的模型选择指南。
Claude Code 更新日志:Claude Code 变更与默认设置的官方发布历史记录。
Claude 托管智能体多代理会话:协调多个 Claude 智能体的官方文档。
构建编排模式:Anthropic 关于将高投入与多代理编排相结合的使用指南。
Claude Code GitHub 仓库:Claude Code 的官方源代码仓库、问题追踪器和更新日志。
即使底层模型未发生变化,Claude Code 也可能让人感觉能力下降。原因可能是投入设置较低、上下文不完整、缺少工具或任务范围不明确。
模型选择决定了能力上限。投入则决定了 Claude 通过读取文件、调用工具、运行测试和验证工作来使用该能力的充分程度。
首先从修正输入入手。当 Claude 跳过可用工作时提高投入级别。当它已充分探究任务但仍无法解决时,则切换模型。
最佳的 Claude Code 配置并不总是最大的模型——而是在足够的投入、上下文、工具和任务验证下的正确模型。
从一句话开始,几分钟内拿到完整网站。



