For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/claude-code-review-ai-checks-human-approv-629ae884.md.
Anthropic 表示,Claude 编写了 Claude Code 自身约 90% 的代码。其工程团队提出了下一个问题:当智能体生成变更的速度快于人类阅读变更的速度时,团队应该如何审查这些变更?
Anthropic 表示,Claude 编写了 Claude Code 自身约 90% 的代码。其工程团队提出了下一个问题:当智能体生成变更的速度快于人类阅读变更的速度时,团队应该如何审查这些变更?
答案是一套分层流程:将常规检查提前,使用智能体调查错误,并将人工注意力保留给风险更高的决策。Anthropic 报告称,从 6 月到 9 月,已合并拉取请求的数量增长了一倍以上,而需要回滚的占比下降了超过 40%。
这些观察描述的是一个团队的流程。90% 这一数字指的是代码编写归属,而不是允许绕过人工审核的变更比例。需要人工审批时,智能体仍然不能代替人工完成这一审批。
该团队将逐行人工阅读视为发现问题的一种方式,而不是审查本身的目标。更好的问题是:一次变更会引入哪些失败模式,以及哪些检查可以发现这些问题?
这会将审查从拉取请求创建之后的单一关卡,转变为持续进行的活动。测试、构建以及在全新上下文中进行的智能体审查,可以在打断另一名工程师之前发现问题。
成本计算同时包括审查时间和修复事故所花费的时间。如果减少审批只会让故障转移到后续环节,那么这就不是一次成功的优化。因此,除了人工评论、审批和等待时间等指标外,回滚率和事故率也要作为安全护栏。
Anthropic 的独立单体仓库从 5 月每天约 2,500 个已合并变更,增长到 9 月的超过 30,000 个。Claude Code 拥有自己的代码仓库;这些单体仓库的数据不应直接归因于 Claude Code 的代码库。
所提供的报告重点介绍了七层流程中的三个阶段。官方文章给出了完整顺序:
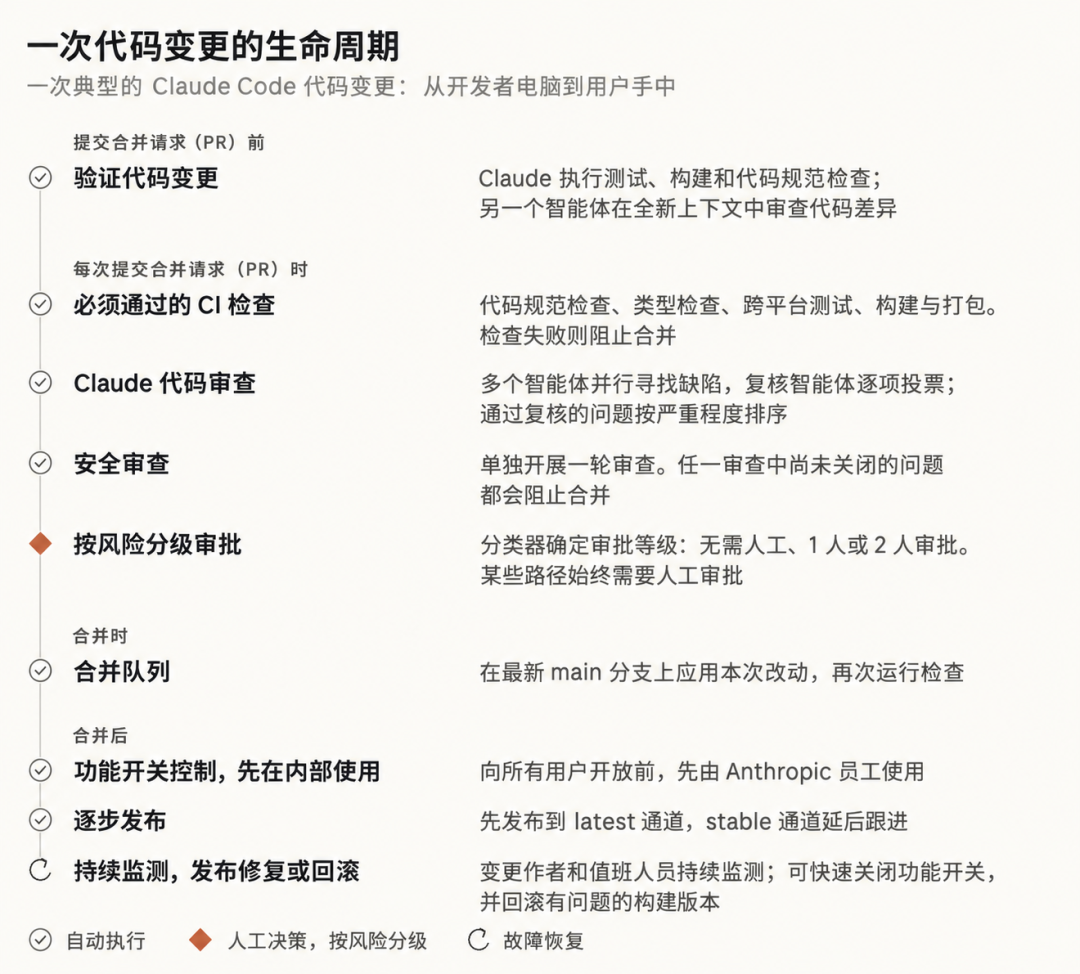
所提供报告中的翻译版工作流图;官方文章提供英文原图。
在创建 PR 之前,证据比智能体声称任务已完成更重要。测试命令及其输出,或者经过设计对照检查的截图,可以为审查者提供可检查的内容。随后,重复出现的问题可以转化为代码检查规则、技能,或写入 CLAUDE.md 和 REVIEW.md 的简明项目说明。
AI 审查者关注实质性缺陷,而不是不受限制的风格建议。Anthropic 报告称,在研究预览期间,收到实质性评论的内部 PR 占比从 16% 上升到 54%。评论也可以单独标识预先存在的问题,避免让人误以为每个发现的问题都是由新变更引入的。
| 风险等级 | 团队描述的内部审批政策 |
|---|---|
| 低 | 在适用的自动化检查通过后,无需人工审批,但仍受信任规则和路径规则约束。 |
| 中 | 需要一名人工审批者。 |
| 高 | 需要两名人工审批者。 |
敏感路径和持续集成工作流文件还需要满足额外要求。只有受信任的作者才符合较轻量流程的条件;其他贡献者需要获得另一名人员的审批。分类器会评估变更本身,而不是简单信任提交者的身份。
对于由智能体编写的工作,负责指挥智能体的人被视为负责的审查者。智能体的批准永远不能填补规定必须由人工完成的审批名额;如果后续提交改变了已审查的内容,审批也可能需要重新获得。
团队内部的零人工流程也不同于公开的审查产品。该产品会发布发现的问题,但不会独立提供仓库规则要求的人工审批。
有一个 CLI 拉取请求在一夜之间经历了 50 多轮审查与修复,最终由其负责人停止。智能体作者会修复一条细小评论,生成新的提交,并触发审查者;审查者又会发现另一个问题。
团队回顾性检查发现,反复被指出的代码中约有 59% 在首次审查时就已经存在。后续审查往往是在发现更多旧问题,而不是发现每次修复中新引入的缺陷。
修订后的流程将常规审查循环限制在三轮以内,之后要求作者重新考虑方案。该流程还会将后续审查范围收窄到新的差异,抑制重复发现,并要求作者处理一类错误,而不是一次只处理一个实例。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
| 内部指标 | 调整前 | 收敛改进后 |
|---|---|---|
| 一轮审查与修复后通过 | 65% | 78% |
| 至少需要五轮 | 8.9% | 1.5% |
| 平均通过所需审查次数 | 2.08 | 1.32 |
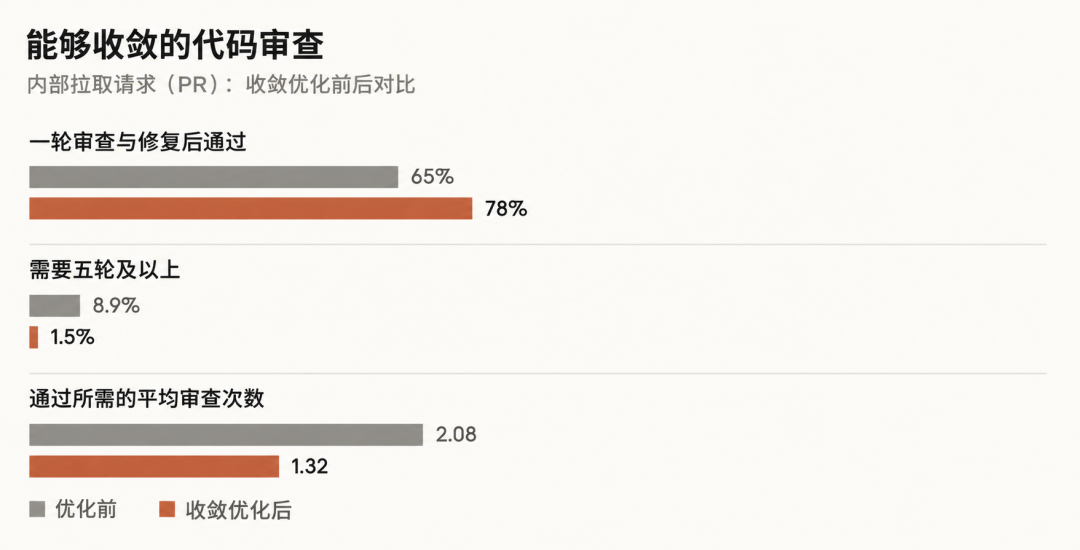
Anthropic 的内部测量结果,转载于源报告。
发现更多评论并不等同于让审查变得更好。Anthropic 使用经过专家确认的事故案例和已知无问题的变更测试审查者,同时跟踪遗漏的错误和有害的误报。
人类仍然负责决定某项功能是否应纳入产品,审查影响重大的架构,并检查计费、持续集成和更新器等高风险区域。他们还需要理解自动化检查可能遗漏什么。
作者和负责值班的工程师会在合并后关注结果。功能开关、内部使用和分阶段渠道可以让恢复更容易,但它们并不能消除事故。官方文章表示,在指标恶化时收紧审批要求的自动断路器仍然是期望实现的改进。
持续存在的责任是对已交付变更负责。更快的实现速度让团队更容易放弃不必要的 PR,但这并不会将哪些内容应该发布的决策交给未经检查的审查循环。
不是。代码编写归属和审批是两个不同的指标。内部流程会根据风险调整人工审查,同时对指定的变更和路径保留强制审批要求。
官方文章明确表示不能。自动化审查可以为符合条件的低风险工作放行,但不能占据指定由人员完成的审批名额。
不同智能体会调查不同的潜在缺陷,独立验证器则会评估它们的发现。这可以在评论到达作者之前增加一层检查,但多个智能体达成一致并不代表每个发现都一定正确。
没有上限的作者—审查者循环可能会在反复发现旧问题的同时消耗大量时间。设置上限可以促使团队重新考虑方案,而不是自动继续相同的循环。
它指的是 6 月至 9 月期间,需要回滚的已合并 Claude Code PR 占比的相对降幅。这并不是说所有软件缺陷都减少了 40%。
可以从可验证的检查、明确的风险规则和可靠的回滚机制开始。在减少必要的人工参与之前,应将审查工作量与事故和回滚情况结合起来衡量。
Claude Code 团队将提前验证、多智能体审查、安全检查、明确的审批规则和快速恢复结合起来。同时,团队也限制审查循环的次数,避免智能体在没有改善变更的情况下不断相互占用时间。
自动化改变了谁来阅读差异;但人类仍然对决策和结果负责。
从一句话开始,几分钟内拿到完整网站。