For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/claude-distillation-defenses-and-preserve-b64c5fd8.md.
Anthropic 表示,新的保护措施已将其自有平台上蒸馏者获取的 Claude 推理内容减少约 90%–99%。其 10 月 12 日更新介绍了三层防御:限制受保护推理的复用、加强提取分类器,以及通过账户控制提高重复尝试的成本。
Anthropic 表示,新的保护措施已将其自有平台上蒸馏者获取的 Claude 推理内容减少约 90%–99%。其 10 月 12 日更新介绍了三层防御:限制受保护推理的复用、加强提取分类器,以及通过账户控制提高重复尝试的成本。
这对普通开发者也有实际影响。一些集成必须改变重放对话历史的方式,而部分在 Claude 作答前被拦截的请求现在也可能计费。要理解这些成本,需要区分该公司的反滥用成果与应用程序在 API 中实际会遇到的规则。
蒸馏是指使用一个模型的输出训练另一个模型。它也是一项合法技术:开发者可以蒸馏自己的模型,或使用其获得使用许可的数据。Anthropic 的报告聚焦于未经授权的提取活动,通常涉及欺诈账户,而非将所有蒸馏行为都视为滥用。
在这一场景中,最终答案是有价值的训练数据,但详细推理可能更具价值。推理记录揭示了中间决策、尝试过的方法和修正过程,而学生模型原本需要自行推断这些信息。
Anthropic 通过一项实验说明了其中差异:研究人员使用 Claude Opus 4.8 的记录来训练一个预训练 Claude 模型。得到的 SWE-bench Verified 分数如下:
| 训练材料 | 报告的 SWE-bench Verified 分数 |
|---|---|
| 包含完整推理的记录 | 80.4% |
| 包含摘要推理的记录 | 71.8% |
在该实验中,两者相差 8.6 个百分点。这支持推理记录对于该训练设置的价值;但并不能证明在所有模型或任务中都会存在同等规模的普遍优势。
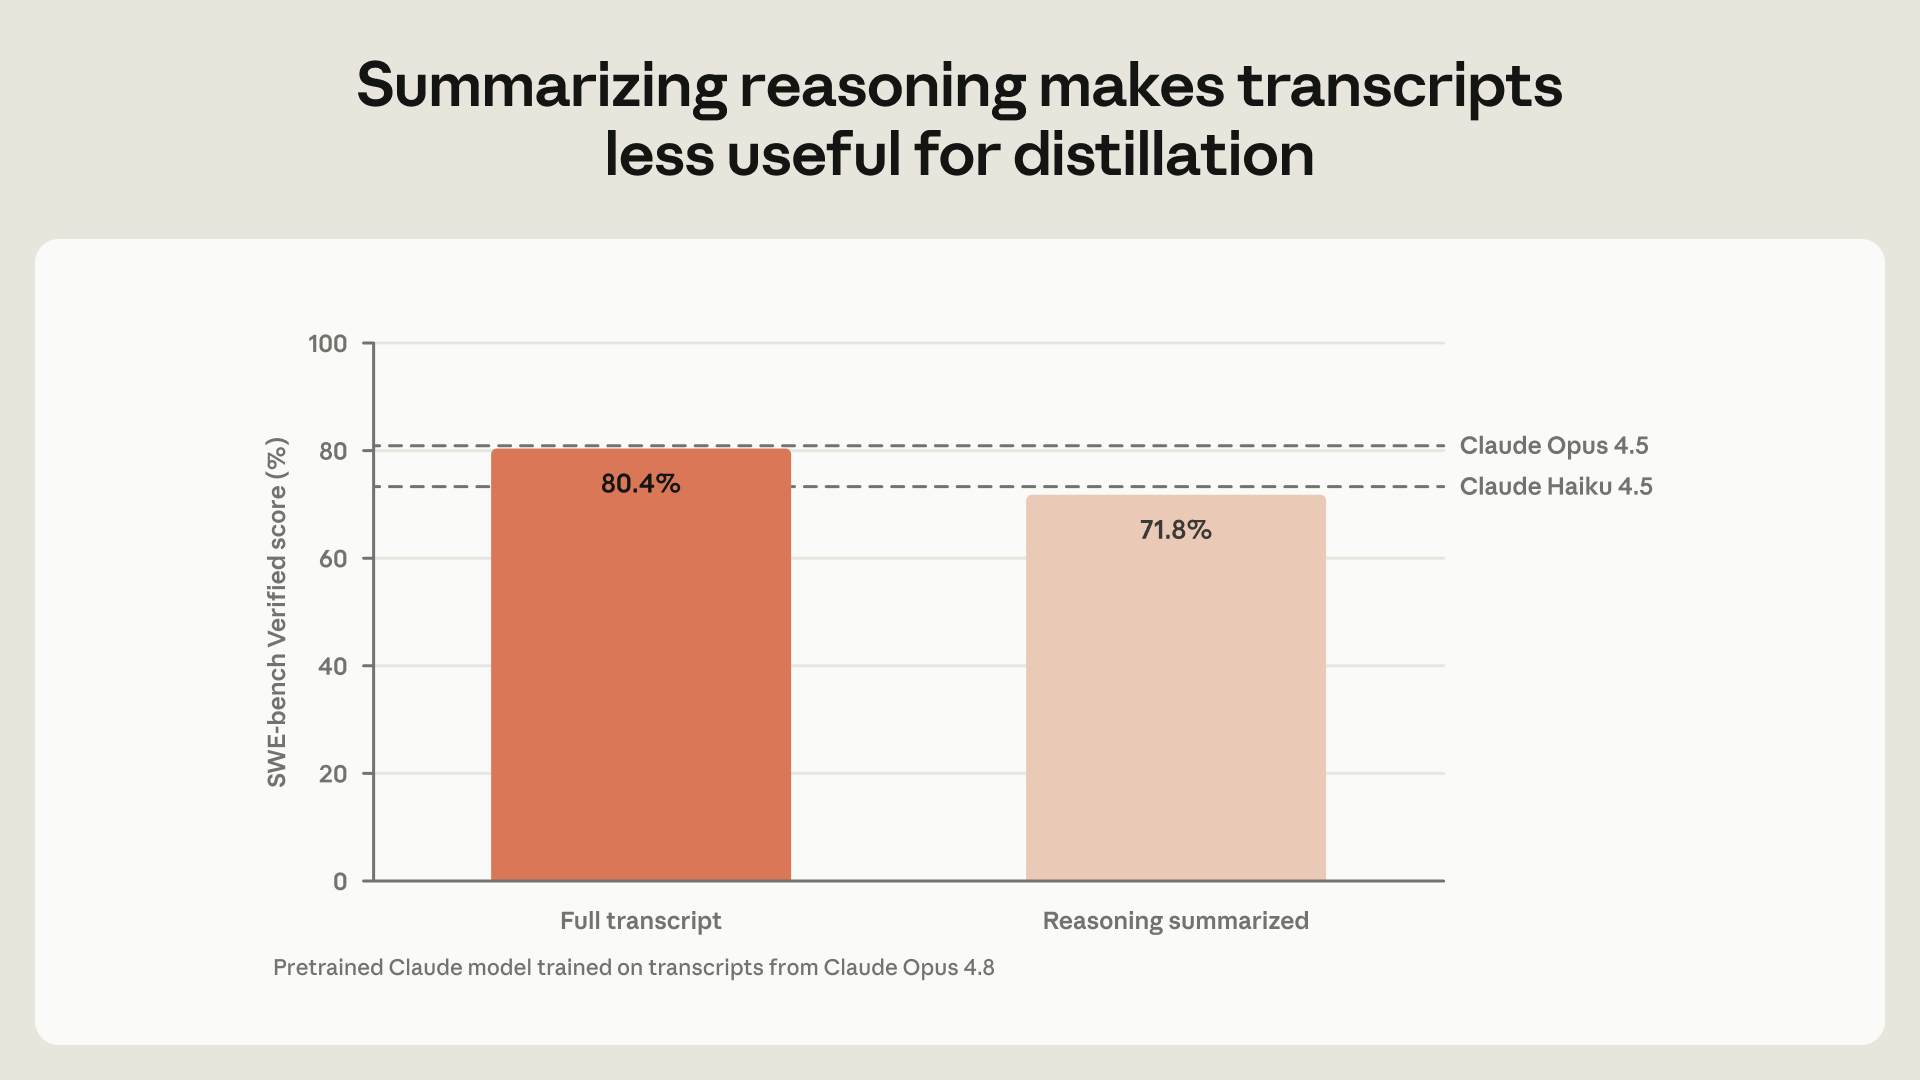
来源:Anthropic。柱状图描述的是基于 Opus 4.8 记录训练的学生模型,而不是图中作为参考线展示的生产模型之间的直接基准对比。
展示摘要可以减少被动收集,但也会促使攻击者通过后续请求诱导隐藏推理。Anthropic 表示,一个实验室曾测试 12,000 种不同的提取请求。该公司还描述了通过大量账户分散活动的代理网络,其中包括此前披露的一个网络:该网络曾同时管理超过 20,000 个欺诈账户。
对于长任务,模型可能需要从早先轮次生成的推理继续处理。API 可以为此保留受保护的推理块,而不会将底层推理作为普通的、用户可读的文本暴露出来。
这带来了访问控制问题。根据 Anthropic 的说法,攻击者曾尝试在不同对话、模型或账户之间转移推理,以寻找可以披露它的上下文。因此,保护推理块不仅需要控制其展示方式,也需要控制其复用方式。
Anthropic 在 Claude Fable 5.1 和 Claude Opus 5.5 中引入了保留推理。当前文档描述了两项核心检查:
对于在 2026 年 8 月 31 日 00:00 UTC 或之后创建的账户,前缀检查默认强制执行。较早创建的账户可以通过已记录的控制项选择启用强制执行。模型兼容性检查则适用于所有账户。
研究公告还描述了针对 Sonnet 5.5 推理的组织限制。当前 API 文档给出了更具体的规则:在适用已记录强制规则的情况下,Sonnet 5.5 和 Haiku 5.5 的推理块只能在生成它们的账户或关联账户中使用。开发者在实施路由或账户变更时,应以该兼容性文档为准。
常见的应用程序行为可能会更改变更受保护的前缀:例如使用新时间戳重建系统提示词、编辑旧的工具输出、更改工具说明,或者在保留后续推理块的同时摘要早期轮次。
默认情况下,无效前缀可能导致返回 400 invalid_request_error。文档中的 Beta 控制项还允许将 thinking.block_binding.prefix_mismatch_behavior 设置为 drop_block,此时无效推理块以及其后的推理块会在该请求中被丢弃。这样可以让请求继续执行,但并不会修复已被更改的历史记录。
应保持重放历史稳定,并通过受支持的模式追加新信息。 更改对话的可见文本后,仍继续复用其所有旧的受保护推理,不再是一个稳妥的假设。
Anthropic 的第二层防御使用了受其 Constitutional Classifiers 研究启发的两阶段分类器系统。该系统通过内部和外部红队测试提取尝试,并在某种技术成功时更新防御措施。
该公司表示,所得反蒸馏保护措施在其评估中的误报率低于 0.1%。它将这些措施的稳健性与其防止生物武器协助的防御措施进行了比较。这是该公司在其测试条件下的评估,并不保证某个用户的合法请求绝不会被拒绝。
该系统也会随时间变化。Anthropic 描述了针对试图通过翻译或特殊格式输出披露受保护推理的技术所进行的修补。公开的说法是,分类器可捕获其 9 月报告中所描述、且针对该系统所覆盖模型的提取技术。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
第三层则针对重复行为。持续尝试提取的账户可能会被施加更严格的使用限制,关联账户也可能被封禁。Anthropic 报告称,其已封禁数万个账户,有时在某次活动开始后的两小时内便采取行动。
自 9 月 24 日起,Anthropic 还恢复对部分在模型响应前被拦截的请求收费,这些请求属于报告误报率低于 0.1% 的特定保护类别,其中包括蒸馏。来源还指出了生物滥用和前沿模型开发类别。该政策不应被泛化为适用于所有被拒绝请求或所有类型的安全过滤器。
Anthropic 估计,在引入分类器以及保留推理变更后,其自有平台上被提取的推理 Token 数量下降了 10–100 倍。有些日期的被提取 Token 数量过少,导致公司无法进行测量。
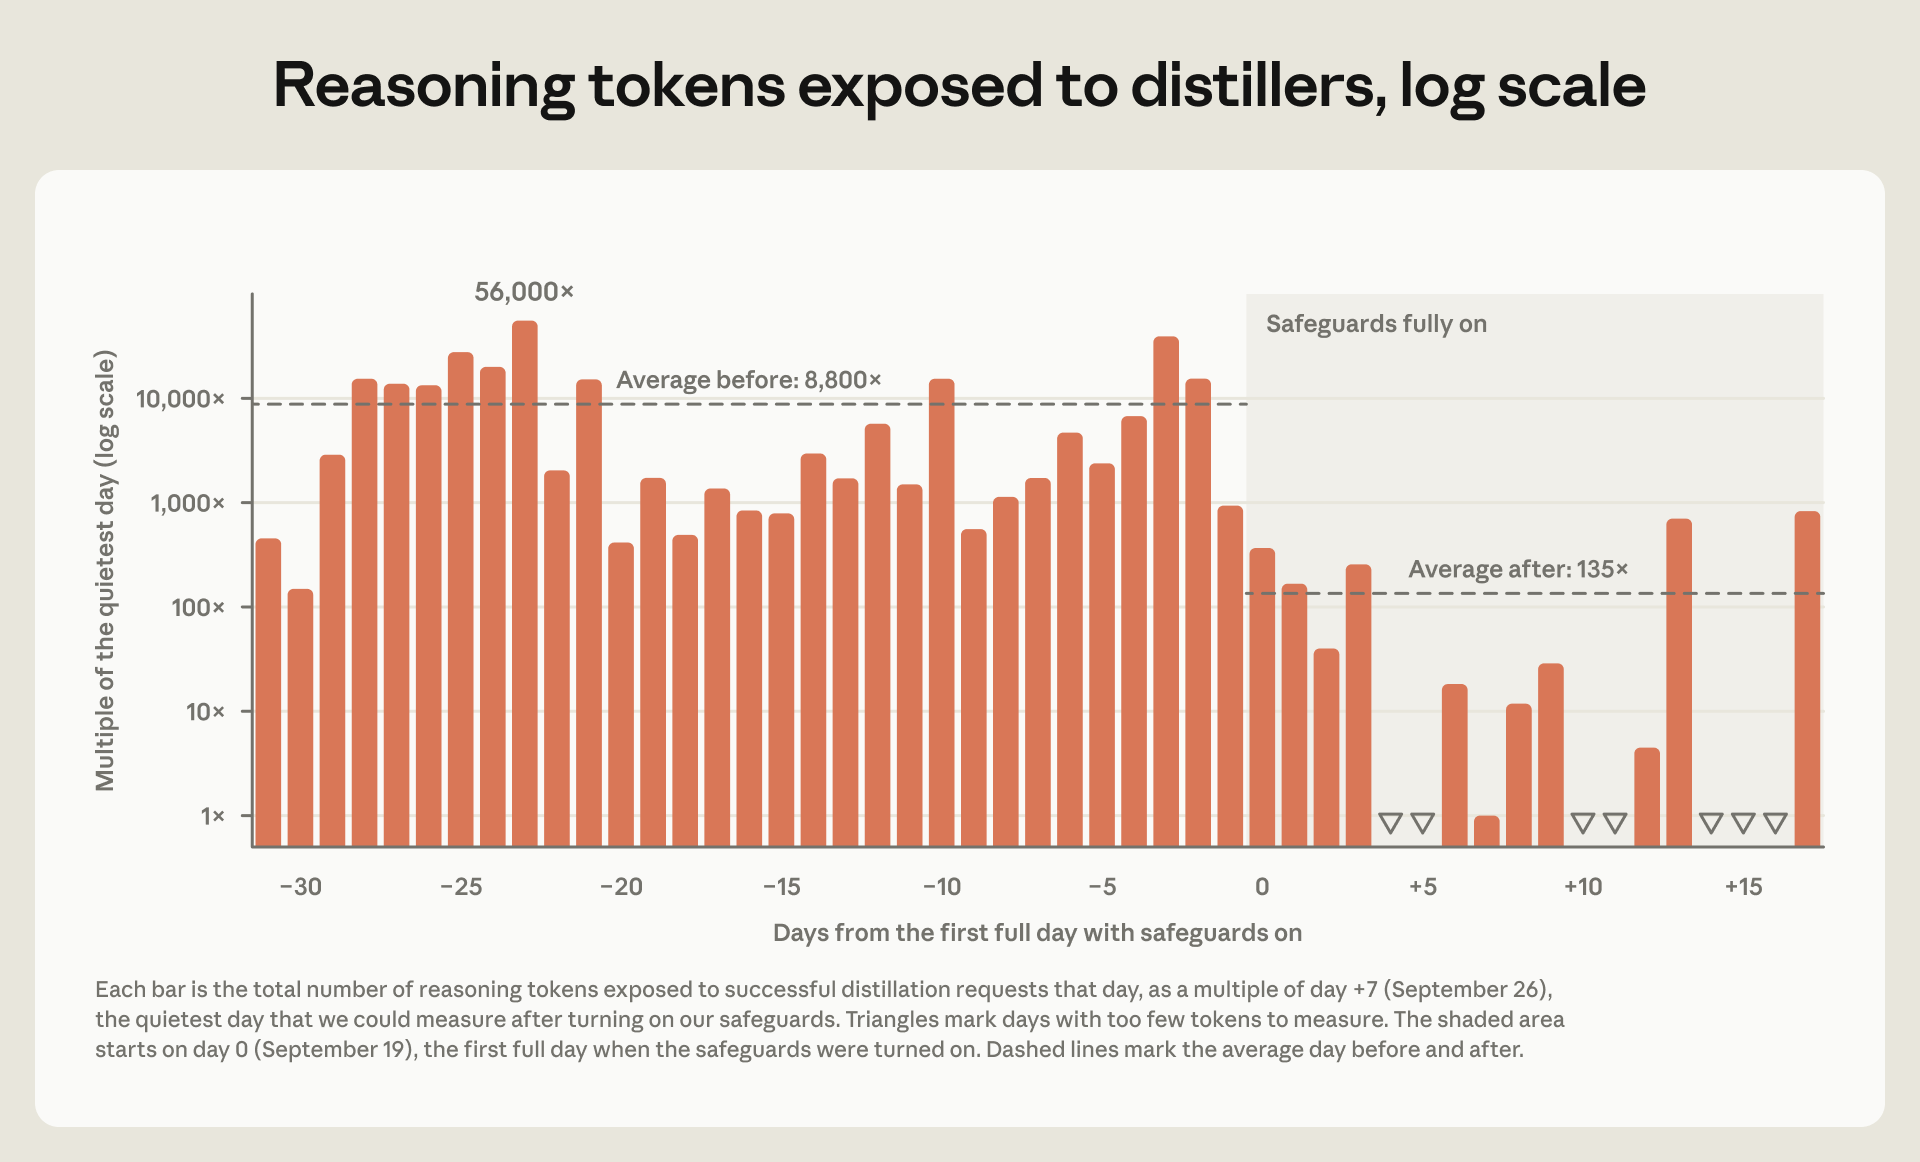
来源:Anthropic。纵轴采用对数刻度,并以某个低提取量日期为基准进行归一化,而非绝对 Token 计数。向下三角形表示 Token 数量过少而无法测量的日期。
范围很重要。这些数据描述的是 Anthropic 对其自有平台的估计,而不是对第三方推理服务提供商上所有蒸馏活动的测量。该公司还表示,尚未观察到高度复杂且持续尝试击败已完整实施防御措施的行为,也不知道这些成效能够维持多久。
Anthropic 承认,这些变化对普通用户而言并不完全透明。集成可能需要更新,正常请求可能被误分类,而这些误拦截如今可能会在受影响类别中产生费用。
失去可复用推理还会带来另一种成本:模型可能需要重新构建已完成的工作。API 文档描述的一项多轮编程基准测试显示,在最大努力级别下,每个会话丢弃一次推理会使输出 Token 增加 20.1%。这是一个具有较大误差范围、特定于工作负载的估计,而不是标准附加费,也不是对每个应用的预测。
对开发者而言,有用的区别在于无法读取或被丢弃的输入块,与新生成的输出之间的差别。被丢弃的推理块本身不计费,但重新构建推理可能会产生额外输出 Token。监控前缀不匹配并测试应用自身的工作负载,比假设一次成功重试没有成本更有参考价值。
在 Anthropic 的定义中,它是指未经授权地收集 Claude 输出或受保护推理,以训练另一个模型的活动。蒸馏本身是一项标准机器学习技术;当开发者拥有必要权利和授权时,它可以是合法的。
没有。Anthropic 报告称,在部署这些保护措施后,其自有平台上被获取的推理减少了约 90%–99%。这一数字并不覆盖每一个服务提供商、每一种攻击或未来所有提取方法。
不会,前提是应用程序遵循已记录的规则来重放推理并保留对话前缀。当早期上下文发生变化,而应用程序仍继续发送绑定于原始上下文的推理块时,才会出现问题。
只有在已记录的模型兼容性规则允许的情况下才可以。无法读取某个推理块的模型会在没有该块的情况下运行,因此切换到成本更低的模型不一定能保留先前模型的推理。
是的。Anthropic 表示,自 9 月 24 日起,某些保护类别即使在 Claude 响应前拦截请求,也会恢复计费。报告明确承认,这些类别中的误报可能影响合法客户。
不会。该数字是在一项特定的多轮编程测试中,于最大努力级别下每个会话丢弃一次推理时报告的增幅。实际影响取决于努力级别、对话历史、任务类型以及集成丢弃推理块的频率。
Anthropic 的新防御措施结合了对受保护推理的限制、提取分类器,以及对重复滥用行为的执行措施。该公司报告称,其自有平台上被获取的推理已显著减少,同时也承认攻击者可能会适应这些变化。
对于 Claude API 开发者,当前的重点是维护有效的对话历史,并理解被拦截请求或被丢弃推理所带来的成本。报告中的安全收益十分显著,但稳定的集成设计和针对具体工作负载的测试仍然至关重要。
从一句话开始,几分钟内拿到完整网站。



