Claude Fable 5.2 泄露:灰度测试、Opus 5.2 传闻及与 GPT-6 Astra 的早期对比

新一轮 Anthropic 模型传闻正在开发者社区中快速传播。
2026 年 9 月 20 日,36氪转载了新智元的一篇报道,称部分 Claude 用户开始通过有限或隐藏路由测试看到疑似 Fable 5.2 和 Opus 5.2 / Opus-Next 的模型。开发者发布了截图、编码演示、视觉任务,以及与 OpenAI GPT-6 Astra 的并排对比。
这些报道很有意思,但一开始就必须明确一个区别:
截至 2026 年 9 月 20 日,Anthropic 尚未正式发布 Claude Fable 5.2 或 Claude Opus 5.2。
Anthropic 官方 Newsroom 仍将 9 月 1 日发布的 Claude Fable 5.1 列为当前正式可用的 Fable 模型。目前官方发布的 Opus 产品是 Claude Opus 5,于 7 月 24 日发布。
因此,下面的案例应被视为社区报告的灰度测试证据,而不是最终模型经过验证的规格或发布基准。
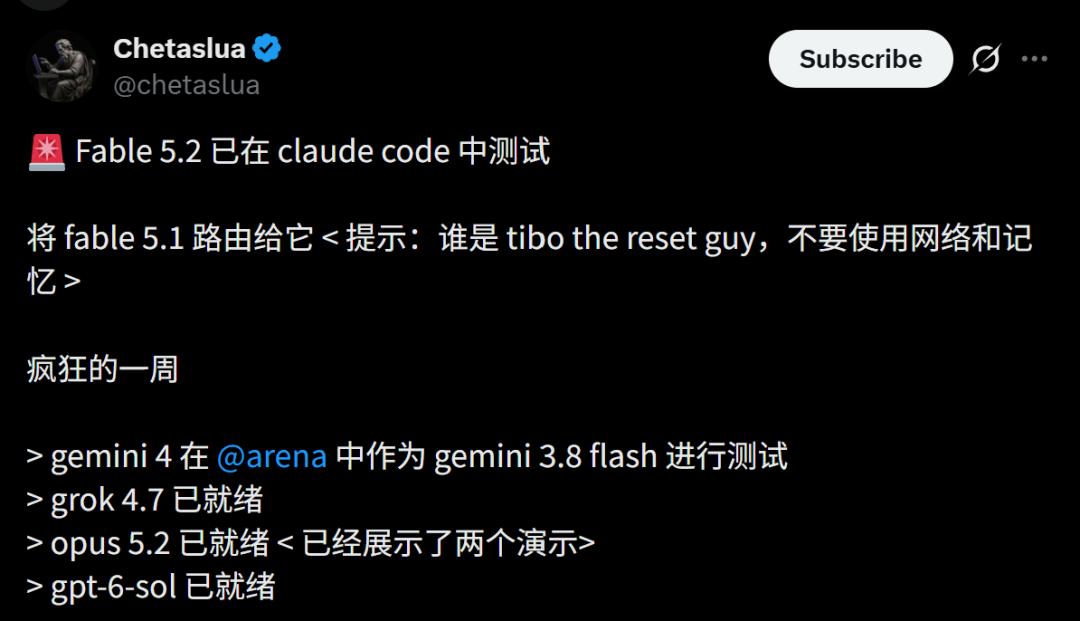
消息源文章称,部分 Claude Code、Claude Chat 和 Claude Cowork 用户开始注意到,原本发给 Fable 5.1 的请求表现有所不同,因此怀疑 Anthropic 正在静默地将一部分流量路由到更新的模型。
一些用户将这个可能的模型称为 Fable 5.2。
截至撰写本文时,Anthropic 尚未发布 Fable 5.2 的官方模型标识符、发布说明、API 模型页面、定价页面或系统卡片。
因此,目前能够提出的最有力结论是:
一些用户认为 Anthropic 正在对更新版 Fable 进行 A/B 测试或灰度路由,但公开证据尚不能独立证明其最终产品名称、架构、定价或发布时间。
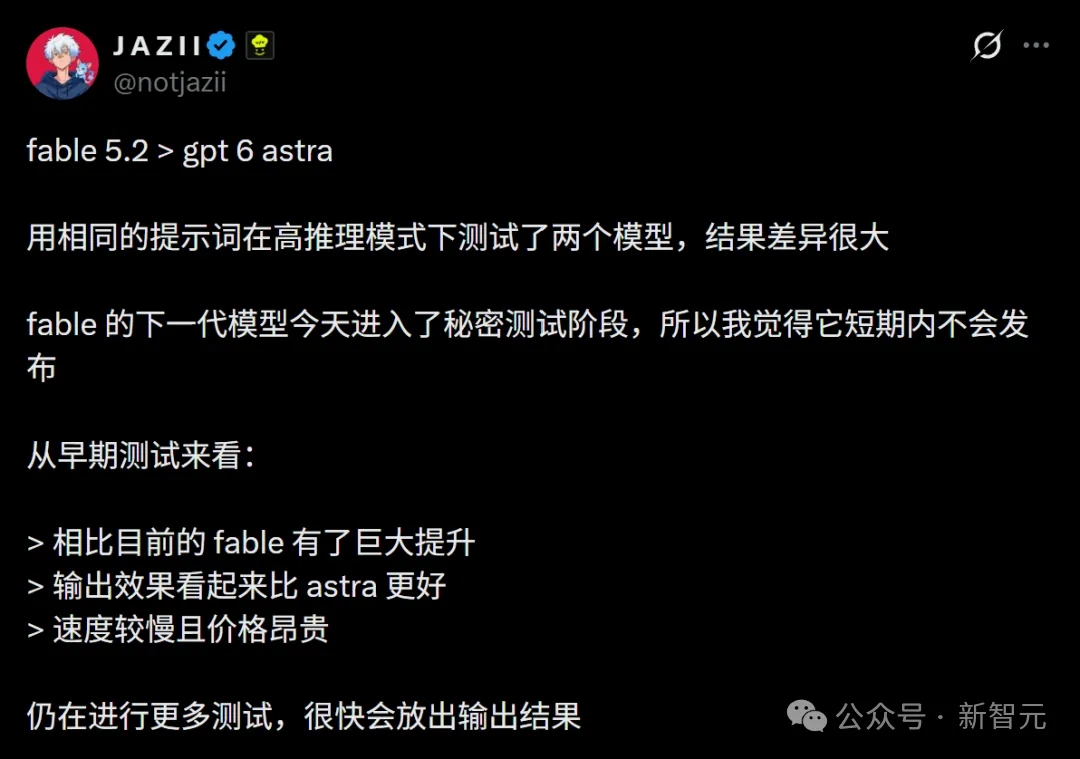
AI 测试者 @notjazii 表示,他认为某次 Claude 会话被路由到了更新的 Fable 模型,其结果明显强于此前使用的 Fable 版本。
随后,他在高推理设置下,使用同一个提示词,将疑似 Fable 5.2 的输出与 GPT-6 Astra 进行了对比。
他的结论是,疑似新 Fable 模型看起来相较当前版本有明显提升,并且在测试中产生了更令人印象深刻的输出。
他还提到了两个权衡:
如果模型使用了更多测试时计算或更高的工作量设置,这些权衡是合理的,但 Anthropic 尚未公布 Fable 5.2 的官方延迟或定价信息。
因此,这些内容仍应被视为用户观察,而不是产品规格。
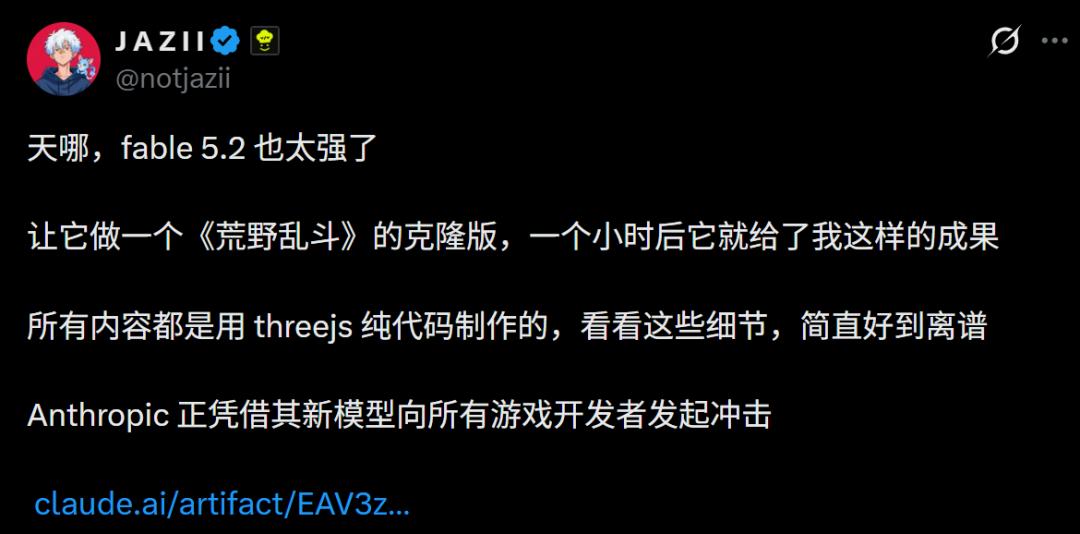
同一位测试者还要求这个疑似新模型使用 Three.js 构建一个受 Brawl Stars 启发的克隆版本。
根据帖子内容,该模型在大约一小时后生成了一个视觉细节丰富、可以运行的原型。
这类案例有助于理解开发者正在测试什么:不仅是短代码补全,还包括涉及视觉输出、游戏逻辑、迭代和前端实现的更长时间 Agent 编码会话。
不过,这并不是受控基准测试。结果会受到提示词、环境、工具、人工干预、重试次数以及模型路由的影响。
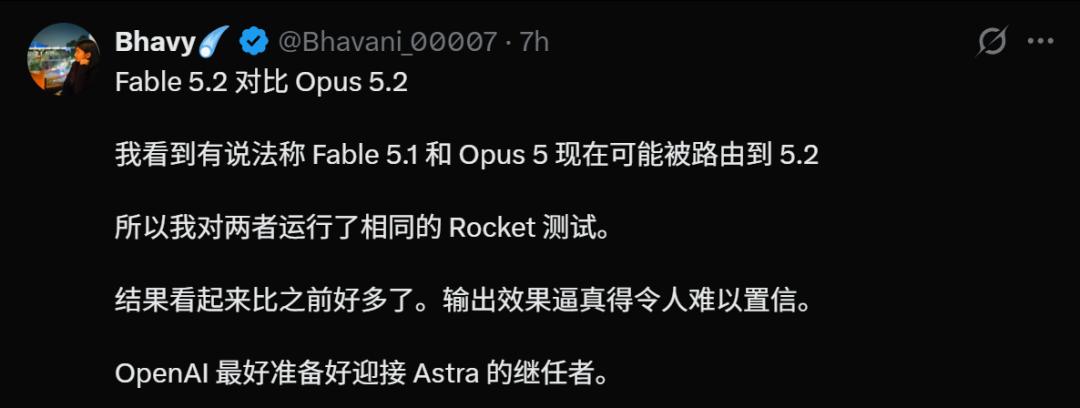
另一位测试者 @Bhavani_00007 表示,他对疑似 Fable 5.2 和 Opus 5.2 的实例运行了同一个“火箭测试”。
据描述,这项任务主要考察:
这位测试者表示,结果看起来比此前的 Claude 输出好得多。
同样,这一说法没有配套的标准化分数或可复现基准测试流程,因此应被视为轶闻证据,而不是经过测量的能力提升证明。
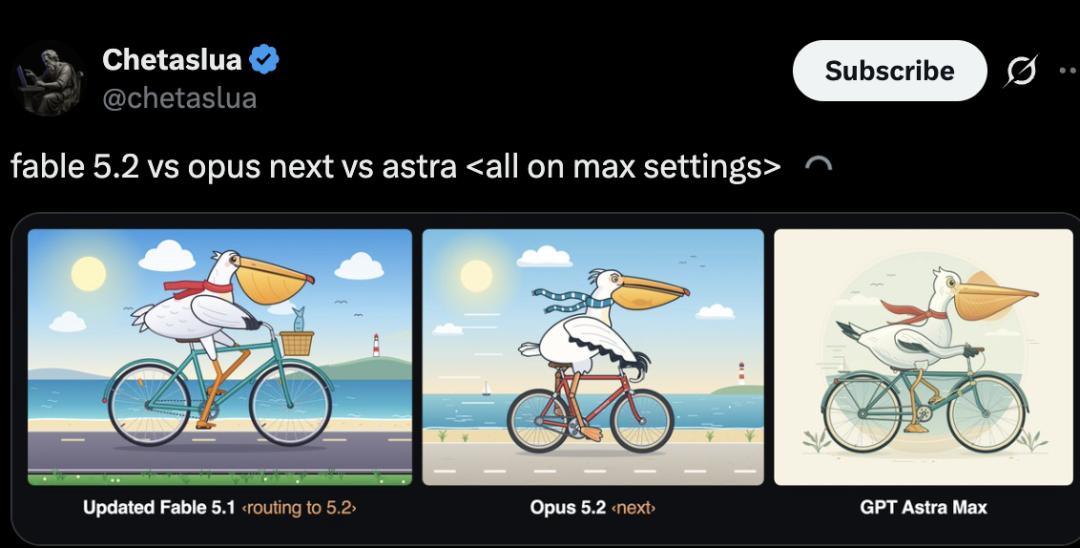
另一项社区对比将疑似 Fable 5.2、一个传闻中的 Opus-Next 模型和 GPT-6 Astra 放在一起,并均使用各自最高可用设置进行测试。
消息源文章认为,Anthropic 模型的输出在细节上比 Astra 的结果更丰富。
这是一种主观视觉判断,而不是受控基准测试结果。不同的工作量设置、工具访问权限、提示词处理方式、采样机制和隐藏路由,都可能影响对比结果。
更谨慎的结论是:这些泄露的输出足够强,已经让有经验的用户相信 Anthropic 可能正在测试一次有实际意义的更新。
消息源还引用了测试者 @Mr_Salio 的说法。该测试者认为 Anthropic 似乎正在强势回归,并预测 Fable 5.2 将在更困难的推理配置下超过 GPT-6 Astra。
这仍然只是个人测试者的预测。
目前没有公开的 Anthropic Fable 5.2 基准测试表,可以与 OpenAI 发布的 GPT-6 Astra 结果直接比较。
作为参考,正式发布的 Claude Fable 5.1 已经是 Anthropic 当前正式可用、最擅长编码和知识工作的模型。Anthropic 表示,Fable 5.1 面向高难度、长时间运行的任务,并已在 Claude、Claude Code、Claude Platform、AWS、Google Cloud 和 Microsoft Azure 上提供。
文章还分享了一种社区技巧,用于尝试推断某个 Claude 会话是否被路由到了更新的模型。
建议使用的提示词大致是:
你知道“Tibo the reset guy”是谁吗?不要使用网络搜索。
其理论是,旧模型可能不知道这一近期出现的指代,而拥有较新训练数据的新模型可能会根据记忆正确回答。
这作为社区实验很巧妙,但它不是可靠的模型识别方法。
模型可能因为以下原因给出不同答案:
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
是否知道某一条近期事实,不能证明请求究竟由哪个后端模型处理。
识别 API 模型的唯一可靠方式,是查看官方模型标识符和平台文档。面向消费者的 Claude 产品可能使用动态路由,而用户无法完全看到这种路由过程。
文章的后半部分聚焦于另一个传闻模型:Opus 5.2,测试者有时也将其称为 Opus-Next。
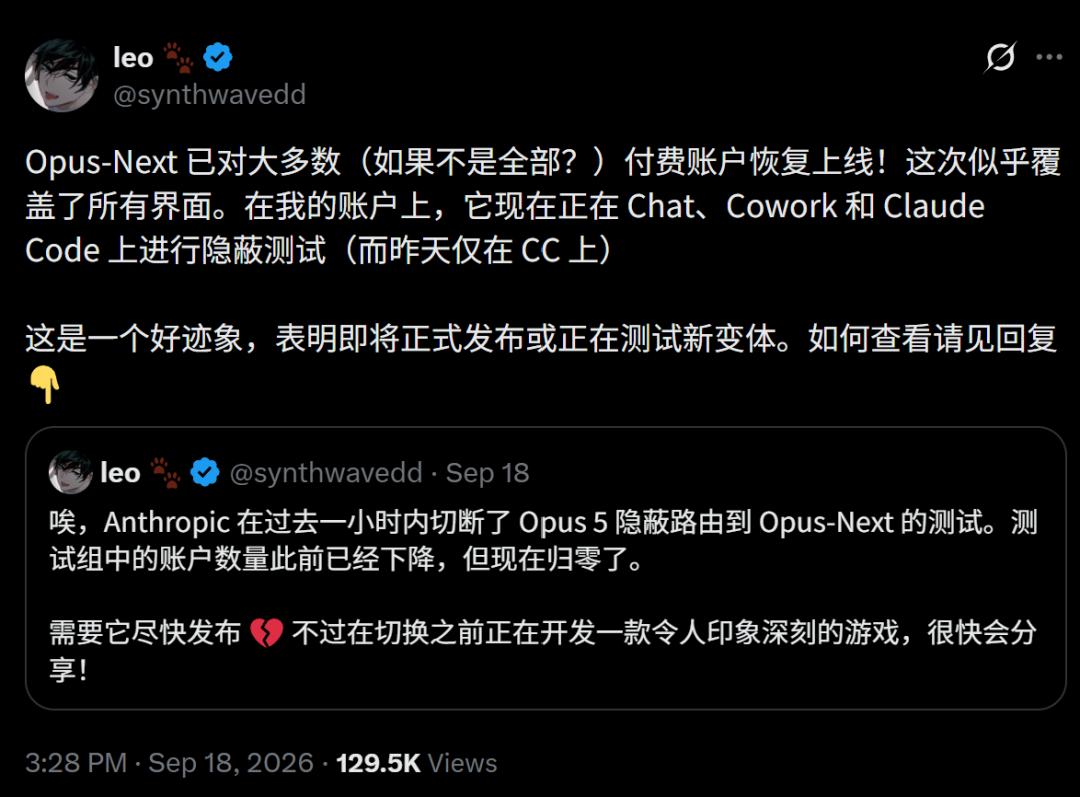
用户声称,该模型曾短暂出现在 Claude Code 中,随后消失,几小时后又重新出现,并在 Chat、Cowork 和 Claude Code 中进行更广泛的测试。
一位测试者描述称,他在处理一个复杂项目时模型突然被移除,之后似乎又恢复了。
文章将此解读为 Anthropic 可能正在进行后期路由实验的证据。
这种可能性存在,但尚未得到确认。
Anthropic 官方宣布的 Opus 模型仍然是 Claude Opus 5,于 2026 年 7 月 24 日发布。Anthropic 将其描述为一款审慎、主动的模型,以更低成本实现接近 Fable 5 能力的表现,定价为每百万输入 Token 5 美元、每百万输出 Token 25 美元。
截至 9 月 20 日,官方尚未出现 Opus 5.2 产品页面或 API 标识符。
文章引用了社交媒体上的猜测,认为 Anthropic 可能将下一代 Opus 模型命名为“5.2”,因为这次更新幅度大于典型的小版本迭代。
没有官方证据表明这就是 Anthropic 的命名逻辑。
事实上,Anthropic 确实在 9 月 1 日正式发布了 Fable 5.1,这说明公司在选择使用时确实会采用 .1 版本号。
如果 Opus 5.2 最终发布,Anthropic 的发布公告,而不是社区关于命名的理论,才是权威解释。
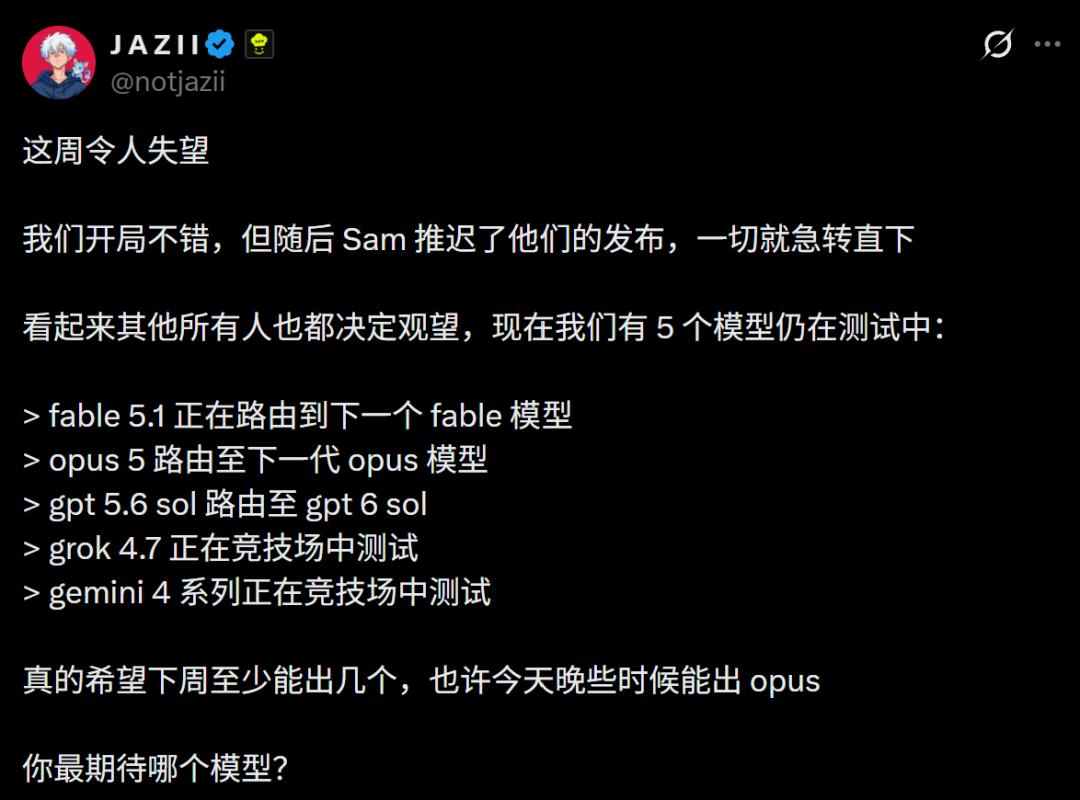
文章最后将 Claude 传闻放在更广泛的一周前沿模型猜测中进行讨论。
社区帖子声称,多家公司正在悄悄测试新的模型变体,包括:
这些说法的可信度并不完全相同。
模型提供商经常运行 A/B 测试、分阶段发布、内部别名和隐藏路由实验。但如果没有官方公告或稳定的模型标识符,外部用户通常无法仅凭模型行为准确判断实际使用的模型。
消息源还提到,有传闻称前沿模型可能正在接近解决一些困难的开放数学问题,研究团队也在就潜在结果联系数学家。
根据现有证据,这一说法过于模糊,无法验证,也不应被视为任何千禧年大奖难题已经解决的证明。
截至 9 月 20 日,最重要且已确认的 Anthropic 基准仍然是 Claude Fable 5.1。
Anthropic 官方表示,Fable 5.1:
未来任何 Fable 5.2 或 Opus 5.2 的发布,都应在 Anthropic 公布实际模型卡、基准测试、价格、上下文限制和 API 标识符后,再与这一官方基线进行比较。
没有。截至 2026 年 9 月 20 日,Anthropic 官方 Newsroom 和 Fable 产品页面仍将 Claude Fable 5.1 列为当前正式可用的 Fable 模型。关于 Fable 5.2 的说法,基于社区关于可能存在灰度测试或隐藏路由的报告。
根据本文查阅的 Anthropic 公开产品公告,尚未正式可用。目前官方发布的 Opus 版本是 Claude Opus 5,于 2026 年 7 月 24 日发布。
它们可以作为早期用户印象参考,但不是受控基准测试。隐藏路由、推理工作量、工具、采样方式、提示词细节和重复尝试次数,都可能改变结果。
不能可靠地检测。模型是否知道某一条近期互联网信息,并不能证明其后端身份;面向消费者的 Claude 产品还可能使用用户无法直接检查的路由机制或系统行为。
Anthropic 于 2026 年 9 月 1 日正式发布了 Claude Fable 5.1。它是公司当前正式可用的 Fable 模型,面向高端编码、知识工作和长时间运行的 Agent 任务。
Anthropic 将 Fable 5.1 的价格列为每百万输入 Token 10 美元、每百万输出 Token 50 美元,缓存读取价格为每百万 Token 0.25 美元。Anthropic 表示,较低的缓存读取价格可以相较 Fable 5 降低典型工作负载成本。
Anthropic 将 Opus 5 定位为一款适合日常编码和知识工作的强大模型,以低于 Fable 的成本提供接近前沿的能力。其定价为每百万输入 Token 5 美元、每百万输出 Token 25 美元。
Anthropic 尚未公开确认这两个模型的发布时间。在 Anthropic 发布官方公告或模型文档之前,任何具体的发布日期预测都仍属于猜测。
Fable 5.2 故事最好被理解为一次灰度测试泄露,而不是产品发布。开发者发布了足够多的异常路由行为、编码输出和并排测试,让这些传闻值得关注;但 Anthropic 尚未提供验证正式 Fable 5.2 或 Opus 5.2 产品所需的模型 ID、基准测试、定价、系统卡片或发布说明。
早期案例表明,Anthropic 可能正在测试更强的长时程编码、视觉生成和推理能力。但这些案例尚不能证明 Fable 5.2 一定击败 GPT-6 Astra,也不能证明用户标记为“5.2”的每个会话都确实由同一个隐藏模型处理。
目前,经过验证的参考点仍然是 Claude Fable 5.1 和 Claude Opus 5。
这些泄露信息值得持续关注,但真正的比较要等到 Anthropic 发布官方 5.2 模型及其可复现的评估细节后才会开始。
从一句话开始,几分钟内拿到完整网站。