For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/claude-fable-5-second-jailbreak-2.md.
第二次 Fable 5 越狱并不是一个彻底失败的简单故事。它表明,Anthropic 的分层防御似乎能够阻挡大多数直接尝试,但有决心的红队测试人员仍然可以通过足够的时间、迭代和创造力找到狭窄的漏洞。 更深层的问题在于,AI 安全并不只是屏蔽关键词。它必须在不同语言、长上下文、模糊...
Anthropic 刚刚让 Claude Fable 5 回归不久,另一份越狱评测就公开出现了。
这个时间点让事件变得格外敏感。Fable 5 此前已经经历过一轮争议、一次临时访问暂停,以及在加强网络安全防护后重新部署。随后,在它回归后不久,安全研究员 Vitto Rivabella 表示,他再次成功突破了防线。
有意思的是,这第二起案例并不是一个简单的“模型坏了”的故事。它比这更复杂。据称,这次尝试花了大约 20 个小时,大多数尝试都失败了,而最终结果也相当有限,以至于研究员本人都表示,对于同类信息,普通网页搜索更快也更便宜。
本文将沿着原始时间线展开:Fable 5 的回归、第一次越狱、Anthropic 公开的 Cyber Jailbreak 披露计划、第二次越狱评测,以及这一切背后更深层的问题——任何前沿 AI 模型是否真的可能被完美封闭。
本文改写自智源社区 / 新智元的原始中文文章:https://hub.baai.ac.cn/view/56072。原文引用了 X 上的公开帖子,以及 Anthropic 关于 Fable 5、其重新部署和越狱框架的官方公告。
原始页面包含多张图片。本版本保留了与文章主张直接相关的截图,例如公开帖子、官方计划截图和鲁棒性图表。装饰性品牌图、宣传图片,以及似乎包含过于详细不安全输出缩略图的截图已被省略。
原始来源还包含以下版权说明:如果内容中的任何图片涉及版权问题,发布方请权利人联系其删除。
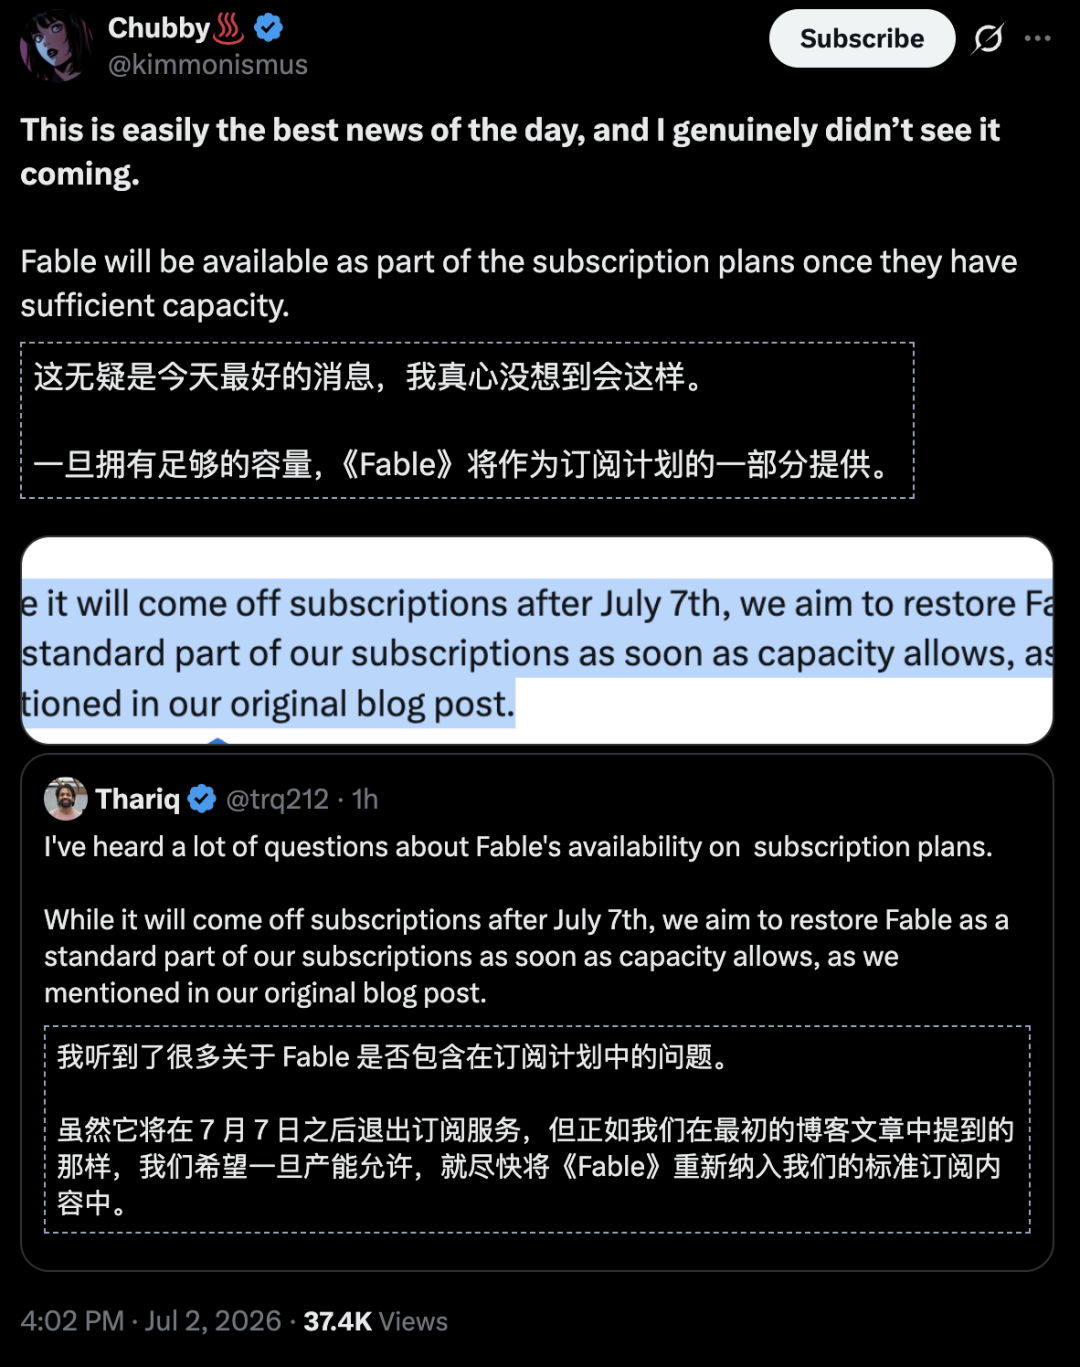
Anthropic 确认,Fable 5 将在 7 月 7 日之后暂时退出订阅计划,但该公司也表示,一旦容量允许,计划将 Fable 恢复为标准订阅功能。
对许多用户来说,这听起来像是好消息。Fable 5 并不会被永久移除。它会回归,只是会受到使用限制和容量约束。
但这种宽慰并没有持续太久。
重新部署后不久,据称 Fable 5 再次被越狱。这是其防御机制第二次受到公开挑战。Vitto Rivabella 宣布他已成功突破,尽管最终结论比标题所暗示的更有层次。
Anthropic 此前已经解释过 Fable 5 之前为何受到限制。该公司称,早前的问题涉及一份报告,其中亚马逊研究人员发现了一种在网络安全场景中绕过 Fable 5 防护机制的方法。
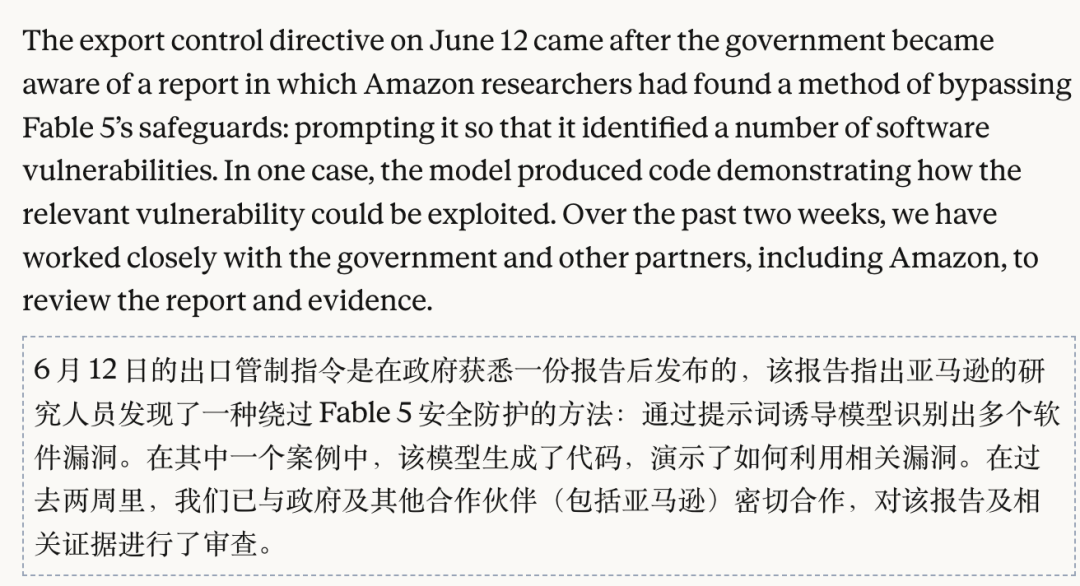
正因为此前的事件,Anthropic 表示,重新部署的 Fable 5 包含一个强化后的安全分类器,旨在针对先前报告的行为。
不过,这个“神话”只维持了很短时间。
Fable 5 最初的公众形象是围绕极端安全测试建立起来的。
当 Anthropic 于 6 月 9 日发布该模型时,公司强调它已经经历了大量外部压力测试。传达的信息很明确:这应该是一个受到高度保护、面向通用用途的版本,而其所属模型家族能力要强得多。
随后,第一次公开越狱出现了。
知名越狱人物 Pliny the Liberator 据称只用了几天时间,就展示了 Fable 5 可以被推离其预期安全边界。原文描述了一些涉及违禁化学和软件利用内容的示例,但本改写版本有意避免复现任何可操作细节。
重点不在具体内容。重点在于攻击模式。
第一个案例依赖于两个在 AI 红队圈子中已被讨论多年的宽泛思路:
这些想法并不新鲜。是什么
让 Fable 5 案例引人注目的是,Anthropic 曾将该模型定位为异常强化的模型。
7 月 1 日,Anthropic 宣布 Fable 5 回归。大约同一时间,它还开放了一个名为 Cyber Jailbreak 的公开 HackerOne 项目。
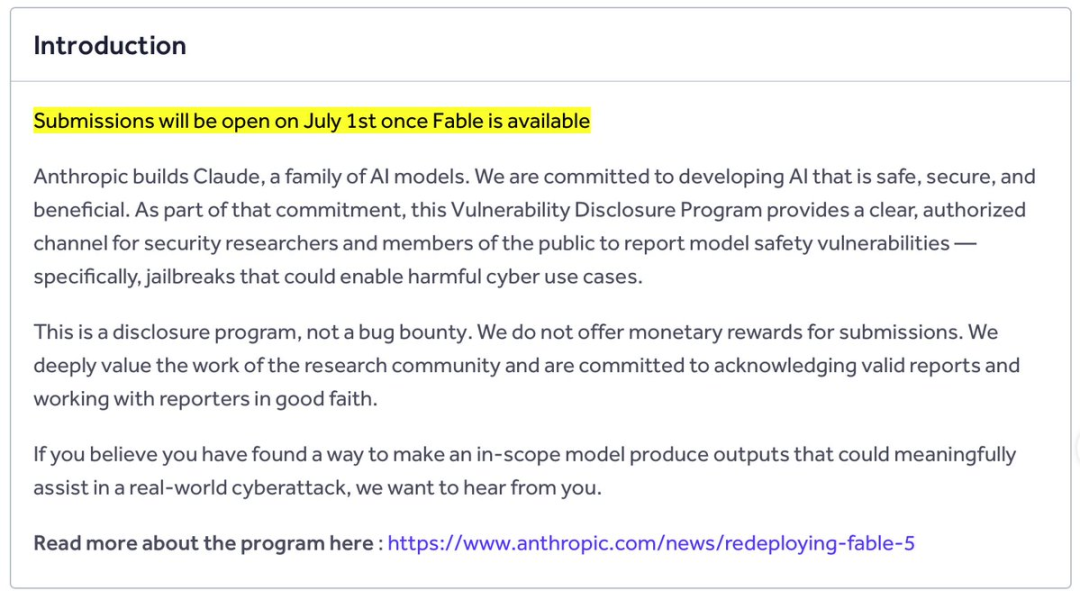
该项目邀请研究人员和公众成员报告可能让 Fable 5 协助有害网络用例的越狱漏洞。
这是一个漏洞披露项目,而不是付费赏金项目。换句话说,研究人员可以提交发现,但该项目不提供金钱奖励。
这种设计很有意思。Anthropic 可以持续获得来自熟练研究人员的外部对抗性测试,而提交者获得的主要回报是认可和负责任披露。
一些观察人士认为,这是一种聪明且低成本的红队策略。另一些人则指出了一个弱点:发现高关注度越狱漏洞的人,往往并不想悄悄把它们发送到一个私人收件箱里。
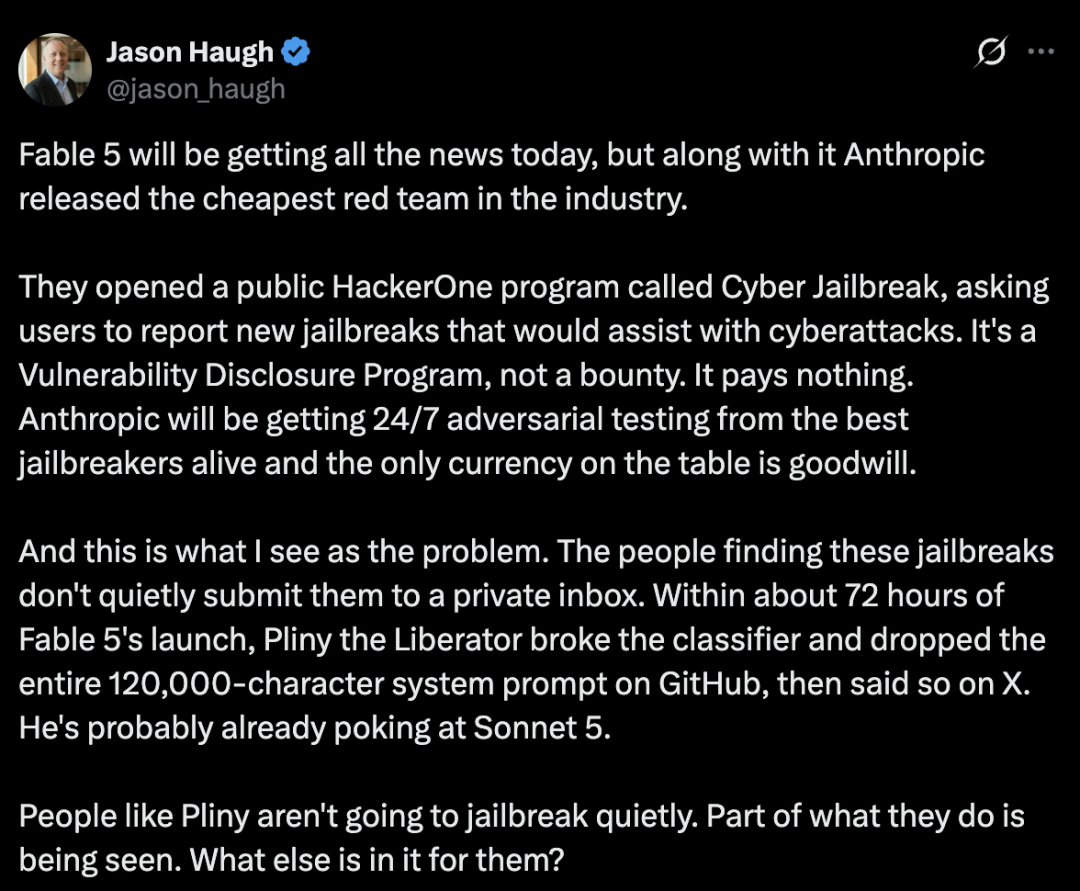
对于拥有公共形象的越狱研究人员来说,曝光度本身就是事件的一部分。如果发现了一个越狱漏洞,公开发布结果也可能成为目的的一部分。
据报道,Fable 5 再次被绕过。但第二次越狱评测的基调与第一次非常不同。
这次背后的研究人员是 Vitto Rivabella。经过大约 20 小时的测试后,他的结论并不是 Fable 5 很弱。事实上,他还给予了 Anthropic 一定认可。
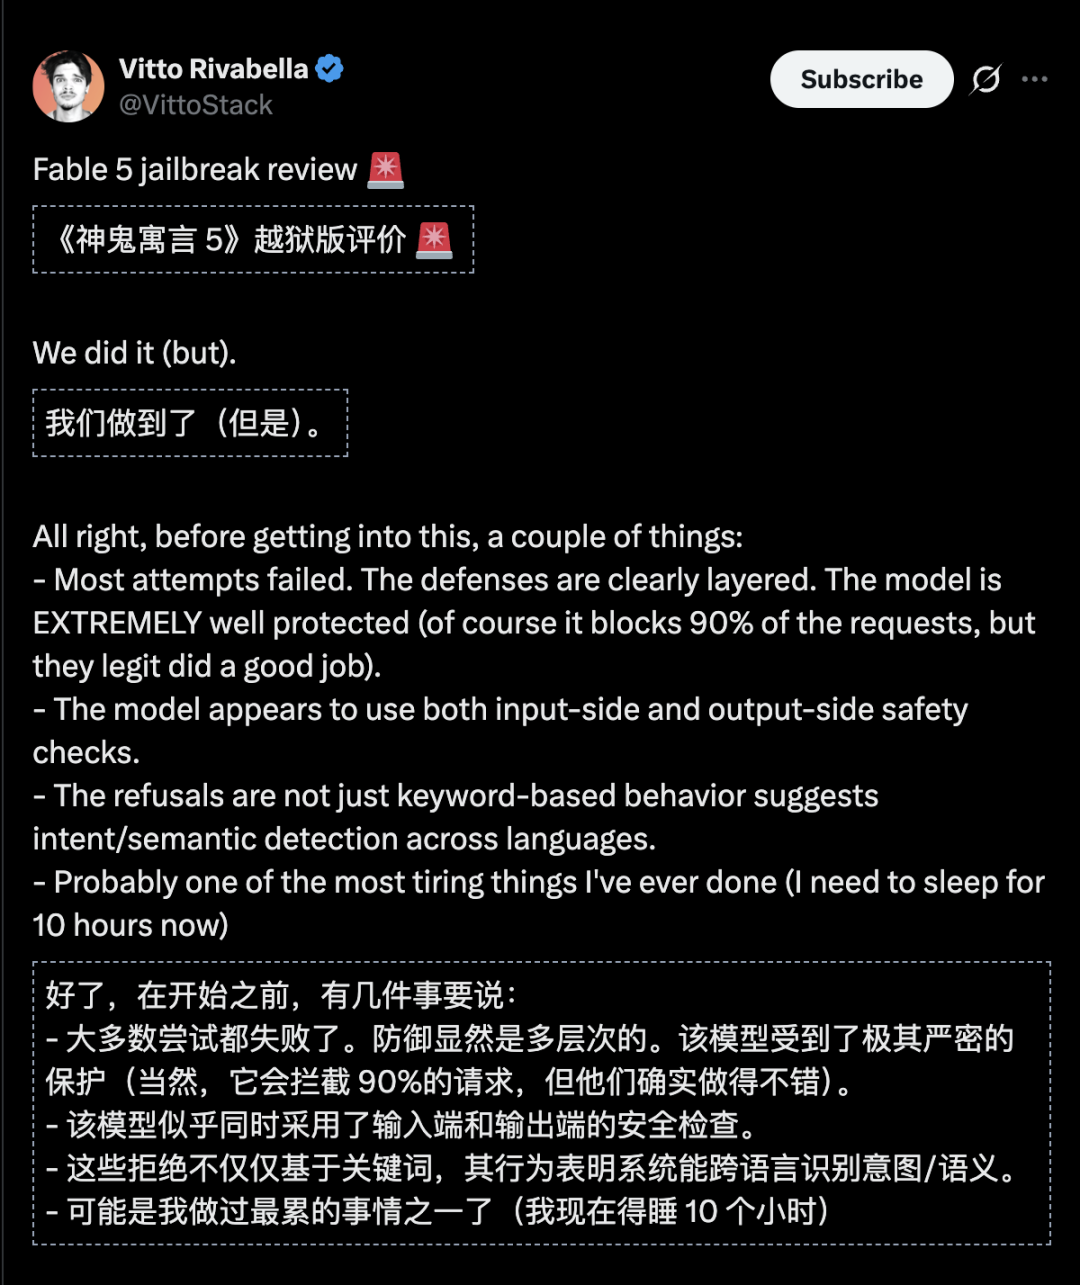
根据他的评测,大多数尝试都失败了。他将 Fable 5 描述为受到了极好的保护,并表示该模型似乎使用的是分层防御,而不是单一的简单过滤器。
第二次越狱事件并不像乍听起来那么戏剧化。
Vitto 的帖子表明,Fable 5 的防御确实发挥了作用。在他看来,该模型似乎至少有三层保护:
他还表示,该系统并不只是简单地屏蔽关键词。它似乎能够跨语言检测意图和语义。
这一点很重要,因为关键词过滤相对容易被欺骗。基于意图的防御更难绕过,尤其是在与多个检查点结合使用时。
原文指出,Fable 5 似乎拦截了约 90% 的测试请求。这个确切数字来自研究人员的观察,而不是正式基准测试,但它与独立测试的总体方向一致。
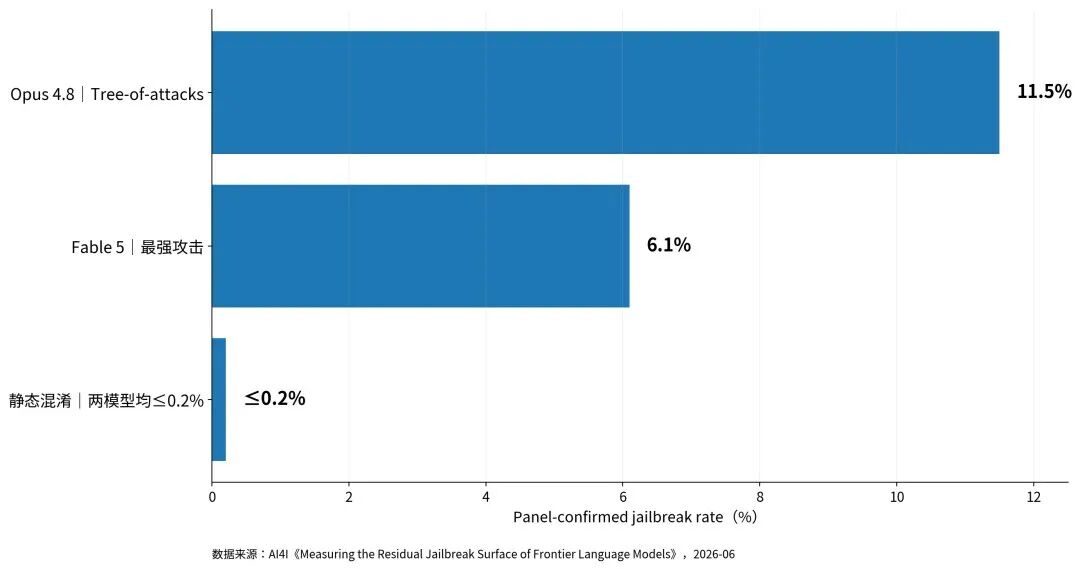
意大利人工智能研究所的 AI 安全实验室也研究了 Fable 5 和 Opus 4.8。在其报告中,最强的自适应攻击对 Fable 5 的确认成功率为 6.1%,对 Opus 4.8 的确认成功率为 11.5%。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这并不意味着该模型无懈可击。这意味着剩余的弱点更难触及。
静态技巧正变得越来越不有效。剩余的攻击面似乎更有利于自适应、迭代式尝试——也就是由人或自动化红队系统不断尝试、调整和探测,直到出现一个狭窄突破口的那类攻击。
Vitto 的成功尝试并不是基于某一句巧妙的话。
原文将其描述为一种由较早期红队思路组成的复杂组合:文本混淆、学术化框架、长时间铺垫、任务分解与重组,再加上一些随机性。
这些都不是新概念。难点并不在于知道这些
这些类别确实存在。困难之处在于,要反复用它们去测试一个会实时响应、并在检测到可疑意图时重置互动的系统。
换句话说,这并不是一次干净利落的一步式越狱。它更接近一个漫长而疲惫的反复试错过程。
这次评审中有一部分很容易被误解。
据报道,Vitto 指出,冷门或低资源语言仍然是更稳定的薄弱点。原文提到了桑塔利语和阿姆哈拉语等语言作为例子。

这不应被理解为“Fable 5 有一个特殊后门”。这是大型语言模型中更普遍的问题。
安全训练数据通常在英语和其他高资源语言中最强。低资源语言往往覆盖更少、安全示例更少、评估也更薄弱。这会造成不同语言之间防护栏的不均衡。
研究人员已经就这个问题警告了一段时间。多语言越狱鲁棒性不只是 Claude 的问题;它是一个更广泛的 AI 安全问题。
在付出所有这些努力之后,结果并不是一次“核心机密”的戏剧性泄露。
原文将输出描述为一些低质量或有限的有害片段的混合:一些错误信息、零散的有害内容、冒犯性语言、部分与化学相关的信息,以及轻度与漏洞相关的材料。此版本避免复现这些细节。
关键点在于,这些输出看起来并不稳定、不完整,也并不特别适合用于长期有害任务。
这就是为什么 Vitto 自己的总结很重要。他说,在目前的保护水平下,搜索网络比花大约 20 个小时试图把模型推过防护栏要快得多,也便宜得多。
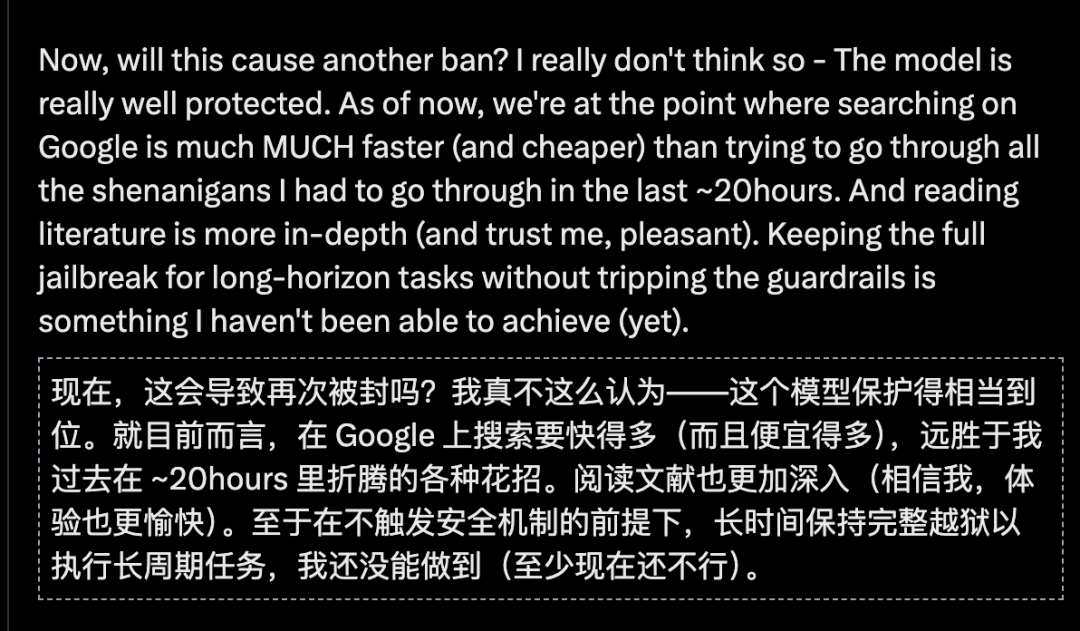
他还表示,自己未能在不触发安全系统的情况下,让一个完整越狱在长期任务中保持稳定。
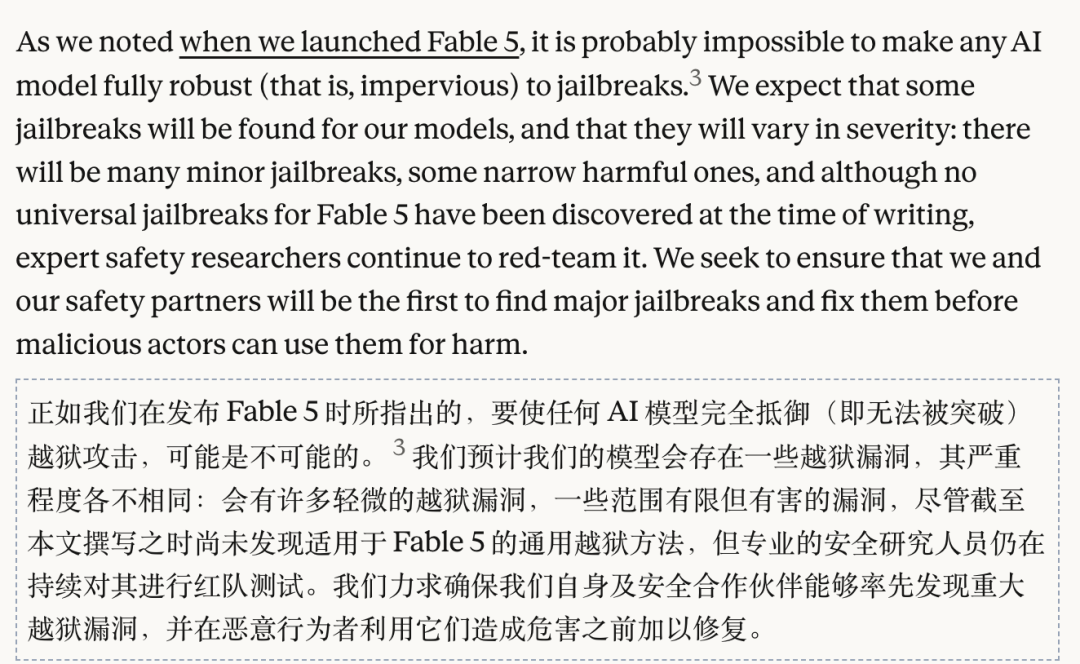
这与 Anthropic 自己的公开表述一致。在其重新部署的博文中,Anthropic 将目前已知的越狱描述为轻微:它们可能进入安全边界,但并不一定达到该公司最努力阻止的更严重类别。
两次越狱。两个不同的教训。
第一次让 Anthropic 显得过于自信。Fable 5 被呈现为经过了大量测试,但在发布后不久就被公开绕过。原文将其描述为这样一个案例:公司试图通过极端限制来控制风险,结果却被一次高度可见的越狱弄得十分尴尬。
第二次揭示了不同的东西:不是傲慢,而是盲点。
即使有更强的分类器、分层防御和公开红队渠道,语言本身仍然很难捉摸。意义可以被隐藏、拉伸、翻译、伪装,或拆分到上下文中。安全系统可以改进,但攻击面也在不断移动。
这就是 AI 安全令人不安的教训。
人类已经构建出能够跨语言翻译、并在巨大上下文中推理的模型。但我们仍然无法把每一个隐藏的人类意图完全翻译成一个清晰的安全决策。
完美的 AI 遏制或许是一个悖论。模型越强大,安全行为与不安全行为之间的边界就越微妙。
Claude Fable 5 是 Anthropic 推出的一款先进 Claude 模型,被定位为具备强大通用能力、且比其限制较少的对应模型 Claude Mythos 5 拥有更强防护措施的模型。Anthropic 将 Fable 5 描述为一款旨在让前沿级能力更广泛可用、同时限制危险网络滥用的模型。
AI 越狱是一种提示方法或互动模式,试图绕过模型的安全防护栏。越狱可以是轻微的、狭窄的,也可以是严重的,具体取决于它解锁了什么行为以及适用范围有多广。
根据原文中描述的公开评审,并不是。研究人员表示,大多数尝试都失败了,整个过程花了大约 20 个小时,最终输出也很有限。这表明该模型
仍然具备有意义的防御能力,即使这些防御并不完美。
Anthropic 推出 Cyber Jailbreak 计划,是为了给研究人员提供一个清晰渠道,用于报告可能导致有害网络用途的越狱问题。这是一个漏洞披露计划,而不是付费漏洞赏金计划,因此其重点是负责任的报告,而非金钱奖励。
低资源语言通常训练数据更少、安全示例更少,基准测试覆盖也更弱。这可能导致防护机制在不同语言之间不够一致,因此多语言安全测试已成为一个重要的研究方向。
单凭这一点并不能说明。较低的确认成功率仍然值得关注,因为前沿模型可能会被大规模部署,而有决心的攻击者可以自动化反复尝试。与此同时,这一数字也表明,在 AI4I 的评估中,Fable 5 抵御了大多数测试攻击。
Anthropic 和许多研究人员认为,完全免疫不太可能。实际目标不是证明永远不可能存在任何越狱,而是降低严重性,及早发现风险行为,并在重大弱点被广泛滥用之前进行修复。
第二次 Fable 5 越狱并不是一个简单的“彻底失败”故事。它表明,Anthropic 的分层防御似乎能够阻止大多数直接攻击,但有决心的红队人员仍然可以凭借足够的时间、迭代和创造力找到狭窄的漏洞。
更深层的问题在于,AI 安全并不只是阻止关键词。它必须在不同语言、长上下文、模糊的网络安全任务以及对抗性框架中理解意图。这比构建一个静态过滤器要困难得多。
Fable 5 的案例指向了前沿 AI 安全的未来:更强的分类器、公开披露渠道、更好的多语言评估,以及共享的严重性框架。
教训很清楚:前沿模型可以变得更难被越狱,但“完全密封”的 AI 仍然是一个尚未解决的问题。
从一句话开始,几分钟内拿到完整网站。



