For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/claude-haiku-5-vs-gpt-6-luna-benchmarks-p-ec36c306.md.
Anthropic 已发布 **Claude Haiku 5.5**,这并不是一次常规的小模型更新。

Anthropic 已发布 Claude Haiku 5.5,这并不是一次常规的小模型更新。
新版本 Haiku 在计算机使用、编程、专业工作和工具密集型智能体任务方面远超 Haiku 4.5,同时大幅降低了其官方 API 价格。
根据 Anthropic 自己的发布对比,Haiku 5.5 在多个基准测试项目上也超过了 GPT-6 Luna,包括 GDPval-AA v2.1、OSWorld 2.1、Terminal-Bench 4.0、FrontierCode 1.1 和 Chartography。
这使 Haiku 5.5 成为以下高频工作负载的一项重要新选择:
但此次发布也伴随着一些重要注意事项。
定价会在 10 万提示词 token 的边界发生变化;分词器会让相同文本产生更多 token;升级现有 Haiku 4.5 集成还需要进行多项 API 变更。
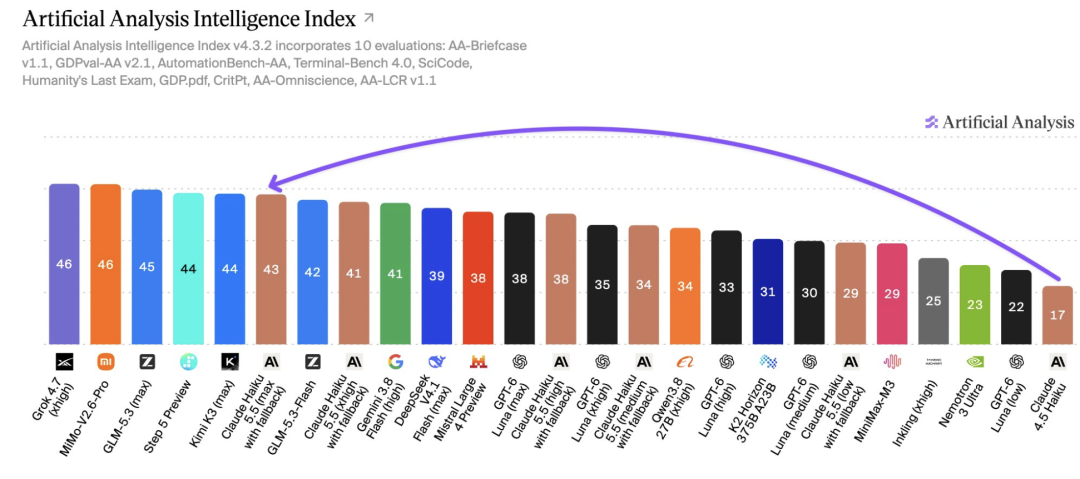
Anthropic 将 Haiku 5.5 定位为迄今为止最便宜、最快且能力最强的小模型。
官方基准测试表明确显示了其目标竞争对手:GPT-6 Luna 被直接列在 Haiku 5.5 旁边。
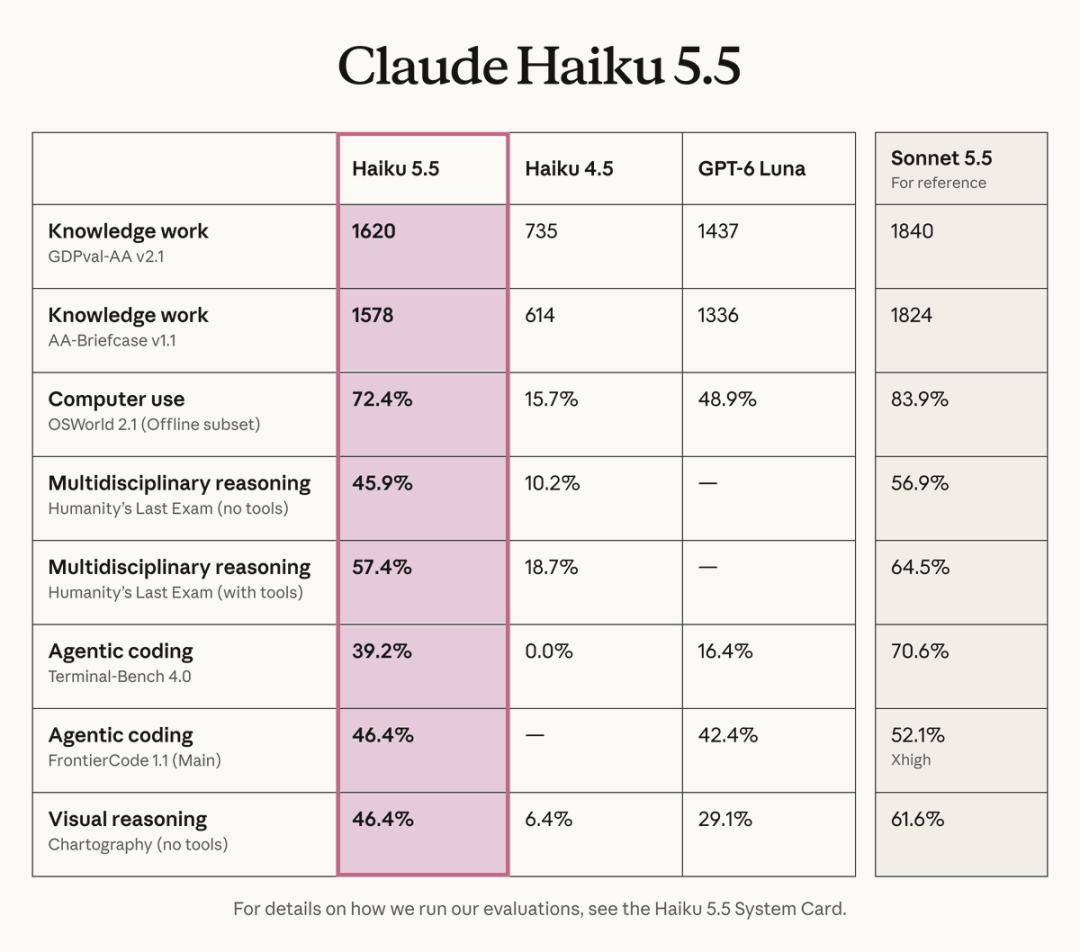
此次发布的结果包括:
| 基准测试 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1,离线子集 | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity’s Last Exam,无工具 | 45.9% | 10.2% | — | 56.9% |
| Humanity’s Last Exam,使用工具 | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1(Main) | 46.4% | — | 42.4% | 52.1% |
| Chartography,无工具 | 46.4% | 6.4% | 29.1% | 61.6% |
关键结论并不是 Haiku 5.5 突然取代了所有更大型号。
真正的变化在于,Claude 最小的模型层级如今已经能够更好地完成过去通常需要大型号才能处理的任务。
对于不超过 10 万 token 的提示词,Anthropic 的收费如下:
Haiku 5.5 输入:  $0.10 / 100 万 token
Haiku 5.5 输出:  $0.50 / 100 万 token
缓存读取:        $0.01 / 100 万 token
缓存写入:        $0.125 / 100 万 token
OpenAI 目前的 GPT-6 Luna 标准定价为:
GPT-6 Luna 输入:        $0.10 / 100 万 token
GPT-6 Luna 缓存输入:    $0.01 / 100 万 token
GPT-6 Luna 缓存写入:    $0.125 / 100 万 token
GPT-6 Luna 输出:        $0.50 / 100 万 token
因此,对于短上下文的标准 API 工作,两款模型在官方 token 价格上几乎完全一致。
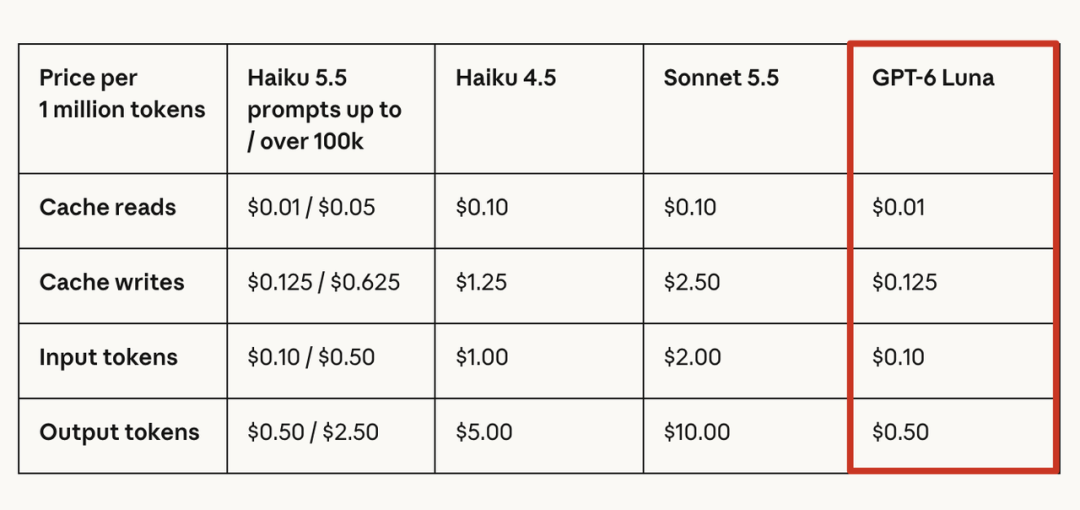
Haiku 5.5 使用两档定价。
| Token 类型 | 提示词 ≤100K | 提示词 >100K |
|---|---|---|
| 缓存读取 | $0.01/M | $0.05/M |
| 缓存写入 | $0.125/M | $0.625/M |
| 输入 | $0.10/M | $0.50/M |
| 输出 | $0.50/M | $2.50/M |
Anthropic 表示,不超过 10 万 token 的提示词约占 Haiku 4.5 请求量的 90%,因此较低价格档位能够覆盖预计流量中的大多数请求。
对于超过 10 万 token 的提示词,Haiku 5.5 仍然比 Haiku 4.5 便宜,但折扣幅度会缩小。
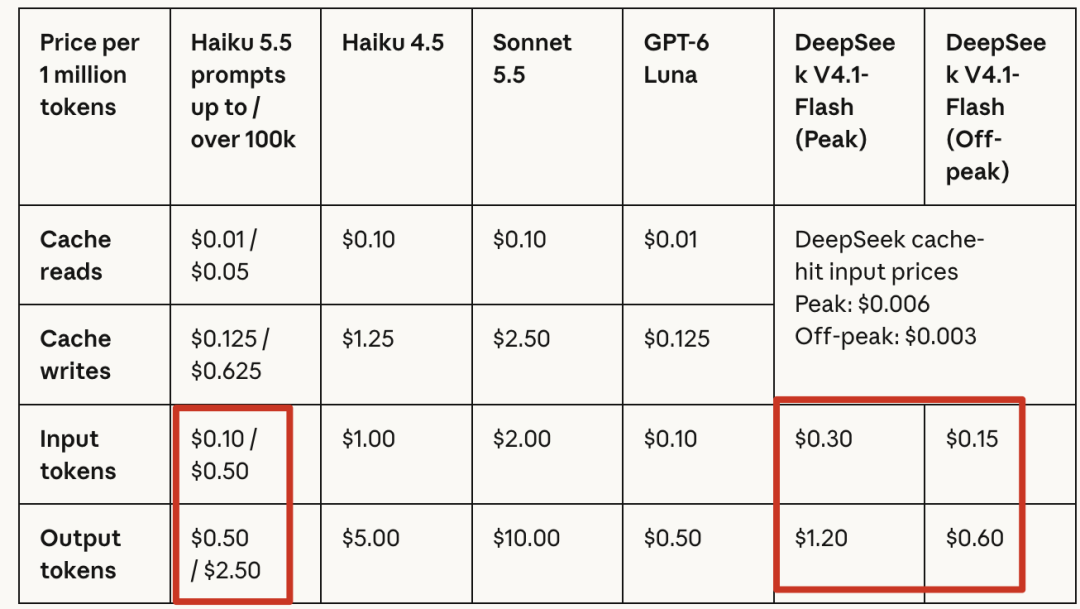
原文将 Haiku 5.5 与 DeepSeek-V4.1-Flash 进行了比较。
DeepSeek 当前的官方定价采用高峰期和非高峰期两种费率。
对于未命中缓存的输入和输出:
| 模型 | 输入 / 100 万 | 输出 / 100 万 |
|---|---|---|
| Haiku 5.5,≤100K 提示词 | $0.10 | $0.50 |
| DeepSeek-V4.1-Flash,非高峰期 | $0.15 | $0.60 |
| DeepSeek-V4.1-Flash,高峰期 | $0.30 | $1.20 |
DeepSeek 在命中缓存的输入价格方面仍然更便宜,尤其是在非高峰期,因此总成本仍取决于工作负载的结构。
上一代 Haiku 在高要求的计算机使用任务上并不具备竞争力。
Haiku 5.5 大幅改变了这一点。
在 OSWorld 2.1 离线子集测试中,Anthropic 的结果从 Haiku 4.5 的 15.7% 提升到了 Haiku 5.5 在最高工作强度下的 72.4%。
原文还进行了实际测试:让 Haiku 5.5 将 GPT-6 和 DeepSeek 的定价数据添加到 Haiku 发布页面的表格中。
模型没有通过用户界面手动编辑单个 HTML 元素,而是打开浏览器控制台,并通过脚本注入修改内容。
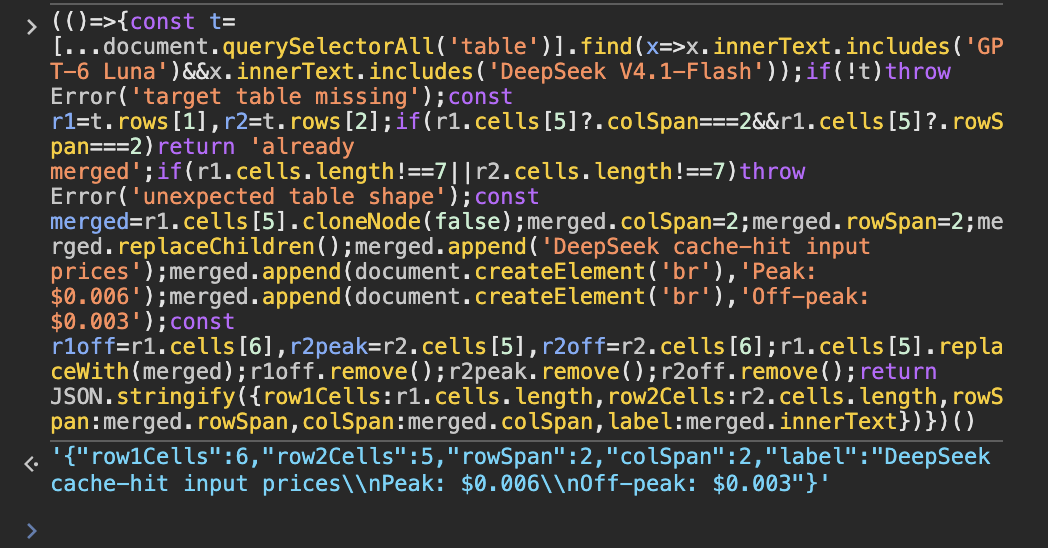
这种行为很有用,因为计算机使用智能体并不总是需要完全模仿人类的鼠标移动。
如果浏览器环境提供了更直接的执行路径,使用脚本可能比逐个单元格点击更快、更可靠。
Haiku 5.5 是 Haiku 系列中第一款支持可调节工作强度的模型。
该模型支持从低成本、快速响应到更高成本、更审慎推理的一系列模式。
Anthropic 发布的图表展示了 OSWorld 测试中清晰的准确率与成本曲线。
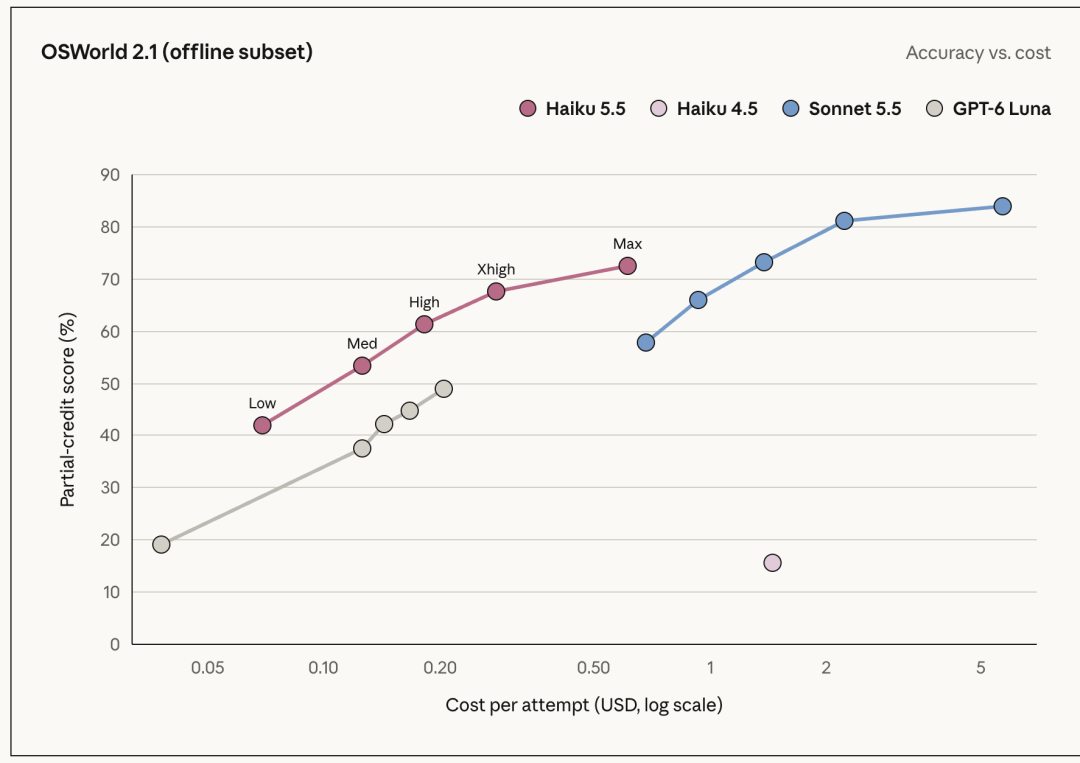
原文重点指出了这条曲线上的两个结果:
生产任务的确切成本会随提示词长度、输出长度、缓存和工具使用情况而变化,但总体趋势很重要。
现在,你可以根据任务本身调整 Haiku,而不必再把“小模型”视为一个固定的能力等级。
GDPval-AA v2.1 衡量 44 个职业中的真实专业工作表现。
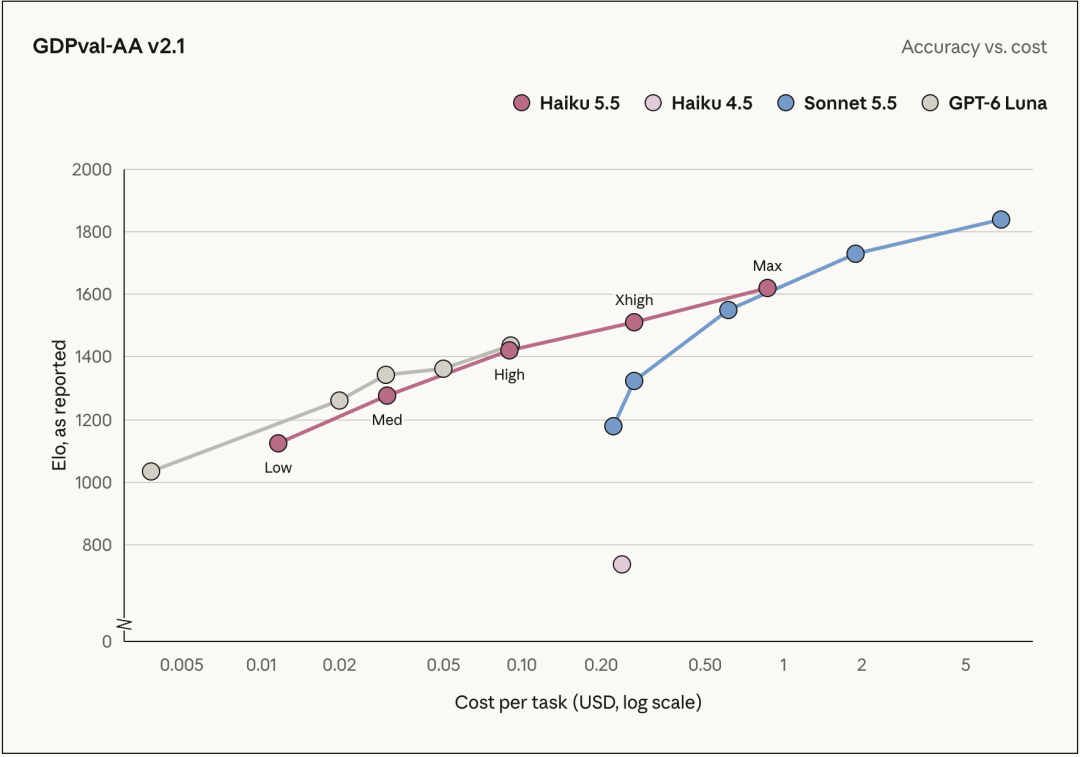
Anthropic 报告称,在最高工作强度下,Haiku 5.5 的 Elo 得分为 1620,而 Haiku 4.5 为 735。
同样,Sonnet 5.5 仍然更强,但“小模型”与“适用于专业工作的模型”之间的差距已经明显缩小。
Haiku 5.5 引入了与新一代 Claude 共享的新分词器。
这很重要,因为相同文本在 Haiku 4.5 和 Haiku 5.5 上并不会产生相同数量的 token。
Anthropic 的迁移指南表示,相同输入文本在 Haiku 5.5 上产生的 token 数量约比 Haiku 4.5 多 30%,但具体增幅取决于内容。
不同工作负载的影响可能更大或更小,其中代码、表格和非英语文本尤其值得重新测量。
这意味着以下比较过于简单:
旧输入价格:$1.00
新输入价格:$0.10
因此每项任务都正好便宜 90%
更合理的计算方式是:
实际任务成本
= 新 token 数量
× 新 token 价格
+ 缓存成本
+ 输出成本
+ 工具成本
Anthropic 自己表示,在考虑分词器变化后,Haiku 5.5 平均比 Haiku 4.5 便宜约 75%,而不是每项任务都统一降低 90%。
Artificial Analysis 也展示了为什么在比较低价模型时,token 效率很重要。
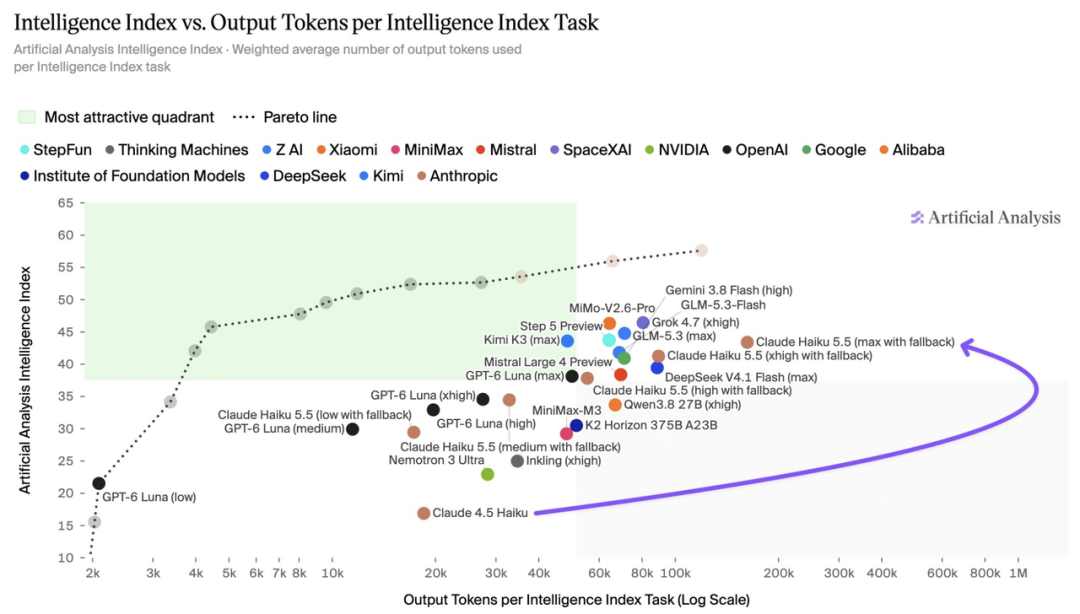
某个模型的 token 价格可能很低,但它也可能需要生成更多输出 token 才能完成任务。
对于生产系统而言,每个已完成任务的成本比单纯的每百万 token 价格更有参考价值。
原文清楚地指出了这一点:“小杯子”仍然是小杯子。
Haiku 5.5 虽然比 Haiku 4.5 强大得多,但复杂的自主编程仍然是大型号更适合的任务。
Terminal-Bench 4.0 展示了两者之间的差距:
Haiku 5.5:  39.2%
Sonnet 5.5:70.6%
Anthropic 明确建议,对于复杂的智能体编程任务,应使用 Sonnet 5.5 或 Opus 5.5。
Haiku 5.5 更适合以下已经明确界定的任务:
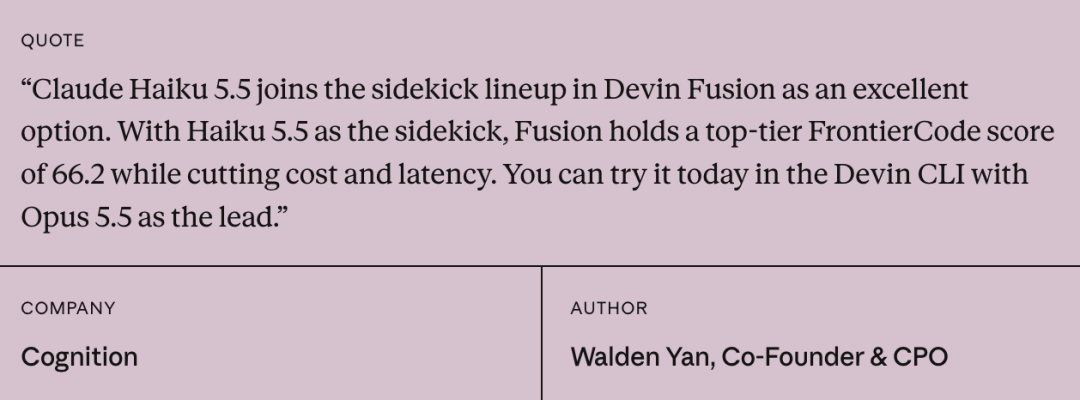
Cognition 已经在 Devin Fusion 中采用了这种结构。
发布页面表示,Opus 5.5 可以担任主模型,而 Haiku 5.5 作为辅助模型工作。
在 Cognition 报告的配置中,这种组合取得了 66.2 的 FrontierCode 得分,同时降低了成本和延迟。
其模式很直接:
Opus / Sonnet
→ 规划、任务拆解、困难判断

Haiku 5.5
→ 窄范围子任务、并行执行、快速查询、摘要
相比试图在所有场景中取代大型号,这可能是使用 Haiku 5.5 更现实的方式。
如果应用已经在使用 Haiku 4.5,Anthropic 警告称,多项变化可能导致现有请求失效。
官方模型 ID 现在是:
claude-haiku-5-5
但迁移还需要满足若干其他要求。
像下面这样的 Haiku 4.5 请求不再有效:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
Haiku 5.5 改用自适应思考和工作强度控制:
{
  "thinking": {
    "type": "adaptive"
  },
  "output_config": {
    "effort": "medium"
  }
}
如果请求仍然发送旧的 budget_tokens 格式,将返回 400 错误。
自适应思考默认也处于启用状态,因此应用不应假设响应内容块的第一个元素始终是普通回答文本。
请根据 type 解析内容块。
max_tokens由于新分词器会将相同文本计算为更多 token,旧的 max_tokens 值可能无法为等量输出留下足够空间。
思考 token 也会计入输出预算。
请使用 claude-haiku-5-5 重新计算提示词,而不是继续沿用 Haiku 4.5 的 token 估算值。
Haiku 5.5 不再像 Haiku 4.5 那样支持任意采样设置。
Anthropic 建议省略:
temperature
top_p
top_k
非默认值可能导致 400 错误,且不接受 top_k。
如果应用过去使用采样参数实现创意变化,应将这类控制迁移到提示词或其他应用层策略中。
Haiku 4.5 在某些配置下可以从最终的 assistant 消息继续生成。
Haiku 5.5 会拒绝助手预填充。
如果过去曾使用如下前缀来强制输出 JSON:
{"result":
请改用结构化输出或工具模式。
对于 Claude API 和 Google Cloud 集成,旧的计算机使用声明:
computer_20250124
必须更新为:
computer_toolset_20260801
新工具集拥有不同的事件结构,因此智能体循环必须正确分发返回的工具使用块,并在结果中保留 toolset_name。
Haiku 5.5 还支持 Anthropic 的浏览器使用工具集,可在受支持的平台上执行网页任务。
在部署 Haiku 5.5 之前,至少检查以下事项:
claude-haiku-5-5。budget_tokens。type 解析内容块,不要假设第 0 个内容块就是回答文本。computer_toolset_20260801。refusal 停止原因。Anthropic 还提供了一个自动化的 Claude Code 迁移命令:
/claude-api migrate this project to claude-haiku-5-5
该工具可以修改模型 ID,并检测若干不兼容的请求模式,但仍建议进行人工验证。
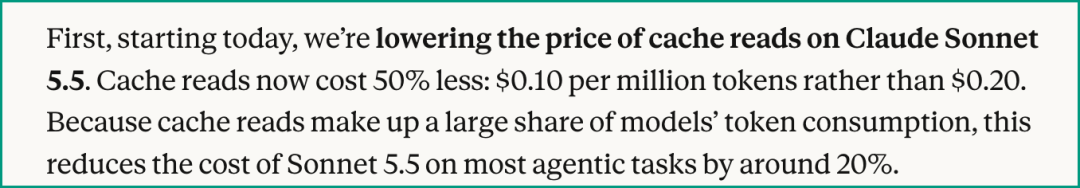
Haiku 5.5 并不是 Anthropic 宣布的唯一一项定价变化。
Sonnet 5.5 的缓存读取价格从:
$0.20 / 100 万 token
降至:
$0.10 / 100 万 token
Anthropic 表示,在许多智能体工作流中,缓存读取占 token 消耗的很大一部分,因此这一变化使大多数 Sonnet 5.5 智能体任务的成本降低约 20%。
这使混合模型架构更具吸引力:
Sonnet 5.5
→ 规划和更困难的执行任务

Haiku 5.5
→ 低成本、高频的子任务
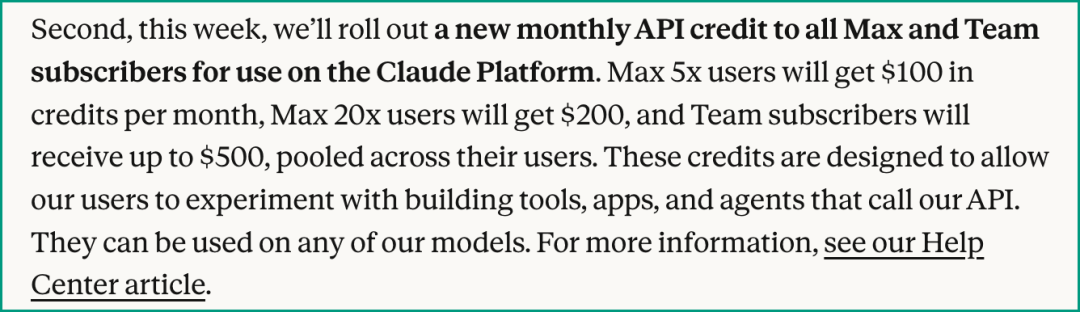
Anthropic 还为符合条件的 Max 和 Team 订阅者推出了每月 Claude Platform 积分。
当前官方积分额度如下:
| 方案 | 每月 API 积分 |
|---|---|
| Max 5x | $100 |
| Max 20x | $200 |
| Team Standard 席位 | 每个席位 $20 |
| Team Premium 席位 | 每个席位 $100 |
| Team 共享池上限 | $500 |
这些积分可以用于 Claude Platform 工作负载,例如:
这些积分不会提高用户的 Claude 或 Claude Code 订阅使用额度,也不覆盖通过订阅方案计费的普通交互式 Claude Code 会话。
积分与一个 Claude Console 组织绑定,且不会无限期结转。
原文最后进行了一个较轻松的对比。
Anthropic 宣布更便宜的模型、更低的 Sonnet 缓存读取价格和每月 API 积分时,OpenAI 的 Codex 与 ChatGPT Work 负责人 Thibault Sottiaux 宣布,付费账户又获得了一次 可存储的重置额度,同时庆祝 Codex 和 ChatGPT Work 的活跃用户总数达到 4000 万。
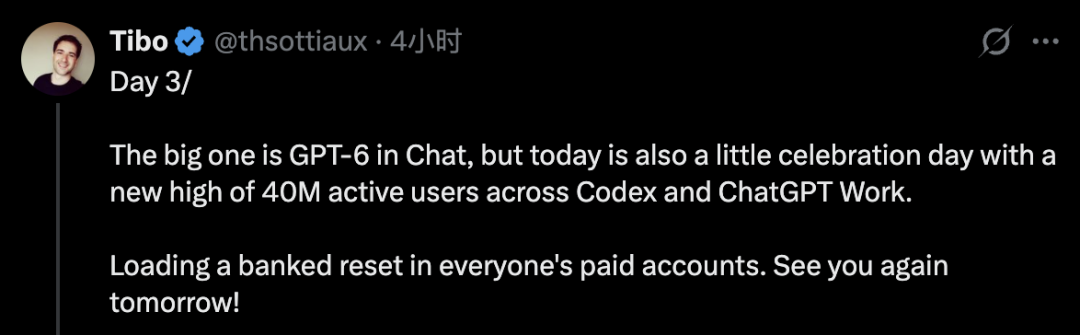
可存储的重置额度不同于永久性降价。
它是符合条件的用户可以保存并兑换的额外使用重置额度,并不意味着模型持续 token 价格发生变化。
因此,这种比较更多是修辞层面的,而不是技术层面的:
Anthropic 发布:
新小模型 + 更低缓存价格 + 每月 API 积分

OpenAI 更新:
付费 Codex / Work 账户获得额外可存储使用重置额度
两者都试图为高频用户提供更多试验空间,但采用的是不同机制。
此次发布让 Haiku 的实用性大幅提升,但它的理想定位仍然相对清晰。
Haiku 5.5 适合用于:
以下任务更适合使用更大型的 Claude 模型:
最便宜的模型并不总是完成任务成本最低的方式。
对于生产系统,应衡量:
每个成功任务的成本
=
输入 + 缓存 + 输出 + 工具使用 + 重试 + 失败
这一指标比模型官方标示的输入价格更有参考价值。
Claude Haiku 5.5 是 Anthropic 最新的小型 Claude 模型,面向高频、成本敏感和延迟敏感型工作负载推出。它也是第一款支持可调节工作强度的 Haiku 模型,在编程、计算机使用和专业工作评测方面明显强于 Haiku 4.5。
对于不超过 10 万 token 的提示词,输入价格为每百万 token 0.10 美元,输出价格为每百万 token 0.50 美元。对于超过 10 万 token 的提示词,价格上升至每百万 token 输入 0.50 美元、输出 2.50 美元,缓存读取和缓存写入另行计费。
对于标准短上下文 token 定价,两者的官方输入、缓存输入、缓存写入和输出价格基本一致。Haiku 5.5 在提示词超过 10 万 token 后会提高价格,因此长上下文工作负载应单独比较。
不会。Anthropic 自己的 Terminal-Bench 4.0 结果显示,Sonnet 5.5 的得分为 70.6%,Haiku 5.5 为 39.2%。Haiku 更适合范围明确、可重复、高频的任务和子智能体工作,而 Sonnet 和 Opus 仍然更适合复杂的自主编程。
Haiku 5.5 使用了新的分词器。Anthropic 的迁移指南表示,相同文本在 Haiku 5.5 上平均会产生约多 30% 的 token,但具体增幅取决于内容。
需要。重要变化包括:用自适应思考替代手动设置的 budget_tokens、调整采样参数行为、移除助手预填充、使用新的计算机使用工具集,以及根据 type 解析响应内容块。Anthropic 提供了官方迁移指南和 Claude Code 迁移命令。
在 Claude API 中,模型 ID 是 claude-haiku-5-5。Anthropic 也为 Amazon Bedrock、Google Cloud、Microsoft Foundry 以及 AWS 上的 Claude Platform 记录了对应的模型 ID。
符合条件的 Max 和 Team 订阅者可以领取每月 Claude Platform 积分。Max 5x 可获得 100 美元,Max 20x 可获得 200 美元;Team 积分则根据席位类型计算,每月共享池上限为 500 美元。
Claude Haiku 5.5 是 Anthropic 小模型层级的一次重大升级。在计算机使用、专业工作、编程和推理方面,它大幅超过 Haiku 4.5;同时,在短上下文官方 API 定价方面与 GPT-6 Luna 持平,并在 Anthropic 发布的多项基准测试对比中超过 Luna。
更低的价格确实存在,但生产团队不应忽视新的分词器和 10 万 token 提示词定价边界。相同文本消耗的 token 可能比 Haiku 4.5 多约 30%,而长提示词会进入更高的价格档位。
迁移还包含真正的破坏性变更:自适应思考取代手动思考预算,自定义采样控制受到限制,助手预填充被移除,计算机使用集成需要采用新工具集。现有 Haiku 4.5 应用应遵循迁移指南,而不是只修改模型名称。
Haiku 5.5 最适合被理解为一款面向规模化任务和子智能体的快速、低成本执行模型,而不是取代 Sonnet 或 Opus 处理复杂长期任务的通用方案。
从一句话开始,几分钟内拿到完整网站。



