Anthropic表示,Claude目前主导其26%的AI研发工作,其中超过90%的工作已达到人机协作或更高水平。本指南解释六级自动化框架、3万名内部智能体、十亿级监控、超过80%的代码合并比例,以及Anthropic为何表示真正的递归式自我改进尚未到来。
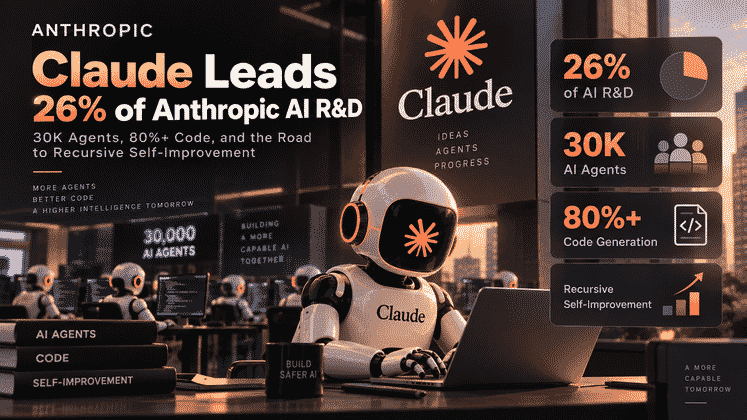
Anthropic发布了迄今为止最清晰的内部数据之一,展示人工智能已经在多大程度上参与构建下一代人工智能。
截至2026年8月,Anthropic表示,Claude目前主导公司26%的AI研发工作。2026年早些时候,这一指标还低于1%。
这个 headline 数字非常引人注目,但也很容易被误读。
“Claude主导26%的研发工作”并不意味着Claude在没有人类参与的情况下独立运行了公司四分之一的研发工作。Anthropic采用了六级自动化框架,而26%这一数字特指被评为AL4——AI主导的工作:人类提供高层级目标,Claude端到端完成大部分任务,而人类仍然负责监督和批准。
Anthropic还表示,其测量的AI研发工作中,超过90%至少已经达到AL3——AI协作水平。
与此同时,该公司正在运行规模非常庞大的内部智能体基础设施。8月,Anthropic使用最多的内部平台上,随时约有3万名智能体在执行研究和工程工作;Anthropic还分析了当月超过10亿次智能体决策。
这些数据有助于解释,为什么“AI构建AI”的讨论已经从理论走向了可测量的现实。
这些数据也说明了最后一个限定条件为什么如此重要:
Anthropic表示,所测量的工作中没有任何一项达到完全自主的AL5水平。
该公司正在更深入地采用AI辅助和AI主导的研发方式,但并未声称Claude已经能够在没有人类监督的情况下,独立设计、训练、评估并替代自身。
Anthropic构建了一个原型研发自动化指数,用于追踪其AI研究与开发工作中有多少由Claude完成。
公司首先梳理模型研发涉及的工作类型,然后为每个类别分配自动化等级。这一量表源自Epoch AI的研究,范围从AL0到AL5。
| 等级 | 标签 | 实际含义 |
|---|---|---|
| AL0 | 未使用 | AI没有实质性参与该任务。 |
| AL1 | 边缘参与 | AI可能偶尔协助查找资料、头脑风暴或润色,但不会改变工作的完成方式。 |
| AL2 | 辅助 | AI能够显著加快任务的部分环节,但人类仍然主导并审查工作。 |
| AL3 | 协作 | AI在人类密切指导下处理大块工作;人类仍然做出关键决策并整合结果。 |
| AL4 | 主导 | AI根据高层级请求端到端完成大部分任务,人类负责监督、纠偏和批准。 |
| AL5 | 自主 | AI几乎不需要或完全不需要人类参与,端到端完成工作。 |
AL3和AL4之间的差异尤其重要。
在AL3水平下,人类仍然深度参与。他们可能提供日志、提出假设、回答问题,并在出现意外情况时决定下一步行动。
在AL4水平下,人类可以交付一个高层级目标,让Claude处理大部分执行工作。人员仍然会监督任务,但不需要持续引导每一个步骤。
Anthropic报告了三项核心发现:
| 测量指标 | Anthropic报告的结果 |
|---|---|
| Claude以AL4“主导”方式完成的AI研发工作 | 26% |
| 达到AL3“协作”或更高水平的AI研发工作 | 超过90% |
| 达到AL5“自主”水平的AI研发工作 | 所测子集的0% |
因此,26%这一数字最好理解为:
人类设定高层级目标
        ↓
Claude处理大部分工作流程
        ↓
人类进行监督并批准
而不是:
Claude独立选择研究方向,
构建自己的继任模型、验证该模型,并在没有人类参与的情况下部署它
这一差异是Anthropic对递归式自我改进定义的核心。
Anthropic并不是简单询问员工使用Claude的程度,然后得出26%这一数字。
根据其公开的方法说明,公司从参与模型研发闭环的团队中抽取工作记录,并基于2026年7月的数据,自下而上建立了一个约包含1.5万个细分任务的清单。
随后,Claude协助将这些任务整理成一个层级结构,其中包括:
对于每个类别,一个研究智能体会考察任务的实际执行方式,以及AI处理了整个流程的多少内容。随后,一个独立的Claude评审模型会分配自动化等级。
Anthropic还要求相关工作领域的人类负责人分别对自动化程度进行评级。
公司表示,模型和人类在59%的情况下给出了完全相同的评级,在97%的情况下评级差距不超过一个自动化等级。
这是有参考价值的证据,但并不是完美的测量结果。
Anthropic明确指出,临界案例仍然带有主观性,而且其评审模型可能与被评估的系统存在部分相同的错误。
原始文章还重点介绍了Anthropic内部智能体基础设施的规模。
Anthropic表示,截至2026年8月,其使用最多的内部平台上,随时约有3万名智能体在执行研究和工程工作。
这里的措辞很重要:这不是3万名类似人类的长期员工,也不一定代表Anthropic内部任何地方使用的全部AI智能体。
这个数字指的是该测量覆盖的内部平台上,在任意时刻处于活跃状态的智能体数量。
这些智能体可以半自主地长时间工作,也可以相互委派任务。
Anthropic表示,其内部脚手架为智能体分配独立身份,并使用开放式消息系统,让智能体能够看到彼此的主张、链接回原始证据,并纠正错误,而不是沿着信息链条盲目传递内容。
当数以万计的智能体并行工作时,监督就会变成一个系统性问题。
Anthropic表示,它分析了2026年8月研发智能体和工程智能体做出的超过10亿次决策。
在被测内部平台上,每个操作在执行前都要经过在线监控器。
在线监控器可以:
Anthropic表示,在超过10亿次决策中,有0.002%被阻止,约为每4.7万次中阻止1次。
这一较低比例不应被自动解读为“智能体有99.998%的时间是安全的”。阻止率只是一个测量指标。它取决于监控器能够检测到什么、行为如何被分类,以及风险操作本身出现的类型。
Anthropic自己也指出,在这一规模下,很难确定每一种重要行为是否都能被监控系统观察到。
Anthropic描述了两层监控机制。
在线监控器会在操作执行前检查行为。
它们的任务是阻止可能造成即时且难以逆转损害的行为,例如智能体试图将敏感的模型资产移出授权系统。
Anthropic表示,被测平台上的100%智能体操作都会经过这一层。
离线监控会在行为发生后检查智能体活动。
它的目标是捕捉那些可能缓慢发展、而不是立即造成损害的行为模式。
Anthropic表示,离线系统每周会标记约10万份对话记录,交由分类器进一步审查。
大多数记录会自动处理,但其中优先级最高的案例——每周约50起——会升级给人类审查人员。
因此,这一架构更接近:
智能体提出操作
        ↓
在线监控器检查操作
        ↓
操作执行,或被阻止/重定向
        ↓
活动被记录
        ↓
离线监控检查行为模式
        ↓
优先级最高的案例交由人类审查人员处理
这一监控体系是Anthropic公告中最重要的部分之一,因为只有当组织仍然能够理解并干预智能体的行为时,更高程度的自动化才真正有用。
AIBase文章中的第二个重点,是Anthropic目前有多少代码由Claude编写。
这里需要准确说明日期。
Anthropic官方发布的《当AI构建自身》报告表示,截至2026年5月,Anthropic代码库中合并的代码有超过80%由Claude编写。
Anthropic表示,在2025年2月Claude Code进入研究预览之前,这一比例还处于个位数的较低水平。
在一年多的时间里,这发生了非常显著的变化。
这两个数字衡量的是不同内容。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
| 指标 | 日期 | 衡量内容 |
|---|---|---|
| 超过80% | 2026年5月 | Anthropic合并代码中由Claude编写的比例 |
| 26% | 2026年8月 | 被评为AL4“AI主导”的加权AI研发工作比例 |
| 超过90% | 2026年8月 | 达到AL3“协作”或更高水平的加权AI研发工作比例 |
软件代码只是模型研发的一部分。
AI研究还涉及:
因此,Claude可以编写80%的合并代码,但整体AI研发工作中只有26%被归类为AI主导。
Anthropic还表示,2026年第二季度,典型工程师每天合并的代码量约为2024年的8倍。
公司立即补充了一个重要限定条件:代码行数是一个不完善的生产力指标。
代码量增加并不自动意味着价值增加了八倍。
一次大型变更可能包括:
不过,Anthropic认为,这种变化幅度足以说明工程吞吐量确实得到了加速。
这一趋势尤其值得注意,因为从2021年到2024年,产出总体保持相对稳定;而在Claude开始运行代码,而不只是建议供人类粘贴的代码片段之后,产出才开始上升。
原始文章将Claude的工作归纳为模型实验、编码、数据分析和结果验证。
Anthropic自身发布的内容也支持这样一个更广泛的判断:Claude越来越多地参与模型开发闭环中的各种任务。
这些任务可能包括:
这正是人们将这一趋势描述为“AI帮助构建更好的AI”的原因。
但“参与继任模型的开发”和“完全自主地创建继任模型”之间存在重要差异。
按照Anthropic自己的定义,还没有。
Anthropic将递归式自我改进描述为:模型能够完全自主地构建自己的继任模型。
8月的自动化数据明确表示,所测量的AI研发子集中没有任何一项达到AL5。
因此,目前最准确的表述是:
Claude正在实质性加速产生未来Claude模型的研发流程,但Anthropic并未声称Claude已经能够自主运行整个继任模型开发闭环。
这一差异很重要,因为“递归式自我改进”这一短语经常被宽泛地使用。
人们至少可能指代以下三个不同阶段:
阶段1
AI协助构建下一代模型的人类

阶段2
AI在人类监督下主导研发工作流中的大部分环节

阶段3
AI自主设计、构建、评估并改进自己的继任模型
Anthropic公开的数据有力支持这样一个判断:越来越多的工作已经达到阶段2。
但这些数据并没有显示阶段3已经到来。
Anthropic表示,测量这些数据的目的并不只是宣传生产力。
公司认为,如果前沿模型开始加速自身开发,公众和政府就需要能够持续追踪的指标。
其提出的指标主要关注三件事:
Anthropic表示,这类指标最终可能得到独立验证,并被用作启动更严格安全要求的触发信号。
例如,如果AI主导的研发比例快速上升,实验室可能需要采用更长的测试周期,或在允许新模型继续参与研发之前进行更严格的外部评估。
这一点超出了AIBase文章的简短内容,但它来自同一份Anthropic测量报告,有助于解释公司的整体框架。
在2026年7月为期一周的快照中,Anthropic表示:
Anthropic称这些是偏保守的估计,并指出,将安全研究与能力研究分类本身就存在困难。
因此,这些数字应被视为一个时间点的快照,而不是普遍适用或永久不变的比例。
Anthropic对其方法论的局限说明得相当明确。
重要限定条件包括:
这些局限并不意味着数据毫无意义。
它们意味着,在解读这些数据时,最好将其视为趋势指标,而不是证明自主性的绝对证据。
这意味着Anthropic加权AI研发工作中有26%目前被评为AL4,即Claude可以根据高层级请求端到端完成大部分任务。人类仍然会监督、审查和批准工作,因此这并不是完全自主的研究。
AL4意味着AI主导任务的大部分环节,同时人类仍然负责监督和批准。AL5意味着工作几乎不需要或完全不需要人类参与即可端到端完成;Anthropic表示,其测量的AI研发工作中没有任何一项达到AL5。
Anthropic报告称,截至2026年5月,其代码库中合并的代码有超过80%由Claude编写。这一指标指的是合并代码,并不代表所有研究、产品决策或模型开发工作的80%都由Claude完成。
Anthropic表示,截至2026年8月,其使用最多的内部平台上,随时约有3万名智能体在执行研究和工程工作。这个数字适用于被测量的内部平台,不应被理解为相当于3万名人类员工的数量。
公司在操作执行前采用在线监控,在操作发生后采用离线监控。Anthropic表示,被测平台上的100%操作都会经过在线监控器;离线系统则会标记对话记录,交由自动化系统和人类进一步审查。
Anthropic表示,2026年8月,其在线监控器阻止了超过10亿次智能体决策中的约0.002%,即大约每4.7万次阻止1次。这是一个监控统计数据,并不能证明每个未被阻止的决策都是安全或正确的。
按照Anthropic自己的定义,还没有。Anthropic将更强意义上的递归式自我改进定义为模型完全自主地构建自己的继任模型,而其当前数据表明,没有任何被测AI研发类别达到AL5自主水平。
Anthropic认为,公众、政府和独立评估机构需要了解前沿实验室自动化模型开发的速度。公司希望自动化程度、智能体监督和算力分配等指标能够成为可追踪的信号,并为未来的安全要求提供依据。
Anthropic最新的内部测量数据表明,AI主导的模型开发正在快速转变。截至2026年8月,Claude主导了26%的加权AI研发工作,超过90%的工作达到人机协作或更高水平,同时约有3万名智能体在Anthropic使用最多的内部研究平台上同时运行。
此外,Anthropic表示,截至2026年5月,其代码库中合并的代码有超过80%由Claude编写。这一数据有力表明,AI已经深度参与构建未来Claude模型所依赖的系统,但不应将其与更广义的研发自动化比例混为一谈。
最重要的是,Anthropic仍然报告称,没有任何被测AI研发类别达到AL5完全自主水平。公司显然正在走向更加由AI驱动的AI开发,但尚未宣布完全自主的递归式自我改进已经到来。
目前最清晰的信号并不是“Claude已经取代了Anthropic的研究人员”,而是研发工作的重心正在从人类借助AI完成工作,转向人类监督由AI日益主导的研发工作流。
从一句话开始,几分钟内拿到完整网站。