For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/claude-opentelemetry-tracing-api-and-sdk-4adbbb12.md.
Anthropic 已为 Claude Managed Agents、Messages API 和 Claude SDK 引入 OpenTelemetry 追踪导出功能。该功能于 2026 年 10 月 14 日宣布,目前处于公开测试阶段,可将标准追踪数据发送至接受 OTLP 的...
Anthropic 已为 Claude Managed Agents、Messages API 和 Claude SDK 引入 OpenTelemetry 追踪导出功能。该功能于 2026 年 10 月 14 日宣布,目前处于公开测试阶段,可将标准追踪数据发送至接受 OTLP 的可观测性平台。
其目标很实际:将智能体的模型调用和工具活动与调用它的应用程序一并追踪。团队无需在不同位置分别排查延迟、故障和 Token 用量,而可以在既有的可观测性系统中查看相关 span。
**追踪(trace)**会记录一个请求在系统中的路径。**跨度(span)**会记录该路径中的一次操作,例如模型调用或工具执行。Claude 的 span 遵循 OpenTelemetry 的 GenAI 语义约定,这有助于兼容工具跨模型提供商解读数据。
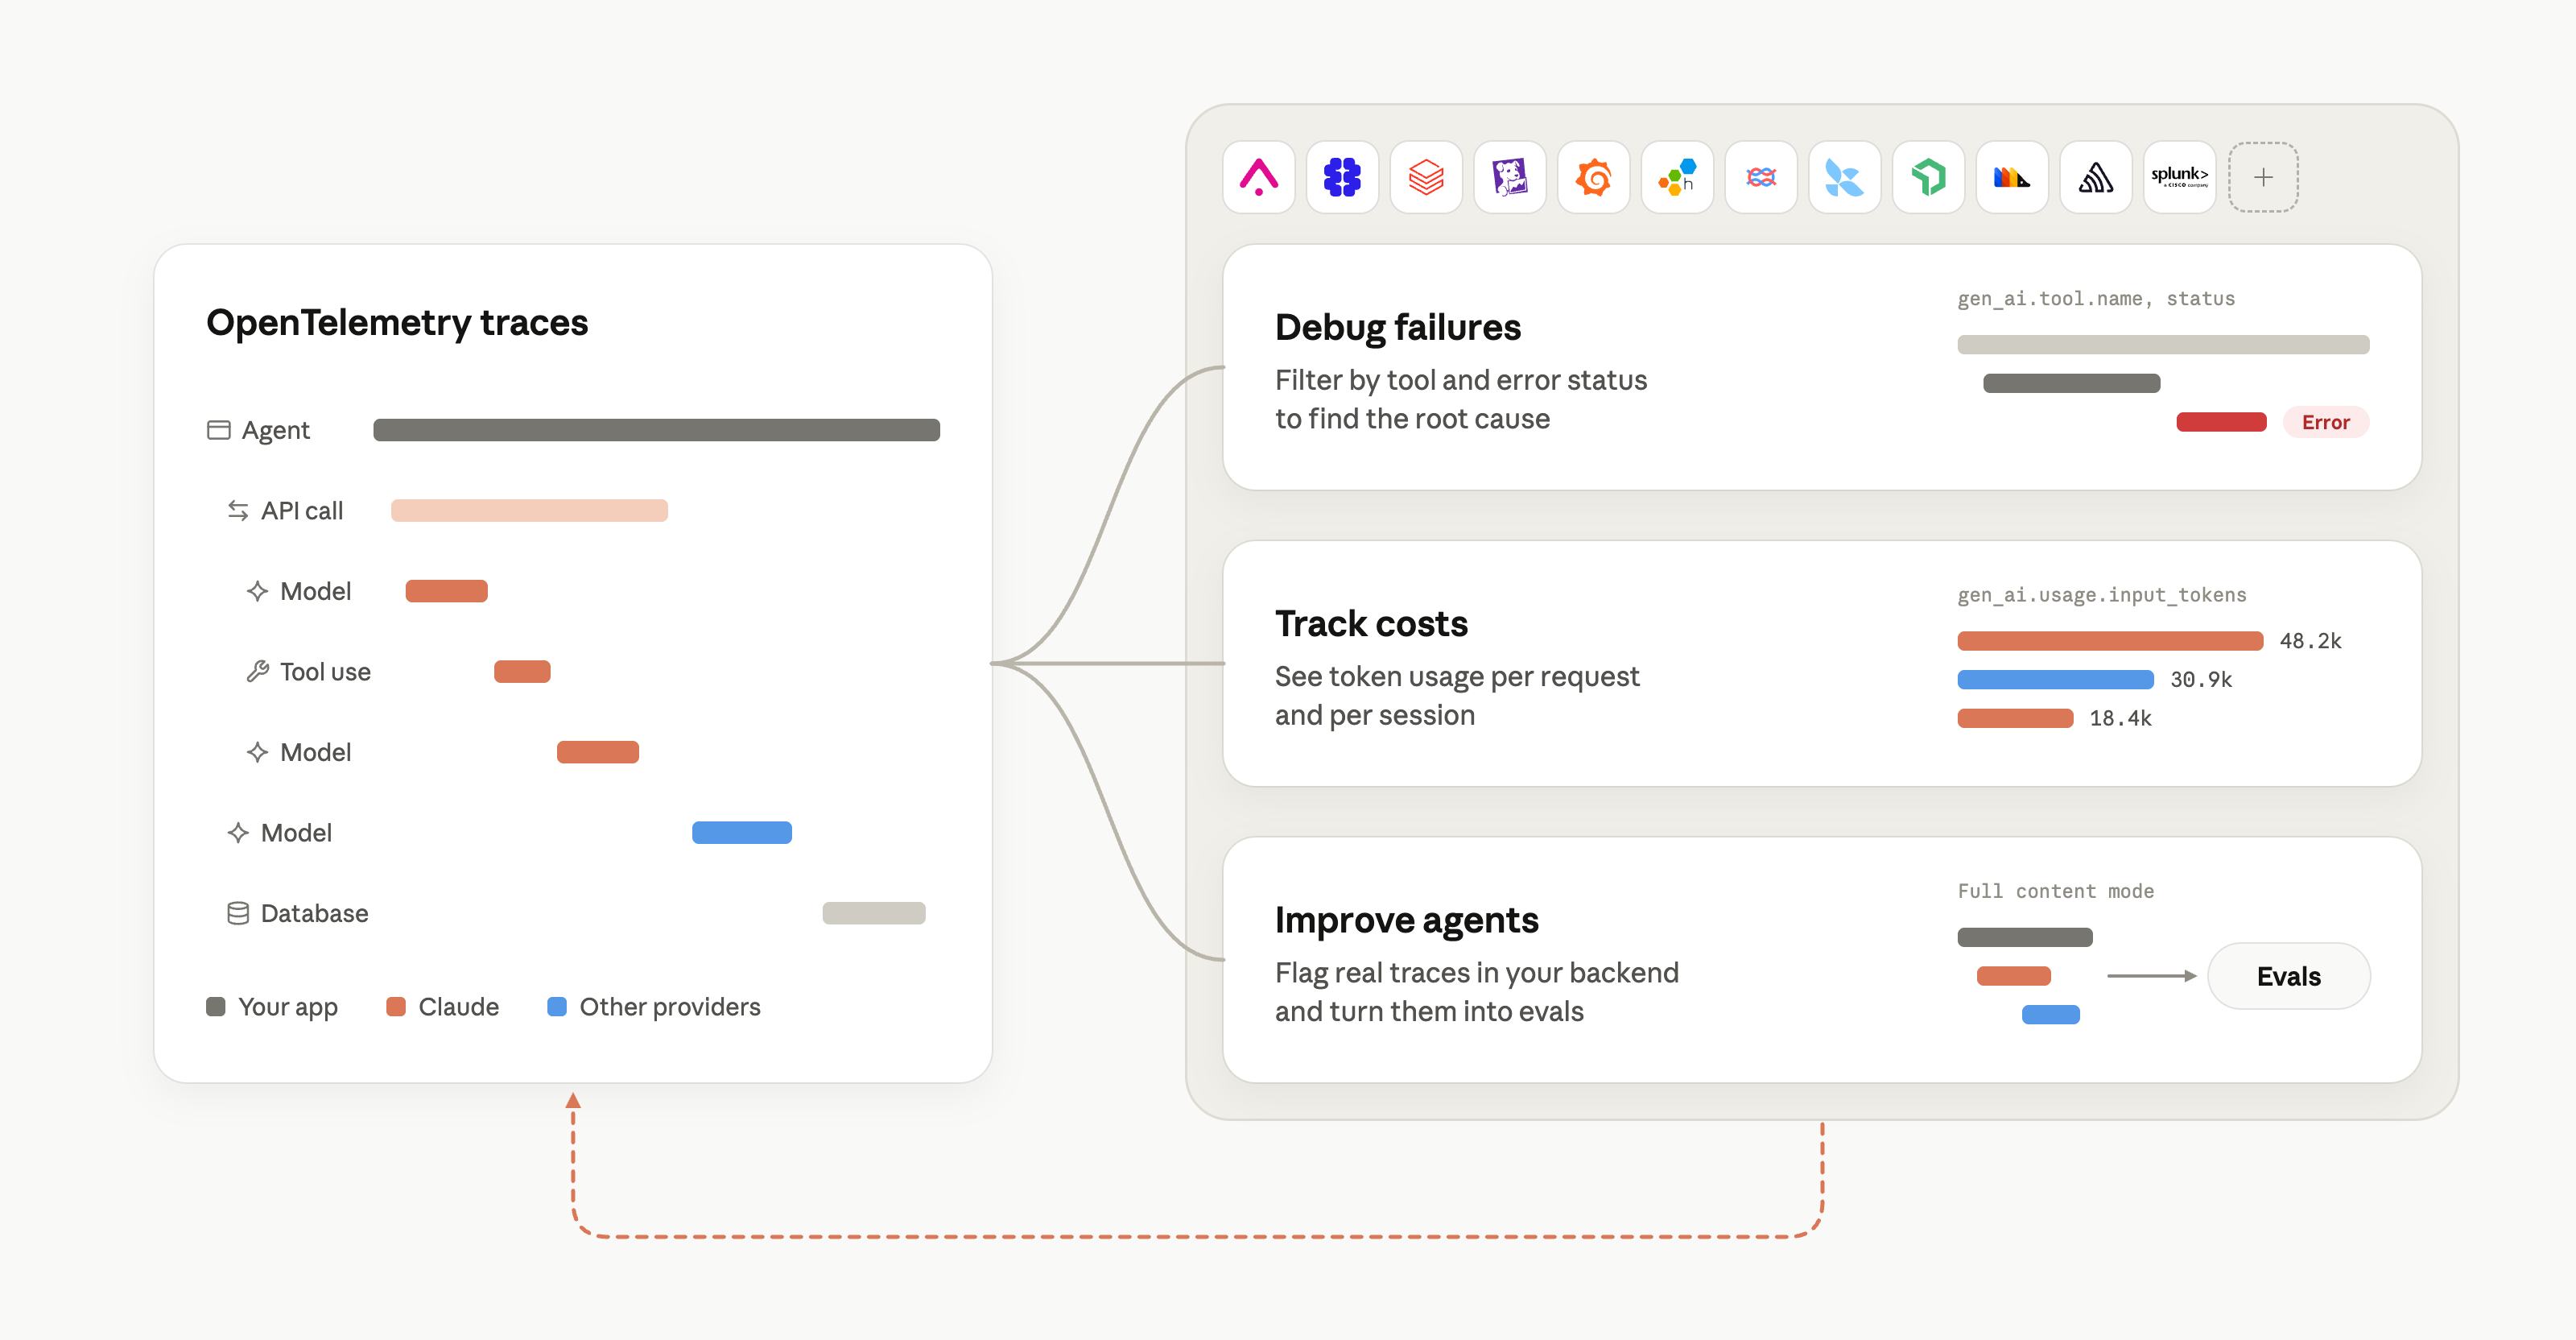
来源:Anthropic。该图展示的是追踪结构和分析工作流,而非实测性能结果。
有两种互补方式可以收集这些数据:
| 能力 | SDK 追踪 | API 追踪 |
|---|---|---|
| 配置方式 | 应用程序代码和 tracer provider | Claude Console 中的目标端 |
| 特殊 Claude 权限 | 无需 | 添加或更改目标端需要管理员角色 |
| 请求内的模型运行 | 仅使用 SDK 追踪时不会单独公开 | 包含 |
| Managed Agents 回合 | 仅使用 SDK 追踪时不会公开 | 包含 |
| 由 API 执行的工具 | 仅使用 SDK 追踪时不会公开 | 包含 |
| 由 SDK 工具运行器执行的客户端工具 | 包含 | 仅使用 API 追踪时不会捕获 |
| 自托管沙盒中的工具 | 通过受支持的 SDK worker 包含 | 不会被 API 追踪捕获 |
| 其他客户端 API 操作,例如文件上传 | 包含 | 不会被 API 追踪捕获 |
两种路径都会记录请求 span 和 Token 用量。结合使用时,团队能够同时了解客户端工作和 Claude API 内部执行的工作。将两类数据发送至相同后端后,后端还可以展示它们之间的关联。
API 追踪不要求为了接收独立的 API 追踪数据而修改常规请求代码。管理员只需添加一个目标端,指定 Claude 应将追踪数据发送到哪里。
anthropic.test span。service.name = claude-platform。对于自定义目标端,文档要求其为接受 protobuf 的 OTLP/HTTP 端点,且必须通过端口 443 上的公共 HTTPS 主机名访问。仅在常用端口 4318 上监听的 Collector 需要适当的 HTTPS 暴露方式或反向代理。凭证应放在请求头值中。
基础端点通常不包含 /v1/traces,因为 Claude 会自动追加该路径。高级 traces 端点可以覆盖该路径,但必须使用相同的主机。私有地址端点和重定向不被支持作为常规投递目标端。
SDK 追踪首先需要安装当前受支持的 Claude SDK,并在第一次需要追踪的调用之前注册 OpenTelemetry tracer provider。应用程序负责提供将 span 投递到可观测性后端的 exporter。因此,“自动 SDK 导出”并不意味着一个全新的应用无需 tracer provider 和目标 exporter 就会自动将数据发送到某处。
在连接远程平台之前,控制台 exporter 可以帮助检查本地埋点。完成配置后,SDK 会发出请求 span,以及通过其工具运行器运行的工具对应的 span。在应用程序 span 内发起的调用可以嵌套在该 span 下方。
在测试阶段,SDK 选项、span 名称和属性可能发生变化。Anthropic 建议固定 SDK 版本,以便团队自行决定何时采纳这些变化。
SDK 会传播追踪上下文,使 API 的服务器端 span 能够位于 SDK 客户端 span 之下。对 Claude Platform on AWS 发起的请求是例外:其 API span 会显示在独立追踪中,因为该平台目前尚不支持相同的追踪上下文关联行为。
Managed Agents 会话会公开 Sessions API 请求 span、智能体回合 span、模型请求、由 API 运行的工具以及结果评估。一个会话可以跨越多条追踪,并且在多智能体运行时可以跨越多个线程。文档建议使用 anthropic.session.id 对会话进行分组,或使用 gen_ai.conversation.id 对线程进行分组。
Claude Code、Agent SDK 和 Cowork 均有各自的监控文档。新的平台功能不应被视为替代每个产品现有埋点说明的方案。
每个 Console 目标端和 SDK 客户端都有内容模式。默认模式 仅元数据(Metadata only) 包含标识符、时间信息、状态、Token 计数,以及工具名称、工具描述和 MCP 服务器名称等部分描述性文本。它不包含模型提示词和响应,但这并不意味着每一个导出字段都不会包含应用程序提供的文本。
完整内容(Full content) 还包括提示词和响应。这对于调试失败交互、基于真实流量构建评估非常有帮助,但也会将对话内容转移到另一个拥有自身访问权限和保留设置的系统中。
默认内容限制为每个 span 0.75 MB。Anthropic 表示,该限制大致可容纳 200,000 Token 的英文上下文,并低于许多可观测性服务和代理使用的 1 MB 请求限制。完整的一百万 Token 上下文可能需要约 4 MB,因此默认限制不足以完整保留每一条大型提示词。
当 span 超过内容限制时,SDK 或 API 会将其截短,并将 anthropic.content.truncated 设为 true。请求 span 会优先舍弃系统提示词和最早的消息;工具 span 则会从工具结果末尾开始舍弃内容块。图像和文档会按类型出现,而不会包含完整的媒体负载。
SDK 使用 traces.max_content_bytes 控制该限制。Console 目标端会在高级设置中公开最大内容大小,而已列出的提供商可能拥有提供商特定的默认值。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
与 Anthropic 约定了 HIPAA、FERPA 或 K–12 数据处理限制的组织,无论选择何种内容模式,都会仅通过 API 目标端导出元数据。文档说明该限制不适用于 SDK span,因此仍需单独审查 SDK 配置。
符合条件的零数据保留 Messages API 请求可以使用完整内容导出,因为 API 会在内存中保留导出内容直至投递完成。Managed Agents 不符合零数据保留条件,启用 OpenTelemetry 也不会改变其数据保留条款。
一次请求可能会将其 Token 用量记录在追踪中的多个 span 上。因此,对追踪中的每一个 span 求和可能会夸大实际用量。
当 Messages API 请求同时存在 SDK 和 API span 时,应使用 API 来源。在该来源内部,应对请求 span 或其模型请求 span 求和,而非同时对两者求和;对于压缩(compaction),需遵循文档规定的具体计算规则。对于 Managed Agents,相关 API span 是模型请求和结果评估。
投递重试也可能产生重复 span。如果后端尚未自动处理,应使用追踪 ID 和 span ID 进行去重。
导出的追踪记录用于调试,而不是保证完整的计费账本。 投递采用尽力而为方式,采样也可能遗漏请求。Anthropic 建议需要完整 API 密钥用量追踪的团队使用 Usage API。
Anthropic 提到了 Grafana Cloud、Honeycomb、Sentry 和 Splunk,它们可用于将智能体追踪与应用日志和指标并排查看。Anthropic 还列出了 Arize AI、Braintrust、Datadog、Langfuse、LangSmith、New Relic 和 PostHog,用于将追踪与评估及质量改进连接起来的工作流。Databricks Unity Gateway 被重点提及,用于组织级可见性。
这些只是示例,并非唯一的兼容列表。其他工具只要接受所需的标准 OTLP 导出,也可以接收这些数据。
该公告包含来自 Foxglove、Ramp、Sterling Labs 和 FloQast 的客户表述。其使用场景包括机器人调试、市场智能体分析和会计工作流追踪。
Ramp 介绍了一个名为 Reflect 的内部系统,该系统会对 Langfuse 追踪进行评分并提出修复建议。其工程师称,该改进工作流让部分智能体的 Token 用量降低了 10%–20%,会话速度提高了 30%。这些是客户对该改进工作流的报告结果,并不意味着仅启用追踪导出就能获得这些收益。
它会将描述 Claude API 请求、智能体回合、模型调用和受支持工具活动的标准 span 发送至可观测性后端。该功能目前处于公开测试阶段,并支持独立的 API 和 SDK 追踪路径。
在 Claude Console 中添加或更改 API 追踪目标端需要管理员角色。SDK 追踪在应用程序代码中配置,无需特殊的 Claude 组织权限。
不会,默认模式为仅元数据。完整内容模式会添加提示词和响应,但受内容限制以及特定组织的文档限制约束。
可以,前提是 API 目标端满足文档规定的网络和协议要求。尤其是,API 导出需要一个可通过端口 443 上的公共 HTTPS 主机名访问的 OTLP/HTTP protobuf 接收器,而不能仅使用私有 Collector 监听器。
可以,当追踪上下文得到传播且这些 span 到达相同的可观测性后端时即可。当前,对 Claude Platform on AWS 发起请求的 API span 会显示在各自独立的追踪中。
不可以。追踪可能被采样、丢失或被多次投递。分析时应使用文档规定的计数规则;如需完整的用量核算,则应使用 Usage API。
Claude 的 OpenTelemetry 测试版将模型调用和智能体工具连接到团队已在使用的追踪系统中。API 追踪公开服务器端活动,而 SDK 追踪补充客户端操作和工具;在支持追踪关联的情况下,将二者结合可获得最清晰的应用程序时间线。
应审慎选择内容模式,检查截断情况和投递健康状态,并从单一适当来源统计 Token。追踪能够提升可见性,但完整的用量核算和数据保留控制仍是独立的责任。
从一句话开始,几分钟内拿到完整网站。



