DeepSeek V4 Flash 0731 进入公开测试版,并带来一个熟悉的承诺:以极低的 API 价格提供更强大的编码和智能体能力。开发者们很快就把这个说法付诸实践。

DeepSeek V4 Flash 0731进入公开测试版,带着一个熟悉的承诺:以极低的API价格提供更强的编码和智能体能力。
开发者们迅速将这一说法转化为实际实验。
流传最广的案例之一来自一次Hermes Agent运行,其中DeepSeek V4 Flash仅凭一个初始提示词就生成了一款可游玩的第一人称3D射击游戏。据报道,该项目耗时32分钟,模型使用成本仅为0.07美元。
最终成果包括:
DeepSeek V4支持100万Token的上下文窗口。
传统的注意力系统在这样的规模下会变得极其昂贵,因为每个新Token可能需要检查大量的先前上下文并维护较大的KV缓存。
DeepSeek的技术报告描述了一种混合注意力设计,结合了:
总体策略是避免在每一步都对整个历史进行完整且昂贵的注意力计算。
系统会对上下文进行压缩和过滤,使模型能够将计算集中在最有用的信息上。
DeepSeek报告称,在100万Token的上下文环境中,V4 Pro需要:
这些确切百分比是技术论文中针对V4 Pro报告的,并非Flash的单独审计数据。
V4 Flash使用相同的架构家族,因此受益于相同的长上下文设计原则。
实际效果包括降低了:
以及内存流量
发布的 V4 Flash 模型使用了混合低精度权重。
DeepSeek 列出:
FP4 + FP8 混合精度
较低的精度减少了推理过程中必须存储、从内存加载、在设备之间传输以及处理的数据量。
这一点很重要,因为现代语言模型推理往往受限于内存带宽,而不仅仅是原始算术运算能力。
如果硬件和内核设计为高效执行这种格式,较小的数据表示可以提升吞吐量。
低精度并非天然免费。
糟糕的量化会降低模型质量。
DeepSeek 的发布是围绕所选精度方案进行设计和训练的,而不仅仅是依赖事后社区量化。
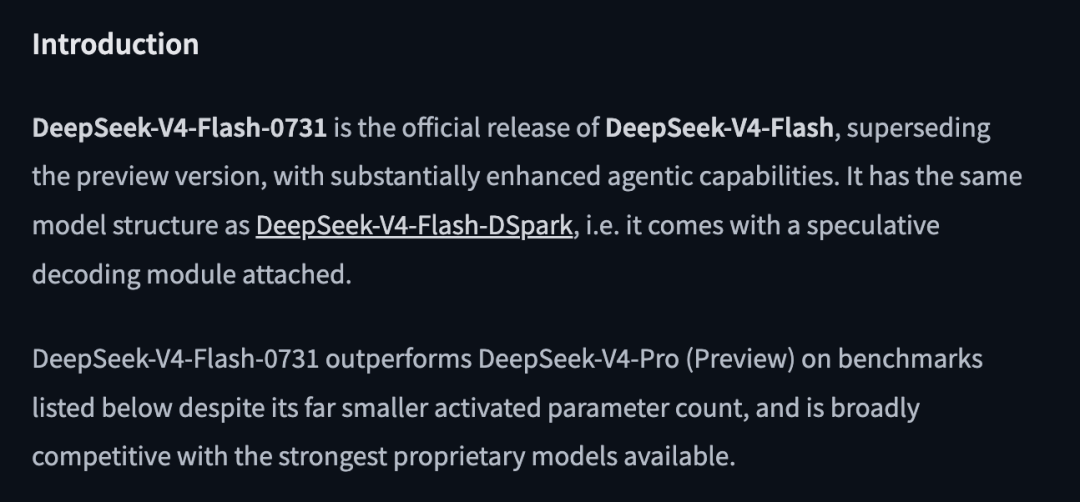
DeepSeek 表示,官方 0731 版本保持了与 V4 Flash 预览版相同的模型架构和规模。
该公司没有为本次更新再次进行完整的预训练。
而是重做了后训练流程。
源文章将变化总结为:
DeepSeek 的技术报告将更广泛的 V4 后训练过程描述为:
0731 更新侧重于改善这些能力在实际智能体工作流中的表现。
DeepSeek-V4-Flash-0731 附带 DSpark 投机解码模块。
投机解码使用较小或更便宜的草稿路径来提出多个未来 token。
主模型批量验证这些提议。
简化流程如下:
草稿模块提出 token
→ 主模型同时验证
→ 接受的 token 被输出
→ 被拒绝的路径会被纠正
当草稿预测准确时,系统可以通过更少的主模型昂贵顺序推理生成多个被接受的 token。
DeepSeek 为 vLLM 和 SGLang 均提供 DSpark 支持。
对于 vLLM,官方模型卡使用:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
对于 SGLang,对应选项为:
--speculative-algorithm DSPARK
DeepSeek 表示,目标模型和草稿模型的权重存储在同一个检查点中,因此 SGLang 不需要单独的草稿模型路径。
投机解码主要提升服务速度和吞吐量。
它本身并不能解释模型的推理能力提升。
这些提升来自更新后的后训练流程。
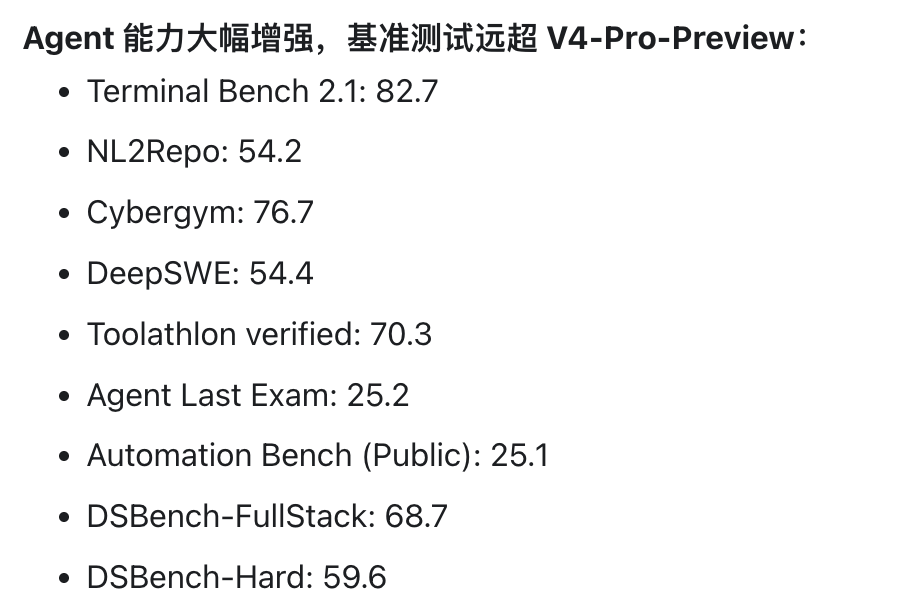
DeepSeek 报告了与 V4 Flash 预览版相比,在多项智能体重点测试中的大幅提升。
| 基准测试 | V4 Flash 0731 | V4 Flash 预览版 | V4 Pro 预览版 |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| CyberGym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 |
12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents' Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 |
DeepSeek表示,公开的代码智能体基准测试使用了以下配置运行:
DeepSeek Harness最小模式
reasoning_effort = max
top_p = 0.95
temperature = 1.0
截至官方更新时,该测试框架尚未公开发布。
DSBench-FullStack和DSBench-Hard是DeepSeek的内部基准测试。
这意味着它们的分数可以作为公司报告的参考证据,但不像完全公开的基准测试套件那样可以独立核查。
Terminal Bench评估智能体在终端环境中完成任务的能力。
模型可能需要检查文件、运行命令、安装依赖、调试故障、修改代码并验证完成情况。
高分反映了模型、智能体框架、工具策略、推理预算和运行时环境的综合表现。
Toolathlon评估跨多个软件应用和工具的长周期任务。
该基准包括涉及日历、文件系统、Notion、WooCommerce、Kubernetes和BigQuery的场景。
任务需要多次工具交互,并通过基于执行的评估器进行验证。
DeepSeek报告的70.3分相比预览模型有了大幅提升。
但这不应被解读为对每项真实业务自动化都有70.3%的成功保证。
消息来源中的游戏示例揭示了基准性能与创意编码之间的重要差异。
V4 Flash在官方智能体评估中表现强劲,但一个游戏对比仍然需要三次迭代。
基准可以衡量在定义明确的任务集和已知评估规则下的成功率。
而创意项目可能包含模糊的视觉要求、浏览器兼容性问题、物理引擎错误、资源缺失、主观质量评判,并且没有单一测试套件可以定义成功。
在这种场景下,低成本模型尤其有用,因为工作流可以承受多次迭代。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
它的价值不一定在于首次生成就完美无缺。
它可能是:
可接受的质量
×
大量可负担的尝试次数
DeepSeek通过以下方式开放模型:
兼容OpenAI的Base URL为:
https://api.deepseek.com

兼容 Anthropic 的基础 URL 为:

```Plaintext
https://api.deepseek.com/anthropic
DeepSeek 表示 V4 Flash 是目前唯一支持 Responses API 的 V4 API 模型。
V4 Pro 的支持将另行规划。
Responses API 的兼容性还允许该模型通过 DeepSeek 的文档化配置在 Codex 中使用。
DeepSeek V4 Flash 支持思考模式和非思考模式。
思考模式为默认模式。
对于本地推理,官方模型卡支持三种推理努力级别:
low
high
max
DeepSeek 推荐:
temperature = 1.0
top_p = 0.95
用于智能体场景。
对于 high 和 max 推理努力级别,该公司建议允许最大输出长度达 384K tokens。
更高的推理设置可以改善困难任务的表现,但也可能增加延迟、输出量、API 成本和智能体循环的耗时。
生产系统应评估能够可靠满足任务需求的最低努力级别。
DeepSeek 在 Hugging Face 上以 MIT 许可证发布了 V4 Flash 0731 权重。
这使得该模型与许多大型商业发布相比具有异常宽松的许可。
开发者可以将官方模型仓库与受支持的引擎一起使用,包括:
该模型规模较大。
核心模型拥有 284B 参数,0731 检查点中另有一个 DSpark 组件。
以可用速度运行它需要大量的内存和硬件资源。
权重可下载并不意味着完整模型能在普通的消费级笔记本电脑上流畅运行。
社区量化版本可以降低内存需求,但可能改变准确性、吞吐量、上下文容量、DSpark 行为和工具调用可靠性。
消息来源总结认为,V4 Flash 并非在每次对比中都能产生最佳结果,但在性价比方面很难被击败。
这是对示例的合理总结,但有一个重要前提:
性价比取决于完整的 workflow。
V4 Flash 在以下情况下尤其具有吸引力:
而在以下情况下,更昂贵的 frontier 模型总体上可能仍然更经济:
正确的对比不是:
每 token 的价格
而是:
每个经过验证的成功任务的成本
不要只测试精心打磨的演示。
使用与生产 workload 匹配的任务,包括困难和复杂的场景。
在不同模型之间保持提示词、工具、时间限制、重试策略、框架、沙箱、测试套件和推理设置的一致性。
跟踪未命中缓存的输入、命中缓存的输入、输出令牌、工具调用、重试次数、运行时间、人工审核和失败尝试。
对于代码,运行测试并检查可维护性。
对于游戏,检查控制、碰撞、性能和浏览器兼容性。
当稳定上下文在多个智能体步骤中被反复复用时,缓存命中价格极低的模型会变得更有价值。
一个经过三次廉价尝试才成功的模型,可能比一个以高价格一次成功的模型更具性价比。
当重试缓慢或存在风险时,情况也可能相反。
DeepSeek V4 Flash 0731是DeepSeek较小规模V4混合专家模型的官方后训练版本。它取代了预览版本,新增了DSpark投机解码模块,并重点聚焦于编码和工具使用型智能体任务。
DeepSeek目前公布的常规价格为:每百万个缓存命中输入令牌0.0028美元,每百万个缓存未命中输入令牌0.14美元,每百万个输出令牌0.28美元。该公司已宣布未来政策将在指定高峰时段将价格翻倍。
一位开发者报告称,Hermes Agent的一次运行在32分钟内以0.07美元的成本生成了一个可玩的第一人称射击游戏。这是一个社交媒体案例研究,而非标准化基准测试,因此其他任务的成本可能更高或更低。
V4技术报告列出的核心Flash模型总参数为2840亿,每个令牌激活130亿参数。完整的0731版本仓库可能显示约3040亿参数,因为它包含了附带的DSpark投机解码组件。
其低成本源于稀疏混合专家激活、压缩长上下文注意力、FP4/FP8混合精度、提示缓存、投机解码和高并发服务。每个令牌仅激活总专家中的一小部分。
在当前的API定价下,它便宜得多,并在多个社区演示中表现出竞争力。Opus 5和GPT-5.6在某些任务上可能仍提供更强的首次通过可靠性或质量,而那些病毒式传播的比较并非受控基准测试。
可以。DeepSeek以MIT许可证发布权重,并提供vLLM和SGLang的使用指导。完整模型极其庞大,因此实际的本地部署需要大量的加速器内存或激进的社区量化方案。
支持。DeepSeek表示,官方Flash版本原生支持Responses API,并已适配用于Codex。当前的V4 Pro API尚不支持Responses API。
deepseek.com/):DeepSeek V4 Flash 及其他受支持模型的官方托管端点。
DeepSeek V4 Flash 0731 引起了广泛关注,因为开发者报告称仅需几美分就能构建完整的交互式演示。据报道,一款第一人称射击游戏仅花费 0.07 美元,而其他社交媒体上的对比显示,任务成本比 Claude Opus 5 或 GPT-5.6 低数十倍。
这些示例并非受控基准测试,但官方 API 定价支持了其核心观点。V4 Flash 每百万未缓存输入令牌收费 0.14 美元,每百万输出令牌收费 0.28 美元,缓存命中率仅为 0.0028 美元,低得惊人。
其经济性源于整个系统:一个每次令牌激活 13B 参数的 284B MoE 核心、压缩的长上下文注意力、FP4/FP8 权重、百万令牌上下文窗口、高效的服务能力,以及 DSpark 投机解码。0731 更新保留了预览架构,并通过新的后训练改进了智能体行为。
最有力的官方证据是基准的提升。Terminal Bench 2.1 从 61.8 升至 82.7,Toolathlon-Verified 从 49.7 升至 70.3,同时模型保持了 Flash 定价层级。
V4 Flash 的优势不在于它在所有对比中胜出——而在于其极低的边际成本使得
以许多前沿定价模型难以实现的规模,反复进行代理式实验,这在实践中是可行的。
从一句话开始,几分钟内拿到完整网站。



