For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prize 宣布,Gemini 4 Argon 在 ARC-AGI-3 中取得经验证的 97.5% 成绩。据主办方称,Google DeepMind 因此成为第二家在该基准测试中超过 95% 的前沿实验室。
ARC Prize 宣布,Gemini 4 Argon 在 ARC-AGI-3 中取得经验证的 97.5% 成绩。据主办方称,Google DeepMind 因此成为第二家在该基准测试中超过 95% 的前沿实验室。
与此同时,还有一项同样重要的对比:同一模型系列使用标准评测框架时得分为 49.8%,使用提供方适配器时则为 97.5%。报告的评测成本分别约为 5,800 美元和 4,800 美元。
这些成绩针对的是经过配置的系统。在根据醒目的百分比得出结论前,有必要了解基准测试、推理级别、评测框架以及未完成的测试运行。
ARC Prize 公告给出了以下数据:
| 基准测试与设置 | 报告成绩 | 报告评测成本 |
|---|---|---|
| ARC-AGI-1,报告中的最佳设置 | 98.5% | 每项任务约 0.16 美元 |
| ARC-AGI-2,报告中的最佳设置 | 91.3% | 每项任务约 0.32 美元 |
| ARC-AGI-3,提供方适配器,低推理级别 | 97.5% | 本次评测约 4,800 美元 |
| ARC-AGI-3,标准框架,低推理级别 | 49.8% | 本次评测约 5,800 美元 |
成本的计量单位不同。 ARC-AGI-1 和 ARC-AGI-2 的金额按每项任务计算;ARC-AGI-3 的金额则指整次评测运行的成本。若不区分这一点,就不应将它们放在同一成本尺度上比较。
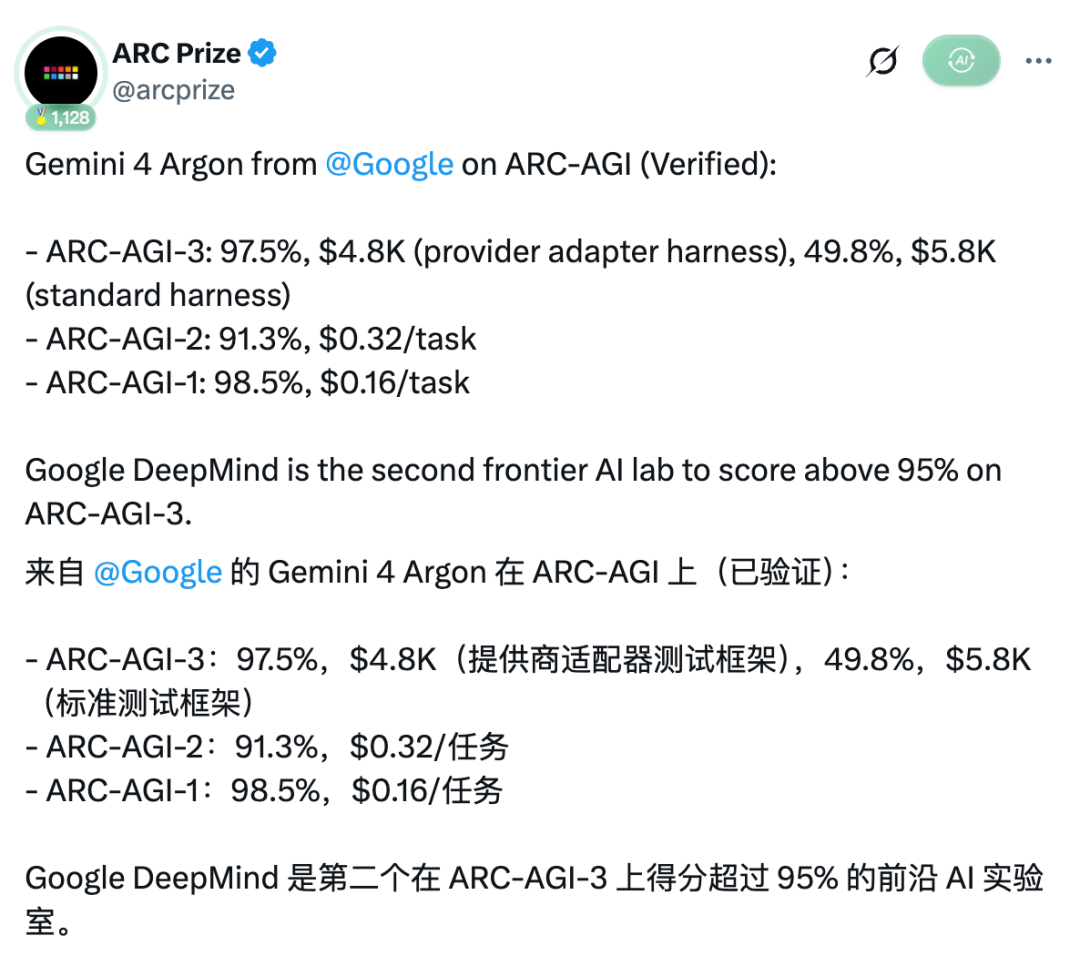
源报道转载的 ARC Prize 经验证成绩公告。
实时数据表列出的 ARC-AGI-1 和 ARC-AGI-2 最佳设置成本更为精确,分别为每项任务 0.162 美元和 0.325 美元。表中 ARC-AGI-2 的成绩为 91.3%,与公告一致,不过结果页面随附段落写的是 91.2%。本文保留公告和表格中的数值,同时注明这一差异。
ARC-AGI-3 与前两代基准测试有所不同。它不再要求模型根据静态示例推断输出网格,而是要求智能体探索陌生的交互式环境,发现行动方式,并在没有自然语言游戏说明的情况下学习如何实现目标。
ARC Prize 表示,这项测试衡量的是技能获取效率、适应能力以及随时间推进的规划能力。因此,该基准的分数并不只是“赢得游戏的百分比”。基准测试说明指出,达到 100% 分数意味着以不低于人类参考水平的效率完成游戏。
源报道追溯了 ARC-AGI-3 三月发布时前沿模型成绩不足 1%,到当年稍晚时成绩接近上限的变化过程。报道重点提及 OpenAI 早先取得的 GPT-6 Astra 成绩,随后是 Gemini 进入 95% 以上的区间。
这代表该评测上的显著进步,但并不意味着主办方测试了所有可能的推理形式,也不代表已经证明这两个系统都能像人一样学习任何新任务。
报道还介绍了模型在 25 个公开游戏上的高行动效率:相比人类基线少用 62% 的行动次数;其中三款游戏的速度与速通纪录持平或更快,另有六款与纪录相差不超过 10%。这些具体对比是源报道对公开测试集的观察,不能推广到全部 55 项评测任务或任意游戏。
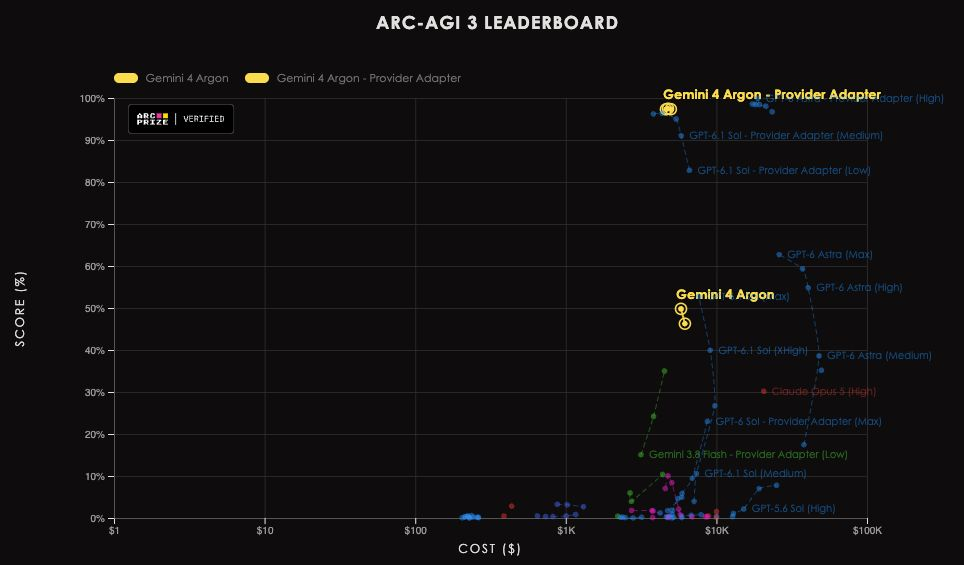
报道保留的排行榜截图;实时结果页面提供当前配置的详细信息。
智能体评测框架负责控制模型周围的交互方式:观察信息如何传入、行动如何发送、保留哪些上下文,以及对话变长时如何处理。
ARC Prize 分别定义了两种测试条件:
Gemini 4 Argon 的实时结果如下:
| 推理级别 | 标准评测框架 | 提供方适配器评测框架 |
|---|---|---|
| 低 | 49.8% | 97.5% |
| 中 | 46.3% | 97.3% |
| 高 | 没有完整的已报告对比数据 | 97.3% |
低推理级别下,两种评测框架的成绩相差 47.7 个百分点。这说明经过配置的交互系统会显著影响测得的结果,但不能据此确定某一个单独的因果机制。除评测框架标签外,还需要考虑上下文处理、执行条件、API 可靠性和其他设置。
具体而言,ARC Prize 报告称,API 问题导致标准框架评测未能全部完成。低、中、高推理级别的运行分别完成了 55 项任务中的 42 项、46 项和 19 项。报告中的汇总成绩涵盖全部 55 项任务,并保留未完成运行所取得的部分分数;这些完成数量并不意味着 42 项或 46 项游戏都已被彻底解决。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
未完成的高推理级别标准框架数据点未纳入图表。因此,在这次评测中,更高的推理投入并未形成一组完整且可直接比较的标准框架结果。
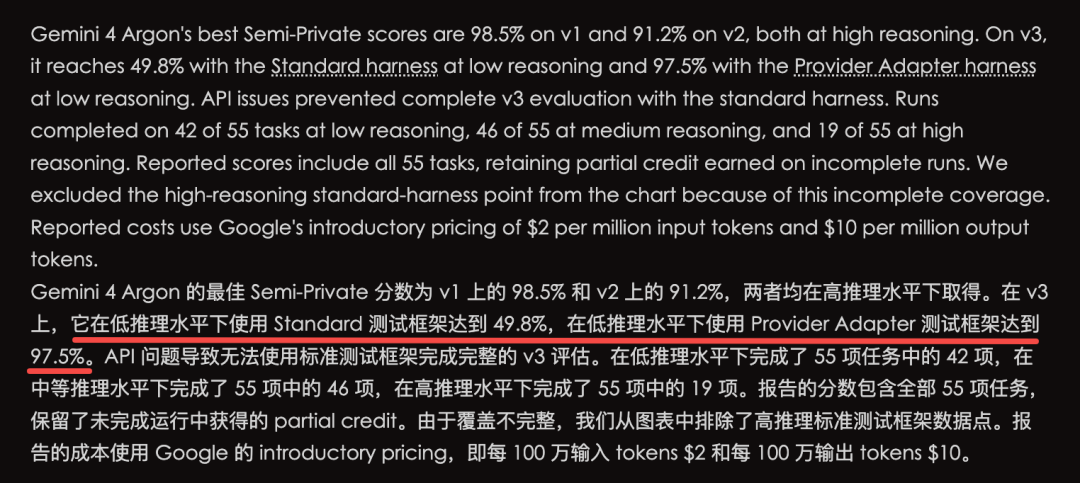
源报道转载的配置与覆盖范围说明;请查看实时结果页面了解更新。
ARC Prize 表示,成本估算采用 Google 的入门级 API 价格:每百万输入词元 2 美元、每百万输出词元 10 美元。这不是解决某项新现实任务的固定价格,实际费用也可能随定价或配置变化。
源报道提出的主要实践经验是合理的:仅凭模型名称和一个百分比,无法完整说明被评测的系统。如果两个成绩对应的上下文管理接口不同,那么即使模型名称相同,它们回答的也可能是不同问题。
ARC Prize 的政策明确指出,两种评测框架会分开报告,因为它们针对的是不同的评测问题。经验证成绩由主办方按照已公布的方法进行评测,因此比未经佐证的厂商演示材料更有依据;但这些成绩仍受测试任务分布和测试条件的限制。
比较这些结果时,建议依次查看基准版本、确切的模型配置、推理级别、评测框架、任务覆盖范围、评分规则和成本单位。这样更容易区分真实进步与不同实验之间的比较。
接近上限的表现也引出了一个研究问题:测试中还剩多少提升空间?但这并不会消除现存局限,也不能把“AGI 基准测试”变成通用人工智能已经实现的证明。
ARC Prize 报告称,Gemini 4 Argon 在低推理级别、使用提供方适配器评测框架时取得 97.5%。低推理级别下,标准框架的成绩为 49.8%;两者属于不同评测条件,且标准框架的测试运行未能全部完成。
不是。ARC-AGI-3 使用基于效率的评分系统,并且可以给予部分分数。因此,不能直接把这个分数换算成完整完成的游戏数量。
标准评测框架是一个精简、独立于模型提供方的接口,会保留模型自行选择的笔记。提供方适配器则可以使用提供方专属的上下文管理功能,包括保留推理状态和压缩对话。
公告称,低推理级别的评测运行中,提供方适配器的成本约为 4,800 美元,标准评测框架约为 5,800 美元。ARC Prize 表示,这些估算使用入门级词元价格计算;它们是整次评测的总成本,并非每项任务的价格。
ARC Prize 将这些结果标记为经验证,并公布了测试政策和针对该模型的结果页面。本文核查了这些记录,但没有重新运行评测,也没有独立复现这些成绩。
没有任何单一基准测试能够证明这一结论。该结果表明,Gemini 4 Argon 在所述系统配置下于 ARC-AGI-3 上表现出色;要评估其在该设置之外的可靠性和泛化能力,还需要更多证据。
Gemini 4 Argon 经验证的 ARC-AGI 成绩表明,它在静态和交互式测试中都表现出色。ARC-AGI-3 的 97.5% 这一醒目成绩,针对的是特定的低推理级别、提供方适配器配置;报告的评测成本约为 4,800 美元。
标准框架成绩、未完成的测试运行以及上下文管理方面的差异,都是解读这项对比时不可忽视的因素。应结合模型、评测框架和评测条件一起看待结果;单凭百分比无法证明通用人工智能已经实现。
从一句话开始,几分钟内拿到完整网站。



