For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/gemini-4-argon-launch-access-api-pricing-cf4e0dbb.md.
Google 的 [Gemini 4 Argon 公告](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/)介绍了一款面向高难度、...
Google 的 Gemini 4 Argon 公告介绍了一款面向高难度、长周期工作的模型:大型代码变更、视觉创作、科学推理,以及超出短轮对话范围的任务。此次发布同时覆盖开发者产品和消费者体验,但两者的访问条件有所不同。
实际评估的关键在于这些细节。API 介绍期定价有明确的截止日期,百万 Token 限额由多类内容共享,而引人注目的软件速度提升也只适用于某一特定工作负载环节。阅读底层文档后,公告会更容易被准确评估。
Google 表示,可通过 AI Studio 和 Gemini 平台获得付费 API 访问权限,开发者可用范围还延伸至 Android Studio。Google AI Ultra 订阅者可通过 Antigravity 和 AI Studio 访问,而消费者 Gemini 应用和 Search AI Mode 的推出则覆盖 Google AI Pro 和 Ultra 订阅者。
这些是具有不同权益的不同产品。Google AI Pro 对消费者体验的访问权限,并不自动意味着同一套餐包含在 AI Studio 中访问 Argon 的开发者权限,或提供免费的 API 配额。
进行集成时,应核查当前开发者访问要求,而不是仅依赖笼统的发布公告标题。AI Studio 定价页面将 API 模型标记为 gemini-4-argon,且未列出其免费层级。
截至 10 月 15 日,Google 的标准 API 定价文档为 Gemini 4 Argon 列出了两个定价时期。以下价格均为每百万 Token 的美元价格。
| Token 类别 | 截至 2026 年 11 月 30 日 | 自 2026 年 12 月 1 日起 |
|---|---|---|
| 输入 | $2.00 | $4.00 |
| 输出(含思考) | $10.00 | $20.00 |
| 隐式缓存输入 | $0.10 | $0.20 |
因此,发布公告中的介绍期输入和输出价格是有时限的,并非永久定价。缓存输入价格相较对应输入价格降低了 95%,但仅适用于符合条件的隐式缓存输入;该页面未列出此模型支持显式缓存。
Token 价格也未必能够完整反映应用成本。单独计费的工具以及工作流中的重复请求都可能产生额外费用,因此,生产环境成本预估应反映实际请求模式和最新文档。
Google 的长解码文档描述了一个由输入、思考和输出共享的统一 1,048,576 Token 限额。它并不承诺可以使用一百万输入 Token,再额外生成一百万 Token 输出。
Interactions API 通常将同步或流式输出限制为 65,536 Token。要生成超过这一数量的内容,需要按文档要求启用后台模式、配置更大的 max_output_tokens 设置并启用存储。服务器会通过连续跳转完成更长的生成过程。
规划此类任务时,有两个细节很重要。第一,max_output_tokens 同时包含思考内容和返回的输出。第二,连续跳转可能会再次计算输入,而在符合条件时将应用文档规定的隐式缓存折扣;长解码并不是对单次请求无限且免费的扩展。
这一能力可能有助于完成较长的实现任务或深入分析,但更大的输出额度并不保证正确性。结果仍需要审查,而且输入会占用同一个总预算的一部分。
Google 报告称,其使用 Argon 参与了 Chrome 的一次重构,该代码库约有 4,000 万行代码,其中一个遗留区域约有 600 万行。该公司表示,这项工作从以月计的任务缩短为以周计的任务。这些是 Google 报告的项目结果,并非对任意代码库变更的普遍承诺。
ADK 工程文章提供了一个更便于审查的案例。该案例涉及一个约 205,000 行代码、约 800 个源文件的 Python 仓库,并有庞大的公共测试套件支持。
这项工作分两轮完成。最初一次两小时的尝试暴露出一些不足;之后的一次隔夜运行使用了项目技能和一个 Antigravity 目标。模型在 32 个文件中提出了六项优化,但维护者保留了两项,拒绝了四项。最终合并的工作结合了两轮中的修改,涉及 22 个文件,并新增了 17 个测试函数。
被接受的优化包括:在内存会话服务中先过滤数据再复制数据,以及延迟导入软件包。公开合并提交提供了可供审查的最终代码。
该基准测试的价值在于,它区分了多项耗时,而不是将某一项加速呈现为普遍提升。
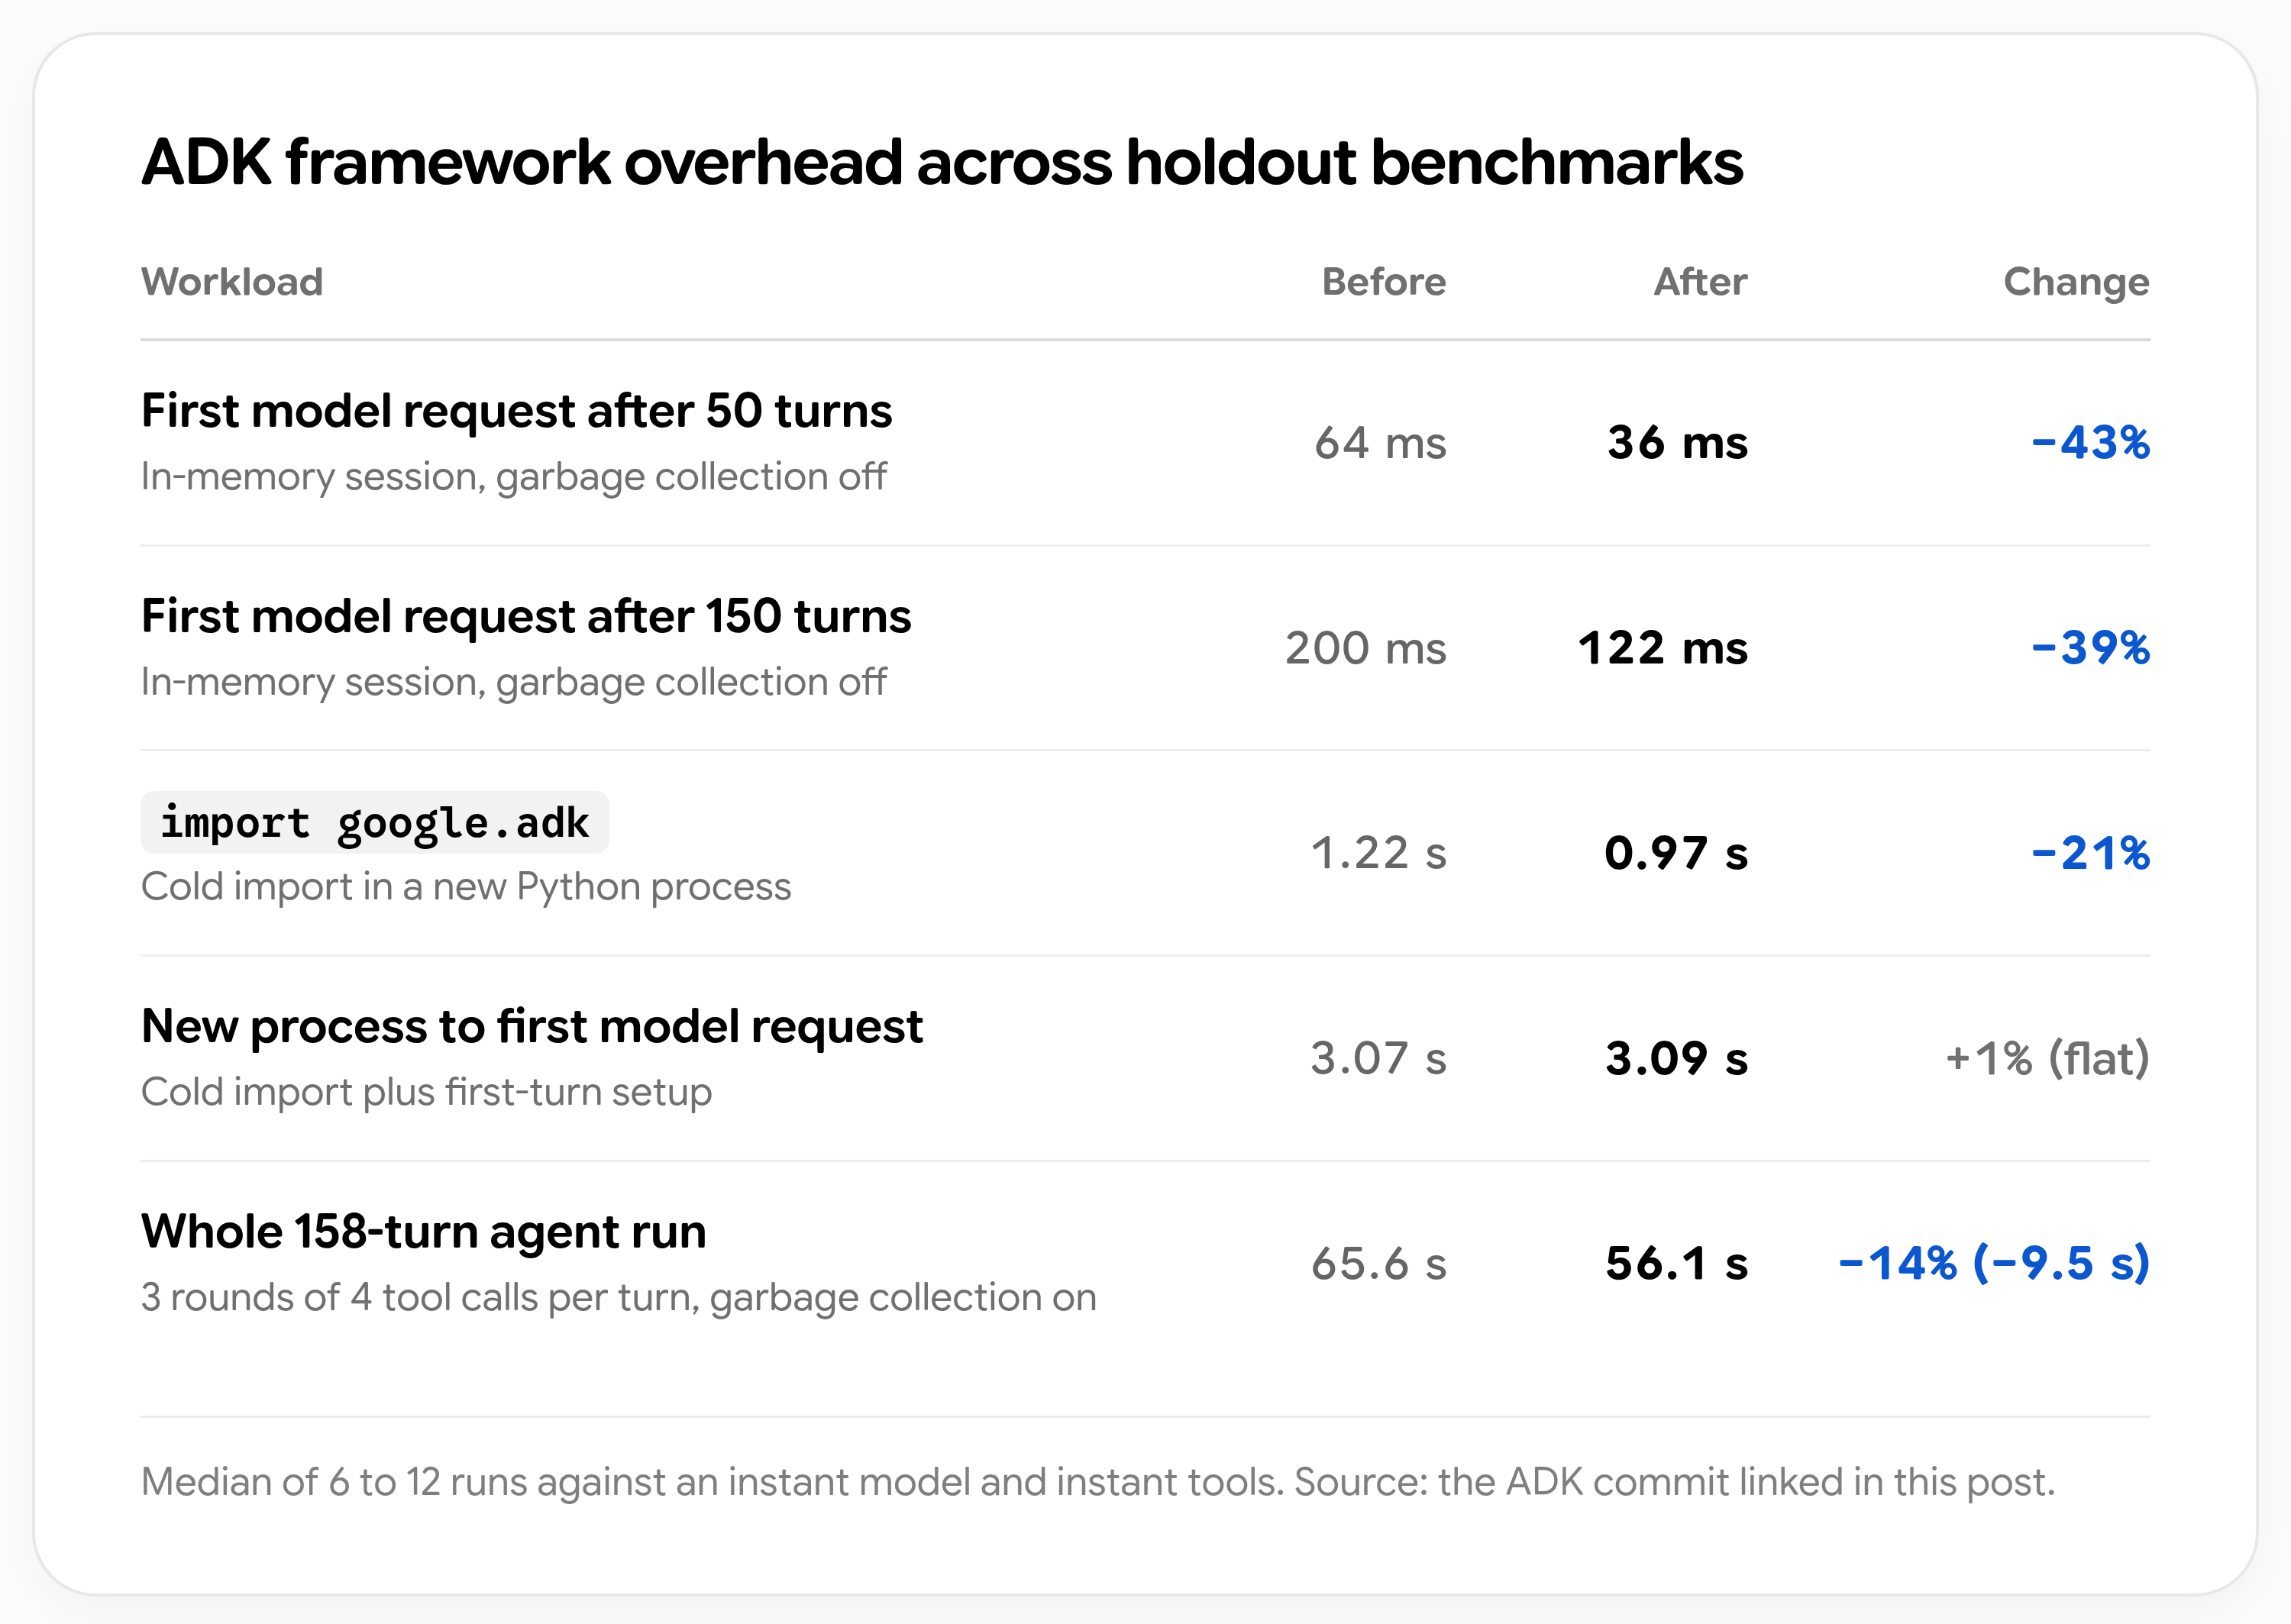
来源:Google Developers Blog,ADK 优化研究。测量使用即时模型和工具以隔离框架开销,结果取多次运行的中位数。
| 测量项 | 优化前 | 优化后 | 报告变化 |
|---|---|---|---|
| 50 轮后首次模型请求 | 64 毫秒 | 36 毫秒 | 快 43% |
| 150 轮后首次模型请求 | 200 毫秒 | 122 毫秒 | 快 39% |
| 冷启动导入 | 1.22 秒 | 0.97 秒 | 快 21% |
| 新进程至首次请求 | 3.07 秒 | 3.09 秒 | 基本持平 |
| 完整 158 轮运行 | 65.6 秒 | 56.1 秒 | 快 14% |
约 40% 的提升针对的是测试中的内存服务会话准备路径。不应将其描述为让每个 ADK 应用都快 40%,尤其是在部署使用其他存储后端,或大部分时间用于等待模型和工具响应时。
冷启动导入有所改善,但从进程启动到首次请求的耗时没有改善。这是一个实用提醒:应测量用户可感知的工作流,而不能假设局部优化会改善每一项端到端指标。
提议的修改通过了全部 16,892 项公共单元测试,但有 25 个内部测试目标失败,因为此前被移除的导入仍被预期可进行修补。维护者通过延迟访问器解决了兼容性问题,而不是将公共测试全部通过视为安全性的充分证明。
其他提议的修改因多种原因被拒绝,包括缓存数据过期、依赖私有 OpenTelemetry 属性、在缺乏端到端收益的情况下可读性下降,以及某项优化仅在合成工作负载中表现出收益。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这使该案例比无人监管的编码成功故事更有参考价值。模型生成了候选改进;维护者评估证据、拒绝不合适的补丁,并在合并被接受的修改前修复了一个兼容性问题。
Google 还报告了在 NVIDIA A100 上使用 vLLM 对 Gemma 4 E2B 推理进行的优化。在该特定配置下,吞吐量从每秒 37,900 Token 提升至每秒 108,000 Token,报告称在 Token 对等条件下实现了 2.85 倍提升。
这是一个特定配置下的结果。它并不能证明不同模型、GPU、批处理模式或部署栈也能获得同样的速度提升,也不应与托管 Argon API 请求的价格或延迟混为一谈。
此次发布中的创意演示包括:使用 Blender 和视觉评审构建的三维神庙,以及利用桌面照片灵感制作的赛车体验。后者结合了 Blender MCP、生成纹理、Three.js 和额外的媒体能力,因此完成的作品是工作流结果,而非证明一次纯文本调用可以在无人辅助下创建所有资产。
这些案例展示了 Google 希望开发者尝试的项目类型。它们不能替代对生成代码、物理行为、资产许可或浏览器性能的直接测试。
此次发布将范围从软件工程扩展到多个研究领域。每项结果解决的问题,都比所属领域名称可能暗示的范围更窄。
机器人演示也遵循同样的模式。Google 的 Apollo 机器人观察人类玩玉米洞游戏,构建模拟环境,然后在报告的演示中连续七次真实命中。这证明的是展示运行本身,而不是对任意机器人、环境或物理任务的可靠性估计。
Google 表示,内部代码提交量增加了 35%,回滚率下降了约三分之一。这些是公司报告的内部数据;发布文章并未将其作为其他组织能够获得结果的受控预测。
ADK 案例提供了一种更实用的方式来评估这一更广泛的主张。应从基线可衡量的任务开始,保留测试和兼容性检查,并评估最终被接受的补丁。审查和修复修改所花费的时间也应纳入结果。
对于研究工作,相应的问题是:输出能否通过相关领域的检查,例如证明、实验室实验、独立计算或经过精心设计的评估。模型给出的合理解释只是这一过程中的一个阶段。
截至 2026 年 10 月 15 日查阅的 AI Studio 定价页面未列出 gemini-4-argon 的免费层级。消费者订阅访问和开发者 API 访问的条件不同,因此不应假定 Google AI Pro 的消费者功能包含该 API 模型。
文档列出的介绍期标准费率为:截至 2026 年 11 月 30 日,每百万输入 Token 2 美元,每百万输出 Token(含思考)10 美元。自 12 月 1 日起,页面列出价格分别为 4 美元和 20 美元;符合条件的隐式缓存输入单独计价,工具费用也可能增加总成本。
不允许。Google 说明,输入、思考和输出共用 1,048,576 Token 的预算。因此,更长的输入会为交互的其他部分留下更少空间。
长解码文档要求启用后台模式、存储,并将 max_output_tokens 设为高于通常限额的值。连续跳转仍受共享预算和文档规定的计费行为约束,因此应用应遵循当前 Interactions API 指南。
不是。约 40% 的结果针对的是 Google 基准测试中的特定内存会话准备路径。完整的 158 轮运行提升了 14%,而从新进程到首次请求的耗时基本没有变化。
不能。报告的结果针对的是定义明确的研究问题和演示。在将其泛化至临床、工业或真实物理世界用途之前,仍需要进行适当的独立验证、领域审查和部署测试。
Gemini 4 Argon 在代码、视觉项目和研究领域带来了一系列已报告的能力。其当前的实际细节包括付费开发者访问、在 11 月后结束的介绍期价格,以及包含思考和输出在内的共享上下文预算。
最有力的工程证据来自被接受、经过测试的 ADK 修改及其可测量的限制,而人工审查仍然是结果的一部分。
从一句话开始,几分钟内拿到完整网站。



