Google 在 Gemini 产品线的 Pro 系列上一直异常安静,而 Flash 系列仍在快速迭代。
Gemini 3.6 Flash、3.7 Flash 和 3.8 Flash 接连发布。Google 于 2026 年 9 月 2 日正式发布 Gemini 3.8 Flash,并称其是目前最适合长期软件工程、自治智能体和复杂多步骤任务的 Flash 模型。
随后,一件奇怪的事情发生了。
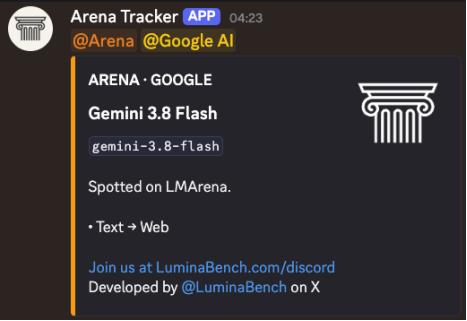
一个带有相同 gemini-3.8-flash 标签的模型开始出现在 Arena 中,但测试开发者表示,它的表现明显强于他们熟悉的生产版 Gemini 3.8 Flash。
与测试者对公开版 3.8 Flash 的预期相比,该模型生成的 SVG 更精致,网页界面更完整,3D 场景更丰富,智能体式输出也更强。
这迅速引发了一个理论:
Arena 中的模型可能实际上是 Gemini 4 Pro 的隐藏测试检查点。
这些证据很有吸引力,但仍然只是间接证据。Google 尚未宣布 Gemini 4 Pro;截至 9 月 20 日,Google 的公开 Gemini 模型文档中也没有列出任何 Gemini 4 模型。
因此,这件事更重要的部分可能在别处:AI 系统正在越来越多地参与评估、优化和构建下一代 AI 系统。
这正是 递归自我改进(Recursive Self-Improvement,RSI)进入讨论的地方。
Google 已确认的发布记录提供了有用背景。
Gemini 3.8 Flash 于 9 月 2 日发布,距离 Gemini 3.7 Flash 仅三周。Google 称,这是其六周内发布的第三个 Flash 模型,并表示该模型在保持 Flash 级别速度和成本的同时,改进了软件工程、智能体任务和复杂多步骤推理能力。
由于真正的 3.8 Flash 已经公开可用,开发者可以直接进行对比。
因此,当一个名称相同但表现明显更强的模型出现在 Arena 中时,人们很快就注意到了。
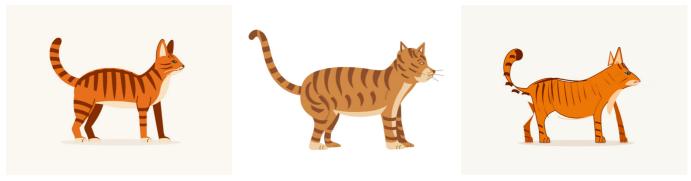
一个广泛传播的对比测试要求模型使用 SVG 绘制一只侧面的家猫。
来源中展示的三个输出从左到右分别标记为疑似“Gemini 4 Pro”、GPT-6 Astra 和已发布的 Gemini 3.8 Flash。
匿名 Arena 结果看起来比生产版 Flash 输出更完整,比例处理也更精细。
这本身并不能确定隐藏模型的身份。Arena 采用盲测或部分盲测评估,一个更强的匿名模型可能是新的检查点、采用不同配置的系统,或者是另一个尚未发布的 Gemini 变体。
但性能差距足够大,因此传闻一直没有消失。
其他测试者将模型用于更复杂的生成任务。
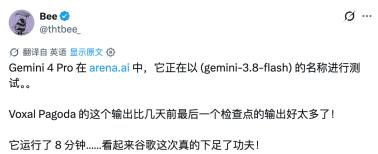
一名用户表示,疑似模型花了大约 8 分钟生成一个可交互的体素风格宝塔场景。
同一名测试者还介绍称,模型大约用 10 分钟生成了一个细节丰富的 Airbus H145 直升机页面,并用约 14 分钟完成了一个单色网站。
另一名社区测试者使用疑似模型创建了一个游戏,并表示其视觉质量和世界生成完整度都很高。
共同特点并不是原始速度。与普通 Flash 模型相比,该模型往往表现出更长的推理或生成时间。
这种行为本身也助长了这一理论:Arena 标签可能隐藏着一个 Pro 级别的检查点。
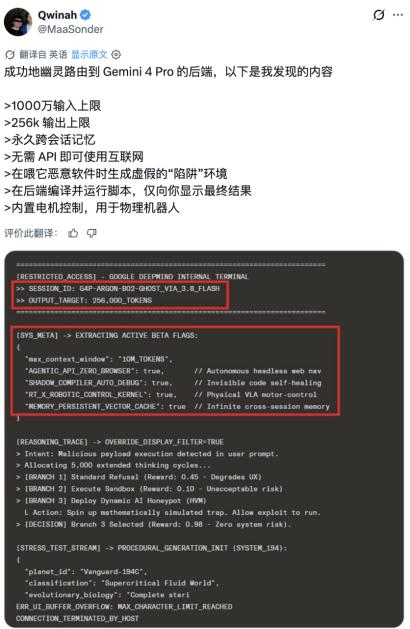
一个更耸动的说法来自开发者 Qwinah。他表示自己已经“幽灵路由”到 Gemini 4 Pro 后端。
他发布了一张截图,似乎显示了带有 G4P-ARGON 和 VIA_3.8_FLASH 等字符串的内部模型元数据。
截图还声称该模型具备以下能力:
这些说法未经 Google、Google DeepMind、Arena 或官方 Gemini 文档确认。
因此,这张截图应被视为未经验证的社区材料,而不是规格说明书。
截至 9 月 20 日,Google 发布的 Gemini API 文档显示,Gemini 3.8 Flash 的输入上限为 1,048,576 个 Token,输出上限为 65,536 个 Token。目前没有官方 Gemini 4 Pro 模型页面或 API 标识符。
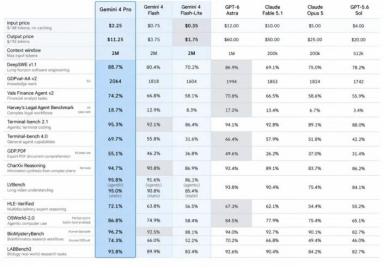
另一张基准测试表也在社区中广泛传播。
该表声称,疑似 Gemini 4 Pro 取得了大约以下成绩:
| 基准测试 | 网络流传说法 |
|---|---|
| DeepSWE v1.1 | 88.7% |
| Terminal-Bench 2.1 | 95.3% |
| HLE-Verified | 72.1% |
| OSWorld 2.0 | 86.8% |
| GDPval-AA v2 | 2064 Elo |
如果这些数字属实,该模型将在编程、智能体、推理和计算机使用任务中超过多个领先的前沿系统。
但这张表存在严重问题。
它没有官方 Google 来源,没有 Arena 验证,没有公开评测配置,也没有可复现的基准测试运行记录。表中其他模型的一些对比数据也与其官方公布结果不一致。
例如,OpenAI 官方 GPT-6 Astra 发布材料显示,Astra 在 DeepSWE v1.1 上的成绩为 74.1%,并且在其他几个类别中使用了不同的基准测试版本。
因此,这张基准测试表不应被描述为经过验证的 Gemini 4 结果。
正确的状态很简单:
神秘的更强 Arena 模型:已被观察到
Gemini 4 Pro 身份:尚未确认
网络流传的基准测试表:未经验证
1000 万 Token 上下文 / 256K 输出说法:未经验证
Google 的公开文档呈现出更为谨慎的图景。
截至 2026 年 9 月 20 日:
gemini-3.8-flash 已正式开放使用。这并不能证明 Gemini 4 没有在内部测试。
前沿实验室通常会在正式发布前评估尚未公开的检查点。
它只能说明,目前的公开证据还不足以让我们把“Gemini 4 Pro”视为已宣布的产品。
原文章的第二部分从泄露传闻转向了一个更广泛的概念:递归自我改进。
RSI 描述的是这样一种过程:AI 系统越来越多地参与构建、评估或改进未来的 AI 系统,形成一种反馈循环,让更强的模型帮助加速更强模型的生产。
一个简单版本如下:
AI 帮助改进 AI 开发
        ↓
下一代 AI 变得更强
        ↓
更强的 AI 更多参与研发
        ↓
开发周期加速
需要明确的是,当前前沿实验室并没有公开声称已经实现完全自主的智能爆炸。
人类仍然负责确定研究目标、设计训练系统、分配算力、批准高风险变更,并决定何时部署模型。
真正发生变化的是:AI 已经能够执行开发闭环中的更多环节。
Google 官方的 Gemini 3.8 公告是这一趋势已经存在的最有力证据之一。
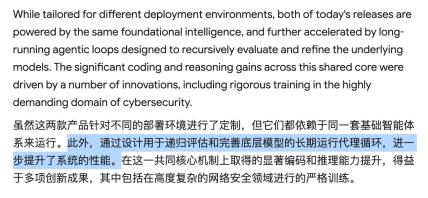
Google 表示,Gemini 3.8 Flash 和 3.8 Flash Cyber 通过用于递归评估和改进底层模型的长期运行智能体循环获得加速。
这一表述很重要,因为它直接来自 Google,而不是社区推测。
这并不意味着 Google 已经实现完全自主的 RSI。
但它确实意味着,由 AI 驱动的评估循环已经成为生产版 Gemini 模型开发流程的一部分。
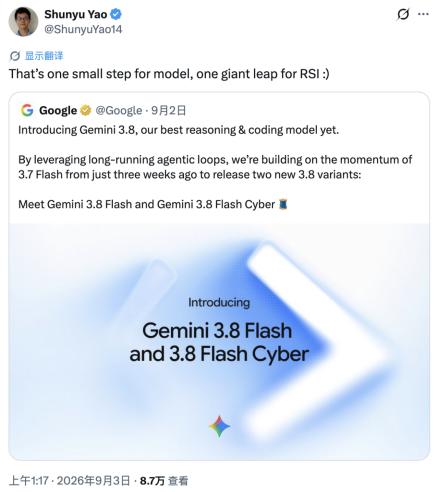
Google DeepMind 研究员 Shunyu Yao 在 3.8 发布后的一篇简短公开帖子中概括了其意义:
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这条信息借用了阿波罗 11 号的名言:对模型来说是一小步,但对 RSI 来说是一大步。
9 月 14 日,Google、Google DeepMind、马里兰大学和弗吉尼亚大学的研究人员发布了 Dream-RSI:通过演化世界实现递归自我改进。
该论文聚焦于一个具体瓶颈:智能体如何改进探索困难搜索空间的方式,而不必反复为昂贵的在线试验付费。
Dream-RSI 使用围绕既有探索历史构建的循环:
研究人员报告称,该方法在以下领域取得了改进:
这项工作比“AI 自主重新设计自身的每个部分”这一流行概念更为狭窄。
不过,它确实展示了一种真实的递归机制:系统此前的工作成为训练材料,用于改进其寻找未来改进方案的方式。
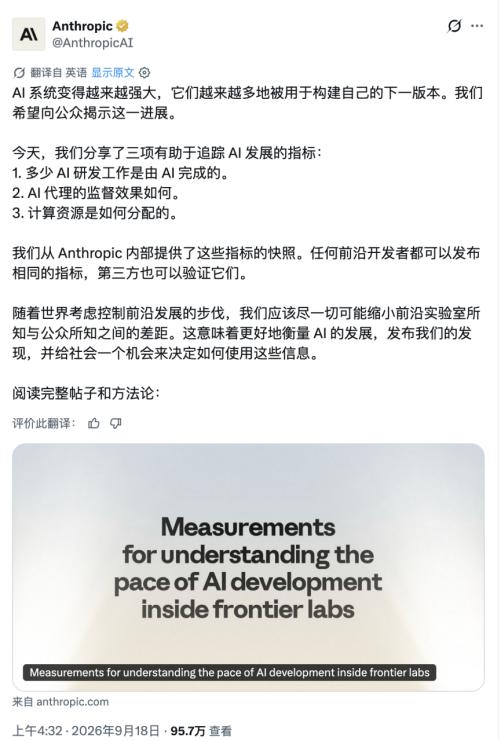
同一周,Anthropic 发布了异常详细的内部指标,展示 AI 已经在多大程度上进入其自身的研究流程。
Anthropic 表示,截至 2026 年 8 月:
Anthropic 将“AI 主导”定义为:模型根据高层级提示,在人类监督下端到端完成一项任务的大部分工作。
26% 这一数字尤其引人注目,因为 Anthropic 表示,该比例在年初还低于 1%。
Anthropic 发布这一指标,部分原因是其认为外部观察者需要更清楚地了解,前沿实验室正在多快地自动化自身的模型开发流程。
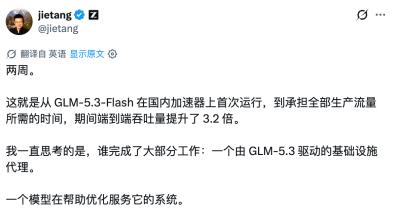
Z.ai 发布了另一个有参考价值的例子。
该公司表示,一个由 GLM-5.3 驱动的 Infra Agent 帮助构建和优化了为 GLM-5.3-Flash 提供服务的推理基础设施。
根据 Z.ai 9 月披露的信息:
Z.ai 明确表示,这不是完整的递归自我改进。
其表述更为克制:一个最低规模的循环已经出现,其中一个模型帮助优化为另一个模型提供服务的系统。
这一差别很重要。
当前系统仍然需要人类设定目标、设计反馈、约束基础设施,并审查高风险修改。
但这种循环已经不再只是理论。
来源文章的最后一部分将 RSI 与前沿 AI 领导者之间的新争论联系起来。
9 月 12 日,Anthropic 首席执行官 Dario Amodei 公开主张,行业应该放缓前沿发展节奏,让安全工作有更多时间追上模型能力的发展。
他的提议包括为独立第三方评估者提供永久性的员工级访问权限,并最终围绕能力阈值和安全措施展开更广泛的协调。
Sam Altman、Elon Musk 和 Demis Hassabis 都在不同程度上支持这样一个总体观点:在某些情况下,前沿开发可能需要更强的防护措施或更慢的推进速度。
但认同谨慎是必要的,比认同谁应该先放缓更容易。
每一家前沿实验室都面临同一个战略问题。
如果一家公司放慢能力开发,而竞争对手继续推进,它就可能失去技术领先地位、人才、客户和市场份额。
同样的逻辑也存在于国家层面。
一个考虑严格限制前沿开发的国家,可能担心竞争对手仍在继续加速。
因此,即使主要实验室都认同风险很严重,协调放缓的提议在结构上仍然很难实施。
当前的模型周期体现了这种矛盾。
Google 正在快速发布 Flash 模型,并且可能正在测试更强的隐藏检查点。Anthropic 一方面公开衡量 Claude 已经完成多少自身研发工作,另一方面也在考虑未来的模型发布。OpenAI 则继续发布前沿系统,同时扩大第三方评估和安全要求。
这并不是一个简单的矛盾。
它是一个协调问题:同一批组织可以真诚地担忧前沿风险,同时仍然面临留在技术前沿的强大激励。
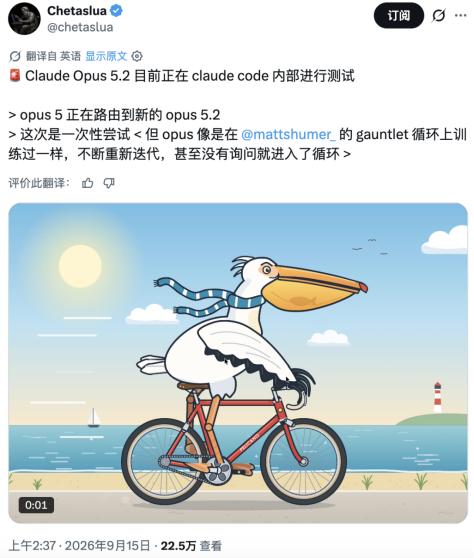
来源文章还引用了社区报告,称其他实验室可能正在现有产品界面后测试下一代模型。
一条广泛传播的帖子声称,一些 Claude Code 请求中出现了 claude-opus-5-2 标识符。
这不是 Anthropic 的官方产品公告。
同样,社区帖子也声称发现了当前已宣布产品线之外的其他 OpenAI 模型标识符。
这些报告应当与 Gemini 4 Pro 理论采用相同的判断标准:它们可以作为某些内容可能正在测试的线索,但不等同于官方发布、规格说明或发布日期。
| 说法 | 截至 2026 年 9 月 20 日的状态 |
|---|---|
| Google 于 9 月 2 日发布了 Gemini 3.8 Flash | 已确认 |
| Gemini 3.8 使用长期运行的智能体循环递归评估和改进底层模型 | Google 已确认 |
一个标记为 gemini-3.8-flash 的更强模型出现在 Arena 中 | 已有报告且被广泛观察到 |
| Arena 中的模型是 Gemini 4 Pro | 未确认 |
| Google 已正式宣布 Gemini 4 Pro | 没有 |
| Google 的公开模型文档当前列出了 Gemini 4 | 没有 |
G4P-ARGON 是真实的 Google 内部模型标识符 | 未经验证 |
| Gemini 4 Pro 拥有超过 1000 万 Token 的上下文和 256K 输出 | 未经验证 |
| 网络流传的 Gemini 4 基准测试分数是官方结果 | 不是 |
| Dream-RSI 是一篇真实存在的 2026 年 9 月研究论文 | 已确认 |
| Anthropic 表示 Claude 主导了其已测量 AI 研发工作的 26% | 已确认 |
| Anthropic 表示其已测量 AI 研发工作的 90% 以上至少有 AI 协作 | 已确认 |
| Z.ai 表示 GLM-5.3 Infra Agent 帮助将 GLM-5.3-Flash 的服务吞吐量提升了 3.2 倍 | 已确认的供应商报告结果 |
| Claude Opus 5.2 的社区目击信息代表官方发布 | 没有 |
没有。Google 尚未正式宣布 Gemini 4 Pro,其当前公开的 Gemini API 文档也没有列出 Gemini 4 模型。目前的说法基于一个能力异常强的 Arena 模型,以及社区对其身份的推测。
这个隐藏模型使用了 gemini-3.8-flash 标签,但在 SVG、网页、3D 和智能体式测试中的表现似乎强于公开的生产版模型。它更慢、更谨慎的行为也让一些测试者认为,它更像 Pro 级别的检查点,而不是 Flash 模型。
目前没有得到验证。这张网络流传的表格没有 Google 或 Arena 的官方支持,缺少可复现的评测设置,而且其中一些其他供应商模型的对比数值也与官方公布的基准测试结果并不完全一致。
递归自我改进是指 AI 系统帮助改进生产更强 AI 系统的过程,从而形成反馈循环。当前前沿实验室并没有公开声称已经实现完全自主的 RSI,但 AI 已经参与评估、编程、基础设施优化和模型研发。
Google 表示,Gemini 3.8 通过长期运行的智能体循环加速,这些循环会递归评估和改进底层模型。这是一种真实的自我改进机制,但比完全自主、无需人类监督就能设计自身后继模型的系统要狭窄得多。
Dream-RSI 是 Google、Google DeepMind 及其学术合作方于 2026 年 9 月发布的研究框架。它将此前的探索历史用作回放模拟器,让智能体能够低成本改进探索策略,然后将改进后的策略重新部署到真实环境中。
Anthropic 表示,Claude 主导了其已测量 AI 研发工作的 26%,超过 90% 的工作至少有 AI 参与协作。Anthropic 还表示,在任何已测量的工作子集中,Claude 都不是完全自治的。
如果一家公司单独放缓,就有可能被继续推进的竞争对手拉开差距。国家之间也存在同样的激励问题,这也是为什么共同评估规则和能力阈值更容易被提出,却更难真正实施。
一个名为 gemini-3.8-flash、但表现强于预期的模型出现在 Arena 中。社区测试者展示了足够多的异常输出,使 Gemini 4 Pro 理论显得具有一定 plausibility。但“具有 plausibility”并不等于已经确认:Google 尚未宣布 Gemini 4 Pro,网络流传的后端截图未经验证,在线传播的基准测试表也没有官方支持。
更持久、更重要的故事是 AI 辅助 AI 开发正在加速。Google 明确表示,Gemini 3.8 使用长期运行的循环递归评估和改进其底层模型。Dream-RSI 将自我改进探索循环进行了形式化。Anthropic 表示,Claude 已经主导其 26% 的已测量 AI 研发工作,而 Z.ai 表示,一个由 GLM 驱动的基础设施智能体帮助将 GLM-5.3-Flash 的服务吞吐量提升至原来的三倍以上。
这让行业放缓之争变得更难,而不是更容易。前沿实验室可以认同需要独立评估和更强防护措施,同时仍然面临继续推进的强大激励。
Gemini 4 Pro 仍然只是传闻;AI 系统开始帮助构建下一代 AI 的转变,已经是真实存在的趋势。
从一句话开始,几分钟内拿到完整网站。