For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
Z.ai 的一个新模型名称已悄然出现在 ZCode 中:**GLM-5.3 Highspeed**。
Z.ai 的一个新模型名称已悄然出现在 ZCode 中:GLM-5.3 Highspeed。
该模型出现在 ZCode 3.15.1 中,部分订阅用户会被随机选中参与 HighSpeed 试用。一位用户 @leo114119 发布了一次运行记录,显示输出速度接近 每秒 490 个 token,另一张截图则显示约 493 tok/s。
这是一个引人注目的数字。
如果一个模型能够持续保持每秒 490 个输出 token,生成 10,000 个输出 token 仅需约:
10,000 / 490 ≈ 20.4 秒
该计算仅涵盖 token 生成阶段,不包括首 token 时间、可见输出前的推理、工具调用、网络开销或 Agent 工作流中的停顿。
更重要的是,490 TPS 的结果目前属于社区观察结果,而不是 Z.ai 对吞吐量的官方保证。
可以确认的是,ZCode 3.15.1 已为订阅用户引入随机 GLM HighSpeed 试用,并且 glm-5.3-highspeed 标识符已出现在 Pi 的公开模型目录中。
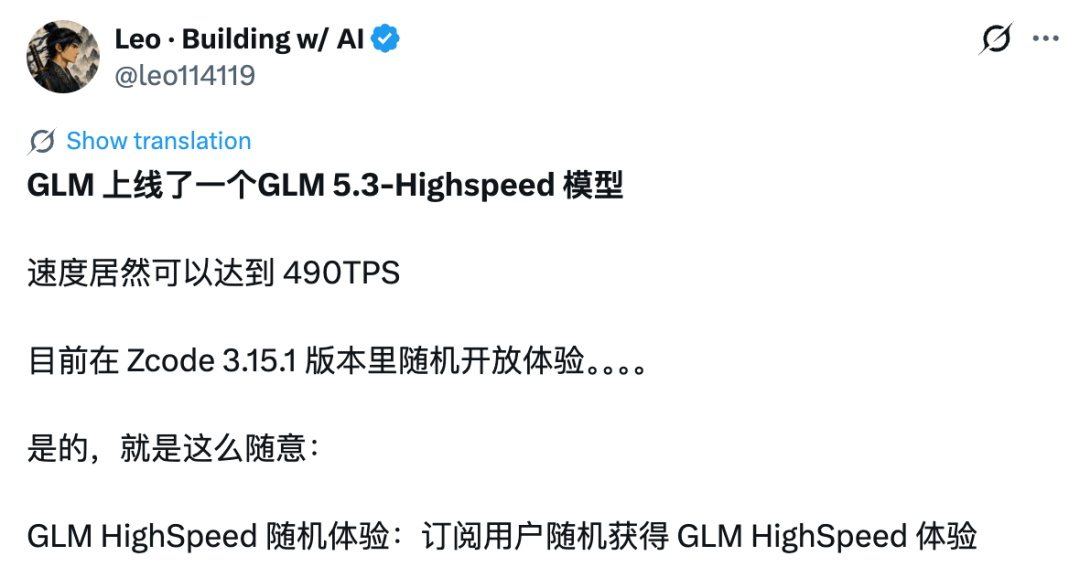
第一个线索并不只是一张社交媒体截图。
ZCode 3.15.1 版本的官方更新说明写道:
订阅用户现在可能被随机选中参与 GLM HighSpeed 试用。
这一措辞很重要,因为它解释了为什么不同账户的访问权限并不一致。
来源文章称,作者尝试手动添加并切换到 GLM-5.3 Highspeed,但无法通过 Lite 订阅使用它。
界面显示该模型存在,但当前套餐不包含访问权限。
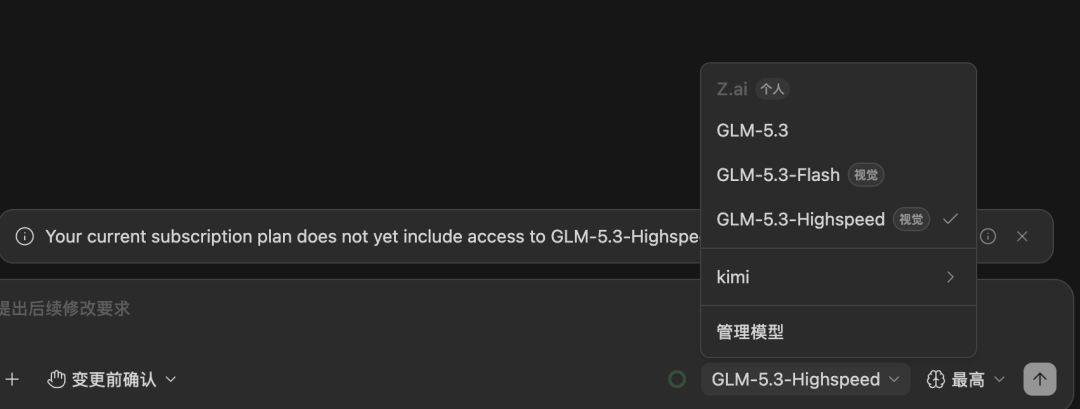
这与 ZCode 当前的发布策略一致:
更新至 ZCode 3.15.1
        ↓
订阅用户账户
        ↓
随机获得 HighSpeed 试用资格
        ↓
如果被选中,客户端中将显示试用访问权限
目前并未将其描述为自动向每个付费套餐开放的功能。
一张总结 ZCode 自身措辞的社区截图也表达了相同观点:HighSpeed 体验是随机分配给订阅用户的权益,客户端是确认特定账户是否被选中的唯一可信来源。
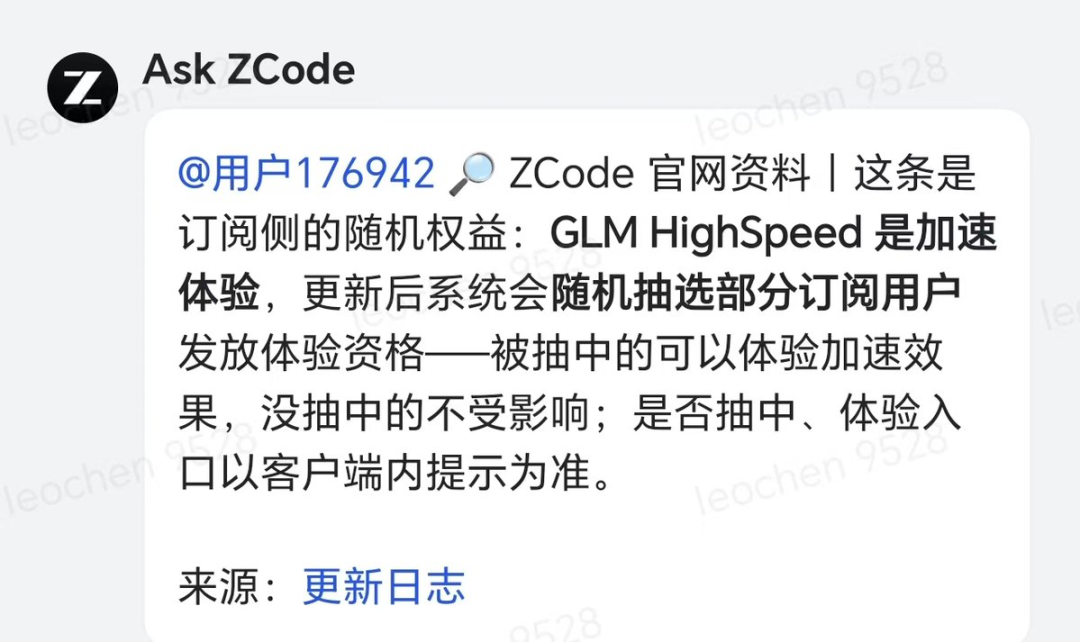
该模型获得关注的最大原因是这张速度截图。
来源用户发布的一次运行显示约 493 tok/s。
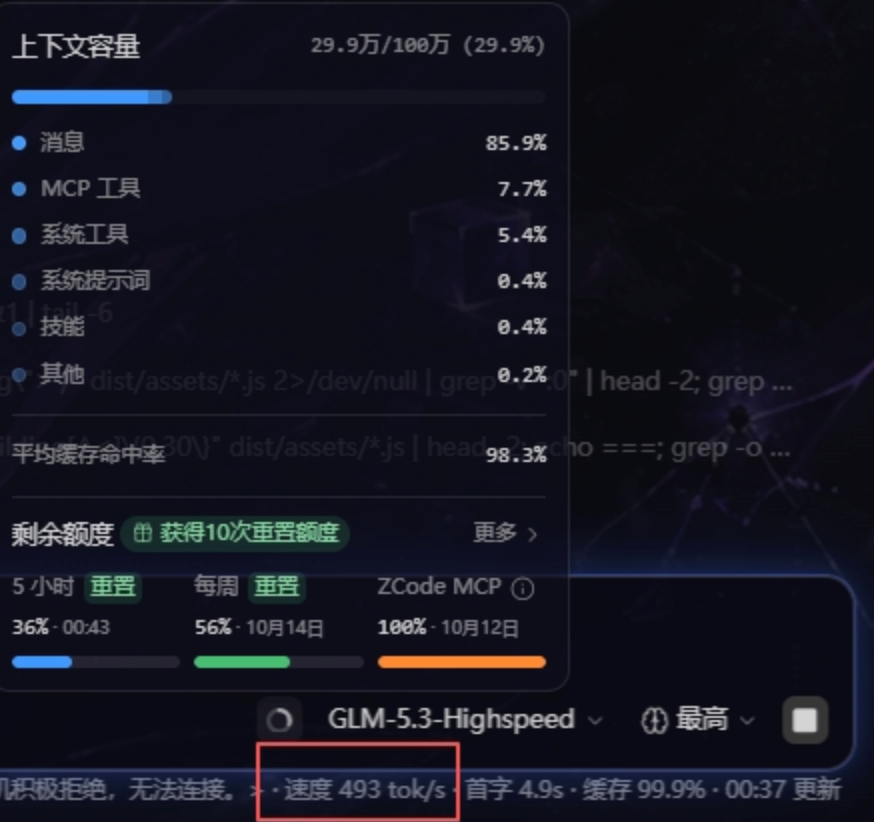
这与文章标题中的 490 TPS 已足够接近,两者差异并不具有实际意义。
但准确理解这张截图说明了什么、又不能说明什么,仍然很有必要。
GLM-5.3-Highspeed 的 ZCode 会话。吞吐量可能在很大程度上取决于:
因此,目前更恰当的结论是:
GLM-5.3 Highspeed 已在至少一项公开 ZCode 测试中展示出极高的输出吞吐量,但 Z.ai 尚未发布正式的 490 TPS 规格说明。
这个数字之所以突出,是因为 GLM 系列已经有多个面向速度的服务选项。
Z.ai 的文档称,GLM-5.3-FlashX 的速度最高可达 200 tokens/s。FlashX 是 GLM-5.3-Flash 的高速服务变体。
Pi 和 Z.ai 文档列出,GLM-5.3-Flash 拥有 100 万 token 上下文窗口和 128K 级最大输出,而 FlashX 则重点优化更低服务延迟和更快生成速度。
原始文章还引用了 Artificial Analysis 的测量数据:在写作时,GLM-5.3-Flash 在 Z.ai 第一方 API 上约为每秒 60 个 token。
独立吞吐量测量会随时间变化,后续快照也会因提供商和日期不同而存在明显差异,因此不应将单一数字视为永久不变。
因此,一个有用的对比如下:
| 模型 / 服务路径 | 报告或文档中的速度 | 状态 |
|---|---|---|
| ZCode 中的 GLM-5.3 Highspeed | 用户截图中约为 490–493 tok/s | 社区观察 / 随机试用 |
| GLM-5.3-FlashX | 最高 200 tok/s | 公开文档中的速度导向变体 |
| Z.ai API 上的 GLM-5.3-Flash | 在独立第一方快照中低得多 | 独立测量结果会随日期/提供商而变化 |
这一差距足够大,因此人们自然会想知道“Highspeed”到底意味着什么。
glm-5.3-highspeed该模型名称并不只出现在 ZCode 中。
Pi 的公开模型目录已经拥有 GLM-5.3 Highspeed 的页面。
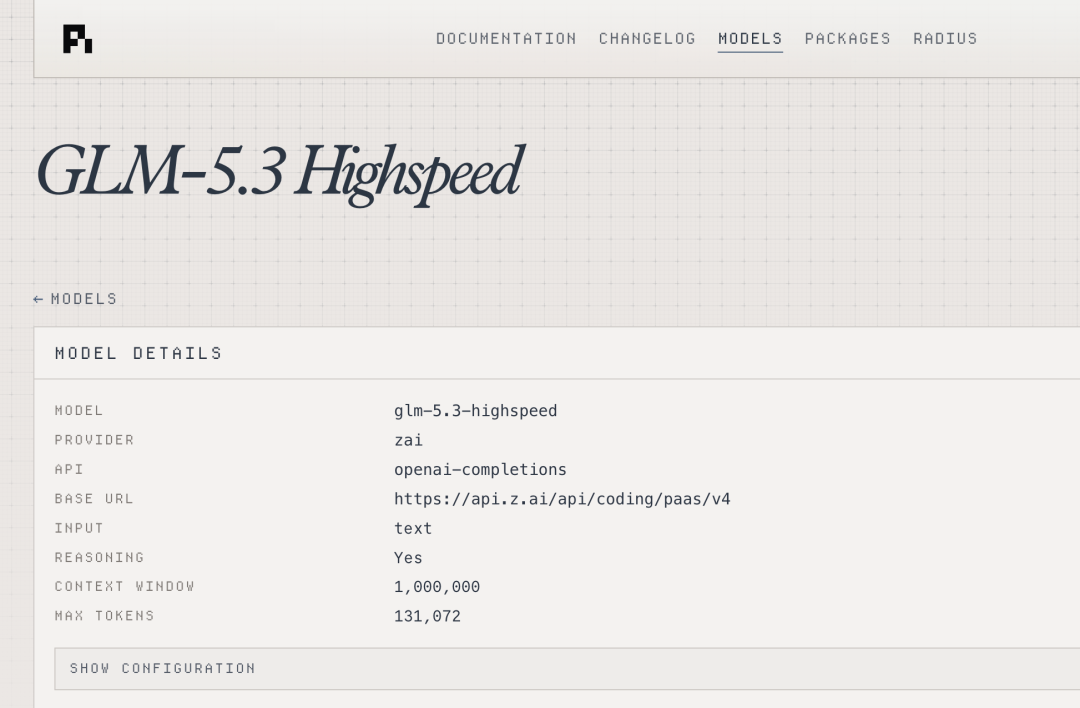
列出的配置为:
| 字段 | 值 |
|---|---|
| 模型 ID | glm-5.3-highspeed |
| 提供商 | zai |
| API 风格 | 兼容 OpenAI 的 completions |
| 输入 | 文本 |
| 推理 | 是 |
| 上下文窗口 | 1,000,000 token |
| 最大输出 | 131,072 token |
| 推理级别 | low / high / max |
Pi 显示的端点为:
https://api.z.ai/api/coding/paas/v4
Pi 还将该模型映射至 Z.ai 的编程 API 格式。
其中有两个细节尤其值得注意。
这与当前 GLM-5.3 系列工具中的长上下文配置一致。
对于编程 Agent,100 万 token 上下文可用于:
这约等于 128K token。
同样,这与多个 GLM-5.3 系列当前条目的长输出配置一致。
因此,Pi 的条目并未表明其上下文架构与普通 GLM-5.3 产品线明显不同。
它主要确认了 Highspeed 标识符真实存在,且已具备结构化的提供商配置。
Pi 映射了三个可用推理设置:
low
high
max
来源文章指出,这些设置也常见于常规 GLM-5.3 配置。
这进一步说明,我们不应假定 Highspeed 是一个全新的基础模型。
它可能是:
在没有 Z.ai 模型卡的情况下,目前还无法有把握地区分这些可能性。
仅凭名称并不足以说明问题。
这部分故事开始进入推测范畴。
在 ZCode 截图出现之前,Reddit 用户已经在 Pi 目录中注意到 glm-5.3-highspeed,并询问它是否可能与 Omen Alpha 有关。
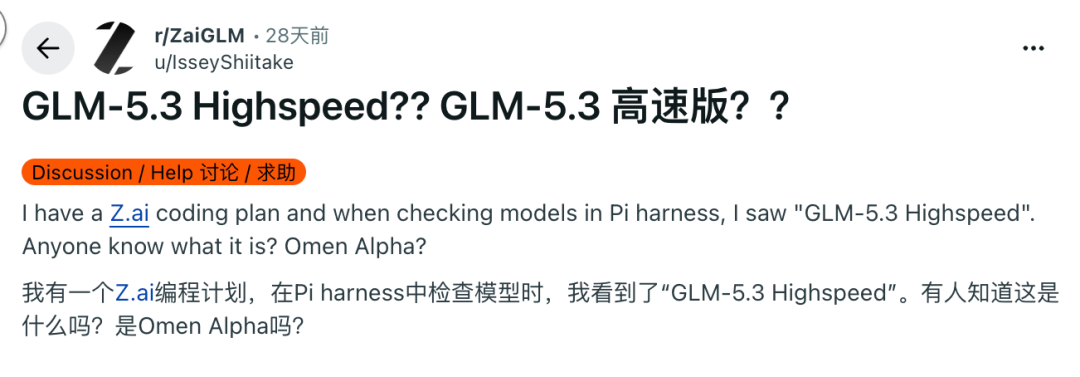
Omen Alpha 是一个出现在 OpenCode 测试中的匿名模型。
社区成员此前已根据观察到的行为和基础设施线索,将其与智谱/Z.ai 联系起来。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
一条 Reddit 回复推测,它可能是一个新的高速 GLM 变体,其质量接近 GLM-5.3-Flash,但吞吐量高得多。
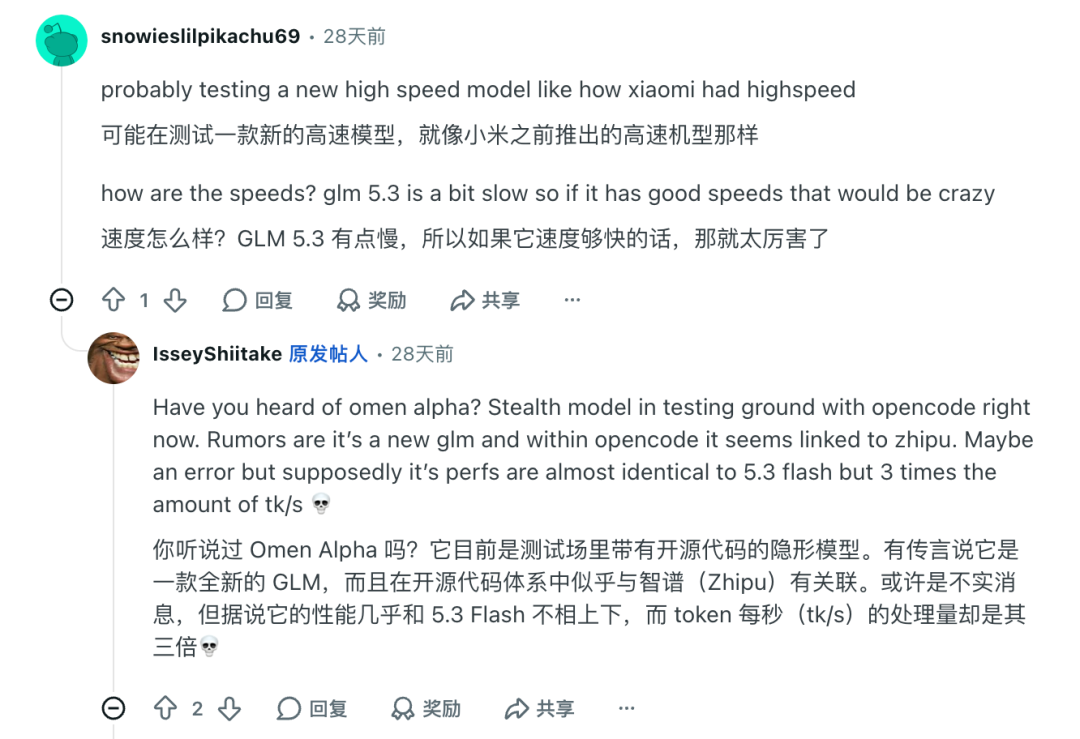
另一张来源截图显示,一个 omen-alpha 模型条目连接至与智谱相关的提供商标签,这也助长了这一理论。
但这些信息都不能确凿证明其身份。
原始文章列出了多种猜测:
在 Z.ai 发布官方映射之前,这些名称都应继续被视为社区推测。
即使两个端点的使用感受非常相似,它们也可能并非同一模型。
观察到的行为可能受到以下因素影响:
因此,行为相似性可以作为证据,但不能作为证明。
对于智谱而言,这一名称本身并不反常。
该公司此前已经推出过 GLM 模型的高速版本。
来源文章提到 GLM-5.1-highspeed,该版本于 2026 年 5 月宣传输出速度约为每秒 400 个 token。
较新的 GLM-5.3 系列也拥有 FlashX,这是一个公开的速度导向变体,其文档标注最高可达 200 tokens/s。
这表明了一种更广泛的产品模式:
基础模型或旗舰模型
        ↓
高速服务路径
        ↓
为交互式工作负载提供更低延迟 / 更高吞吐量
即使不假定采用了新模型权重,这一模式也使 GLM-5.3 Highspeed 在技术上具备合理性。
但这仍然是一种推断,而非官方产品描述。
为什么要关注 490 TPS?
对于 200 token 的简短回答,100 TPS 与 500 TPS 的差异仅是几秒钟。
但对于长 Agent 输出、代码生成或冗长推理,这一差异会大得多。
例如:
| 输出长度 | 100 tok/s | 200 tok/s | 490 tok/s |
|---|---|---|---|
| 1,000 token | 10.0 秒 | 5.0 秒 | 约 2.0 秒 |
| 5,000 token | 50.0 秒 | 25.0 秒 | 约 10.2 秒 |
| 10,000 token | 100.0 秒 | 50.0 秒 | 约 20.4 秒 |
这些仅是简化后的解码时间计算。
真实的 Agent 任务还包括:
尽管如此,更快的解码速度仍可使长时间的迭代工作流显得响应更迅速。
这对于 ZCode 等编程 Agent 尤其相关,因为一次用户请求可能会生成多次模型调用,而不只是一个最终回答。
约 493 tok/s 的截图还显示出极高的缓存命中率。
这一点值得注意。
在长 Agent 会话中,高缓存命中率能够减少重复处理提示词所需的计算量。
一次典型的编程会话可能会反复携带:
系统指令
+ 代码仓库上下文
+ 工具定义
+ 先前对话
+ 最近差异
如果其中大量上下文得以高效复用,系统就可以减少每轮重新计算输入部分所花费的时间。
不过,显示的 tok/s 指标通常是指输出生成吞吐量,而不只是提示词缓存吞吐量。
缓存数字仍然很重要,因为当提示词复用和快速解码同时发挥作用时,整体会话延迟可能会显著改善。
这也是为什么一张截图无法完整描述该模型的另一个原因。
GLM-5.3-FlashX 提供了最清晰的公开对比,因为 Z.ai 文档已经将其描述为面向速度的模型。
目前已发布的 FlashX 信息包括:
glm-5.3-flashx。因此,FlashX 表明 Z.ai 已经愿意打造专门的高吞吐量变体,而不会将其描述为全新一代智能模型。
GLM-5.3 Highspeed 可能遵循相同产品逻辑,只是处于更快的服务层级。
这仍然是一种推断,而非官方产品说明。
目前证据可以分为三个置信度层级。
glm-5.3-highspeed 列为 Z.ai 模型。这是目前解读本次发布最稳妥的方式。
GLM-5.3 Highspeed 是一个已出现在 ZCode 和 Pi 公开模型目录中的 Z.ai 模型标识符。ZCode 3.15.1 已正式确认面向订阅用户的随机 GLM HighSpeed 试用,但在此处核查的来源中,Z.ai 尚未为 GLM-5.3 Highspeed 发布完整的独立模型卡。
一张公开用户截图显示,一次 ZCode 运行的速度约为 493 tok/s,这也是 490 TPS 标题的依据。这是一个有价值的观察结果,但并非官方的持续吞吐量保证;其表现可能随工作负载、缓存行为、地区和服务器条件而变化。
Pi 目前为 glm-5.3-highspeed 列出了 1,000,000 token 的上下文窗口和 131,072 token 的最大输出。这些数值与其他当前 GLM-5.3 系列模型的长上下文配置相似。
不能。ZCode 的官方 v3.15.1 更新日志称,订阅用户会被随机选中参与 GLM HighSpeed 试用。如果你的账户未被选中,即使看到模型名称,也不一定意味着你可以运行它。
目前没有官方确认表明它们是同一产品。FlashX 是一个公开的 GLM-5.3-Flash 高速变体,文档标注速度最高可达 200 tok/s;而 GLM-5.3 Highspeed 目前则通过 ZCode 试用和 Pi 的编程提供商目录出现。
这仍属于推测。Reddit 和 OpenCode 用户曾将 Omen Alpha 与智谱/Z.ai 联系起来,但没有官方来源确认 Omen Alpha 对应 glm-5.3-highspeed。
编程 Agent 在读取文件、编写补丁、运行工具和审查结果时,通常会进行多次较长的模型调用。更高的解码吞吐量可以减少这些步骤之间的等待时间,特别是在模型每次调用生成数千个 token 时。
更新至包含该试用功能的当前 ZCode 客户端后查看。ZCode 自身的更新说明指出,访问权限会随机分配给订阅用户,因此账户/客户端界面是判断资格的实际可信来源。
glm-5.3-highspeed 的提供商配置。GLM-5.3 Highspeed 已不再只是一个偶然出现的模型名称:ZCode 3.15.1 已正式确认面向订阅用户的随机 GLM HighSpeed 试用,Pi 也已经展示了结构化的 glm-5.3-highspeed 配置,包括 100 万 token 上下文窗口和 131,072 token 输出上限。
引人注目的 490–493 tok/s 数字来自一张真实的公开截图,但它仍然是用户观察结果,而不是 Z.ai 的正式吞吐量保证。最稳妥的解释是,Z.ai 正在测试一条极快的编程服务路径,尚未发布完整产品规格。
Omen Alpha 之间的关联仍未得到解决。它最终可能被证明与此相关,但目前的证据是间接的、由社区驱动的,而不是官方确认。
目前确认的是发布试用和模型标识符;尚未确认的是准确架构、公开定价、持续吞吐量,以及 Omen Alpha 是否为同一模型。
从一句话开始,几分钟内拿到完整网站。



