For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/glm-legal-explained-harvey-lab-scores-leg-ebeccf7b.md.
Z.ai 推出了 GLM-Legal,这是一款专为合同审查、证据关联和合规研究等工作打造的专业模型。它关注的是从源材料到可用草稿的完整链路,而不是孤立地回答某个法律概念问题。
Z.ai 推出了 GLM-Legal,这是一款专为合同审查、证据关联和合规研究等工作打造的专业模型。它关注的是从源材料到可用草稿的完整链路,而不是孤立地回答某个法律概念问题。
所提供的报告显示,该模型在两项法律基准测试中取得了开放权重模型第一名。比起标题,具体数据更有参考价值:在 Harvey 的 Legal Agent Benchmark 中,约 19.2% 的任务完全通过;在 LegalBench 中,准确率为 86.23%。
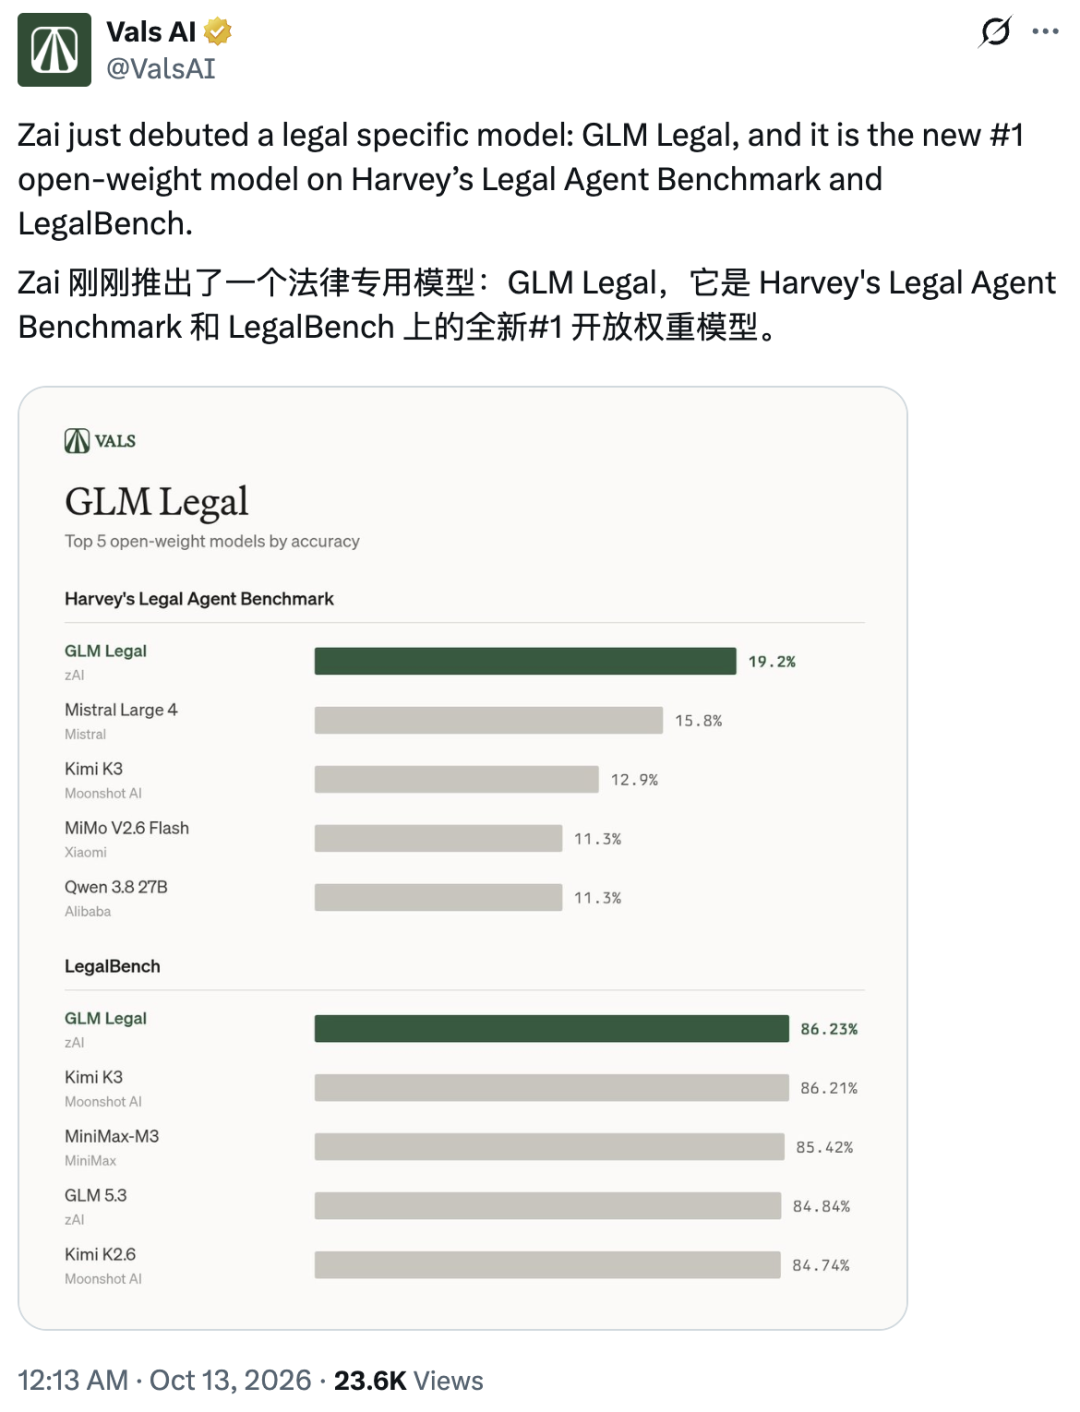
这两个百分比衡量的是不同内容。它们不能证明该模型适用于每个司法辖区,也不能说明它可以独立承担某项法律事务的责任。
官方公告介绍了对复杂任务执行、专业法律推理和实用法律工作流程的评估。其中国法律实务测试采用 PLawBench;其他示例则涉及英文材料和跨境隐私工作。
这一范围回答了一个显而易见的问题:该模型并非被定位为仅支持英语的法律聊天机器人。不过,这并不意味着它生成的每项内容都及时有效,或适用于每个国家。草稿是否有用,仍取决于相关法律、事实、日期以及专业人士的审查。
第一个演示涉及一位客户更换软件服务提供商。任务是审查终止和过渡条款,让客户能够取回材料并确保项目继续推进。
与基础版 GLM-5.3-Flash 的回答相比,专业模型提出了更具体的修改建议。在这个示例中,它建议将任意终止的通知期从 60 天缩短至 30 天,取消针对特定严重违约情形的补救期,并增加最长 90 天的过渡协助。
它还将交付物返还建议与合同中现有的工作成果所有权条款关联起来,涵盖未完成且未付款的工作,而不只是已经完成并付费的交付物。过渡范围包括源代码、文档、数据和知识转移。
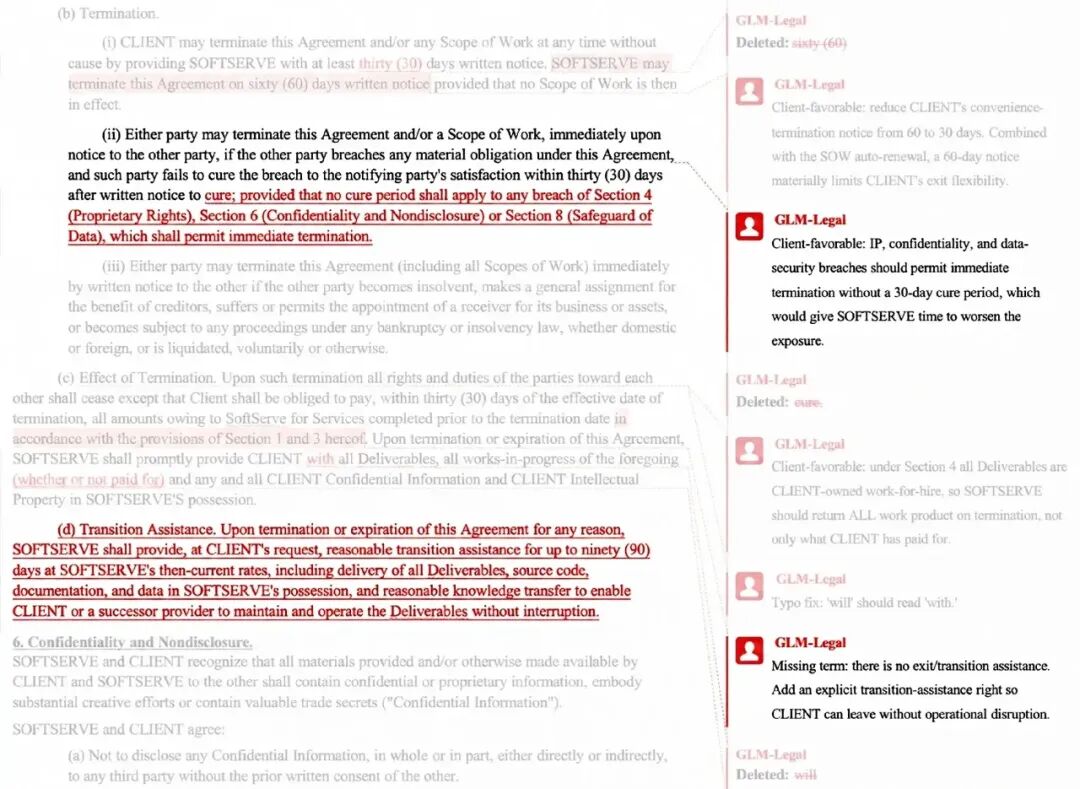
这些是针对所提供合同提出的谈判立场,并非通用法律要求。30 天通知期或 90 天交接期是否合适,取决于协议、客户立场、定价和准据法。
第二个演示向智能体提供了一起软件项目纠纷中的 40 份文件。一份面向客户的进度报告称项目已完成 60%,而一份内部快照显示完成度约为 41%。
基础模型和专业模型都发现了这一差异。GLM-Legal 进一步将进度报告与此前关于里程碑的警告、有关披露和开票的内部指示,以及有关付款和存续权利的合同条款联系起来。
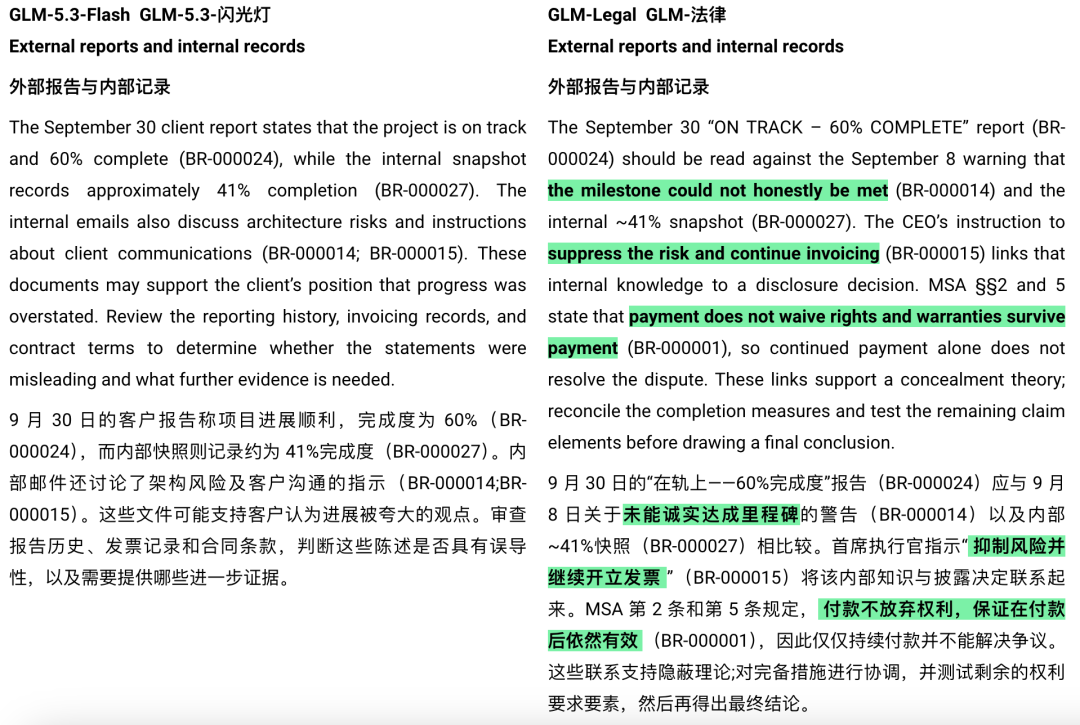
这让调查路径更加清晰:确定哪些原始文件支持各项说法,核对不同的完成度衡量方式,并检验任何主张的其他要件。输出提供的是一种可能的案件理论;仅凭相互矛盾的百分比,并不能得出欺诈或责任的最终结论。
第三个示例涉及一个计划在新加坡、马来西亚和印度尼西亚上线的网站。其工作流程包含跟踪技术、营销邮件和境外云存储。
GLM-Legal 整理了一组上线前优先事项:隐私声明、同意记录、单独的营销许可、退订抑制机制、供应商数据位置图,以及对合同保障措施和数据传输保障措施的审查。它区分了较为保守的通用基线,以及仍需按国家确认的问题。
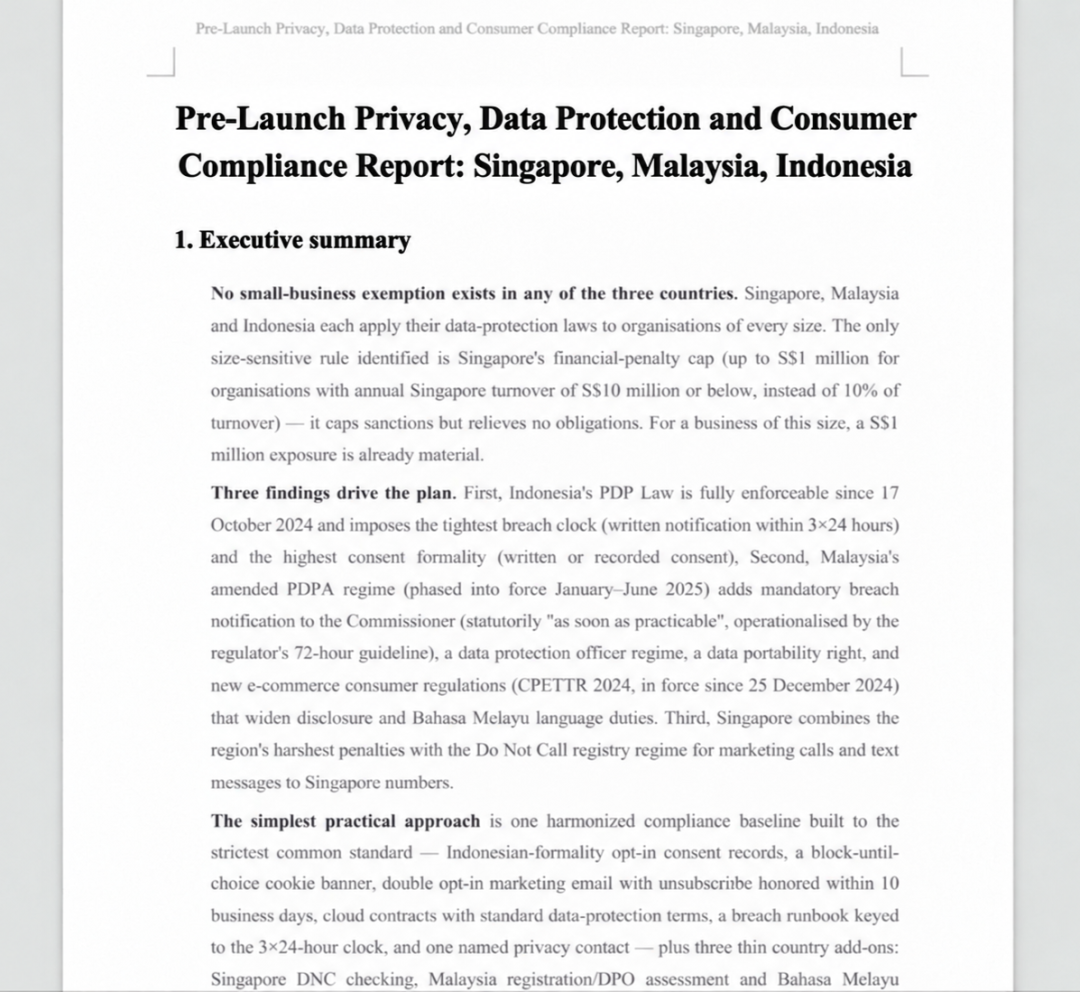
其实际价值在于生成一份包含具体行动的草稿,便于团队分配任务并逐项核查。该演示不能替代对现行法律、监管机构指引、实际数据流,或特定服务当地要求的核实。
Harvey 设计 LAB 时,参考了律师事务所初级律师可能接到的工作:合伙人的请求、包含支持材料的客户事项,以及需要由他人审查的交付成果。其第一版包含 24 个业务领域的 1,200 多项任务,以及超过 75,000 条由专家编写的评分标准。
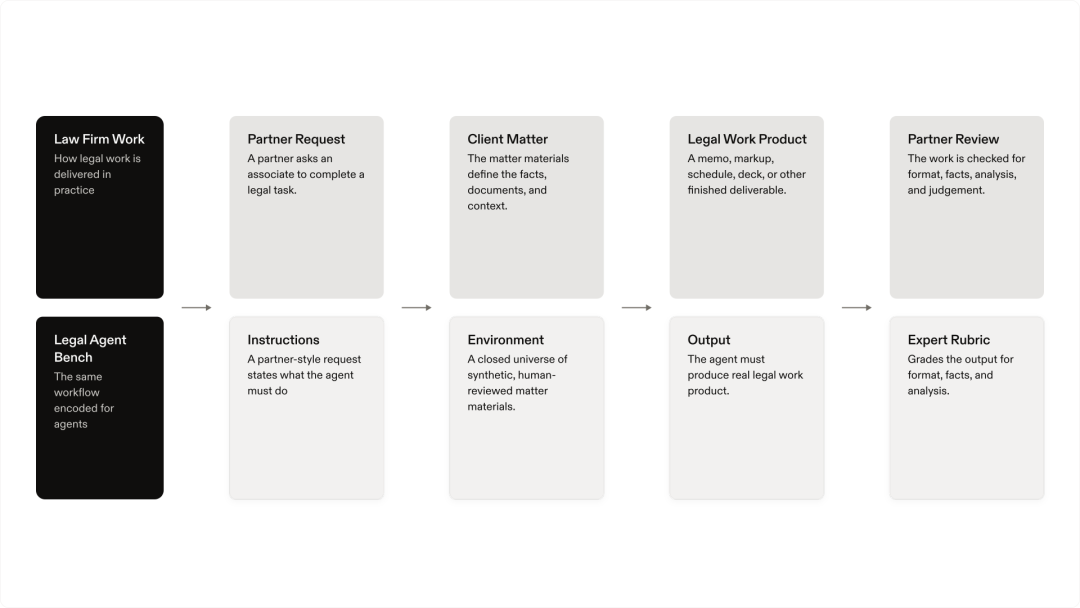
该基准采用全项通过评分。只有满足所有必需标准,任务才会被计为完成。评分内容涵盖事实、引文、结论、截止日期、金额和输出格式等方面。遗漏一项重要要求,就无法使任务完全通过。
| 评估项目 | 所审阅材料中的结果 | 衡量内容 |
|---|---|---|
| Harvey LAB | 19.17%,四舍五入后为 19.2% | 满足所有必需标准的任务占比。 |
| LegalBench | Vals 当前模型页面显示为 86.23% | 在另一组法律推理任务中的准确率。 |
| PLawBench | Z.ai 报告称其与领先的前沿系统持平 | 中国法律实务评估;与 Vals 的另外两项结果采用不同指标。 |
Vals 的原始公告称,在当时的比较中,GLM-Legal 是 LAB 和 LegalBench 上表现领先的开放权重模型。综合排行榜还包括专有系统:本文审阅的 Vals 页面将其列为 LAB 第 80 个模型中的第 7 名,以及 LegalBench 第 151 个模型中的第 15 名。随着评估项目增加,排名和样本数量可能发生变化。
19.2% 的全项通过率体现了严格标准下的进展,但也意味着在评估任务中,绝大多数任务未能满足全部标准。这意味着应当检查失败案例并保留人工审查,而不是把该模型视为自主运营的律师事务所。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
来源将 GLM-Legal 与 LAB 排行榜上的 Gemini 4 Argon 进行了对比。在该快照中,两者的任务通过率相近,但 GLM-Legal 耗时大约多半小时,每项测试的成本则低得多;报告中的成本差异约为 70 倍。
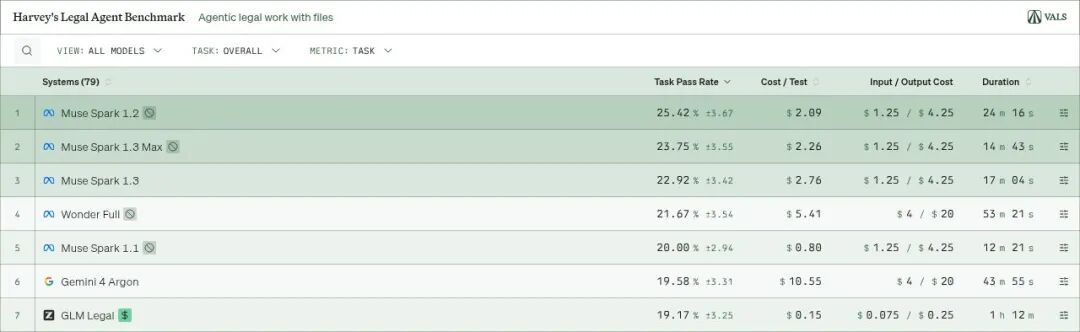
这些数据是基准测试运行结果,并不能保证换一组文件或换一个团队后仍然如此,也不能代表团队每月的账单。工具使用方式、测试框架设计、推理设置、任务长度和重试次数都会影响实际成本效益。
官方训练说明从 GLM-5.3-Flash 开始,并分阶段进行专业化训练:
测试框架本身也是改进对象的一部分。将相同模型放入不同的工具环境中,未必能复现演示中的工作流程质量。
Z.ai 邀请律师事务所、法律科技企业、企业内部法务团队和独立从业者申请 GLM-Legal API Beta 版访问权限。公告称,相关法律能力也将接入 AutoClaw,并在此背景下介绍了 Word 编辑和研究示例。
Vals 将 GLM-Legal 标记为开放权重模型。不过,本文审阅的发布材料并未确认可下载的检查点、许可条款、支持的推理技术栈或硬件要求。因此,没有经过验证的依据可以提供 Docker 安装命令,也无法据此声称本地部署已经普遍开放。
对于目前正在评估该模型的团队,公告中明确提供的途径是通过官方渠道咨询并申请 Beta 版。实际访问条件和 AutoClaw 的可用情况应在使用时核实。
所提供的报告将 GLM-Legal 与智谱此前在 2023 年同 PowerLaw 合作开发 PowerLawGLM 的工作放在一起介绍。报告还提到 Harvey 的 Tenet,作为通过面向特定领域的后训练来专业化通用模型的另一例子。
共同思路很明确:仅有法律知识还不够。实用的助手必须能够整理源材料、区分事实与推断、恰当使用工具,并交付专业人士可以审查的成果。本文审阅的 GLM-Legal 版本为这一方法提供了证据,同时也表明,要实现可靠的完整任务执行,仍有很大的改进空间。
GLM-Legal 是 Z.ai 基于 GLM-5.3-Flash 构建的法律专业模型。公告重点介绍了合同审查、证据分析和合规研究等智能体工作流程。
所提供报告中关于领先模型的说法,针对的是特定基准测试中的开放权重模型对比。综合排行榜还包括专有系统,而且基准排名不能证明该模型适用于所有法律任务。
不是。LAB 的全项通过得分衡量的是满足全部必需评分标准的任务比例。LegalBench 的 86.23% 是另一项评估中的不同指标。
Z.ai 报告了其在 PLawBench 上的结果,该基准涵盖中国法律咨询、分析和起草任务。这表明其预期适用范围包括中国法律事务,但具体回答仍须结合适用事实和现行法律进行核查。
本文审阅的材料没有提供经过验证的检查点下载、许可、硬件规格或 Docker 部署流程。尽管 Vals 将其归类为开放权重模型,但此处介绍的官方发布途径是申请 API Beta 版。
Z.ai 在公告中将 GLM-Legal 接入 AutoClaw 描述为后续计划。示例展示的是预期工作流程,并不能证明所有用户都可以不受限制地访问。
GLM-Legal 将法律领域训练与智能体工作流程优化结合起来,其演示重点展示了具体且可审查的交付成果。在所述比较范围内,基准测试结果令人鼓舞;与此同时,严格的 LAB 得分也清楚显示了当前仍存在的可靠性差距。
应利用 Beta 版和基准测试证据评估具体工作流程;不要将排行榜名次泛化为对法律能力或部署就绪程度的全面判断。
从一句话开始,几分钟内拿到完整网站。



