For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/gpt-5-6-sol-vision-benchmark.md.
Roboflow 基准显示,GPT-5.6 Sol 的物体检测成绩从 GPT-5.5 的 13.8 mAP@50 提升至 46.2,计数准确率达到 73%。但 OCR、定向文本提取、大图定位、成本与延迟仍有限制,生产部署应按任务选择模型。
GPT-5.6 Sol 可能是 OpenAI 近期在实用视觉理解能力上幅度最大的一次跃升。
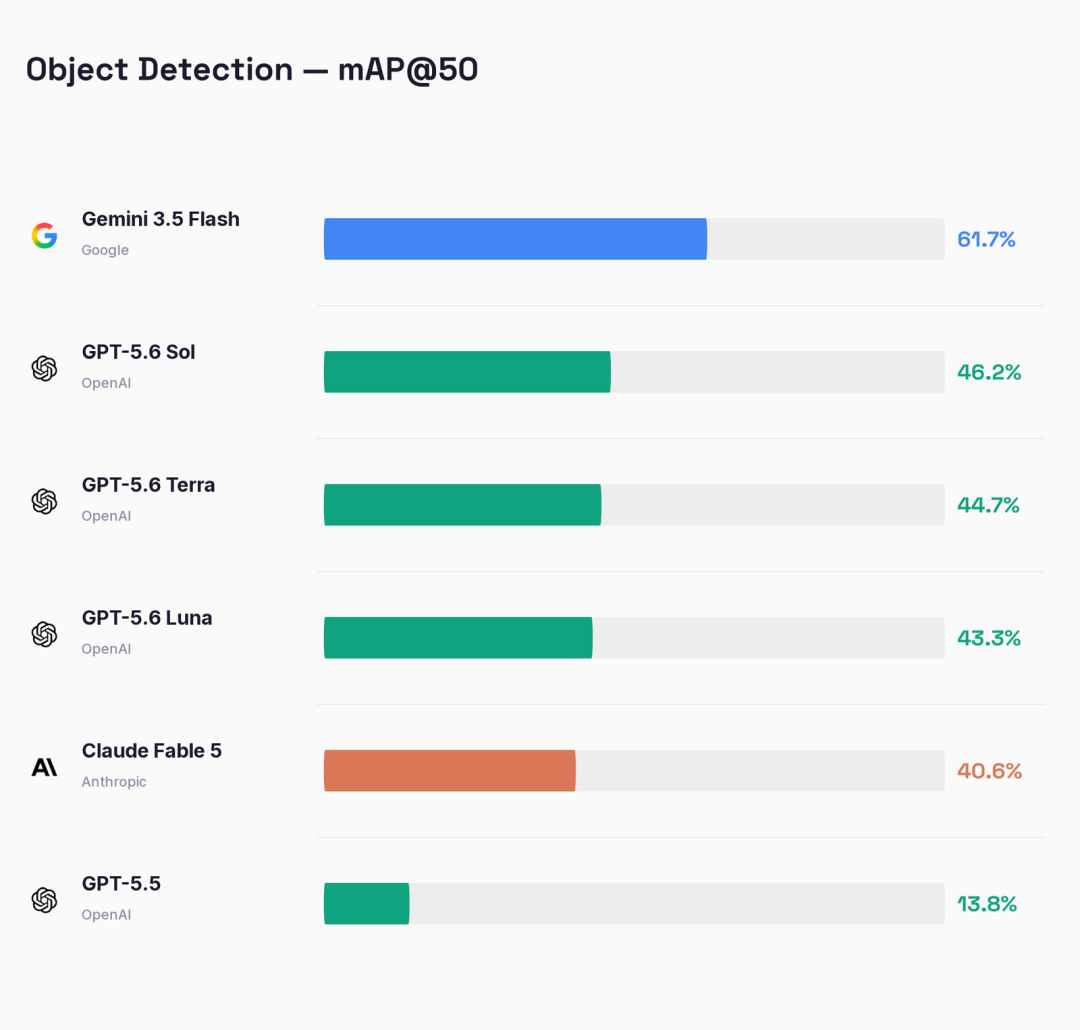
Roboflow 在一项涵盖物体检测、物体计数、OCR 和定向数据提取的视觉语言模型基准测试中,对 GPT-5.6 系列的 Sol、Terra 和 Luna 进行了测试。最引人注目的结果来自物体检测:GPT-5.5 的成绩仅为 13.8 mAP@50,而 GPT-5.6 Sol 达到 46.2,在 Roboflow 发布期的基准测试中比前代提高了三倍以上。
Terra 和 Luna 同样大幅提升,分别达到 44.7 和 43.3。
Roboflow 的 Piotr Skalski 称 Sol 是截至当时 OpenAI 发布过的最强视觉模型。这个结论仅适用于 Roboflow 的评测,不应被理解为它在所有计算机视觉工作负载中都排名第一,但相较 GPT-5.5 的提升确实非常明显。
不过,各项能力的提升并不均衡。Sol 在物体定位、计数、空间约束理解和文档区域检测方面进步显著,但并非在每项 OCR 类任务中都优于 GPT-5.5。它在超大图像上还存在一种特定故障模式:边界框可能变得不稳定。
因此,实际情况比一句“最强视觉模型”更有参考价值:GPT-5.6 执行视觉任务的能力显著增强,但模型选择仍取决于准确率、延迟、成本、图像尺寸和具体任务。
物体检测一直是通用 GPT 模型相对薄弱的领域。
这项任务听起来很简单:识别图像中的每个目标物体,并返回包围它的边界框。实际操作中,视觉语言模型必须正确理解目标类别、定位每个实例、按要求的格式生成坐标,同时避免重复检测或边界框错位。
在 Roboflow 的基准测试中,GPT-5.5 在这方面表现很差。
GPT-5.6 改变了这一局面。
| 模型 | 物体检测 mAP@50 |
|---|---|
| Gemini 3.5 Flash | 61.7 |
| GPT-5.6 Sol | 46.2 |
| GPT-5.6 Terra | 44.7 |
| GPT-5.6 Luna | 43.3 |
| Claude Fable 5 | 40.6 |
| GPT-5.5 | 13.8 |
这些数值来自原文所讨论的 Roboflow 基准快照和 2026 年 7 月的 Roboflow 分析。随着数据集、测试工具、模型版本和排行榜方法调整,Roboflow 的实时基准结果也可能发生变化。
文档版面分析是最实用的案例之一。
Sol 能够识别以下区域:
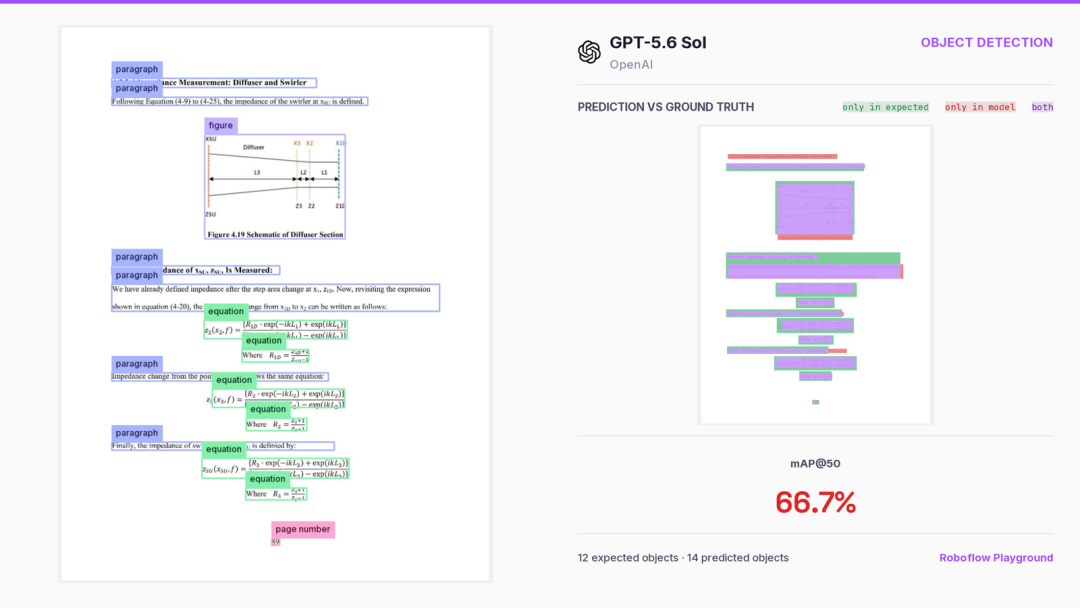
这对文档处理流程很重要,因为 OCR 往往不是第一步。
典型系统首先需要回答:
这页文档中,相关内容位于哪里?
只有确定位置后,转录文本、提取日期、读取表格或将某一区域交给专用解析器才有意义。
因此,对于合同、发票、表单、报告和扫描 PDF,更准确的区域检测可以改善整个下游工作流。
Roboflow 发现,当物体检测提示词要求模型返回绝对 XYXY 像素坐标时,GPT-5.6 的表现最佳。
这个细节很容易被忽视。
根据 Roboflow 的测试,使用错误的坐标表示方式会使 GPT-5.6 的检测成绩降低约 15 个 mAP 点。Gemini 3.5 Flash 的情况不同,它在使用 0 至 1000 范围的归一化 YXYX 坐标时表现最好。
这意味着,无论是基准测试还是实际生产效果,都可能在很大程度上取决于要求模型使用的输出格式。
因此,实用的 GPT-5.6 检测指令应明确指定坐标约定,而不是含糊地要求返回“边界框”。
对基于 VLM 的物体检测来说,密集图像处理难度很高,因为模型通常要以文本形式输出物体标签和坐标。
物体越多,输出就越长,也就越容易出现以下问题:
Roboflow 测试了许多外观相似的物体紧密排列在一起的场景,包括药片和鸡蛋。
Sol 处理这些案例的表现远胜于 OpenAI 之前的模型。
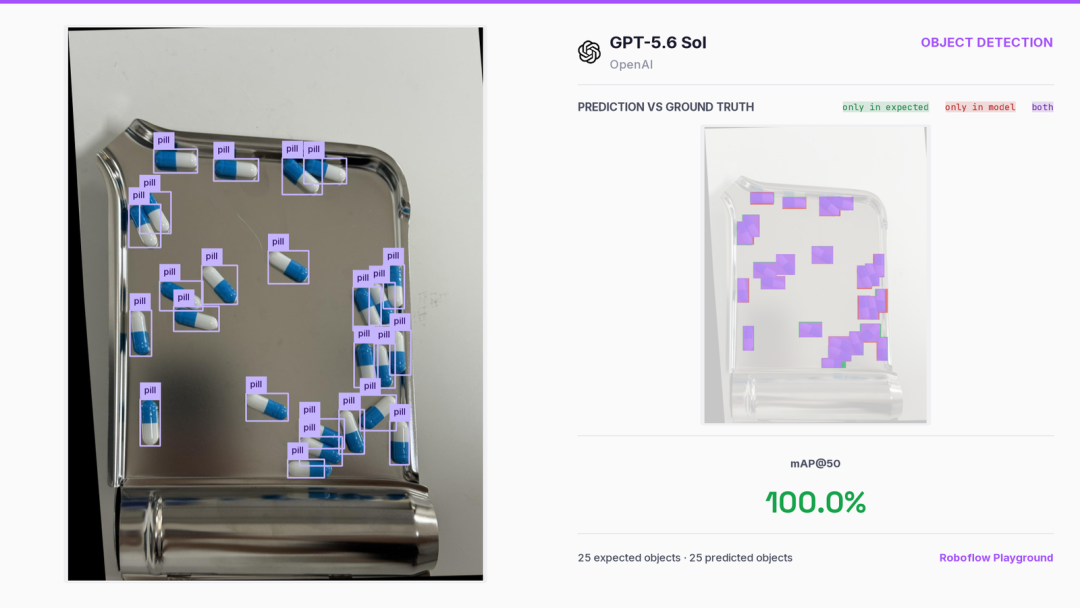
这一结果表明,GPT-5.6 正在从简单识别图像整体内容,迈向更结构化的定位工作。
这并不意味着它可以替代所有专用检测器。在受限的生产环境中,专用物体检测模型仍可能更快、更便宜、更易校准或更可靠。但通用多模态模型与专用视觉管线之间的差距正在明显缩小。
Sol、Terra 和 Luna 的计数能力都得到了改善。
Roboflow 报告的结果如下:
| 模型 | 计数准确率 |
|---|---|
| GPT-5.6 Sol | 73.0% |
| GPT-5.6 Terra | 67.6% |
| GPT-5.6 Luna | 66.2% |
| GPT-5.5 | 64.9% |
Sol 的提升尤其显著,但即便是 GPT-5.6 系列中价格最低的 Luna,在这项基准测试中也超过了 GPT-5.5。
Roboflow 的一些案例并非只要求返回画面中所有物体的总数。
在一项测试中,Sol 需要只统计靶纸指定得分区域内的弹孔。这要求模型完成两层视觉推理:
模型成功完成了 Roboflow 展示的这个案例。
与简单询问“这张图片中有多少个物体?”相比,这种任务更接近真实的视觉自动化场景。
实际应用通常包含条件规则,例如:
能够将物体检测与自然语言规则结合起来的通用多模态模型,很适合视觉逻辑经常变化的工作流。
基准测试中也包含一些仍然困难的示例。
泡罩包装很有挑战性,因为在反光条件下,装有物品和空置的槽位可能看起来非常相似。重复排列的版式还会进一步干扰模型。
Roboflow 还展示了一个异常糖果案例,Sol 返回了错误的数量。无法确定模型究竟是计数失败,还是误解了哪些物品属于所要求的类别。
这种区别在生产系统中非常重要。
错误的计数可能来自多种原因:
检测错误
类别理解错误
空间规则理解错误
重复检测
漏检物体
坐标错误
仅凭最终数字无法判断具体在哪个阶段出了问题。
这项基准测试中最反直觉的部分是 OCR。
Sol 的全文转录得分为 90.7%,略低于 GPT-5.5 的 91.2%。
差距很小,但这意味着新旗舰模型并未在所有视觉类别上都实现提升。
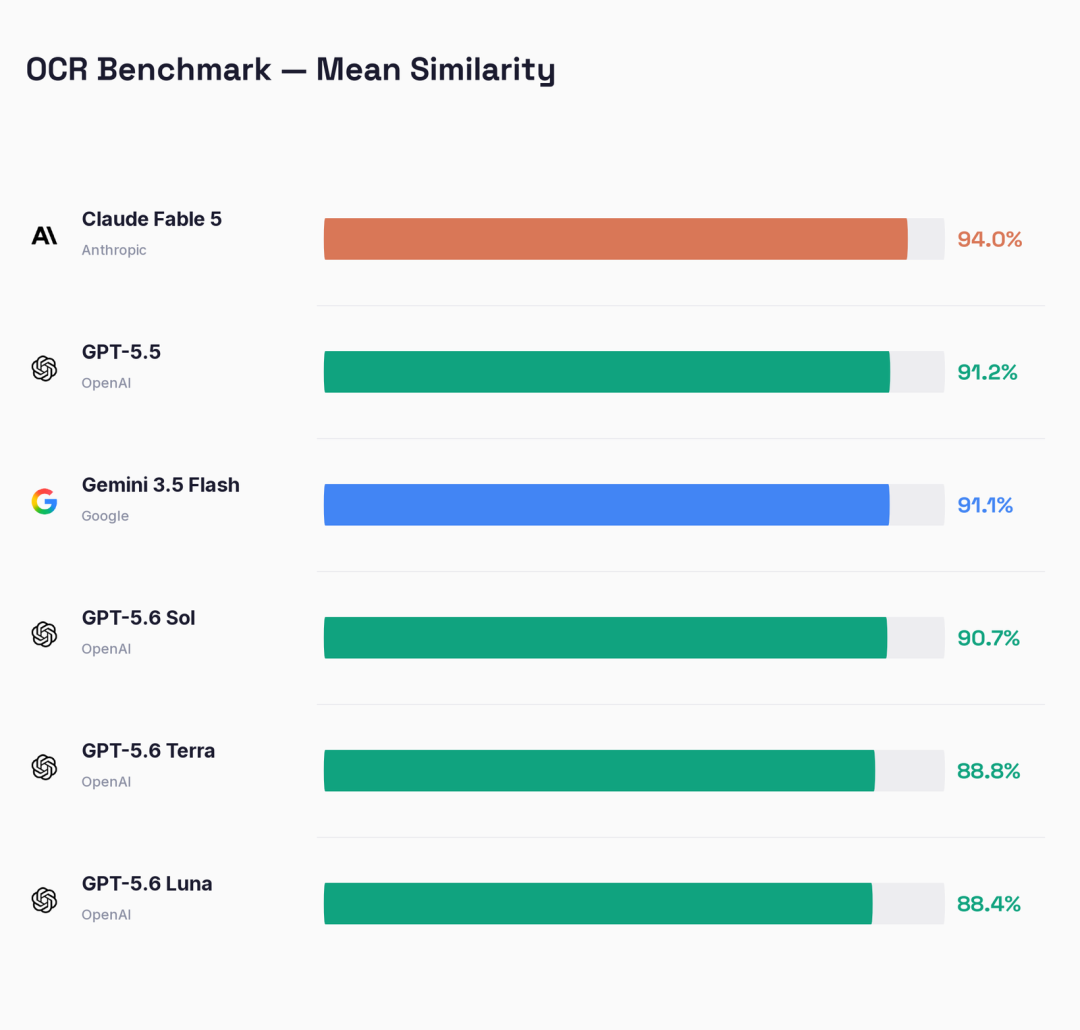
Roboflow 区分了两项相关任务:
第二类任务的退步更加明显。
| 模型 | OCR | 定向文本提取 |
|---|---|---|
| GPT-5.5 | 91.2% | 87.6% |
| GPT-5.6 Sol | 90.7% | 82.5% |
| GPT-5.6 Terra | 88.8% | 79.4% |
| GPT-5.6 Luna | 88.4% | 81.4% |
在这次基准快照中,Sol 的提取得分比 GPT-5.5 低了五个点以上。
不过,模型依然很好地处理了多个困难案例。
Roboflow 展示了 Sol 转录手写笔记的结果,其字符相似度很高。
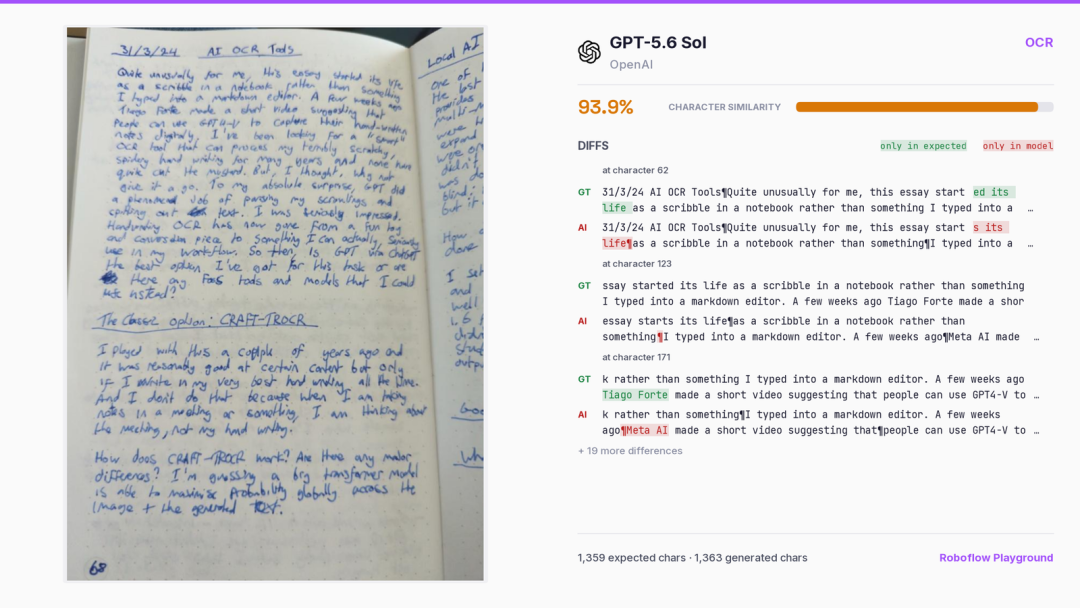
它还成功读取了视觉环境复杂的文字,包括印在脏污曲面轮胎上的尺寸字符串,以及冰球转播画面中的实时比分。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这些案例说明,模型的 OCR 局限并不等同于“小字一定无法识别”。
其表现取决于对比度、方向、反光、字号、周围视觉干扰,以及具体的提取指令。
一个最明显的失败案例涉及印在泡罩包装上的有效期。
文字很小、纵向排列、对比度低,而且受到反光包装的影响。
Sol 未能正确提取所要求的日期。
这对文档和工业工作流是一个很有价值的提醒:即使模型在手写文字或广播图像上的示例令人印象深刻,也不代表它能可靠处理包装、压印文字、反光材料或低对比度小标签。
对于高风险提取任务,仍应视情况使用专用 OCR 引擎、确定性解析器、条码系统或人工审核来验证模型输出。
Roboflow 在物体检测过程中还发现了另一种重要的故障模式。
在一些图像上,Sol 返回的边界框与真实物体几乎没有或完全没有重叠。错误边界框有时还会呈现不自然的规则排列,例如整齐的行列或等间距分组。
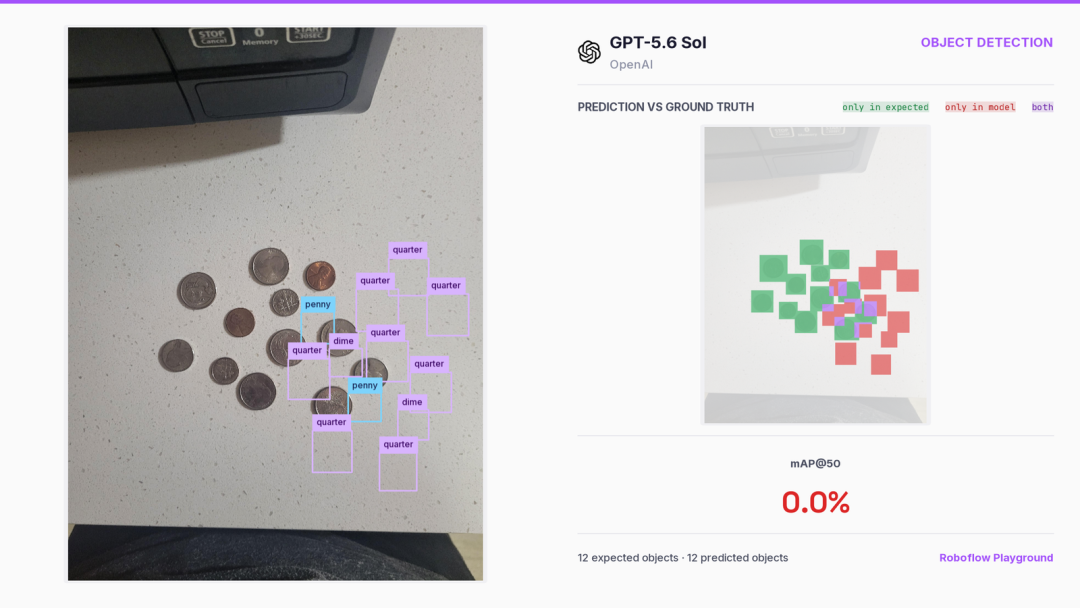
Roboflow 表示,它与 OpenAI 分享了这些案例,并被告知:当图像尺寸达到约 2,000 × 2,000 像素或更大时,Sol 的稳定性会下降,尤其是在使用较低推理强度时。
这一说明来自 Roboflow 的报告,而不是 OpenAI 单独发布的文档页面,因此更准确的表述是:这是 Roboflow 称 OpenAI 已确认的一项限制。
在 Roboflow 的测试中,更高的推理强度提高了稳定性。
代价也很直接:
更高的推理强度
→ 更多 token
→ 更高延迟
→ 更高成本
对于数量较少、价值较高,且一次检测失败代价很大的图像分析任务,这种做法可能值得采用。
但对于超大批量任务,它的吸引力就没那么大。
Roboflow 更实用的建议,是在将大图发送到 API 之前先进行缩放或裁剪。
这样做有两点好处:
对于文档处理,将大幅扫描件切片或裁剪成有意义的区域,也能让任务更易评估和重试。
视觉能力提升也伴随着实际成本。
在 Roboflow 7 月的基准测试中,每张图像的估算成本和延迟大致如下:
| 模型 | 每张图像的估算成本 | 估算延迟 |
|---|---|---|
| GPT-5.6 Sol | $0.025 | ~10 秒 |
| GPT-5.6 Terra | $0.01 | ~6 秒 |
| GPT-5.6 Luna | < $0.005 | ~5 秒 |
| Gemini 3.5 Flash | $0.008 | 在所引对比中快于 Sol |
这些是特定基准测试的估算值,并非固定的 API 单图价格。图像成本取决于图像尺寸、提示词长度、输出 token、推理强度、服务商设置和当前 token 定价。
OpenAI 当前 API 对 GPT-5.6 系列各模型的定价也有很大差异。Sol 是旗舰档,Terra 是均衡档,Luna 则针对高吞吐、成本敏感的工作负载进行了优化。
因此,当工作流需要 GPT-5.6 这一代模型改进后的视觉能力,却无法为每张图像都使用 Sol 时,Luna 尤其值得关注。
原文的结论并不是 GPT-5.6 已经主导所有视觉基准测试。
在 Roboflow 7 月的对比中,Gemini 3.5 Flash 在物体检测和计数方面仍领先 GPT-5.6 Sol,同时每张图像的成本明显更低。
因此,Gemini 3.5 Flash 很适合以下高频工作负载:
Google 的 Gemini 官方文档将 Gemini 3.5 Flash 描述为支持图像、视频、音频、文本和 PDF 输入的多模态模型,拥有 100 万 token 上下文窗口。它的 API 定价也面向高吞吐生产用途。
因此,实际选择应由具体工作负载决定。
以下情况可能更适合 GPT-5.6 Sol:
以下情况可能更适合 Terra 或 Luna:
与把每张图像都直接交给旗舰模型相比,分级处理管线通常更经济。
GPT-5.6 最重要的变化,并不是它突然变成了完美的 OCR 引擎或专用检测器。
真正的变化是,视觉能力开始能够在更广泛的智能体工作流中发挥实用价值。
Sol 越来越能将以下能力结合起来:
OpenAI 在 GPT-5.6 发布说明中重点介绍了更强的计算机操作、多模态推理和智能体工作流。Roboflow 的基准测试则帮助我们看到,这些改进在更底层的视觉能力上具体是什么样子。
这一区别对开发者很重要。
传统计算机视觉系统可能需要分别使用检测、OCR、文档解析和下游推理模型。前沿 VLM 可以通过统一接口完成其中多项操作,不过专用模型在准确率、成本、速度或可预测性方面仍可能胜出。
因此,下一阶段的 VLM 竞争不再只是模型能否描述图像,而是它能否可靠地执行结构化视觉任务,并真正用于生产环境。
Roboflow 的结果为测试 GPT-5.6 视觉工作负载的开发者提供了几条实用规则。
Roboflow 称 GPT-5.6 Sol 是其截至当时测试过的最强 OpenAI 视觉模型。OpenAI 也将 Sol 定位为 GPT-5.6 旗舰模型,并正式支持图像输入,但“最强”仍取决于具体视觉任务和基准测试。
在 Roboflow 2026 年 7 月的基准测试中,GPT-5.5 的成绩为 13.8 mAP@50,而 GPT-5.6 Sol 达到 46.2。报告分数提高了三倍以上。
它具备较强能力,但基准测试并未显示全面提升。在 Roboflow 的 OCR 测试中,Sol 得分为 90.7%,而 GPT-5.5 为 91.2%;在同一评测中,它的定向文本提取得分也低于 GPT-5.5。
Roboflow 建议在 GPT-5.6 检测任务中要求返回以图像像素表示的绝对 XYXY 坐标。其测试发现,坐标格式会显著影响测量结果。
Roboflow 表示,OpenAI 已确认 Sol 在约 2,000 × 2,000 像素或更大的图像上可能变得不稳定,尤其是在较低推理强度下。Roboflow 的测试显示,缩放或裁剪图像,或者提高推理强度,都能改善结果。
适合。在 Roboflow 所引用的基准测试中,Luna 的物体检测成绩为 43.3 mAP@50,计数准确率为 66.2%,两项都明显优于 GPT-5.5 的检测结果。OpenAI 将 Luna 定位为成本最低的 GPT-5.6 档位,因此它很适合高吞吐工作负载。
不能一概而论,但在 Roboflow 所引用的物体检测和计数基准测试中,Gemini 3.5 Flash 仍然表现更强,而且单图成本更低。当视觉能力嵌入更复杂的推理或智能体工作流时,Sol 仍可能是更合适的选择。
在一些场景中可以,但并非必然。通用 VLM 可以简化混合视觉工作流,而在狭窄的生产任务中,专用检测器和 OCR 系统仍可能提供更低延迟、更可预测的输出、更强的领域调优能力或更低成本。
Roboflow 的基准测试显示,GPT-5.6 的实用视觉能力有了重大提升。Sol 的物体检测成绩从 GPT-5.5 的 13.8 mAP@50 提高到 46.2,计数准确率则提升至 73%。Terra 和 Luna 同样进步明显,说明视觉升级覆盖了整个系列,而不仅是旗舰模型。
这种提升并不全面。OCR 表现仍接近 GPT-5.5,所引基准中的定向文本提取能力有所下降,大图还可能产生不稳定的边界框。成本和延迟同样重要,在 Roboflow 的对比中,Gemini 3.5 Flash 对高吞吐检测和计数任务依然很有竞争力。
GPT-5.6 Sol 已经比 GPT-5.5 更像一个可信的通用视觉工作者,但生产团队仍应根据任务、图像尺寸、可靠性、延迟和成本选择模型,而不是只看某一项醒目的基准成绩。
从一句话开始,几分钟内拿到完整网站。



