For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/gpt-6-1-sol-500k-context-codex-usage-and-f5e586e1.md.
长时间的编程会话积累的不只是聊天消息。智能体还需要为源文件、命令输出、测试失败信息以及任务早期作出的决策留出空间。当这些工作上下文被填满时,智能体必须先将其压缩,才能继续工作。
长时间的编程会话积累的不只是聊天消息。智能体还需要为源文件、命令输出、测试失败信息以及任务早期作出的决策留出空间。当这些工作上下文被填满时,智能体必须先将其压缩,才能继续工作。
中国 AI 新闻媒体新智元在 BAAI Hub 上转载的一篇报道提到,GPT-6.1 Sol 在 Codex 和 ChatGPT Work 中的默认上下文从 272K tokens 提升至 500K tokens。该报道将这一公告归因于 OpenAI 的 Thibault Sottiaux,并称这一变更取消了订阅使用中的单独长上下文附加费。这比原始标题所暗示的“免费”升级是一个更具体的说法。
OpenAI 的官方文档确认了 GPT-6.1 Sol 的可用性,并说明了使用量的计算方式。下文所述的确切 500K 变更及附加费公告,仍归因于引用的报道和公告截图;所查阅的官方文档页面并未独立明确这一新的默认值。
从 272,000 tokens 增加到 500,000 tokens,容量约提升了 84%。该来源将其四舍五入为约 80%。其公告截图还提到最大上下文为一百万 tokens,并表示用户可以覆盖默认设置。
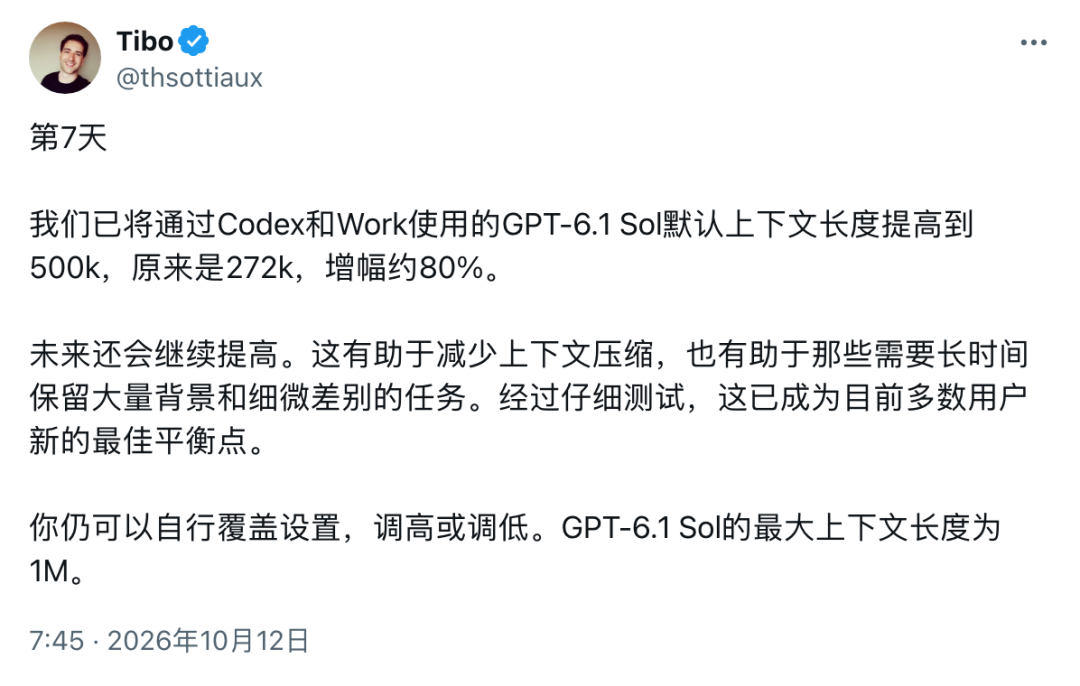
来源:新智元在 BAAI Hub 上转载的 Thibault Sottiaux 公告中文截图;英文描述为编辑说明。
实际收益在于,在压缩之前,可以在活跃上下文中保留更多任务历史。对于一次代码仓库变更,这些信息可能包括最初的兼容性要求、已检查的文件、失败过的方案,以及最新测试结果。
更大的上下文窗口并不能保证智能体会记住每一项要求,也不能保证其作出的修改一定正确。它改变的是能在活跃上下文中保留的信息量,而其决策质量仍然需要检查。
压缩会将一部分累积历史替换为更短的表述。这让智能体无需完整保留此前每一行工具输出,也能继续工作。
其代价是,压缩后的历史可能丢失有用细节。一个编程任务表面上可能已经完成,却遗漏了先前的一项要求,例如保留旧版 API 响应格式。保留更多相关上下文或许能减少这些切换发生的频率,但并不能消除回归测试的必要性。
OpenAI 的配置参考文档记录了 model_context_window 和 model_auto_compact_token_limit。这是两个不同的设置:前者描述模型可用的上下文,后者决定何时触发自动压缩。这些设置的存在并不意味着每个模型或账户都支持相同的取值。
该来源区分了长上下文附加费与常规订阅消耗。即使由于上下文较长而不额外适用特定倍率,一项任务仍可能消耗使用额度。
OpenAI 的官方定价文档支持这一更广泛的区分。文档称,使用量取决于模型选择、上下文、推理、工具使用、检索和缓存。保留更多信息的长任务,其额度消耗可能明显高于简短且聚焦的请求。
| 概念 | 说明 |
|---|---|
| 上下文容量 | 模型在一次请求或会话期间可容纳的信息量 |
| 订阅使用量 | 一项任务如何消耗包含的额度或积分 |
| 缓存输入 | 可能以不同费率重复使用的、此前已处理过的输入 |
| API 定价 | 通过 API 密钥进行身份验证和付费时产生的单独费用 |
像“继续”这样的简短追问,也可能触发一次规模可观的模型请求。智能体可能需要此前的文件、要求和工具结果,才能决定下一步操作。缓存输入的处理成本可能更低,但并不一定不计量。
该来源还提到,此前曾将上下文提升至 372K,随后因订阅消耗高于预期而撤回。该说法可作为理解本次公告的背景,但不应被解读为当前计费规则,也不构成对任何单项任务成本的承诺。
该来源将报道中的新默认值与 Claude Code 中的百万 tokens 配置进行了比较。一项有用的比较不能只看模型卡上最大的数字:默认值、压缩阈值、账户访问权限、定价以及周边智能体软件都可能不同。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
本文未根据 Anthropic 文档独立核验该来源中关于 Claude 特定模型限制和压缩阈值的说法。因此,不应将其视为当前的配置建议。
在日常工作中,请同时检查三项内容:
OpenAI 的官方模型指南也指出,可用性取决于套餐、客户端、灰度发布和工作区设置。容量公告并不会让用户获得原本不可用模型的访问权限。
GPT-6.1 Sol 是 OpenAI 文档中面向代码、应用和文档等复杂工作的模型。官方指南称,它以更低成本提供接近 Astra 的性能,具体可用性取决于用户的套餐和客户端。
这意味着在该配置下,模型可以处理约 500,000 tokens 的上下文。Tokens 不仅包括用户最新发送的消息,因此文件、任务历史、工具输出和回复都可能计入其中。
该来源称,订阅使用没有单独的长上下文附加费,这与无限访问不同。任务仍会消耗适用的额度,GPT-6.1 Sol 的访问权限也取决于套餐和发布进度。
它可以通过提供更多空间来推迟压缩。足够长的会话仍可能达到上限,而且配置的压缩阈值也会影响何时发生信息压缩。
不同。OpenAI 明确说明,API token 价格与订阅使用量是分开的,不能用 API 价格来估算包含的任务数量。
不应仅因为报道中提到了更大的设置就这样做。请先检查支持的模型和配置,再在有代表性的任务中比较完成质量、延迟和使用量,然后再调整常规设置。
报道中的 500K 默认值让 GPT-6.1 Sol 在 Codex 和 Work 中能为文件、要求和工作历史保留更多空间。它最明确的潜在收益,是在长任务期间减少上下文压缩造成的中断。
更大的上下文容量很有用,但它并不会取消订阅限制、API 费用,或免除检查最终结果的必要性。
从一句话开始,几分钟内拿到完整网站。



