For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/gpt-6-pro-parallel-agents-in-chatgpt-setu-69606eac.md.
ChatGPT 于 10 月 16 日发布的 GPT-6 Pro 更新增加了让多个智能体处理任务不同部分的方式。用户可以在对话中查看进度,并打开已完成的任务,检查每个智能体生成的结果。
ChatGPT 于 10 月 16 日发布的 GPT-6 Pro 更新增加了让多个智能体处理任务不同部分的方式。用户可以在对话中查看进度,并打开已完成的任务,检查每个智能体生成的结果。
OpenAI 还宣布响应速度更快,并改进了插件和工具使用体验。但该公告没有公布量化的速度提升数据、最大智能体数量,也没有完整解释结果合并机制。
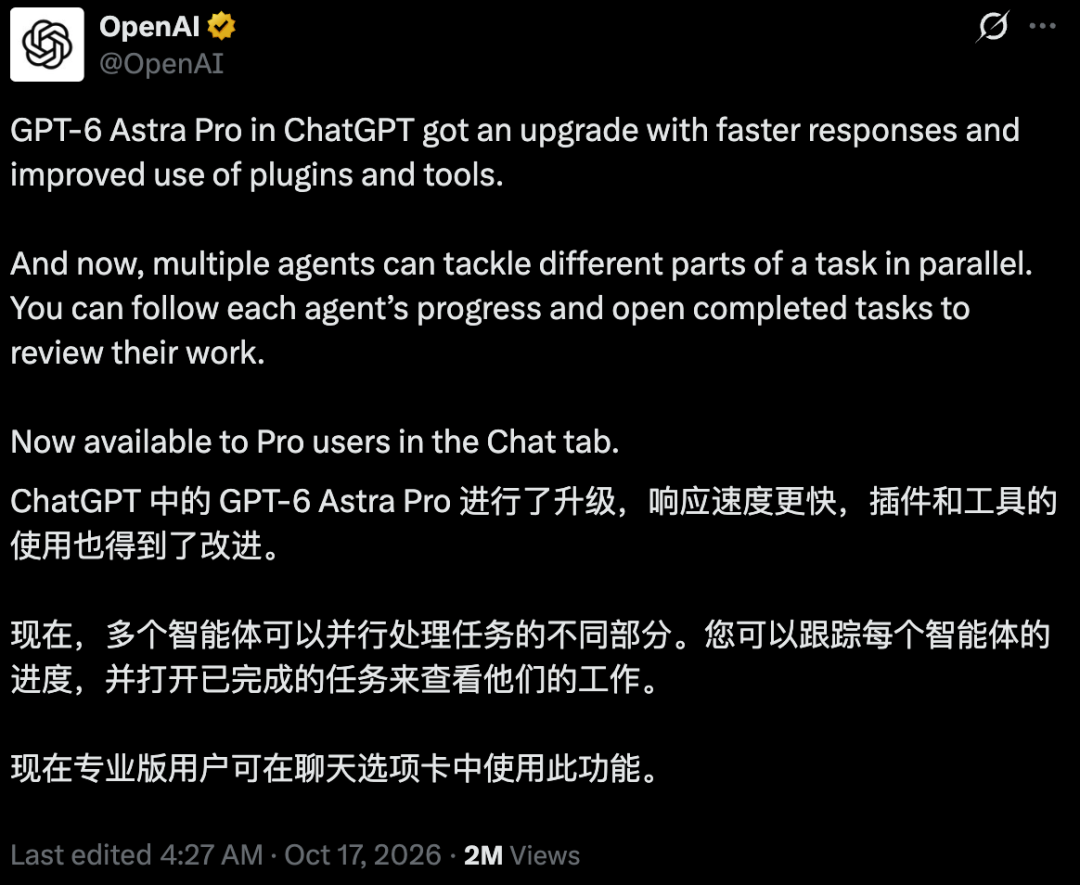
这项更新正在向符合条件的 Pro 用户逐步开放。托管工作区中的可用性取决于相关设置和逐步开放资格。能够使用多个智能体,并不意味着每项任务都会更快完成:用户仍然需要判断合并后的结果。
来源描述的选择路径如下:
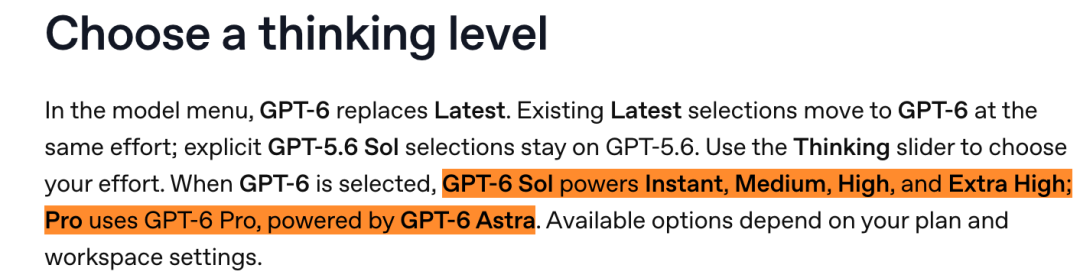
对于 GPT-6,Instant 到 Extra High 使用 Sol,而 Pro 使用由 Astra 驱动的 GPT-6 Pro。可用设置取决于方案和工作区访问权限。该更新公告没有说明能够保证触发特定智能体数量的提示词语法。
第一项是响应速度。“更快”是公告中明确表述的改进,但来源没有提供受控的更新前后完成时间测量结果。
第二项是工具使用。模型通常需要搜索信息、检查文件或与外部服务交互,才能完成任务。更好的工具处理能力可能减少失败调用和停滞循环,但个别用户关于循环问题的反馈,不能用来衡量此次更新的有效性。
外部服务仍然需要相应的账户连接和权限。委派任务本身不会授权访问新的系统。
第三项是并行工作。对三款产品进行比较时,可以先分成相互独立的调查任务,再围绕价格、功能和限制对结果进行统一。相反,阅读文档、根据文档选择方案,再按照该方案编辑文件,则属于相互依赖的阶段。
来源提供了一个用户案例:先开展研究,再生成产品需求文档和任务工单。这是一种有潜力的工作流:一个产物成为下一阶段的输入。
其他用户则指出了管理成本。如果每个智能体都返回一份篇幅较长、格式各异的报告,用户可能会把节省下来的等待时间花在整理和对齐输出上。进度指示器可以显示工作正在进行,但不能证明结果是正确的。
开始任务前,应先定义完成标准:需要回答的问题、时间范围、所需来源以及交付格式。能够将证据与结论关联起来的结果,比仅仅宣称任务成功的结果更容易检查。
报告接下来将这项更新与 Anthropic 的 Research 系统进行比较。Anthropic 于 2025 年 6 月发布的工程说明介绍了一种协调器:它负责规划研究、委派独立搜索、综合返回的发现,并设置了单独的引用阶段。
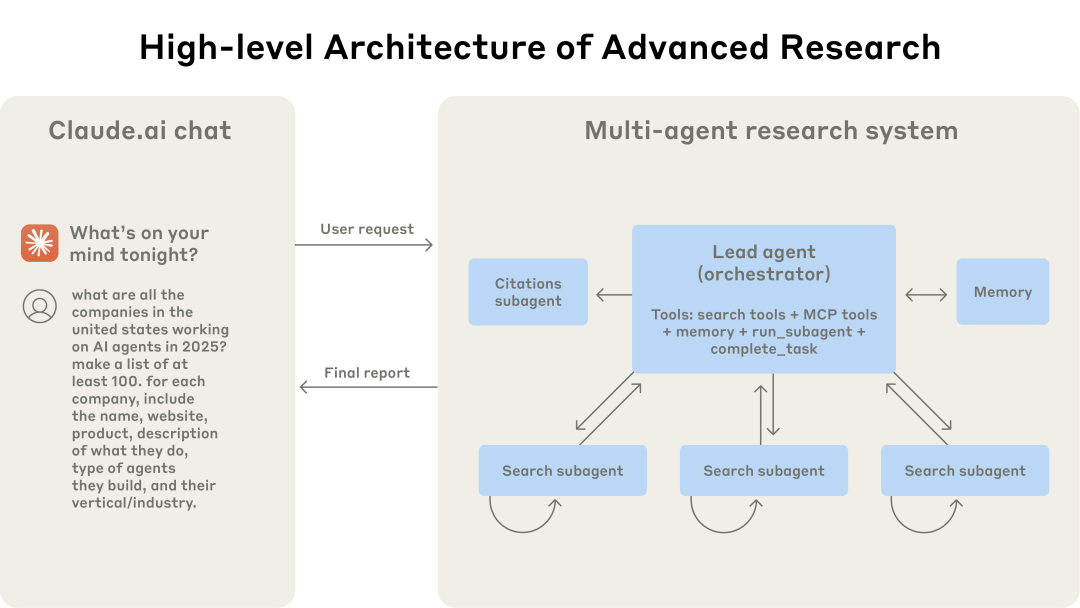
对于包含多个独立研究方向的宽泛问题,这种设计尤其有用。Anthropic 还强调,更多智能体会消耗更多令牌,而高度依赖的工作可能并不适合这种方式。
来源还将比较延伸至 Claude Code Projects 和 Managed Agents 动态工作流。报告引用了一次公司级代码查错演示:在包含 11.6 万行代码和 70 个预埋错误的项目中,单智能体运行分别找到了 14 个、15 个和 27 个错误,而动态工作流每次都找到了 66 个。这些是该设置下报告的结果,并非普遍保证,也不是与 ChatGPT 新功能的直接比较。
不同系统会以不同方式实现任务委派、项目上下文保留和后台工作运行。它们都使用多个智能体,并不意味着其访问权限、授权范围或运行时行为完全相同。
Anthropic 描述过一次早期的委派失败:两个智能体调查了相互重叠的当前信息,而另一个智能体研究了不同年份的内容。问题在于任务边界不够具体。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
一份有用的委派说明应明确目标、来源、范围和输出格式,同时告诉每个执行者哪些内容属于其他任务。如果缺少这些边界,并行活动可能会重复搜索,也可能留下重要空白。
结果合并同样需要谨慎。产品价格必须使用一致的计费周期和日期;研究结论必须区分相互冲突的证据;代码变更必须在接口和命名方面保持一致。即使两个智能体各自的修改单独看起来都合理,同时修改同一个文件仍可能引入冲突。
小型任务可能不值得承担设置和交接成本。当工作依赖先前的决策,或需要尽量减少浏览器标签等资源占用时,采用顺序执行通常更合适。
报告区分了 Work 或 Codex 中的 Astra 访问权限,以及 Chat 中的 GPT-6 Pro 访问权限。在其他体验中拥有 Astra Plus 访问权限,并不能证明用户有资格使用这一 Chat 功能。
报告还区分了 Chat Pro 模型额度与 Work 和 Codex 的使用额度池。复现的帮助信息说明,Pro 200 美元方案存在每周 GPT-6 Pro 使用上限,而 Pro 100 美元方案则有共享的每周 Pro 模型额度。这些规则可能随时间变化;在规划工作量之前,应查看链接的官方模型文章和账户自身显示的通知。
关于 Codex 额度突然下降的个案,不能证明 Chat 中的并行智能体工作是如何计量的。公告没有提供按智能体计费的公式。同样,付费 Pro 订阅也不应被理解为可以无限使用所有 Pro 模型。
有意义的比较标准是:获得可接受结果所需的总投入。评估时应包括协调成本、重复的工具调用、消耗的使用额度,以及人工修正遗漏或不一致内容所花费的时间。
对于研究任务,应检查证据覆盖范围,以及结论是否与证据相符。对于代码任务,应检查运行行为并执行适当的验证。只有当输出满足任务要求时,任务才算完成,而不是在每个智能体都显示完成状态时就结束。
它可以让多个智能体分别处理任务的不同部分,同时让进度继续显示在对话中。用户可以打开已完成的任务进行检查。
在符合条件的账户中,在 Chat 中选择 GPT-6,并在 Thinking 滑块上选择 Pro。如果该选项缺失,方案访问权限、工作区设置或逐步开放状态可能是原因。
相互独立的研究方向可以从并行工作中受益。相互依赖的步骤、小型任务以及共享文件编辑,可能产生超过节省时间的协调成本。
目前审阅的更新公告没有说明最大数量,也没有公布能够保证某项请求会触发多少个智能体的规则。
来源和相关模型帮助页面介绍了适用的使用额度。用户应查看对应体验中的限制通知,而不是假设 Chat、Work 和 Codex 使用完全相同的额度限制。
完成状态只表示任务已经返回结果。用户仍然需要根据任务要求验证来源、文件和结论,尤其是在必须合并多个输出时。
GPT-6 Pro 此次更新将并行工作、可见进度和可检查的输出结合起来,同时宣布改进响应速度和工具使用能力,但没有公布完整的性能或计费细节。
只有当输出准确、彼此兼容且易于快速审核时,良好的任务委派才能减少等待时间。
从一句话开始,几分钟内拿到完整网站。



