For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/grok-4-6-released-agentic-performance.md.
SpaceXAI 于 2026 年 8 月 12 日发布 Grok 4.6,将其定位为面向编程、长时运行的智能体任务和知识工作的前沿模型。该模型直接基于 Grok 4.5 构建,b
SpaceXAI 于 2026 年 8 月 12 日发布了 Grok 4.6,将其定位为面向编程、长时代理任务和知识工作的前沿模型。
该模型直接基于 Grok 4.5 构建,但重点更加聚焦且务实:在更长的连续工作中保持高效,跨多步骤使用工具,并为交互式和可视化应用生成更强的初版。
据 SpaceXAI 和 Cursor 称,Grok 4.6 在 Artificial Analysis 智能指数上现已与 GPT-5.6 Sol 持平,同时在 GDPval-AA v2 和 AA-Briefcase 等真实世界代理评估中展现出尤为出色的成绩。
AIBase 原文还重点介绍了 Grok 4.6 的价格和服务速度。价格优势在官方文档中得到了充分支持。速度数据则需要更细致地解读:AIBase 报告为 80 TPS,而 Artificial Analysis 目前测得第一方 Grok 4.6 API 约为每秒 68 个输出 token。运行时速度会随基础设施、提示长度、推理强度和提供商负载而变化。
Grok 4.6 是一个增量模型世代,而非全新架构的发布。
SpaceXAI 表示,新模型比 Grok 4.5 接受了更长的补充训练。训练内容组合包括:
该公司表示,Grok 4.5 还被用于重新生成 STEM、软件工程和知识工作任务的监督微调轨迹,并使用基于模型的过滤器去除有问题的痕迹。
Grok 4.5 此前已经以超大规模完成了训练。
SpaceXAI 官方表示,Grok 4.5 的训练使用了数万块 NVIDIA GB300 GPU。其训练数据涵盖编程、科学、工程和数学,而强化学习则主要聚焦于多步骤软件工程任务和其他长期技术工作。
Grok 4.6 是对这一基础的延伸,而非替代。
最重要的变化在于对持续代理行为的重视:模型不应仅仅解决孤立的编程问题,而应在研究、编辑文件、使用工具、测试自身工作以及多轮反馈迭代过程中保持连贯性。
SpaceXAI 表示,Grok 4.6 在广泛的代理强化学习任务集上进行了训练。
这些环境包括:
这有助于解释为什么该模型在涉及扩展工作而非短答案推理的评估中表现最为突出。
SpaceXAI 和 Cursor 还强调
该模型将宽泛的产品构想转化为可用初版的能力。
在内部测试中,Grok 4.6 能够:
这并不意味着每次一次性生成的应用都已达到生产就绪水平。这只是说明该公司发现,其初始输出质量优于 Grok 4.5,尤其是当任务需要结合代码、设计、交互和迭代式工具使用时。
Artificial Analysis 目前给 Grok 4.6(高版本) 在智能指数上的评分为 61。
这与 SpaceXAI 发布的对比中 GPT-5.6 Sol(最高版本) 的总分相同。
该指数是九项评测的综合结果,而非单一测试,因此更适合作为一个宽泛的对比参考信号,而非证明两个模型在所有工作负载上表现完全相同的证据。
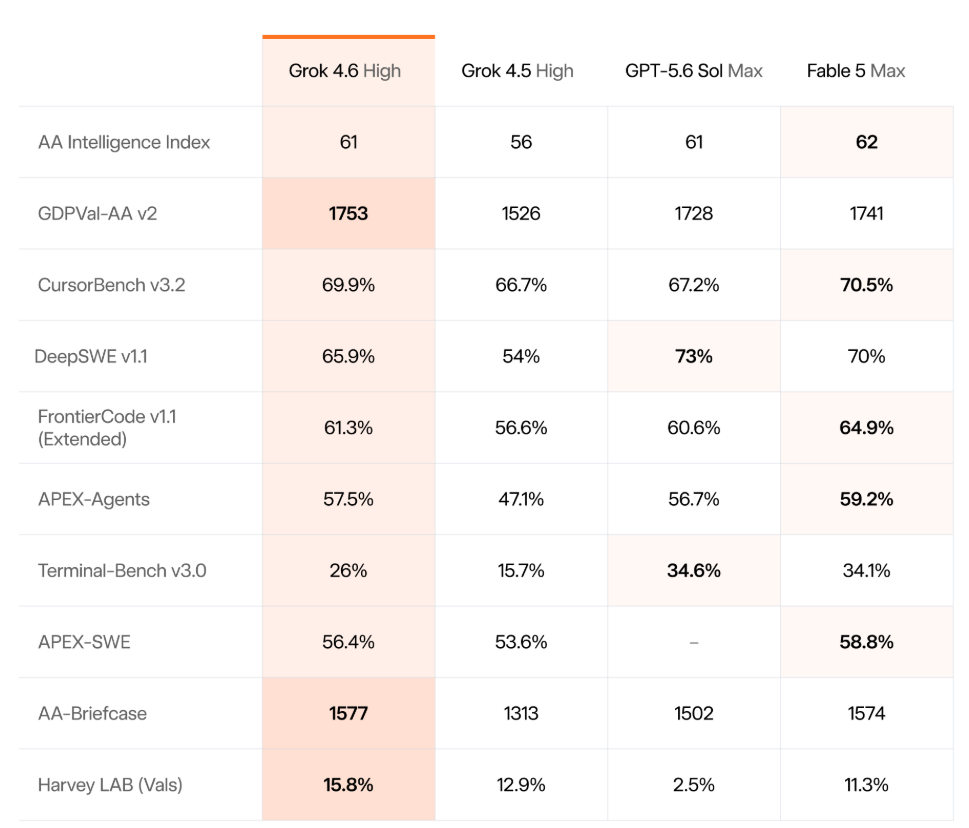
发布时随附的基准测试表包含以下结果:
| 基准测试 | Grok 4.6 高版本 | Grok 4.5 高版本 | GPT-5.6 Sol Max | Fable 5 Max |
|---|---|---|---|---|
| AA 智能指数 | 61 | 56 | 61 | 62 |
| GDPval-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 扩展版 | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
| APEX-SWE | 56.4% | 53.6% | — | 58.8% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
| Harvey LAB (Vals) | 15.8% | 12.9% | 2.5% | 11.3% |
基准测试排名会随着模型、测试框架和评测版本的更新而变化。上表反映的是发布时期的对比结果,并非永久排名。
在 GDPval-AA v2 上,Grok 4.6 获得了 1753 Elo 的评分。
Artificial Analysis 将 GDPval-AA v2 描述为一项覆盖多种专业职业的现实世界代理式知识工作评测。
在 Grok 4.6 分析发布之时,Artificial Analysis 表示该得分仅落后于 Claude Opus 5 系列,同时置信区间与其他领先模型(如 Claude Fable 5 和 Qwen3.8 Max)存在重叠。
这比直接宣称 Grok 4.6 明确排名第二要更严谨。
基于 Elo 的评测存在不确定性,相近的分数在统计上可能相互重叠。
Grok 4.6 在 AA-Briefcase 上也获得了 1577 Elo 的评分。这是 Artificial Analysis 针对长周期代理式知识工作设立的私有基准测试。
这使得其得分——
发布的快照中,Grok 4.6 的性能大致相当于 Fable 5 级水平,落后于 Claude Opus 5 系列。
其效率表现同样值得关注。
Artificial Analysis 报告称,Grok 4.6 在完成其 AA-Briefcase 任务时,大致使用了:
相比之下,据报道 Claude Opus 5(最大版本)大约使用了:
这并不意味着 Grok 4.6 在所有情况下都比 Claude Opus 5 更高效。这只是针对特定基准的观察结果。尽管如此,对于长期运行的智能代理来说,更少的轮数和更少的累积上下文可以显著降低任务成本。
标准的公开 API 定价仍然是 Grok 4.6 最强的竞争优势之一。
对于低于长上下文定价阈值的提示,SpaceXAI 文档说明如下:
| 令牌类型 | 每百万令牌价格 |
|---|---|
| 输入 | 2.00 美元 |
| 缓存输入 | 0.50 美元 |
| 输出 | 6.00 美元 |
Artificial Analysis 指出,尽管智能指数得分从 56 提升至 61,但这一公开定价与 Grok 4.5 相比保持不变。
相比之下,在撰写本文时:
这使得 Grok 4.6 对于高吞吐量的代理循环特别有吸引力,因为在这些场景中,输出令牌和重复上下文往往会占据总成本的主要部分。
SpaceXAI 官方发布说明中增加了一个简短 AIBase 文章未提及的重要细节。
对于超过 20 万令牌的提示,Grok 4.6 采用更高的定价层级:
| 令牌类型 | 超过 20 万提示时每百万令牌价格 |
|---|---|
| 输入 | 4.00 美元 |
| 缓存输入 | 1.00 美元 |
| 输出 | 12.00 美元 |
因此,“输入 2 美元 / 输出 6 美元”是起始价格,并非适用于所有请求的普遍价格。
Cursor 表示,快速变体的定价为标准价格的两倍。
这与上述长提示定价规则是分开的。根据平台和工作负载的不同,用户应在估算生产成本前确认适用的速度层级和上下文层级。
AIBase 文章称 Grok 4.6 可以以每秒 80 个令牌的速度运行。
这个数字应谨慎对待。
SpaceXAI 官方 Grok 4.6 公告并未发布固定的 80 TPS 服务速度保证。Artificial Analysis 目前在其基准工作负载下,测量到第一方 API 上 Grok 4.6(高)的输出速度约为每秒 67.6 个输出令牌。
相比之下,SpaceXAI 官方 Grok 4.5 发布页面明确表示 Grok 4.5 以 80 TPS 提供服务。
因此,简短来源文章可能沿用了早期 80 TPS 的数字,或引用了不同的服务层级。
实际要点更为简单:
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
Grok 4.6 对于前沿推理模型来说速度相当不错,但不存在适用于所有提示、提供商、推理力度或速度层级的单一固定 TPS 数字。
SpaceXAI API 文档将 grok-4.6 的上下文窗口列为 50 万令牌。
该模型支持:
图像输入
官方模型页面还列出了知识截止日期为2026年2月1日。
Cursor的Grok 4.6模型文档目前列出了Cursor内的256k上下文窗口。
这与基础模型规格并不矛盾。这意味着平台集成可以暴露比第一方SpaceXAI API更小的上下文限制。
在比较模型限制时,始终检查所使用的确切提供商和集成方式。
SpaceXAI的官方模型ID是:
grok-4.6
一个最小化的Responses API请求如下所示:
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.6",
    "input": "查找并修复bug,然后解释它:function median(a){a.sort();return a[a.length/2]}"
  }'
同一模型也可通过官方xAI SDK和兼容OpenAI的API客户端使用。
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.6")
chat.append(
    user(
        "查找并修复bug,然后解释它:"
        "function median(a){a.sort();return a[a.length/2]}"
    )
)

response = chat.sample()
print(response.content)
对于长时间运行的代理循环,SpaceXAI建议在适当情况下使用提示缓存和上下文压缩,以减少重复的上下文成本。
在发布时,Grok 4.6可在以下平台使用:
SpaceXAI和Cursor还在Cursor和Grok Build中提供了第一周2倍包含用量。
该发布促销是限时的,不应被视为永久定价。
Cursor以四种推理强度级别展示Grok 4.6:
high是默认的推理强度。
在符合条件的Cursor套餐中,还提供快速速度层级。
在Cursor内部,该模型可以使用平台的代理工具执行以下任务:
这是Grok 4.6发布如此重视代理基准测试的原因之一:其预期用途不限于孤立的聊天补全。
基准测试模式表明,Grok 4.6的最大进步不仅仅在于静态推理。
其改进在任务涉及以下方面时最为明显:
这使得它特别适用于:
长时间运行的知识型工作任务
对于简短、简单的提示词,这种优势可能并不明显。
发布数据支持以下几点明确结论:
但数据不能证明 Grok 4.6 在每项任务上都普遍优于 GPT-5.6 Sol 或 Claude。
例如,同一发布表格显示 GPT-5.6 Sol 在 DeepSWE v1.1 和 Terminal-Bench v3.0 上领先,而 Claude Fable 5 在多项其他编程和智能体评测中领先。
因此,模型选择应取决于实际工作负载,而非单一综合评分。
Grok 4.6 是 SpaceXAI 面向编程、智能体任务和知识工作的前沿模型。它在 Grok 4.5 的基础上增加了额外训练,重点强化了长时间运行的智能体、更强的首次应用构建能力以及更持久的多步骤工作。
这取决于具体任务。在发布对比中,Grok 4.6 在 Artificial Analysis 智能指数上与 GPT-5.6 Sol 持平,并在部分智能体评测中领先,而 GPT-5.6 Sol 在某些编程基准测试中仍然更强。两款模型在定价和上下文长度方面也存在显著差异。
标准定价为每百万输入 token 2 美元、每百万缓存输入 token 0.50 美元、每百万输出 token 6 美元。对于超过 20 万 token 的提示词,SpaceXAI 文档规定了更高的价格档位,分别为输入、缓存输入和输出每百万 4 美元 / 1 美元 / 12 美元。
SpaceXAI 第一方 API 支持 50 万 token 的上下文窗口。Cursor 目前为其自身的 Grok 4.6 集成提供 25.6 万 token 的上下文窗口,因此实际限制取决于平台。
支持。SpaceXAI 将 Grok 4.6 列为支持文本和图像输入以及文本输出。该模型还支持函数调用、网页搜索、X 搜索和代码执行等工具,可通过 xAI API 使用。
可以。Grok 4.6 已在 Cursor 中可用,并支持 xhigh、high、medium 和 low 推理强度。Cursor 还为其提供了访问智能体工具集的权限,用于文件操作、Shell 命令、浏览以及其他编程工作流。
不是。Grok 4.6 是专有模型,SpaceXAI 尚未公布其模型权重或参数数量。
AIBase 报告为每秒 80 token,但当前 Artificial Analysis 的测量显示,第一方 Grok 4.6 API 在其基准工作负载下约为每秒 68 个输出 token。速度会因推理强度、提示词大小、基础设施负载和平台层级而异。
keys 以及访问 Grok 模型的方式。
Grok 4.6 是对 Grok 4.5 的一次针对性升级,重点聚焦于长时间运行的智能体、编码、知识工作,以及在交互式项目上的首次执行质量。其发布结果使其处于当前模型评估的前沿,在 Artificial Analysis 智能指数上取得了 61 分——在发布对比中与 GPT-5.6 Sol 持平。
此次发布的最强之处在于智能体性能与价格的结合。Grok 4.6 起价为每百万输入 token 2 美元、每百万输出 token 6 美元,同时在 GDPval-AA v2 和 AA-Briefcase 上得分也很高。长提示词和快速层级可能带来更高成本,因此生产环境估算应使用确切的服务商配置。
公布的 80 TPS 数据需要谨慎对待:目前独立测量值接近每秒 68 个输出 token,且服务速度会随时间变化。
Grok 4.6 的主要优势不在于它赢下了所有基准测试,而在于它现在以极具竞争力的价格提供了前沿水平的智能体性能。
从一句话开始,几分钟内拿到完整网站。



