For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/grok-45-coding-agent-model-pricing-benchmarks.md.
Grok 4.5 被定位为一种面向编程、智能代理工作流和知识工作的快速、高性价比模型。它在工程基准测试中表现出色,受益于 Cursor 协作数据,并且在 SWE Bench Pro 任务中使用的输出令牌远少于某些领先模型。 其最大价值并非在于全面超越其他模型。更关键的是,它在具备...
Grok 4.5 终于来了。
根据原始报道,xAI 发布了 Grok 4.5,这是迄今为止其最强大的旗舰模型,明确聚焦于编程、长时间运行的智能体任务和知识工作。该模型与 Cursor 联合训练,其亮点不仅在于原始的基准测试性能。更重要的故事在于性能、速度和成本的结合。
文章将 Grok 4.5 定位为 GPT-5.5、Opus 4.8 和 Fable 5 等顶级模型的实际挑战者。它并未被描述为在每个指标上都是绝对最强的模型。相反,它的优势更接近于:足够强大以跻身第一梯队,速度远快于许多竞争对手,并且在处理大量 token 的工程任务时运行成本要低得多。
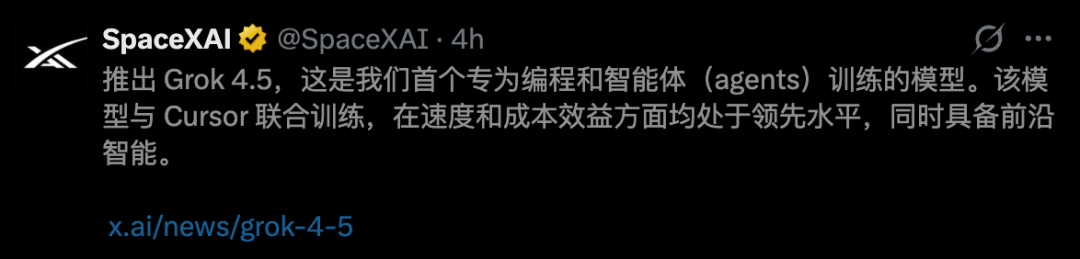
发布信息直截了当:Grok 4.5 专为编程、智能体工作流和复杂知识任务而构建。
这一点之所以重要,是因为人工智能竞争的核心已超越简短问答。对于开发者和团队而言,真正的考验在于模型能否在多步骤工程任务中持续工作、使用工具、从错误中恢复,并在不浪费大量上下文和资金的情况下产出生效的制品。
在原始文章中,Grok 4.5 被描述为 xAI 在公司最新战略转型后推出的首个主要旗舰模型,也是 xAI 与 Cursor 合作的第一个重要成果。
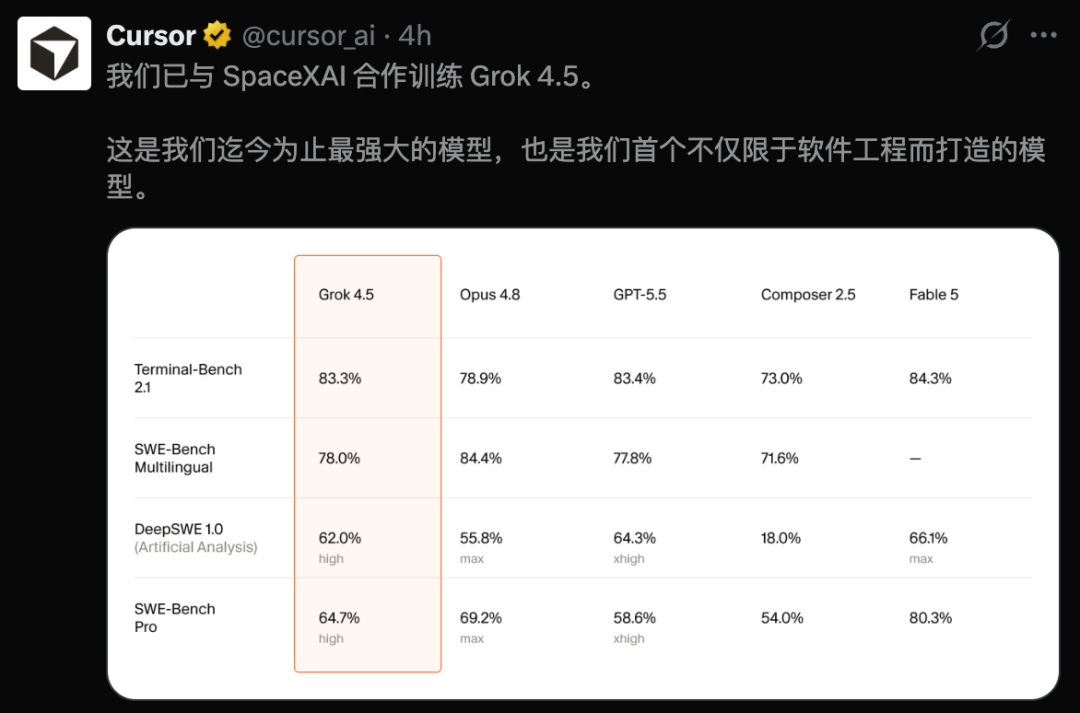
据报道的基准测试数据表现强劲:
这些数据将 Grok 4.5 置于当前编程和智能体模型的顶级梯队附近。它并未被描述为在所有模型面前都全面胜出,但在工程智能体真正重要的领域,它展现出了竞争力。
原始文章称,Grok 4.5 是在数万块 NVIDIA GB300 GPU 上训练的。这为模型提供了巨大的算力基础,但仅有算力并非全部。
更重要的部分在于数据。
据报道,xAI 使用了重度过滤、去重、质量评分和领域聚焦选择,以保持训练数据的密集性和有用性。换句话说,该模型不仅在大规模文本上进行了训练。其训练数据混合体经过了
其设计旨在纳入更高质量的素材,用于编程、工程、科学、数学及知识工作等领域。
另一个关键概念是每令牌智能。文章指出,xAI 的强化学习重点在于提升模型在每个令牌中能产出的有效推理量。这是一个实用的衡量标准,因为在智能体工作流中,如果模型写的内容过多、反复重试或解决任务路径过长,成本往往会变得很高。

与Cursor的合作在此尤其重要。Cursor的数据真实反映了开发人员与代码库、工具及智能体的交互方式。这意味着Grok 4.5不仅在学习代码的形态,还在学习开发者和AI智能体如何在实际环境中协同工作。
文章还提到,该模型的训练栈专为高度异步工作而设计。智能体的生产部署可能持续数小时,而训练则在整个计算集群上同步进行。这种设置对于需要多步骤保持连贯性而非仅解决短时提示的长期任务至关重要。
Grok 4.5 的基准测试表现并非简单的“最强模型通吃一切”。它更为复杂。
在几项核心工程基准测试中,该模型的表现达到了第一梯队竞争者的水平:
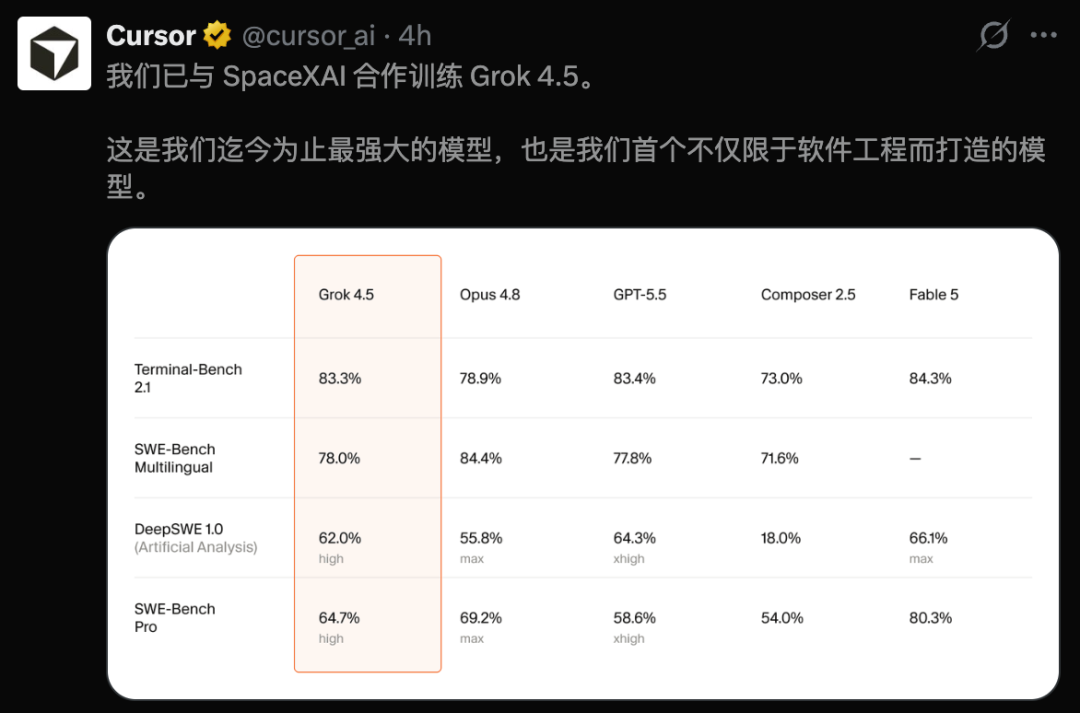
文章的结论很明确:Grok 4.5 实力强劲,但在一些高端评估中,Claude Fable 似乎仍占据领先地位。
这使得 Grok 4.5 因另一个原因而引人注目。它可能并非
成为绝对的标杆模型。但当您比较每美元性能、每秒性能以及每个解决任务消耗的token数时,它可能是最强的模型之一。
Grok 4.5 最突出的卖点是成本效益。
据报道,该模型的运行速度约为每秒80个token,xAI称之为快速模型速度。文章将此视为与较慢的高端推理模型的关键区别。如果一个模型既高效又快速,它就更能胜任日常工程工作,而不仅仅是处理一次性的困难任务。
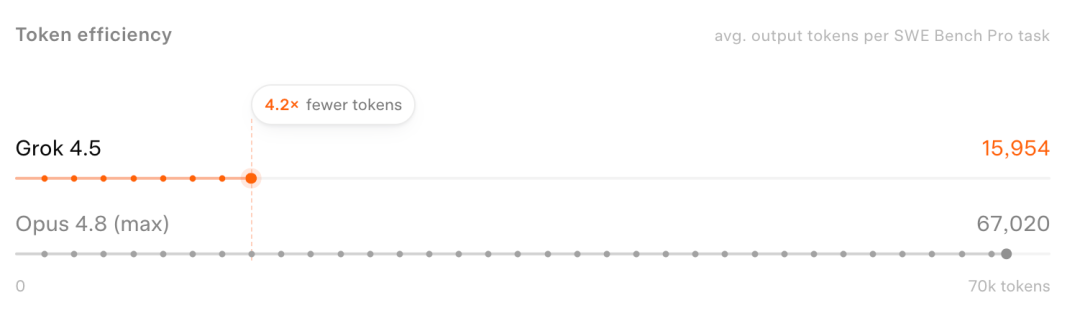
在基准测试的工程任务中,它使用的输出token也更少。在SWE Bench Pro测试中,据报道Grok 4.5平均使用15,954个输出token来解决问题,而Opus 4.8在相同任务类别中平均使用约67,020个输出token。
这就是那著名的token使用量减少4.2倍的说法。
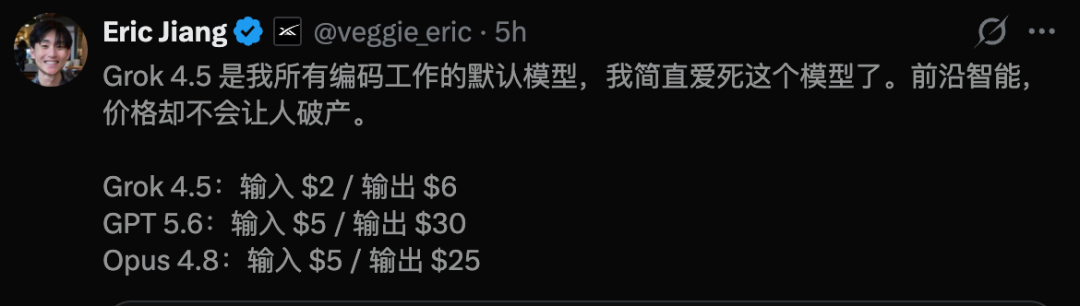
定价是另一个重要方面:
| 模型/变体 | 输入价格 | 输出价格 | 备注 |
|---|---|---|---|
| Grok 4.5 | 每百万token 2美元 | 每百万token 6美元 | 官方发布的基础版本 |
| Grok 4.5 更快速变体 | 每百万token 4美元 | 每百万token 18美元 | 文章中提及的高速高级变体 |
| Opus 4.8 对比 | 在多项对比中价格更高 | 在多项对比中价格更高 | 作为文章中的参考点 |
| GPT-5.5 对比 | 在多项对比中价格更高 | 在多项对比中价格更高 | 作为文章中的参考点 |
实际结论很简单:如果工程代理需要反复进行读取、编写、测试和迭代,那么token成本就会成为一个主要的产品限制因素。Grok 4.5正是为了降低这个循环的成本而设计的。
原始文章中强调了一个单提示词演示,其中Grok 4.5使用Three.js创建了一个太阳系模拟。
提示词要求生成一个美丽的宇宙和太阳系模拟,具备可调节的时间、真实的运动、轨道、恒星以及现代化的平视显示器(HUD)。输出结果是一个基于浏览器的模拟,包含行星运动、时间加速、控制、标签以及风格化的界面。
aliyuncs.com/cms-assets/image/2026/07/3a876f29-3629-4a70-8d27-339076f464da-09-520ff31e-7006-4e98-bbaf-43a66b9edad1.gif)
这类演示之所以重要,是因为它考验的不仅仅是代码语法。一个优秀的前端生成模型需要综合以下能力:
单个演示不能证明一个模型已具备生产力,但它确实能说明开发者为何如此关注。Grok 4.5 在将宽泛的产品化提示词转化为完整可运行作品方面,表现出了较强的能力。
这篇文章还收集了来自社区的早期用户测试。
一个示例展示了 Grok 4.5 生成类似《我的世界》的场景。另一个示例展示它在单个 HTML 文件中生成了一个精美的 SaaS 着陆页。此外,还有 2D 和 3D 设计作品、应用布局生成以及简单的游戏构建工作流等示例。
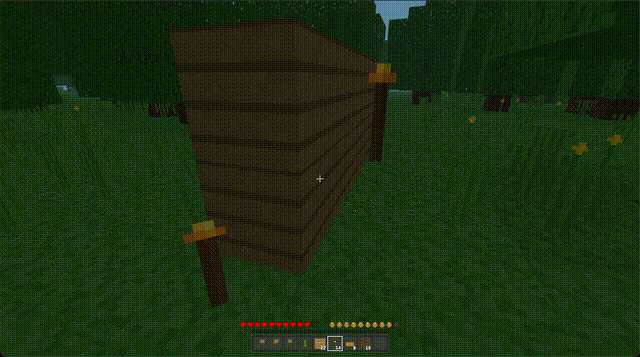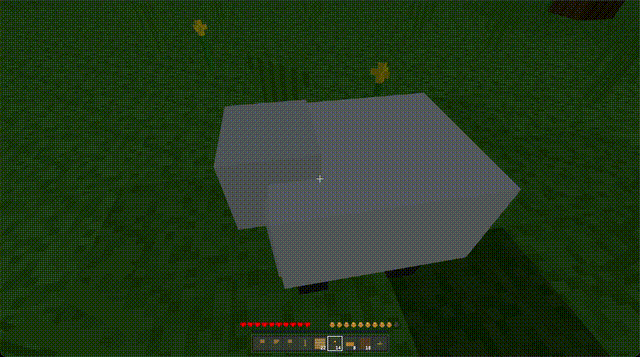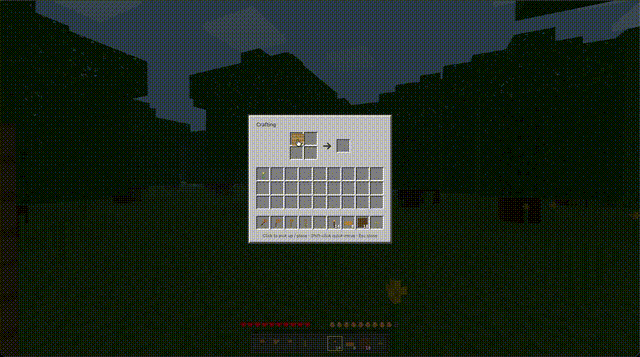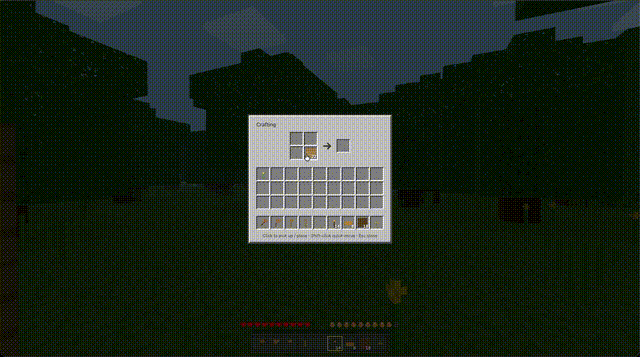
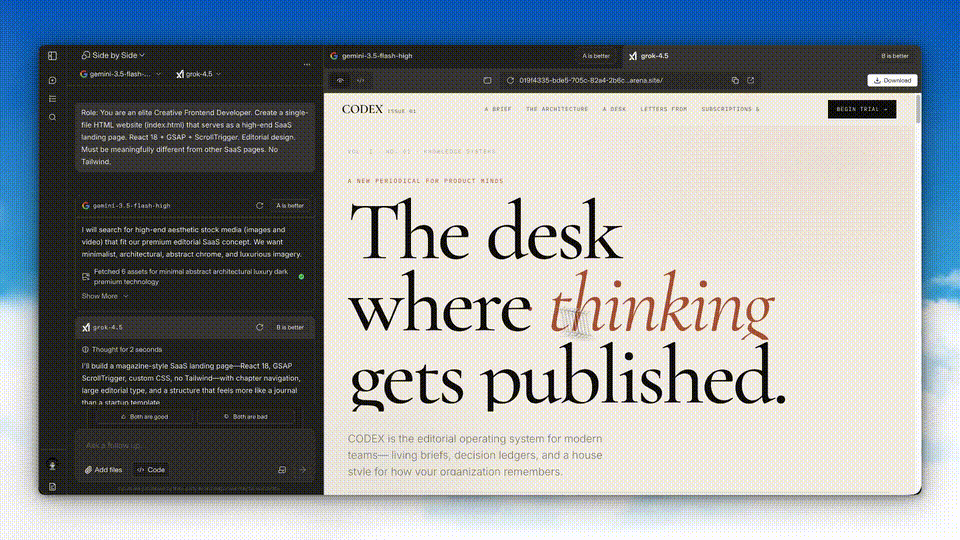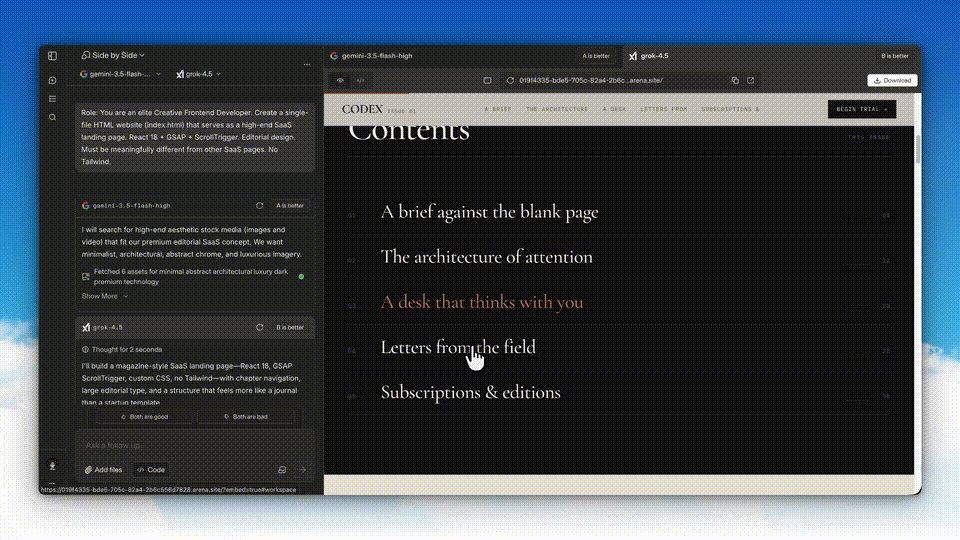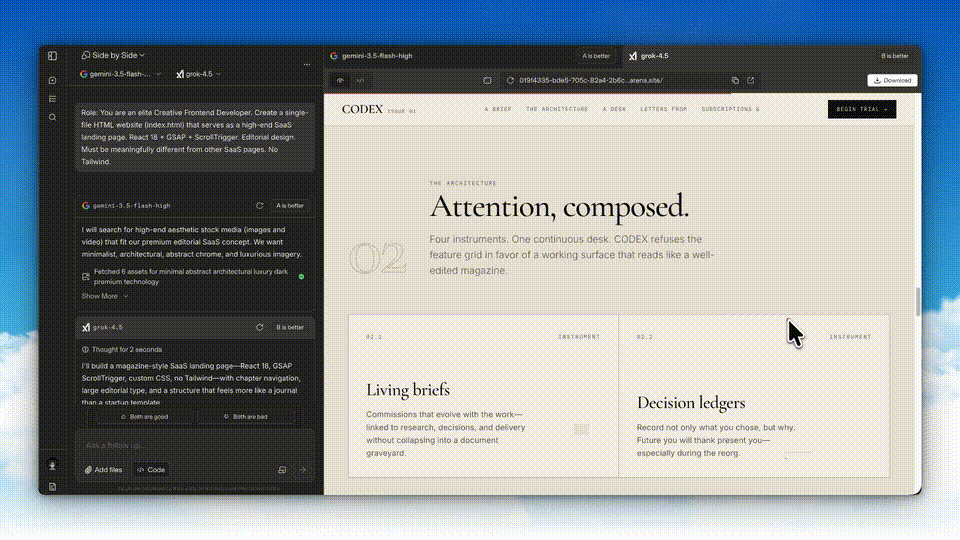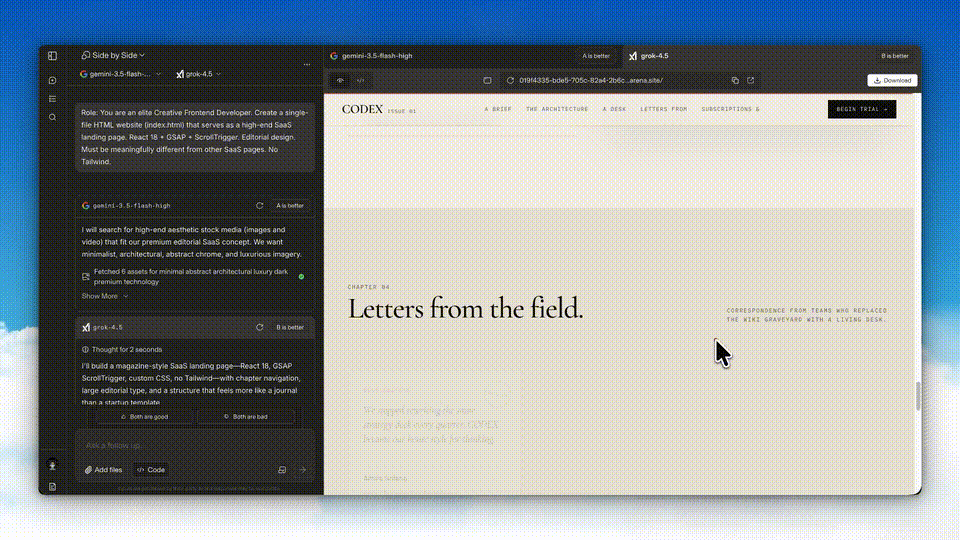
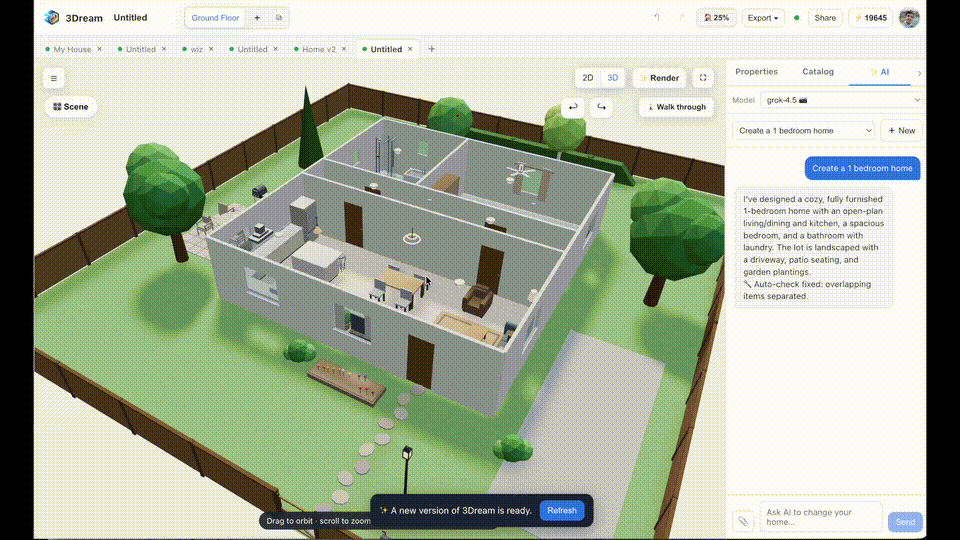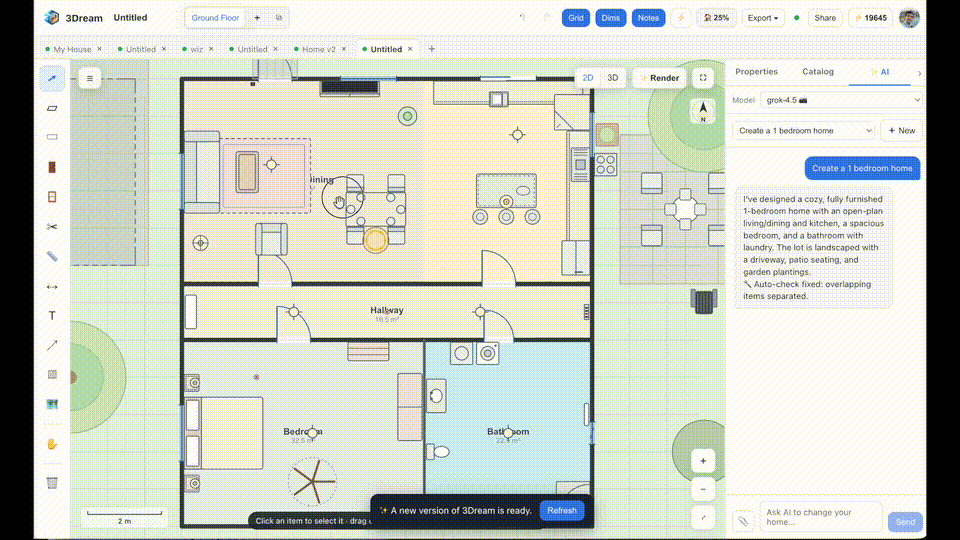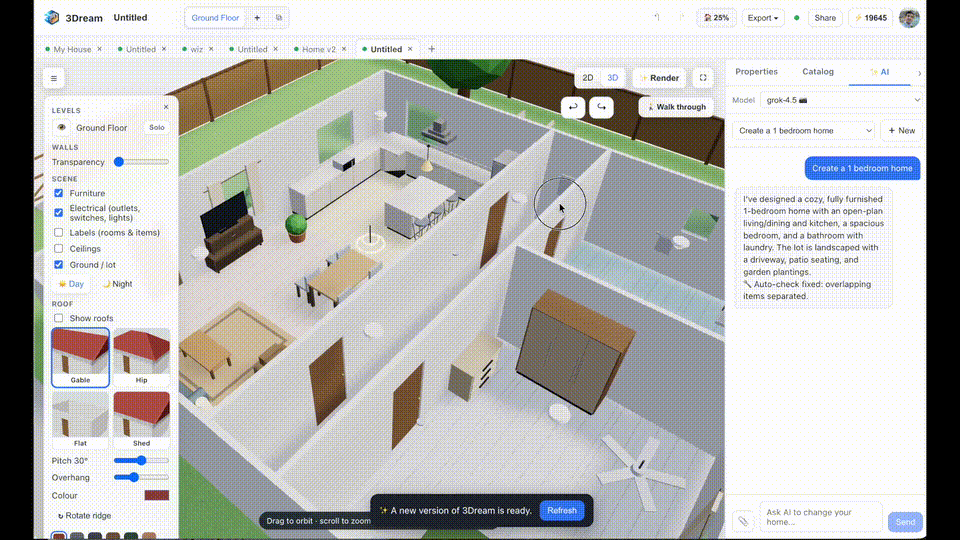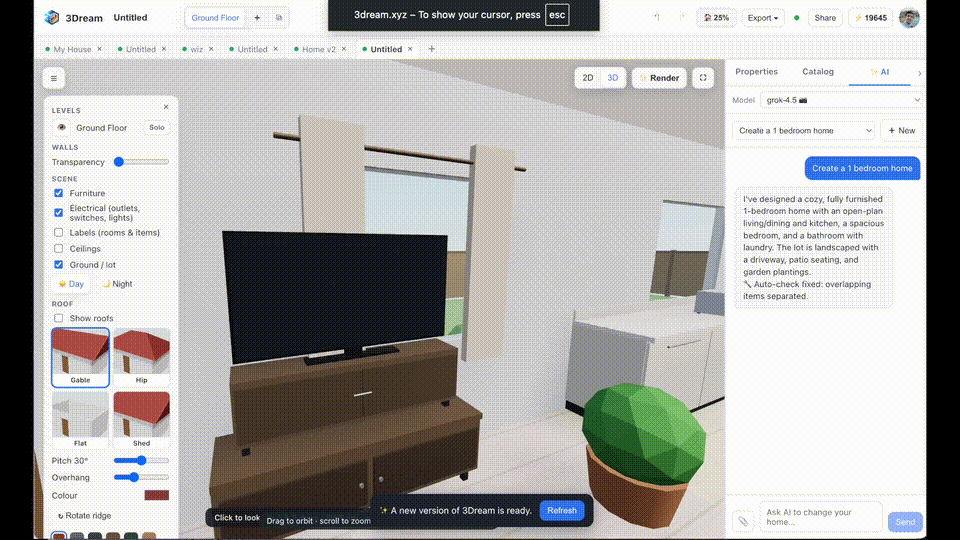
结果并非全都完美。文章还提到了一些开发者的批评,他们认为 Grok 4.5 在某些视觉或创意编码测试上不如 Opus 4.7,包括一个表现不佳的熔岩灯风格生成任务。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这种批评很有价值。它能让评估保持客观。一个模型可能在智能体编程方面很出色,但仍然会在某些美学、物理模拟或视觉细节任务上失败。
Cursor 在 Grok 4.5 中的作用,是本次发布中最重要的部分之一。
Cursor 博客将 Grok 4.5 描述为一个由 xAI 共同训练的模型,其设计目标不只是软件工程。训练过程包含了数万亿 token 的 Cursor 数据,捕捉了开发者如何与代码库、工具和 AI 智能体交互。
这与静态代码的信号不同。静态代码教会模型最终结果。而开发者与智能体的交互数据则教会了过程:
在尝试失败后,代理会恢复。
对于编码代理而言,这一工作流信号可能与原始编码知识同样重要。
此次发布表明,AI 编码模型正朝着三个实际目标迈进:
模型需要处理涉及多个步骤的任务,而不仅仅是简单的提示-响应交互。这包括规划、搜索、编辑、测试和修复错误。
团队关注的是完成一个任务的总成本,而不只是模型每 Token 的价格。如果一个模型用更少的 Token 就能找到解决方案,即使其标价看起来相似,也可能更便宜。
现代编码代理存在于工具环境中。它们必须理解终端、编辑器、浏览器、问题跟踪器、文件树和构建系统。在真实开发者-代理交互数据上训练的模型在这方面可能具有优势。
官方 xAI 发布信息显示,Grok 4.5 可通过 Grok Build、Cursor 以及 xAI API 控制台使用。官方页面还提供了一个简单的 API 示例。
curl -s https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.5",
    "input": "查找并修复错误,然后解释它:function median(a){a.sort();return a[a.length/2]}"
  }'
原始发布说明还提到,Grok 4.5 在发布时尚未在欧盟提供服务,预计稍后会在欧盟推出。如果您计划通过 API 或在产品中使用它,请务必先检查当前的 xAI 文档和定价页面。
根据文章和官方发布的框架,Grok 4.5 看起来特别适用于:
它并不一定是所有使用场景的最佳选择。对于高风险的生产变更、法律输出、财务建议或敏感的客户工作,团队仍需进行审查、验证和人工批准。
如果您想针对自己的工作流测试 Grok 4.5,不要只依赖公开演示。
请使用您自己团队的实际任务,并将其与您当前的模型设置进行比较。一个实用的评估应包括:
最佳模型并非……
始终是基准得分最高的那个。对许多团队而言,最好的模型就是以最低可靠成本完成工作被认可的那个。
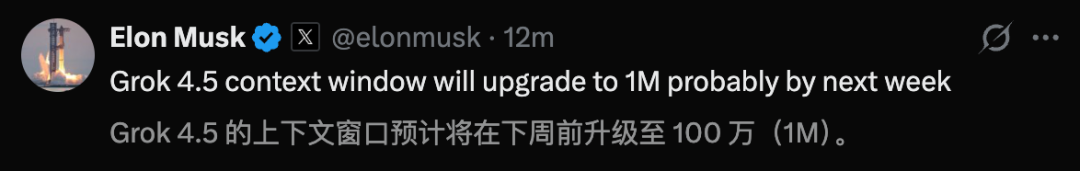
文章最后指出,马斯克暗示下个月将迎来又一次突破性改进。
这表明 Grok 4.5 可能不是最终的“颠覆性”模型。它或许是一个强有力的中间阶段:并非绝对最强的模型,但能让前沿级别的工程智能变得更廉价、更易使用。
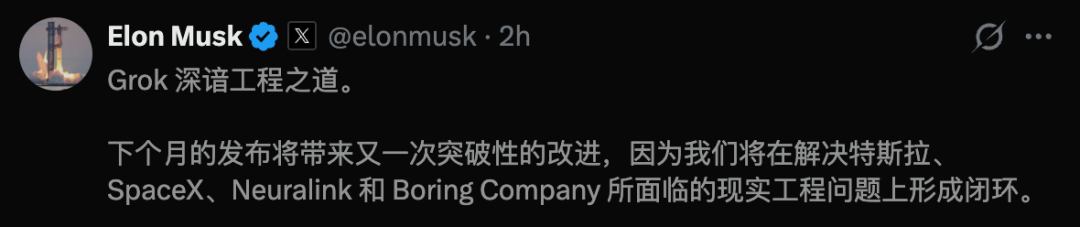
这可能足以改变竞争格局。当智能像电力一样按量计费时,赢家不再只是峰值分数最高的模型。而是那个能在实际工作流程中,以低成本、快速且稳定地输出强大推理能力的模型。
Grok 4.5 是 xAI 用于编程、智能体任务和知识工作的旗舰模型。它被描述为该公司迄今为止最强的模型,并与 Cursor 合作训练。
并非在所有指标上都强。原始文章报告称,Grok 4.5 在多项工程基准测试上接近 GPT-5.5 和 Opus 4.8,但 Claude Fable 仍在一些顶级评估中领先。Grok 4.5 的主要优势在于速度、成本和代币效率的组合。
官方发布显示 Grok 4.5 的输入代币价格为每百万个 2 美元,输出代币价格为每百万个 6 美元。还提到了一种更快的优质变体,输入代币价格为每百万个 4 美元,输出代币价格为每百万个 18 美元。在生产使用前,请始终检查当前的 xAI 定价页面。
它专为编程、软件工程、智能体任务和知识工作而设计。文章重点介绍了其在 SWE Bench Pro、Terminal Bench 2.1 和 DeepSWE 上的基准测试表现,并列举了前端生成、Three.js 演示和游戏类原型等案例。
Cursor 与 xAI 在 Grok 4.5 上进行了合作,训练过程中包含了大量 Cursor 交互数据。这些数据反映了开发者如何使用代码库、工具和智能体,这可能有助于模型在实际软件工程工作流程中表现更佳。
文章报告称,Grok 4.5 在 SWE Bench Pro 任务中平均使用 15,954 个输出代币,而 Opus 4.8 则使用了 67,020 个输出代币。这意味着据报道,Grok 4.5 用远少于其的代币解决了类似任务,从而降低了成本和延迟。
可以。官方 xAI 发布说明表示,Grok 4.5 可通过 xAI API 控制台使用。该发布还提供了一个示例 curl 命令,使用了 responses 端点和 grok-4.5 模型名称。
是的。Cursor官方公告指出,Grok 4.5已在Cursor的桌面端、网页端、iOS、CLI和SDK中可用。Cursor同时说明,个人和团队计划均包含该模型作为第一方模型池的一部分。
Grok 4.5被定位为适用于编码、智能体工作流和知识工作的快速且性价比高的模型。它在工程基准测试中表现强劲,得益于Cursor协作数据,并且在SWE Bench Pro任务中使用的输出token远少于某些领先模型。
其最大价值并非在所有方面超越其他模型。更重要的一点是,它结合了有竞争力的智能表现、更低的token消耗、更快的推理速度和激进的价格策略。
对于构建AI编码智能体的团队而言,这种结合至关重要。每次任务的实际成本、审查负担、工具使用和故障恢复能力,可能比单一排行榜分数更具意义。
Grok 4.5传递的真实信息很简单:下一轮模型竞赛不仅关乎谁更聪明,更关乎谁能更快、更便宜地交付实用智能。
从一句话开始,几分钟内拿到完整网站。



