For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness²(也写作 Harness2)探索了一种实用的递归改进形式:在语言模型权重冻结的情况下,改变模型周围的软件运行时。其可编辑运行时包括提示词、防护规则、记忆、技能、工具指导、脚本、子智能体和中间件。
Harness²(也写作 Harness2)探索了一种实用的递归改进形式:在语言模型权重冻结的情况下,改变模型周围的软件运行时。其可编辑运行时包括提示词、防护规则、记忆、技能、工具指导、脚本、子智能体和中间件。
这项研究来自 Google Cloud AI Research 和西北大学。系统不是在每次失败后重新训练一个模型,而是研究智能体的执行过程,测试对其 harness 的修改,并保留哪些改动有效的证据。
作者报告称,在 OpenCode 环境下,一次改进步骤可将 GLM-5 在 WorkBuddy-Bench 上的平均得分从 64.2 提升至 75.7。这是在特定评估中的 11.5 分提升,并不意味着任何模型或应用都能获得同样的改进。
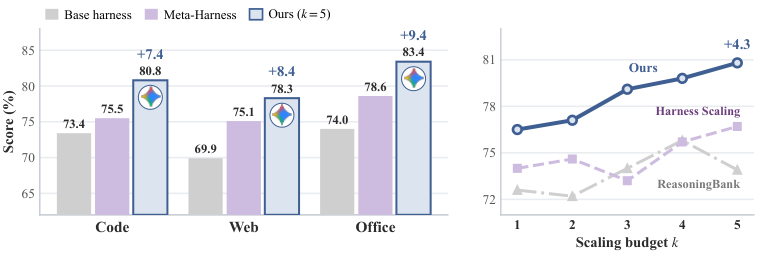
研究团队图表,转载自 QbitAI/BAAI 报告。
这项工作的动机主要来自两个问题。
Harness2 将当前的执行 harness 与改进 harness 的过程分离开来。后续任务从通用基础 harness 开始,改进器会选择性地调用此前的证据,而不是盲目沿用所有历史规则。
系统首先使用初始 harness 记录一次参考执行。随后,它利用这条轨迹识别缺陷,并测试可能的修复方案。
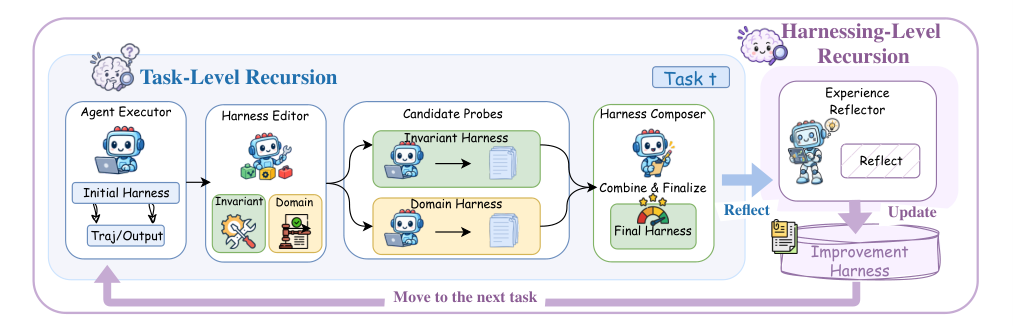
改进步骤分为三个阶段:
在适应过程中,当无法获得真实答案反馈时,行为比较可以作为替代方案。但它并不是判断最终正确性的绝对可靠标准。在评估方法是否有效时,外部基准测试仍然十分重要。
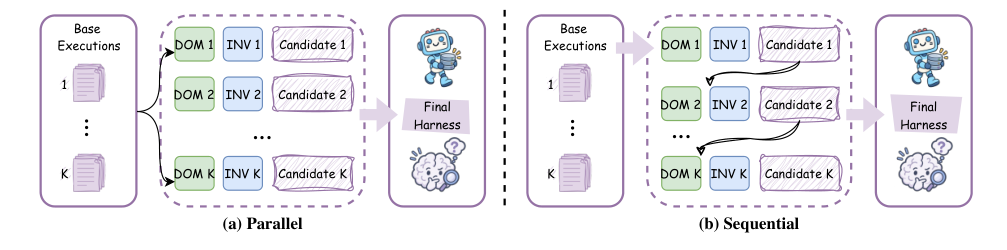
该方法可以通过并行递归进行更广泛的探索,也可以通过串行递归进行连续修订。当并行预算为 k 时,系统会探测 k 个通用候选方案和 k 个领域候选方案,然后生成 k 个组合结果。候选方案越多,所需的计算量越大。
任务完成后,经验反思器会检查参考轨迹、提出的编辑、探测证据和组合决策。它会记录可复用的组件与经验,包括写入 EXPERIENCE.md 的备注。
下一个任务会获得基础执行 harness,但编辑过程可以检索这些早期经验。持续保留的是关于某项修复何时有用的知识,而不是假设上一个任务的完整配置应当永久保留。
模型参数保持不变。这是通过文件与执行证据实现的运行时适应,并不是模型权重自主训练的证明。
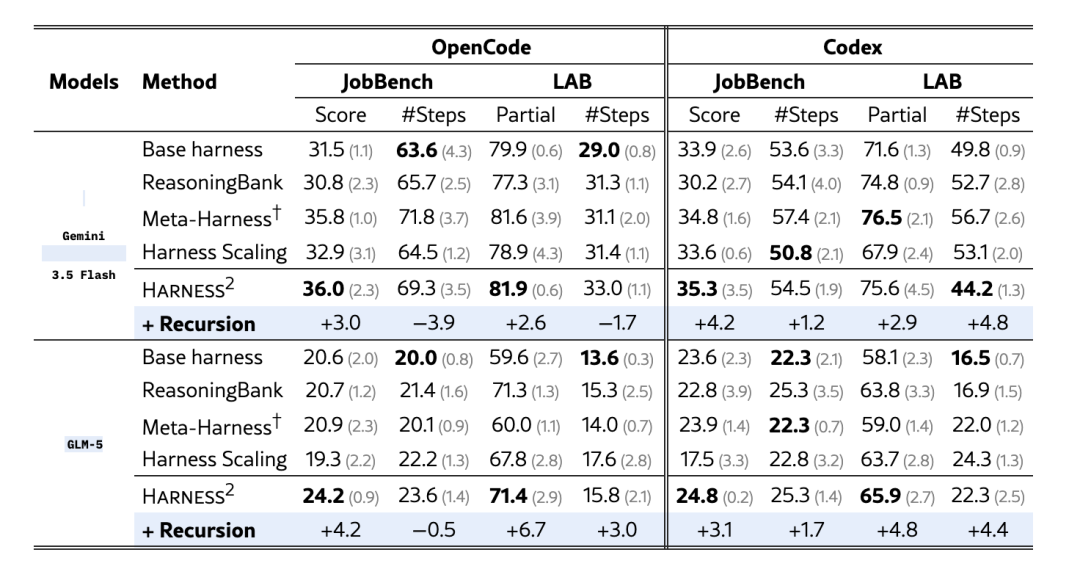
该研究评估了 WorkBuddy-Bench 的代码、网页和办公交付任务,JobBench 的专业任务,以及 Harvey 的 Legal Agent Benchmark。研究使用 GLM-5 和 Gemini 3.5 Flash,并分别采用 OpenCode 和 Codex 作为执行 harness。
默认编辑器是在 OpenCode 下运行的 Claude Opus 4.8。因此, headline 结果体现的是围绕执行器构建的改进系统,不应被描述为执行器本身免费获得的能力提升。
| 执行器模型 | 初始 harness | WorkBuddy 平均基础分 | 一次 Harness2 步骤 | 提升 |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64.2 | 75.7 | 11.5 分 |
| GLM-5 | Codex | 64.4 | 75.3 | 10.9 分 |
| Gemini 3.5 Flash | OpenCode | 72.4 | 77.5 | 5.1 分 |
| Gemini 3.5 Flash | Codex | 74.5 | 77.5 | 3.0 分 |
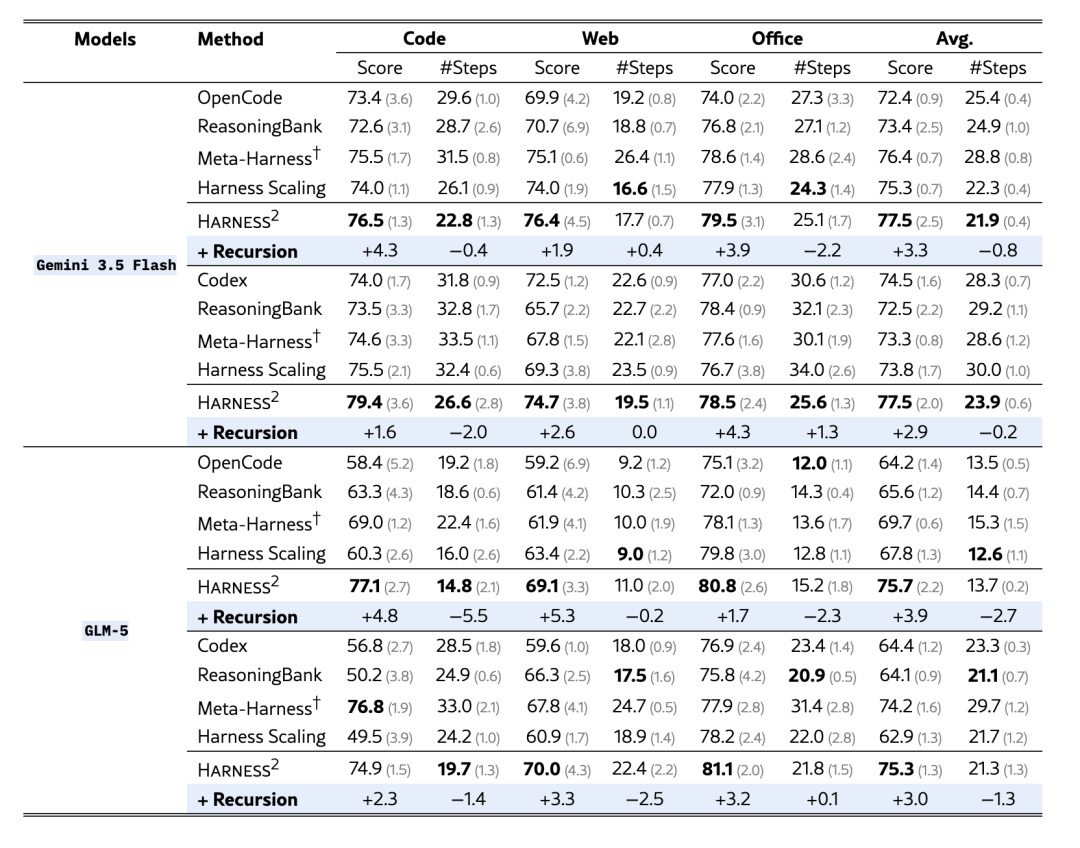
在这一比较中,使用改进 harness 的 GLM-5 超过了对应的未修改 Gemini 基线。这说明运行时设计可能影响模型排名,但并不能证明 GLM-5 在每项任务上都更强。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
论文报告称,JobBench 的单步提升最高达到 4.5 分,LAB Partial 的提升最高达到 11.8 个百分点;这里的 Partial 指按标准计算的通过率。它不同于满足全部标准的任务占比。
将并行预算提高到 k=5,相比单步递归,最多可额外增加 3.9 个 WorkBuddy 分数、4.2 个 JobBench 分数和 6.7 个 LAB Partial 百分点。主要表格报告的是三次运行的均值和标准差,任务顺序经过打乱。
迁移实验同样具有参考价值。在 JobBench 上积累的经验库,可以在不为该比较增加额外探测的情况下,使 WorkBuddy 的单步优化在代码、网页和办公领域分别提升 0.6 分、0.5 分和 2.9 分。
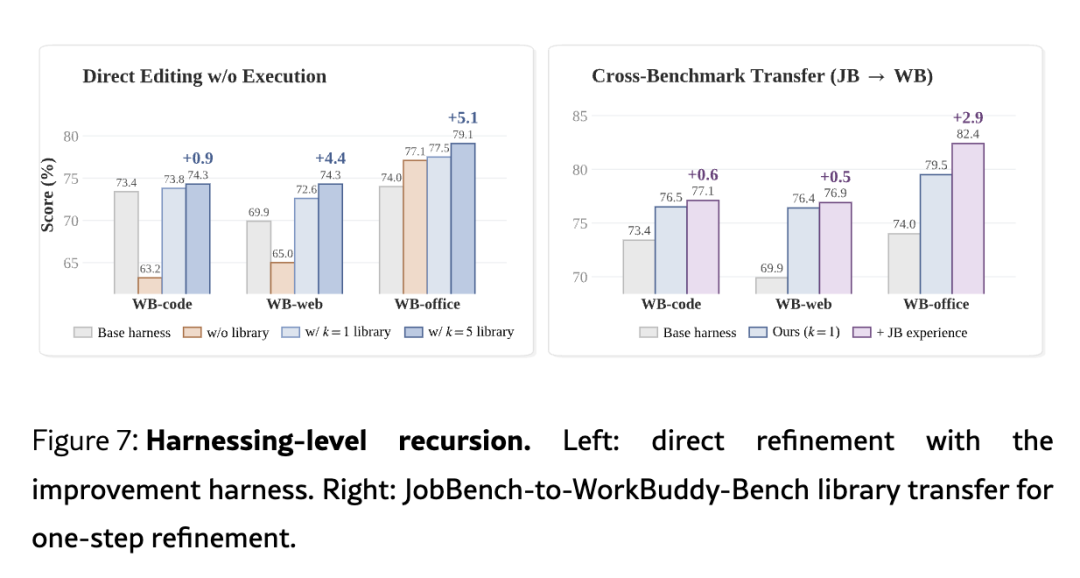
这些结果支持有选择地复用改进经验。但它们并没有证明每条积累的规则都能迁移,也没有消除在实际任务分布上检查所采用 harness 的必要性。
论文列出了 9 位作者:Ruiyao Xu、Yanfei Chen、Zhongying CuiZhu、Bhavana Dalvi Mishra、Yifei Ming、Han Yu、Rujun Han、Chen-Yu Lee 和 Tomas Pfister。资料介绍了西北大学博士生 Xu,以及 Google Cloud 研究人员 Chen 和 CuiZhu。
公开代码仓库支持两种执行 harness 和两种递归模式。其要求包括 Linux、Python 3.12 和 uv;基于模型的基准测试还需要额外依赖,并会产生 API 成本。WorkBuddy 需要 Docker,而 LAB 需要包括 Pandoc 和 Poppler 在内的工具。
README 还警告称,执行器的网络访问不受限制,并且在该设置中 Codex 的执行沙箱处于禁用状态。基准测试用户必须设置相应限制,防止系统访问答案和评分标准,然后再评估结果。论文中的运行时改进,应结合这些执行与评估条件一并判断。
它修改的是语言模型周围的运行时,包括提示词、工具、记忆和技能。底层模型权重保持冻结。
任务级递归会针对当前任务测试并组合修复方案。Harness 级递归则保留证据和可复用经验,用于改进后续的编辑决策。
它的适应方法使用执行轨迹之间的对比,而不是依赖真实答案验证器。这样一来,即使没有标签,也能获得可用证据;但这并不保证生成的成果是正确的。
不适用。这是研究中报告的 GLM-5/OpenCode WorkBuddy 平均提升。其他模型、harness 和基准测试组合会产生不同的提升幅度。
会增加候选方案执行和改进工作。论文将性能与总计算量一并分析,其中包括执行 token 和改进 token。
代码仓库为 WorkBuddy-Bench 列出了 Docker 要求。其本地确定性演示和其他基准测试具有不同要求,因此应遵循所选工作流的说明。
Harness2 将面向具体任务的实验,与关于如何改进智能体运行时的经验库结合起来。其报告的提升表明,即使模型权重保持不变,提示词、工具处理方式和执行结构也能实质性地改变结果。
这些证据支持在经过测试的条件下改进 harness 工程,同时应明确计算量、验证方式和迁移能力的限制。
从一句话开始,几分钟内拿到完整网站。



