For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
将 AI 工作负载部署到本地设备,不仅需要性能足够的加速器。开发者还需要能够准备模型、高效运行模型、连接多个组件并维护最终产品的方法。
Houmo 最新公布的生态系统计划正是针对这一软件层。据所提供的报告,该公司计划分阶段发布其 AI 软件栈,预计到 2027 年 1 月推出 15 个项目。目前已有多个代码仓库公开,包括模型示例、量化工具,以及对常见推理框架的适配版本。
区分路线图与当前可用代码十分重要。计划开源完整软件栈,并不意味着每个组件都已发布,也不代表所有运行时依赖都已消除。
报告将该软件栈划分为四个层级:
| 层级 | 在部署中的作用 |
|---|---|
| 模型准备 | 量化、编译、精度检查,以及转换为受支持的格式 |
| 推理框架、算子与运行时 | 在 Houmo 硬件上执行和调度 |
| 领域工具包、管道与中间件 | 协调模型与应用组件之间的协作 |
| 部署与运维 | 对已部署设备进行更新、监控和管理 |
会议助手的例子说明了这些层级为何需要协同。语音识别必须将结果传递给语言模型,语言模型必须生成有用的记录,而应用程序还必须保存或展示这些记录。每个阶段都有各自的内存、延迟和兼容性要求。
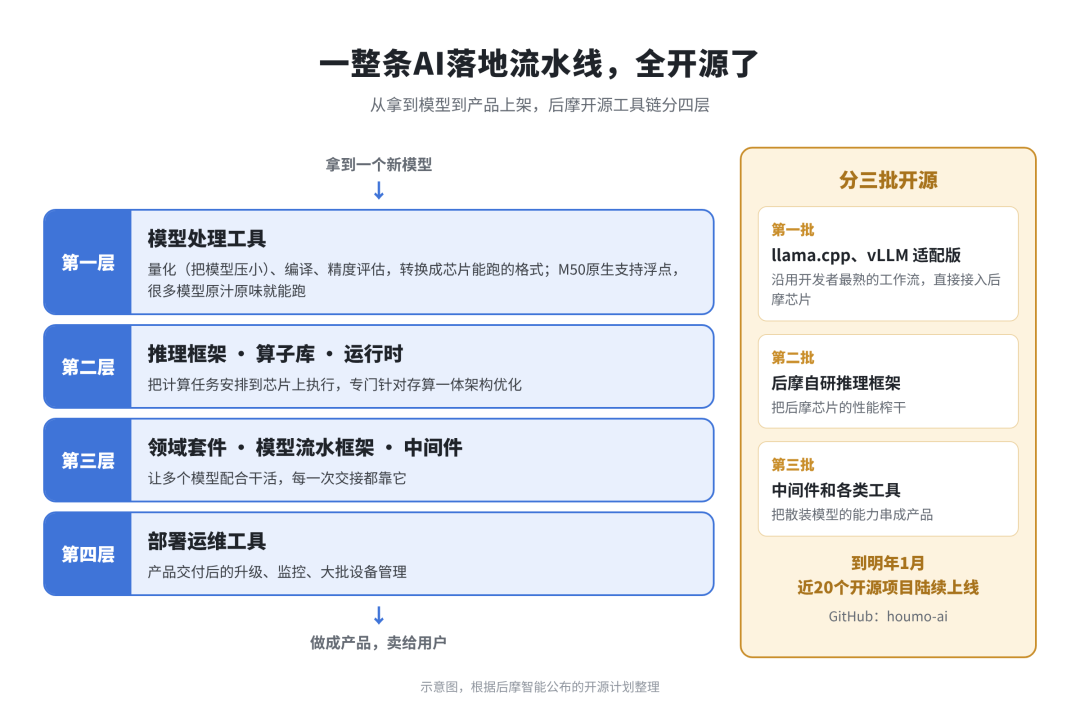
软件栈图示来自新智元/BAAI 报告;其原始标注为中文。
据报道,发布顺序将从对 llama.cpp 和 vLLM 的适配开始,随后是 Houmo 自有的推理框架,再到中间件及其他工具。更广泛的路线图还包括用于加速器和集群管理的基础设施。
公开的 postmo-modelzoo 代码仓库介绍了涵盖量化、编译、精度评估、性能测量和应用部署的示例。其模型类别包括语音识别、语音生成、语言模型、视觉语言模型、嵌入模型、OCR、分割和图像生成。
其他可见代码仓库包括 postmo-quantflow、postmo-gptqmodel、vllm-postmo,以及 Houmo 对 llama.cpp 和 vLLM 的分支版本。开发者应查看每个仓库的 README 和当前分支,而不应假设它们具有相同的安装流程或支持级别。
模型示例 README 给出了若干具体约束:
houmo-tcim-runtime 和 houmo-drv 中的库。这些要求对于规划部署非常重要。开源示例仓库提供了可检查的集成代码,但它并不是一个与硬件无关的执行环境。
消息来源称,已有超过 100 家客户和 150 多款规划中的终端产品与 M50 相关。这些数字描述的是报道中的生态系统项目储备,而非经过审计的出货量。
报告将联想 P7 描述为一台约 300 克的 AI 计算机,最大系统功耗额定为 30 W。据报道,它可在本地以每秒 50 个 token 的速度运行一个 1220 亿参数模型,并支持 128K 上下文。
应当结合未披露的测试条件来看待这些数字。文章没有提供足够的模型架构、精度、工作负载和测量配置细节,因此不能将其视为通用性能保证。尤其是,参数量本身并不能说明一次部署需要多少内存。
M50 本身被描述为提供 160 TOPS 的 INT8 性能、典型功耗为 10 W,并支持最高 48 GB 的 LPDDR5/5X 内存。加速器功耗、整机功耗、理论吞吐量和生成 token 速度衡量的是不同指标。
报道中的其他产品包括 Deepshard 的 Truffle 1 M50 版本、绿联的 HomeAgent HA100 Pro,以及 ClawHouse X1。这些案例聚焦于本地记忆、家庭媒体处理和个人智能体交互界面。即使模型在本地运行,电子邮件等连接型服务仍依赖身份验证和网络访问。
报告介绍了一款运行麒麟 V11 的长城 N90 Pro 笔记本电脑,可离线以每秒 30 个 token 的速度运行 350 亿参数模型。报告还讨论了一款使用本地处理进行感知和记忆的陪伴机器人,以及一套围绕 LM5040 加速卡构建的教育设备;其中每张加速卡集成四颗 M50 芯片。
该教育系统所报告的算力和内存数据适用于组装后的整机,而不是单颗 M50。比较产品时,读者应询问实际卡数、内存拓扑、精度和测量工作负载。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
架构讨论区分了混合专家模型与稠密模型。MoE 模型可针对一个 token 激活部分专家,但仍需存储更广泛的参数集合。稠密模型通常在每一步使用更大比例的参数,因此内存流量成为重要考量。
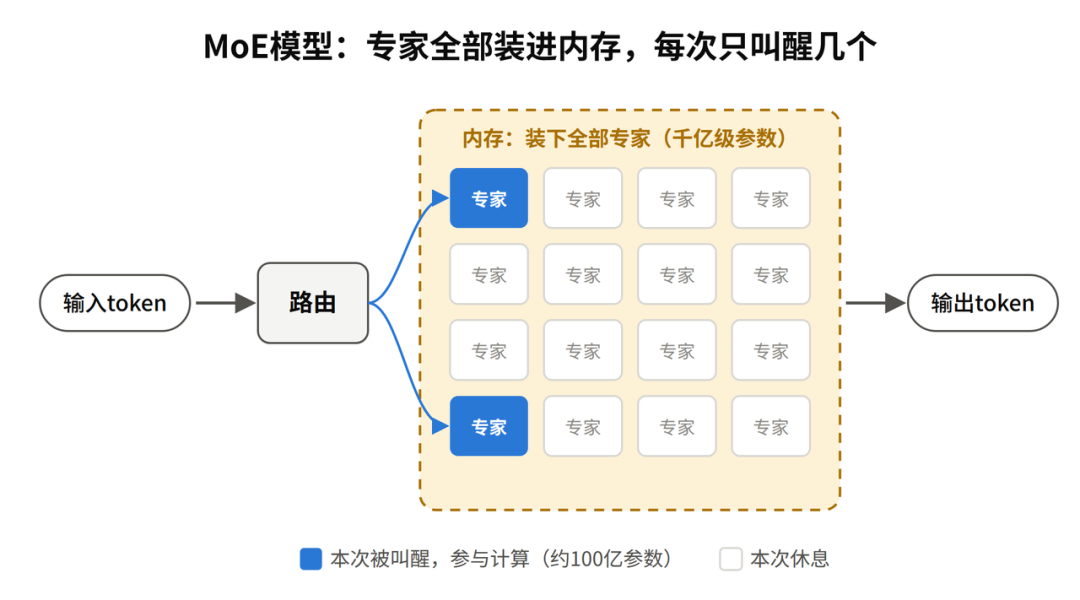
MoE 图示来自来源报告;原始标注解释了已存储和被激活的专家。
Houmo 提出两条开发路径:二维存算一体,强调借助外部内存实现容量和算力;以及 三维存算一体,通过堆叠式设计强调带宽。报告将逻辑层中基于 SRAM 的计算描述为后者的一个差异化特征。
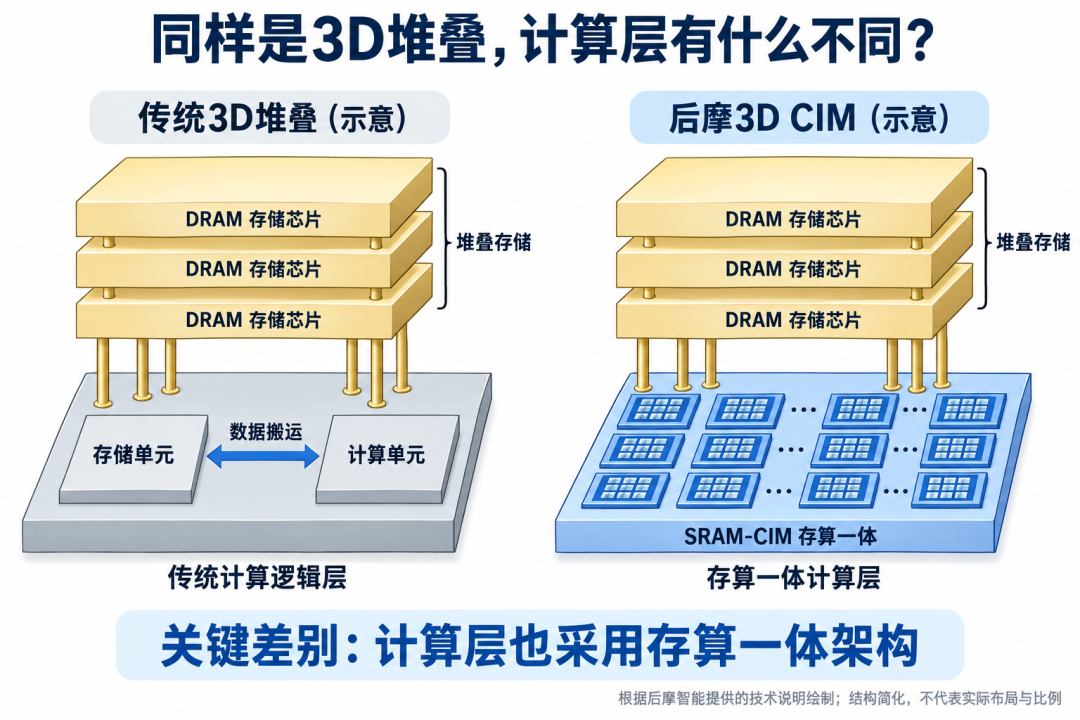
架构对比图转载自新智元/BAAI 报告,并非独立基准测试。
该公司的面积和功耗对比取决于具体比较对象。在未披露测量设置的情况下,不应将这些数据套用于每一款芯片或模型。对 Flash 或 RRAM 的未来提及也描述的是开发方向,而非当前产品可用性的保证。
消息来源将本次公告与创始人兼 CEO Qiang Wu 早期在 GPGPU 和 OpenCL 领域的工作联系起来。更实际的是,公开工具让开发者能够检查集成行为、调整示例并贡献修复。
这种访问能力可以减少设备制造商之间的重复工作。但它并不能消除在最终产品中测试质量、热设计、内存使用、许可证、离线运行和故障恢复行为的必要性。相比醒目的参数量数字,在目标硬件上可复现的示例是更好的起点。
M50 是一款边缘 AI 加速器,用于报告所描述的本地设备场景。示例包括智能体计算机、笔记本电脑、家庭系统、机器人和边缘推理设备。
报告描述的是一项延续至 2027 年 1 月的分阶段计划。目前已有多个代码仓库公开,但开发者应确认每个组件的实际发布状态和许可证。
该仓库包含具有不同平台要求的准备与评估工具。其推理示例需要受支持的 Houmo 硬件和运行时库;大模型量化还需要 GPU。
在已安装所需资产的情况下,本地推理可以不依赖云端模型服务运行。但涉及实时电子邮件、消息或其他在线服务的任务,仍然需要网络连接和授权。
不能。TOPS 是在特定精度下的运算吞吐量指标,而 token 速度取决于模型架构、内存流量、精度和软件行为。应比较相同模型与工作负载下的实测结果。
不能。README 说明,大多数第三方数据集必须单独获取,并遵守各自的使用条款。仓库许可证并不授予对所有引用数据或模型资产的商业权利。
Houmo 的公告旨在让从模型准备到可运行边缘产品的路径更易于复用。公开代码仓库已提供有用示例,而更广泛的软件栈仍处于分阶段发布计划中。
报道中的 M50 设备展示了多种可能的部署形态,但实际决策仍取决于准确的模型、硬件和运行时要求。应从受支持的示例开始,并测量完整产品工作负载。
从一句话开始,几分钟内拿到完整网站。
