For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/infinihand-streaming-3d-hand-motion-from-53c55163.md.
头戴式摄像头能够记录人们如何操作物体,但要将这些记录转化为有用的 3D 运动数据并不容易。手会移动,摄像头会移动,手指会被物体遮挡,两只手也可能彼此遮挡。
头戴式摄像头能够记录人们如何操作物体,但要将这些记录转化为有用的 3D 运动数据并不容易。手会移动,摄像头会移动,手指会被物体遮挡,两只手也可能彼此遮挡。
InfiniHand 在一个流式框架中结合了手部定位、精细手部重建和摄像头运动估计。其目标是将连续的手部姿态置于统一的世界坐标系中,使这些运动数据更适用于大规模标注和潜在的具身学习工作流。
这项工作来自上海人工智能实验室、上海交通大学及其他多所高校的研究人员。其项目页面提供了同步视觉对比和 3D 运动查看器。
裁剪后的手部图像有助于识别手指关节动作,但其中包含的手在周围场景中所处位置的信息有限。同样,图像中的位移既可能来自手部移动,也可能来自头部转动,或者两者兼有。
传统流程通常会结合手部检测器、姿态估计器、摄像头跟踪系统和对齐阶段。某一阶段的错误可能会向后传递:漏检手部会改变重建结果,而不准确的摄像头路径会改变表观的全局运动。
InfiniHand 在这些任务之间共享几何上下文。预训练的 LingBot-Map 主干网络提取全画幅特征,以支持左右手定位。手部重建组件将这些特征与以手为中心的外观信息相结合,以恢复更精细的关节动作。
其手部表示采用 MANO 参数来描述姿态、形状和朝向。辅助 2D 关键点监督有助于约束预测的 3D 手部如何投影回图像中。随后,摄像头估计使重建出的手部能够在时间维度上以相同的世界坐标系表示。
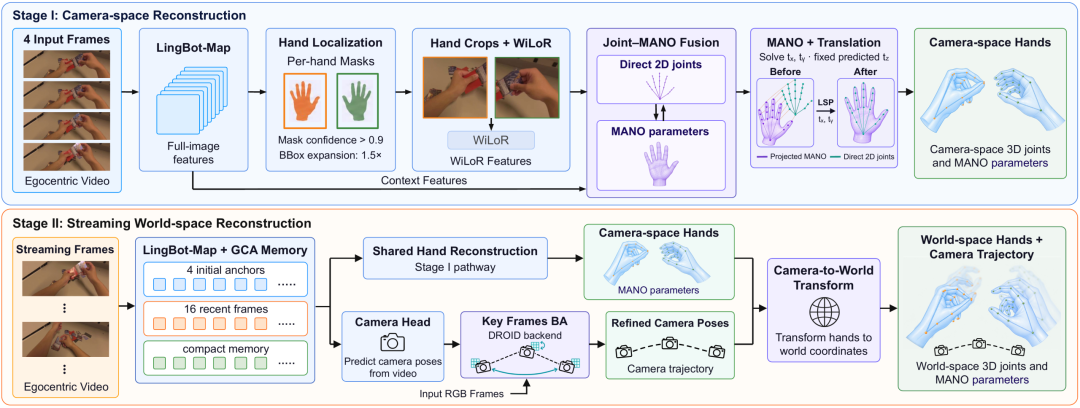
InfiniHand 方法示意图,转载自 QbitAI/BAAI 报告。
研究人员从包括 ARCTIC、HOT3D 和 EgoDex 在内的九个数据集中收集了约 5,000 小时公开第一视角视频。整合这些来源并不只是拼接文件:手部顺序、坐标约定和标注类型都可能不同。
预处理流程对可用图像、手部参数、关节、掩码和边界框进行标准化。在可能的情况下,系统会根据 3D 关节拟合缺失的 MANO 参数。具有摄像头轨迹的序列还可以提供世界空间监督。
标注质量是另一个需要关注的问题。团队使用 Sapiens 2 预测 2D 手部关键点,并将其与投影到图像中的原始标注进行比较。持续存在的不一致可能表明关联错误、投影质量不佳或姿态不合理。
根据论文,这一流程会移除约 30–40% 的候选训练数据,不确定案例则留作人工检查。该图展示了候选数据清理流程;不应据此推断作者在此处未提供的精确保留小时数。
随后,训练分为两个阶段进行:
这种安排使具有不同标注覆盖范围的数据集能够为模型中其可监督的部分作出贡献。
InfiniHand 以窗口方式处理输入视频,同时保留几何记忆。其上下文包括初始参考信息、近期细节特征,以及来自较早观测结果的压缩信息。
该实现让两项预测任务重叠执行:一个工作进程通过主干网络处理即将到来的窗口,另一个工作进程则对前一个窗口进行手部和摄像头预测解码。复用特征并减少空闲时间有助于提高吞吐量。
论文报告的预测吞吐量为 11.19 FPS,而 HaWoR 为 5.48 FPS,在所报告的对比条件下提升了 2.04 倍。这并不意味着其在 30 FPS 下具有普适的实时运行能力,也不保证在任意硬件上都能达到该速度。
对于更长的序列,另一个工作进程会执行稀疏光束法平差,以细化摄像头轨迹。二进制关键帧池会保留近期观测,同时保留选定的较早帧。这种后台优化除所报告的预测吞吐量外,还会带来额外计算成本。
摄像头空间评估涵盖了 34 个 ARCTIC 场景、10 个 HOT3D 场景、166 个 HOI4D 场景和 100 个 EgoDex 场景。研究人员将其与多种现有重建方法进行了比较。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
报告重点列出了 PA-p,这是一项同时考虑姿态误差和漏检惩罚的指标。在所报告的对比中,数值越低越好:
| 数据集和指标 | 对比方法 | InfiniHand | 报告的降幅 |
|---|---|---|---|
| ARCTIC PA-p | ViDiHand:9.82 mm | 7.72 mm | 21.4% |
| EgoDex PA-p | ViDiHand:17.22 mm | 7.29 mm | 57.7% |
| EgoDex 世界空间 W-MPJPE | Dyn-HaMR:78.41 mm | 28.77 mm | 63.3% |
这些行涉及不同的数据集和指标;不应将它们平均为单一的准确率结论。InfiniHand 还报告称,在 ARCTIC、HOT3D 和 EgoDex 上,其 W-MPJPE 是所比较方法中最低的。
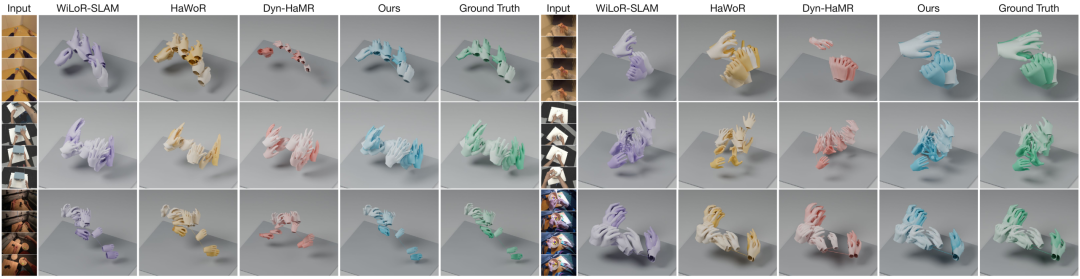
对齐后的定性比较:蓝色表示 InfiniHand,绿色表示参考结果。对齐是可视化的一部分,在解读表观一致性时应将其纳入考虑。
资料来源还讨论了涉及遮挡和物体交互的自然场景 Ego4D 示例。其中一个展示的离线对比为 InfiniHand 使用了外部手部定位。读者应将这一设置与统一模型自身的定位主张区分开来;交互式项目演示提供了相关的视觉上下文。
恢复人类演示的 3D 数据有助于为灵巧操作、运动迁移和模仿学习研究准备数据。将重建的手部数据转化为机器人训练数据,仍然需要质量检查,以及针对机器人物理结构进行适配。
作者指出了若干限制。LingBot-Map 本身无法恢复度量尺度,因此需要一个辅助对齐模型,而该模型可能引入误差。快速视角变化、严重遮挡和间歇性手部可见性仍然较为困难,因为适合的训练数据有限。
单目监督还可能将随时间变化的尺度漂移带入训练。稀疏细化可以提供帮助,但并不能使每一条恢复出的轨迹都成为精确的物理测量结果。
它从第一视角视频中估计手部位置、MANO 手部参数和摄像头轨迹。这些估计结果支持在统一世界坐标系中表示手部运动。
摄像头空间中的手部运动会随摄像头移动而变化。统一的世界坐标系可以在考虑移动视角的同时,更方便地比较不同帧之间的手部轨迹。
所提出的框架包含自己的定位组件。不过,资料来源指出有一个离线定性示例使用了外部手部定位,因此读者应检查每个展示对比的具体设置。
不是。这是在作者所报告评估条件下的预测吞吐量。后台稀疏光束法平差会带来额外工作量,性能也取决于实际执行配置。
研究人员将投影后的标注与基于图像预测的 2D 手部关键点进行比较,并剔除持续存在不一致的序列。他们报告称,约移除了 30–40% 的候选数据,并将模糊案例保留给人工检查。
论文展示的是重建和标注研究,而非经过验证的直接机器人控制系统。机器人应用还需要进行重定向、满足物理约束,并完成特定任务验证。
InfiniHand 结合场景几何、精细手部外观和摄像头估计,从第一视角视频中恢复手部运动。其流式设计和数据清理流程旨在应对大规模视频集合标注这一实际挑战。
所报告的准确率和吞吐量提升是有前景的研究结果,但存在与尺度恢复和后台细化相关的重要条件。该输出是一种有用的重建估计,但在用于下游物理任务前仍需验证。
从一句话开始,几分钟内拿到完整网站。
