For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/meta-muse-wonder-and-full-benchmarks-memo-741b367d.md.
Meta 于 2026 年 10 月 12 日推出 **Muse Wonder** 和 **Muse Wonder Full**。此次发布面向个人及专业智能体:这类系统需要记住有用的上下文、解决过程中的障碍,并完成不止需要一次回答的项目。
Meta 于 2026 年 10 月 12 日推出 Muse Wonder 和 Muse Wonder Full。此次发布面向个人及专业智能体:这类系统需要记住有用的上下文、解决过程中的障碍,并完成不止需要一次回答的项目。
官方公告确认,Wonder 可通过 Meta Model API 和 Muse Code 使用,而 Full 面向 Muse Code 订阅用户提供。Meta 还计划将 Wonder 引入其 Muse 助手,首先向订阅用户开放。
模型卡列出了 100 万 Token 的推理上下文,以及涵盖文本、图像、视频和音频的输入。所列输出模态为 文本。因此,多模态理解不应被误解为该模型本身承诺生成每一种输入媒体。
Meta 表示,这些模型在其千兆瓦级 Prometheus 数据中心完成训练,这是其更广泛重建 AI 技术栈的一部分。训练基础设施说明了此次发布的背景;但它并不能证明每个应用都能达到基准测试演示中的表现。
提供的报告称,Wonder Full 在 Artificial Analysis Intelligence Index 上获得 56 分,Wonder 为 52 分,Muse Spark 1.3 为 48 分。Artificial Analysis 自身的评测以最高推理强度佐证了这些数字。这些数据反映的是所报告的评测快照,而非永久排名。
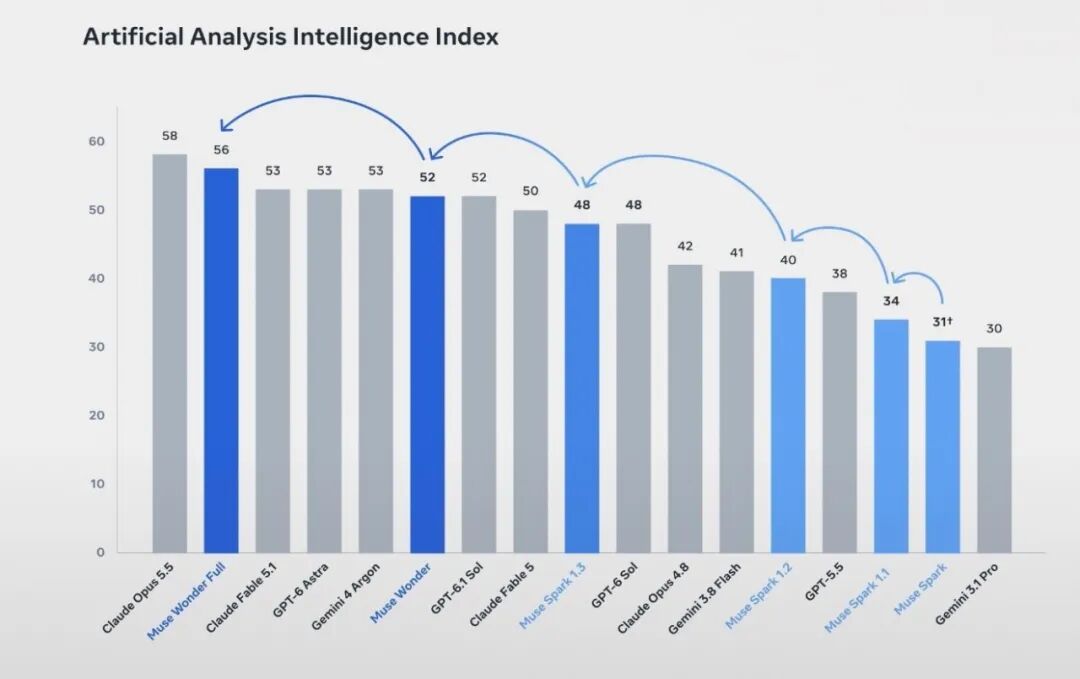
图表转载自 BAAI 上的新智元报告;其中将评测归因于 Artificial Analysis。
对于持续性软件工作,来源报告了以下结果:
| 评测 | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon | 57.5% | 53.1% | 46.3% | 42.5% |
| DeepSWE v1.1 | 79.0% | 78.8% | 74.2% | 74.1% |
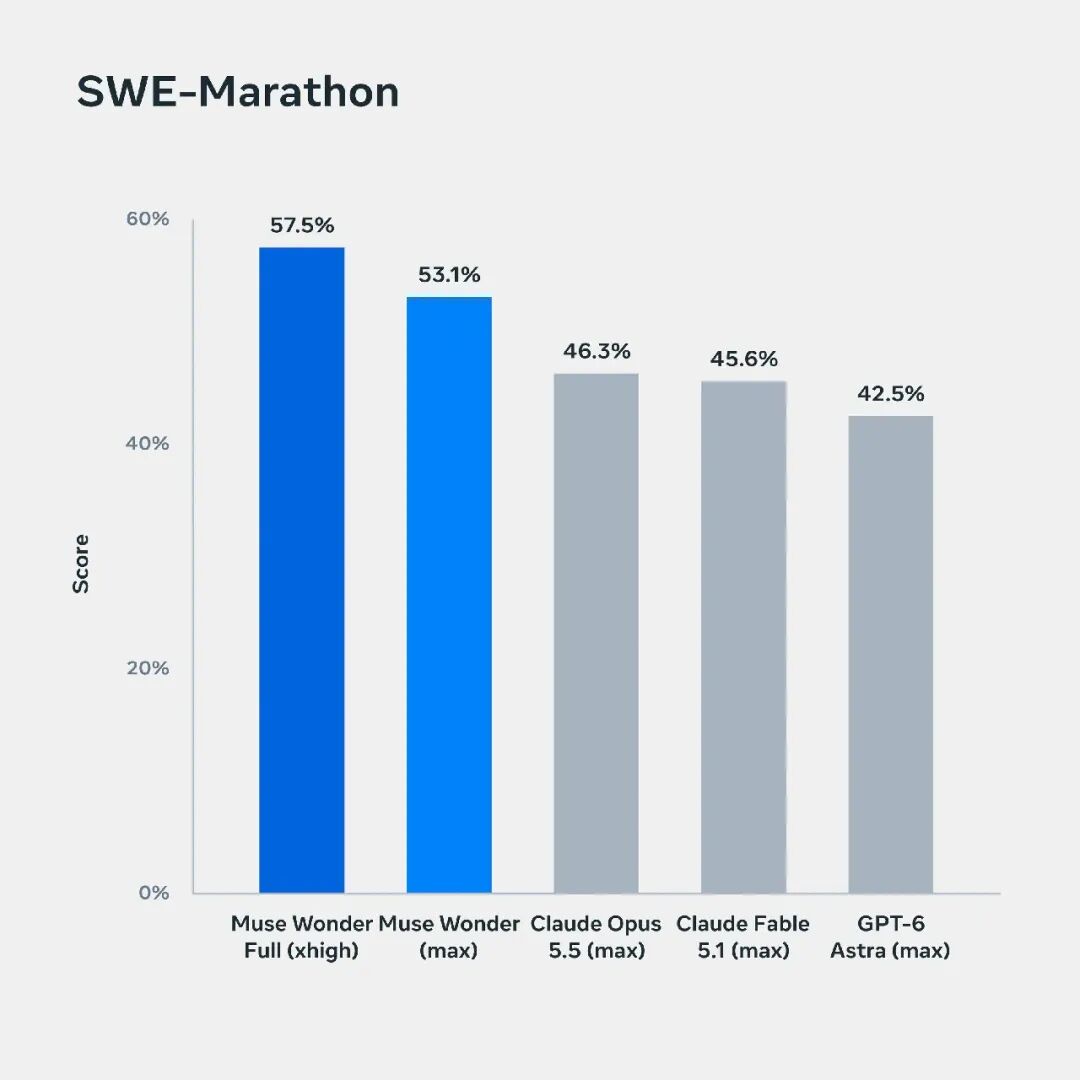
来自 Meta 的基准测试图表,由来源文章转载。
模型卡给出了一个重要限定:SWE-Marathon 并不是在统一公共测试框架下进行的受控对比。部分竞品结果使用 Codex 或 Claude Code,而 Wonder Full 的报告结果使用 xhigh 推理强度。DeepSWE 也汇集了指定的第三方结果和提供商报告结果,因此读者应查阅各项基准测试的方法论。
整体情况是好坏参半,而非全面领先。文章称,Full 在 ProgramBench 上领先 GPT-6 Astra,但落后于 Opus 5.5;在所列终端编程对比中,也落后于两者。模型选择仍取决于实际工作内容、工具环境、预算和可接受的失败率。
Meta 使用 Active Memory 在对话之间保留重要上下文,并在需要时检索相关细节。它使用 Active Focus 支持持续工作:尝试其他方法、适应新信息,以及在遇到阻碍时继续推进。
这些能力解决的是不同问题。记住一项需求,并不自动意味着智能体可以完成困难的实施工作;如果智能体丢失了关键约束条件,持续推进也无济于事。
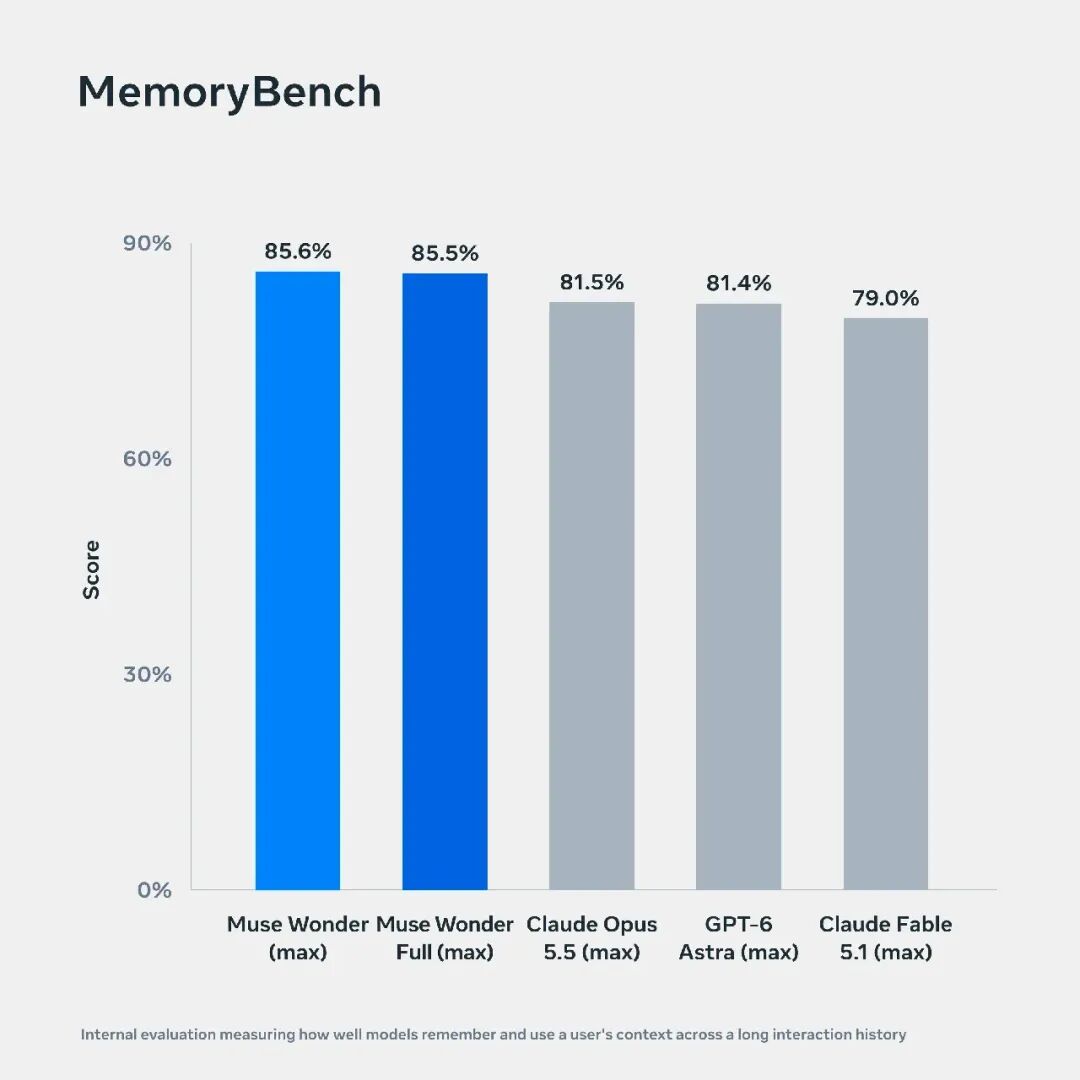
Meta 评测图表,经由来源报告转载。
模型卡将 MemoryBench 描述为一项内部评测,使用包含干扰性或冲突信息的 64,000 至 100,000 Token 对话。FocusBench 同样是一项内部评测。这些内容有助于说明测试了什么,但并不保证在实际部署的服务中实现无缺陷回忆或不中断的自主执行。
Meta 除编程外,还在法律、金融、医疗和专业文档相关任务上评估这些模型。这些测试针对的是特定工作产物和评分规则;分数不应被视为专业资质认证。
中文报告还强调了选择性作答与知识覆盖更广之间的区别。报告称,Full 的幻觉指标低于所比较的 Opus 和 Astra 模型,但其知识指数也较低。在该讨论中,幻觉百分比以知识测试中回答错误或未作答的题目为条件计算;它并不是所有真实世界回答中错误回答的比例。
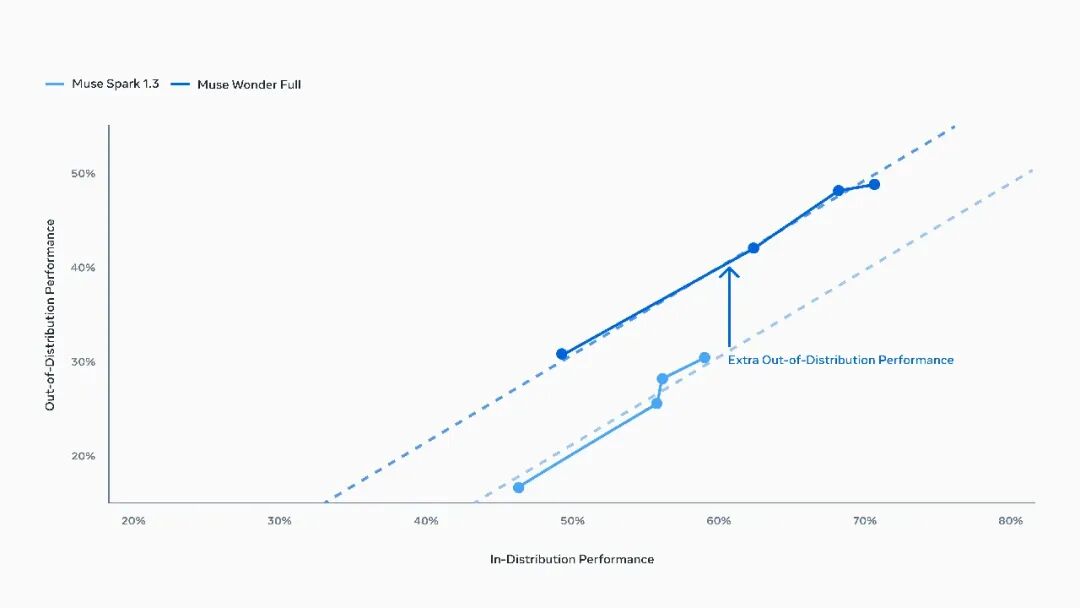
对于不熟悉的任务,Meta 提供了证据表明:在可比的分布内表现下,Full 对新任务的泛化能力优于较早的 Spark 模型。该结论针对的是被测评测环境,并非无限制自我改进能力的证明。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
来自 Meta 的泛化能力图表,由来源文章转载。
来源列出了其报告发布时的以下价格:
| 产品 | 报告价格 | 报告获取方式 |
|---|---|---|
| Wonder API 输入 | 每百万 Token 4 美元 | 按使用量计费的 API |
| Wonder API 输出 | 每百万 Token 20 美元 | 按使用量计费的 API |
| Wonder API 缓存输入 | 每百万 Token 0.20 美元 | 缓存输入 |
| Full:Power Usage | 每月 50 美元 | Muse Code 订阅 |
| Full:Maximum Usage | 每月 200 美元 | Muse Code 订阅 |
报告称,两档 Full 订阅分别提供基础用量的 20 倍和 80 倍。这些倍数并不等同于无限使用,且来源并未给出每月通用的任务数量。
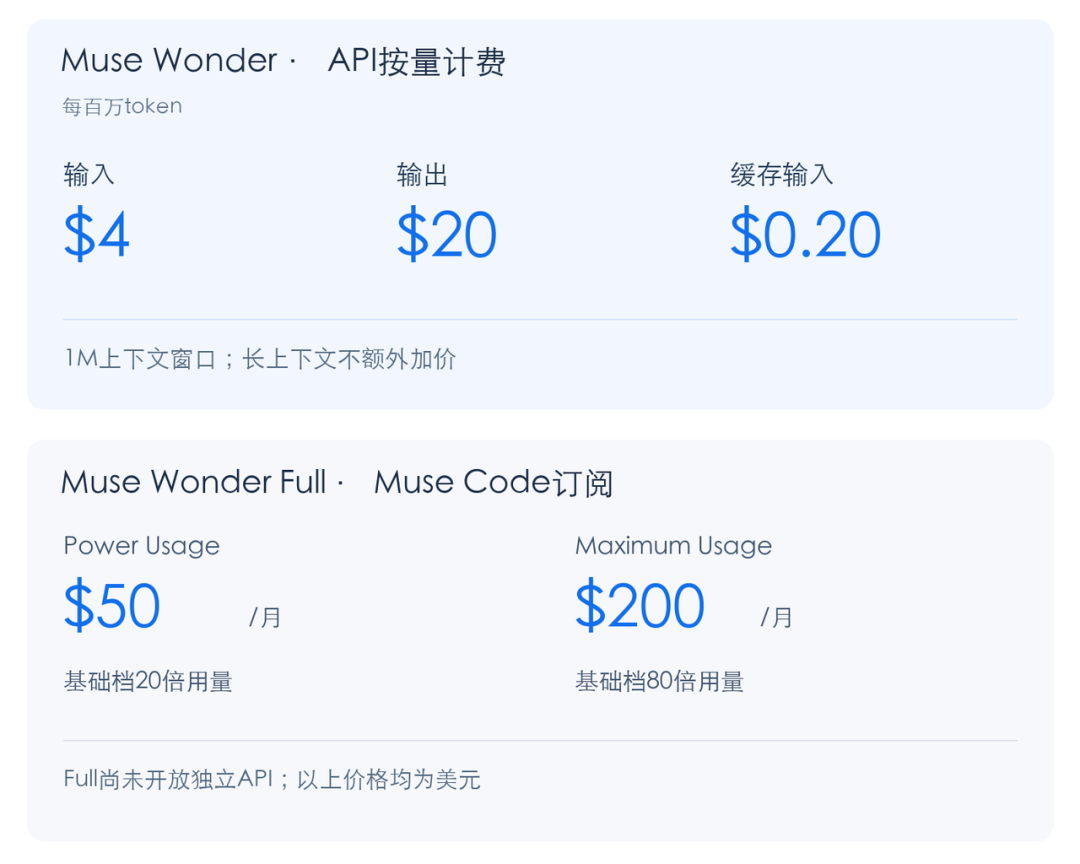
价格图表注明来源报告;当前计费条款无法被独立访问核实。
在公告发布时,Full 通过 Muse Code 订阅提供,而不是通过另行公布的公共 API 提供。考虑使用任一产品的团队,应在将其用于工作负载前确认自身账户当前实际可用的访问权限和价格。
Muse Wonder 是 Meta 于 2026 年 10 月 12 日发布的模型,面向个人和专业智能体任务。Meta 将其优势描述为记忆、持续执行任务、编程和特定领域工作。
在许多已报告的评测中,Full 是性能更高的版本。官方公告通过 API 和 Muse Code 提供 Wonder,而 Full 面向 Muse Code 订阅用户提供。
Meta 的模型卡列出了 100 万 Token 的推理上下文。上下文容量不同于可靠回忆、输出限制,以及具体应用可提供的可用材料数量。
模型卡列出了文本、图像、视频和音频输入。其列出的输出为文本,因此多模态输入支持不应被理解为原生音频或视频生成能力。
不是。报告分数适用于特定任务、智能体设置和推理设置。Meta 明确指出,SWE-Marathon 结果并未在所有对比系统之间采用统一的受控测试框架。
Active Memory 关注跨对话保留和检索相关上下文。Active Focus 关注在任务过程中克服障碍并适应变化,必要时进行澄清或确认。
10 月 12 日的公告称,Full 面向 Muse Code 订阅用户提供。该公告没有宣布独立的公共 Full API,后续可用性应以最新官方通知为准。
Muse Wonder 和 Full 通过 100 万 Token 上下文、多模态输入、记忆和持续编程能力,扩展了 Meta 的智能体产品布局。公告确认了不同的 API 与订阅获取路径,而来源报告称其相较 Muse Spark 1.3 有显著提升。
最有价值的比较方式,是将基准分数与其测试框架、账户访问权限,以及完成自身任务的成本结合起来考量。
从一句话开始,几分钟内拿到完整网站。



