For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7 将一个拥有 350 亿参数的混合专家模型带到包括手机在内的本地设备上。ModelBest 和 OpenBMB 表示,在优化后的部署栈下,该模型在 iPhone 17 Pro Max 上可实现每秒生成超过 13 个词元,并使用约 3 GB 内存。

MiniCPM-V 4.7 将一个拥有 350 亿参数的混合专家模型带到包括手机在内的本地设备上。ModelBest 和 OpenBMB 表示,在优化后的部署栈下,该模型在 iPhone 17 Pro Max 上可实现每秒生成超过 13 个词元,并使用约 3 GB 内存。
这个数字需要结合上下文理解。它并不意味着完整的 35B 模型可以装入 3 GB 的下载包,也不意味着任何拥有 3 GB RAM 的手机都能以宣传的速度运行它。该模型会从存储空间流式加载专家权重,并通过调度、量化和推理优化来保持较小的活跃工作集。
该版本有两个主要变体:
| 变体 | 设计 | 预期用途 |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | MoE,总参数量为 35B,每个词元约激活 3B 参数 | 更强的本地图像、文档、多图和视频理解能力 |
| MiniCPM-V 4.7 1B | 小型稠密模型;QbitAI 将其描述为约 13 亿参数 | 资源要求较低的视觉任务、OCR 和文档提取 |
35B-A3B 模型是 MiniCPM-V 系列中的首个 MoE 模型。该项目于 2026 年 10 月 12 日发布 4.7,随后于 10 月 15 日为两个变体发布了 DSpark 推测解码头。
该仓库列出了对 iOS、Android 和 HarmonyOS 的部署支持,也说明支持 Intel、AMD、Arm、Rockchip 和 Houmo 平台。实际性能取决于设备、模型格式、推理后端和配置,因此不应将平台支持理解为不同硬件上的速度完全相同。
官方 35B-A3B 评估表报告了其在指令模式下的以下结果:
| 基准测试 | 4× 视觉压缩 | 16× 视觉压缩 |
|---|---|---|
| MMBench | 91.72 | 90.87 |
| MMStar | 80.67 | 80.13 |
| MMMU | 80.22 | 80.00 |
| MathVista | 88.00 | 87.30 |
| OCRBench | 91.20 | 90.40 |
| OmniDocBench v1.6 | 94.24 | 93.25 |
| Video-MME,不含字幕 | 76.40 | 74.70 |
| LongVideoBench | 68.90 | 67.60 |

来源:OpenBMB,MiniCPM-V 仓库。该表将公开报告与团队使用官方检查点在指令模式下进行的本地评估相结合。
该表显示,在转向更高视觉压缩率时,多个任务的下降幅度相对较小。例如,MMBench 下降 0.85 分,OCRBench 下降 0.80 分。其他任务的损失更大,因此开发者仍需检查小文本、图表或视觉细节是否对自身工作负载至关重要。
这些是模型评估结果,并不能证明移动端配置能够复现每一项分数,也不能保证每一张用户图像都会被正确理解。它们可作为选择测试内容的参考点。
MoE 通过每个词元仅激活选定专家来降低计算量。但它不会消除存储其他专家的需求,因为后续词元和层可能会选择不同的专家。
在内存受限的手机上,将这些权重存储在闪存中可以让模型可用,但反复等待存储读取会使解码变慢。将路由限制为固定的一小部分专家能够减少加载,但也会改变模型可使用的专家。MiniCPM-V 4.7 则尝试在保留路由器实际决策的同时,让加载与计算重叠进行。
前瞻专家调度(Lookahead Expert Scheduling,LES)会预测下一层可能需要哪些专家,并预加载其权重。当实际路由器选择专家时,推理引擎会先计算已可用的选定专家,同时加载其余必需专家。
预测改变的是准备和执行顺序。它不会取代模型的路由决策:预测遗漏的专家仍会在被选中时加载并参与计算。这一区别解释了该技术为何能提升速度,而无需依赖永久缩减的专家池。
官方指南将 LES 与细粒度逐层量化相结合。更小的专家权重可减少存储空间与内存之间的数据传输,而优化后的布局使加载效率更高。团队表示,其设备端优化工作在真实设备上实现了五倍的解码提升;这是其测试配置的结果,并非普遍适用的倍数。
DSpark 添加了一个草稿模型,用于提出候选词元供主模型验证。该版本为两种尺寸均提供了专用草稿头。这也是优化栈中的另一个组成部分,因此不应假设在通用后端中运行标准检查点可以获得相同速度。
在视觉侧,该模型基于 LLaVA-UHD v4,在视觉编码器内部采用早期压缩。在早期合并视觉词元可减少后续编码器层的工作量。可选的 4× 和 16× 设置体现了视觉细节与推理成本之间的权衡。
官方移动应用文档对完整部署给出了更清晰的说明:
| 移动端部署项目 | 文档记录的要求或大小 |
|---|---|
| 经验证的 35B-A3B 手机 | 配备 12 GB RAM 的 iPhone 17 Pro Max |
| 35B-A3B 演示推荐设备 RAM | 至少 12 GB |
| 35B-A3B 模型总下载量 | 约 16.6 GB |
| 建议可用存储空间 | 模型文件约需 17 GB |
| 专家存储 | 独立的 experts/ 目录,包含 40 个分片和一个清单文件 |
| 默认演示上下文窗口 | 4K 词元 |
拆分后的移动包不同于标准的整模型 GGUF。其主 -les 文件依赖匹配的专家目录,应用会检查文件是否一致。更大的上下文窗口会增加 KV 缓存内存,而在低 RAM 设备上使用更小的专家缓存可能会显著降低生成速度。
较小的工作内存数值并不意味着不再需要大量且高速的本地存储空间。
QbitAI 的文章展示了本地手机和平板电脑示例,随后是独立的 API 测试。区分两者非常重要:API 结果不能证明同一任务是在手机上离线运行的。
在开头的 iPhone 演示中,该模型分析了 Minard 绘制的拿破仑俄国战役图表。当被问及最低温度及其日期时,它识别出 1812 年 12 月 6 日的 −30° Réaumur,并使用 °C = °Ré × 1.25 将其换算为 −37.5°C。
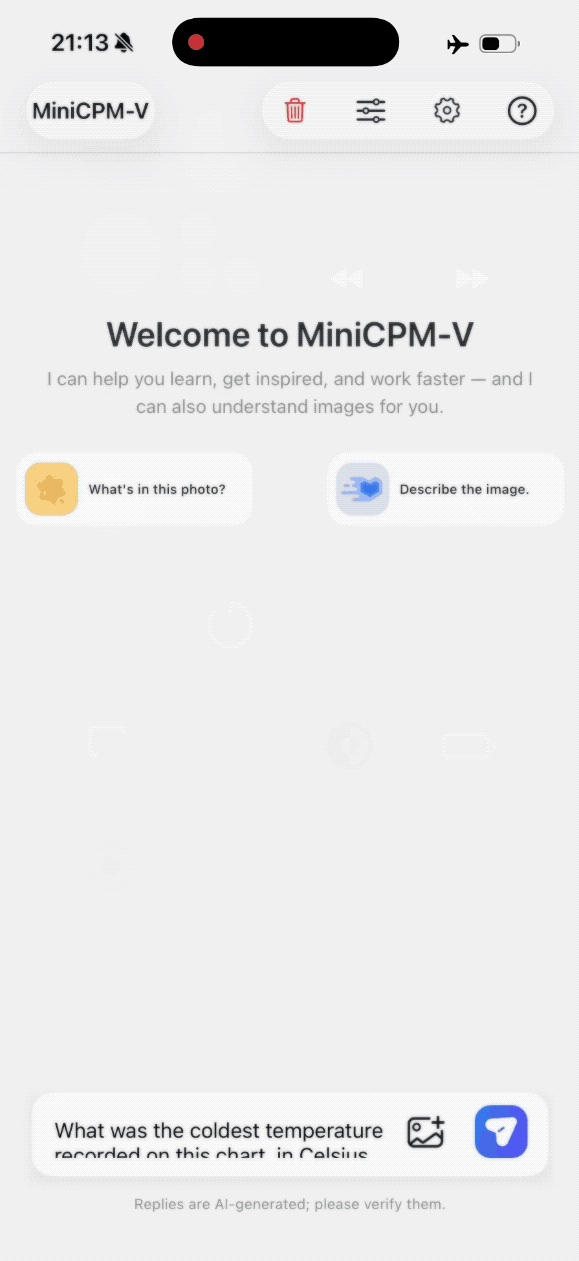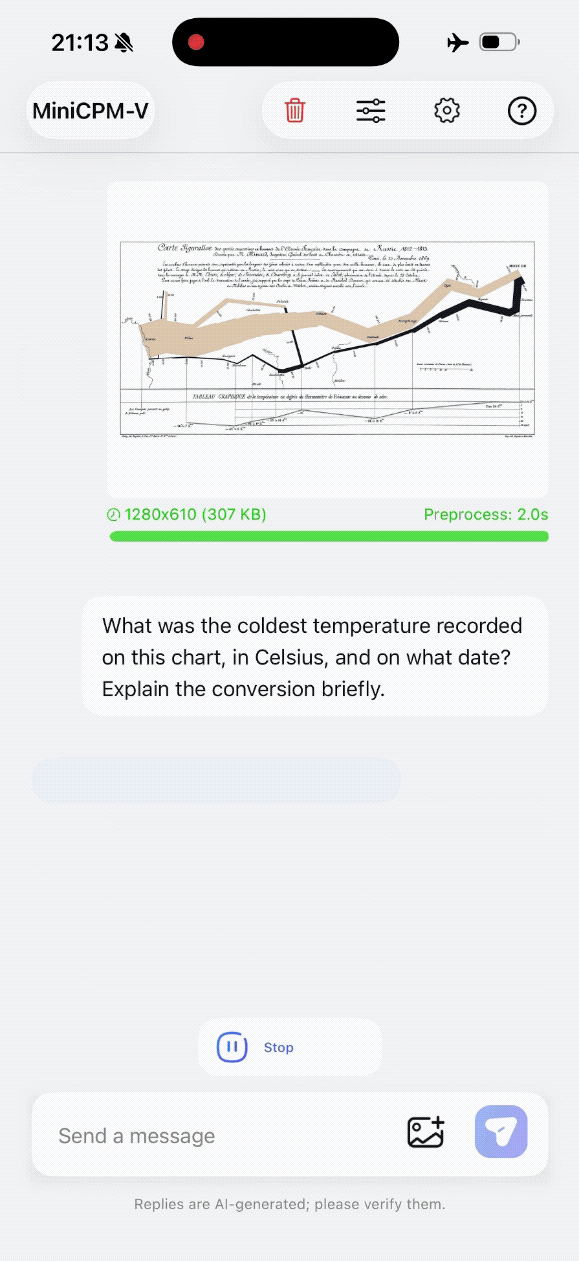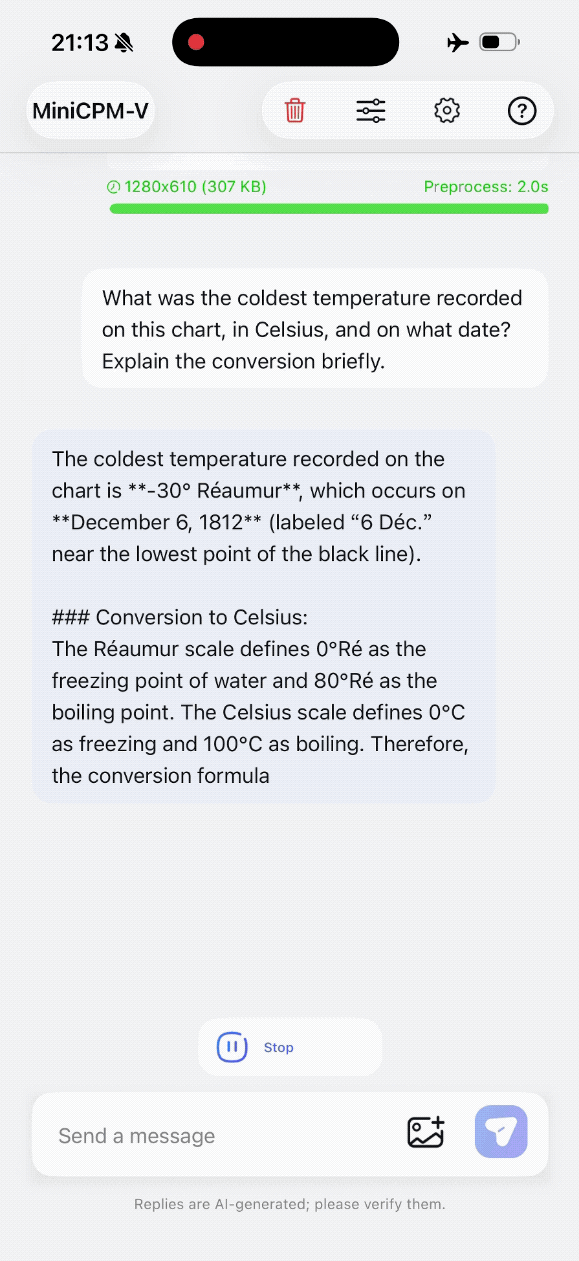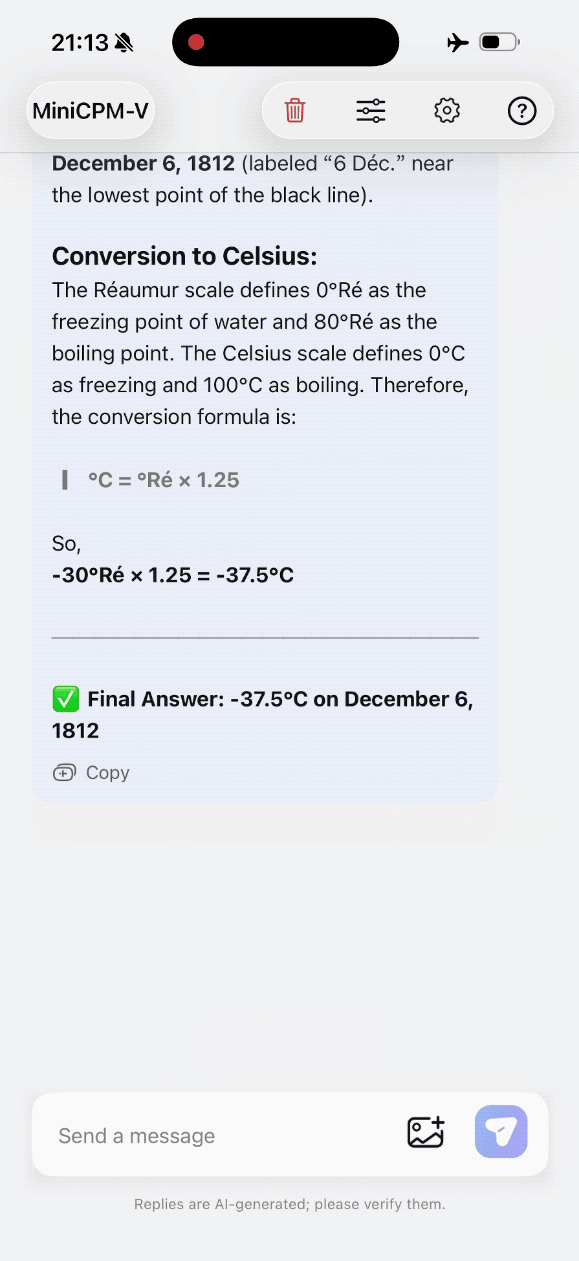
来源:QbitAI,经由 BAAI;手机屏幕录制动图。该来源还报告称,M4 iPad 也给出了相同答案。
这个示例测试的不只是文本识别。模型必须读取图表,将日期与相关数据点关联,识别温度刻度,并完成单位换算。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
另一个示例将电器功率和使用时长与每月 420 kWh、费用 ¥126 的账单相结合。报告的输出估算所列电器耗电量为 213.63 kWh,占账单约 50.9%,并将减少空调使用确定为三个拟议节能方案中最佳的一个。
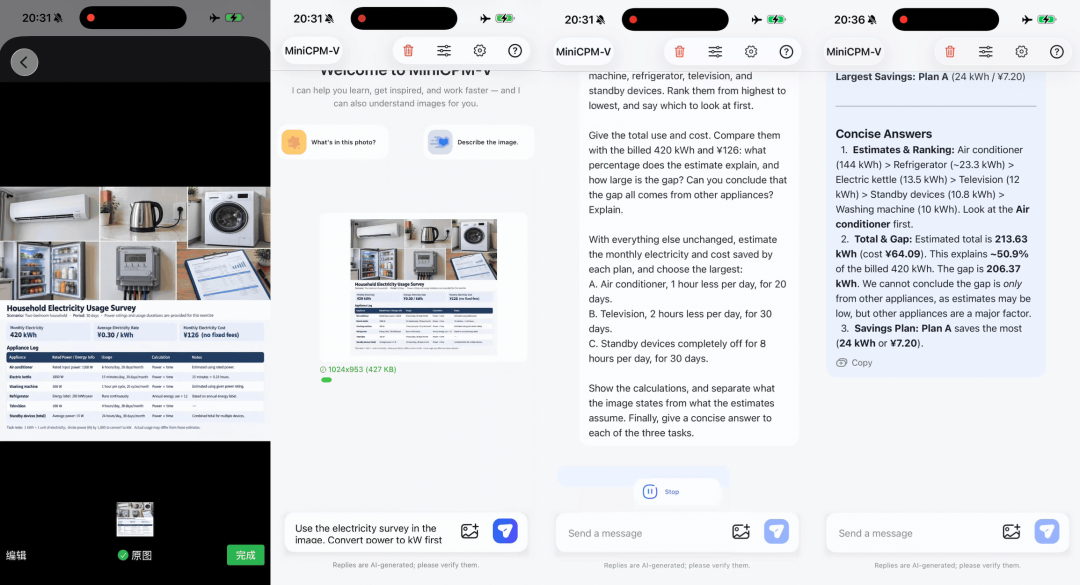
来源:QbitAI,经由 BAAI。显示的答案将无法解释的用电量视为不确定因素,而非自动归因于其他电器。
这种限定很有价值:估算的使用时长、实际功率以及未列出的设备都会影响账单对比。仅有正确的算术总和,并不能证明其余用电量是如何产生的。
较小的模型被展示为可将论文页面转换为 Markdown,包括标题、表格和数学符号。QbitAI 表示,该演示用时不到半分钟。
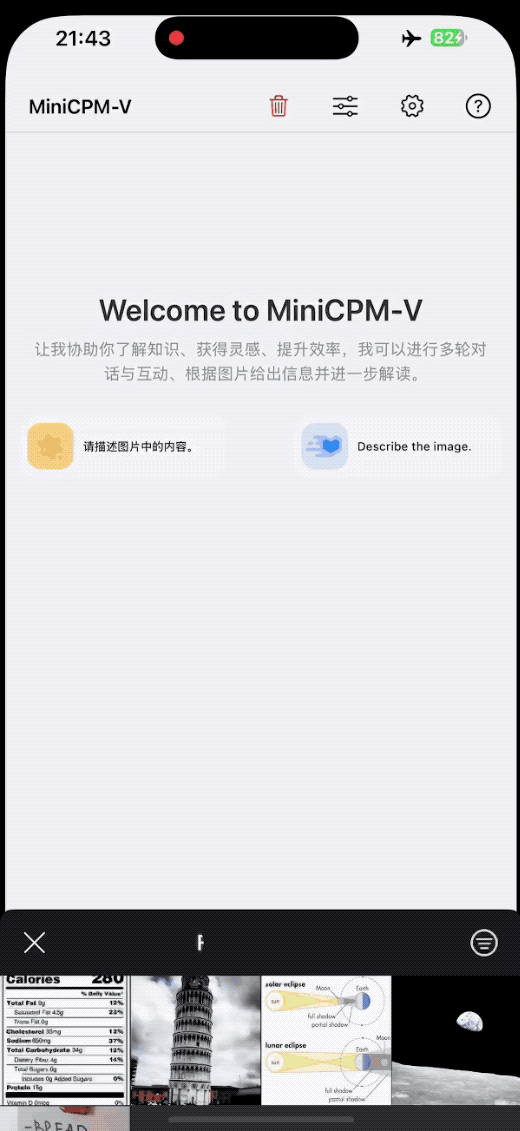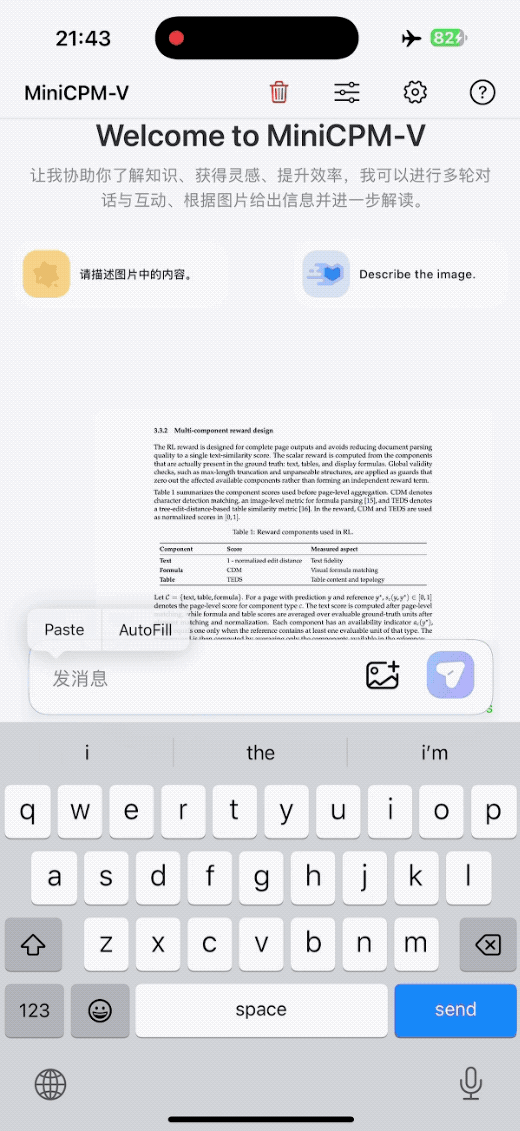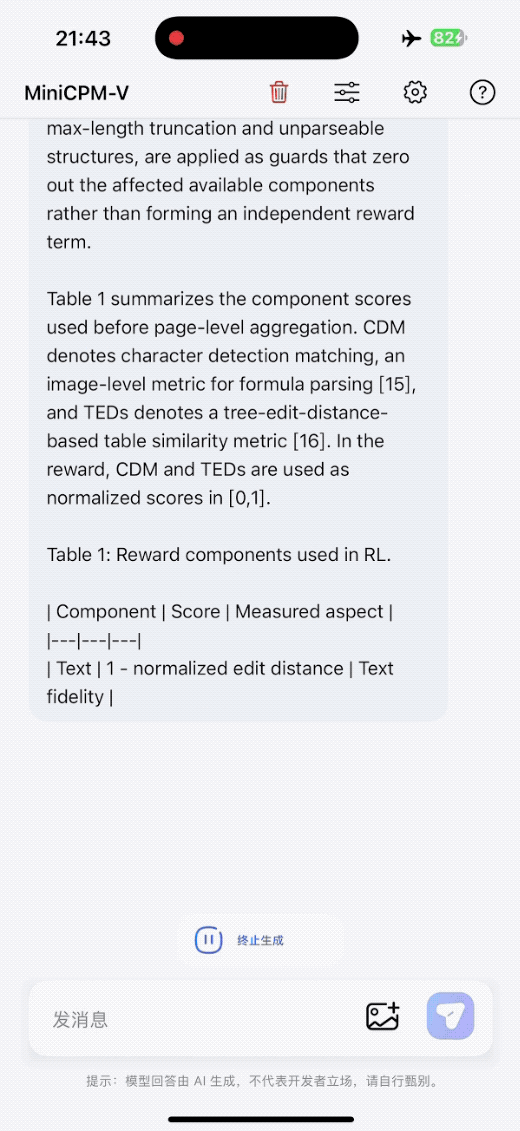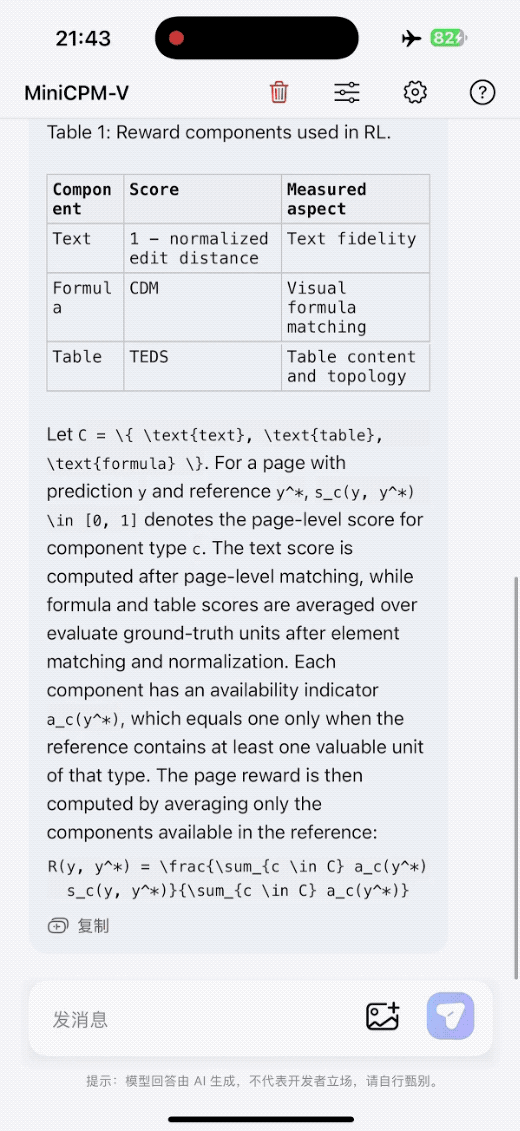
来源:QbitAI,经由 BAAI;本地文档演示动图。
在其独立的 API 测试中,文章报告了一项收据计算:¥86.40 减去 ¥8 折扣,与 ¥78.40 的支付金额一致。文章还描述了一项停车规则任务,需根据清洁限制、两小时上限、居民豁免和再次入场条件,核查 90 分钟的停车时长。这些均为示例性测试,而不是系统性的准确率研究。
一项相关发布旨在解决定制过程中的遗忘问题。自回放微调(Self-Replay Fine-Tuning)会从原始模型生成通用领域回复,对其进行质量过滤,并在标准监督微调期间将保留示例与新任务数据混合。
该方法改变的是训练数据,而不是模型架构或损失函数。回放示例可以在训练前生成并重复使用,从而减少每次运行时对新的在线滚动生成的需求。
OpenBMB 的文章报告了在计数和文档 OCR 实验中令人鼓舞的保留效果,包括对早期 MiniCPM 模型和其他模型家族的测试。这些结果不应被表述为对所有 4.7 微调任务的全面保证。提示词覆盖范围、过滤质量以及任务与回放数据的比例仍是实验性选择。
移动应用仓库提供 iOS、Android 和 HarmonyOS 演示。对于手机端 MoE 路径,其应用内模型管理器会下载匹配的主文件、视觉投影器和专家分片;仓库警告称,普通未拆分的桌面 GGUF 文件不能与该移动包互换使用。
对于其他部署方式,4.7 指南列出了 SGLang、vLLM、llama.cpp 和 Ollama,以及用于微调的 SWIFT 和 LLaMA-Factory。它链接了包括 GGUF、BNB、AWQ、GPTQ 和 FP8 在内的量化选项。应根据目标运行时选择相应制品,而不是将每一种支持的格式都视为可直接用于移动端的模型。
在必要的应用和模型文件已存在于本地后,即可开始离线推理。这避免了将每一次推理请求发送给云端模型,但应用权限、本地数据处理、存储空间和硬件性能仍是实际部署中需要关注的问题。
它是 ModelBest 和 OpenBMB 发布的多模态模型版本,包含 35B-A3B MoE 变体和小型 1B 变体。它支持涉及图像、文档、多张图像和视频的任务。
该项目展示了在 iPhone 17 Pro Max 上优化部署 35B-A3B 模型。它将较小的工作集保留在内存中,同时从本地存储流式加载专家,而非一次性将全部 35B 参数载入 RAM。
不是。官方移动演示列出的 35B-A3B 包总下载量约为 16.6 GB,并建议预留约 17 GB 的可用存储空间。其验证使用的 iPhone 配备 12 GB 设备 RAM。
不是。LES 会预测要预取的专家,并优先调度已可用的专家。模型的实际路由器仍会选择需要计算的专家,包括预测遗漏的专家。
可以,在下载或安装所需文件后,本地演示会在设备上执行推理。来源中的 API 示例是独立测试,不应与离线运行混淆。
不能。该演示需要匹配的拆分包,包括其 -les 主文件、视觉投影器和专家分片。应用文档解释了为何标准整模型 GGUF 文件无法提供相同的手机端部署行为。
MiniCPM-V 4.7 结合稀疏计算、专家流式加载、前瞻调度、量化和视觉压缩,使更大的多模态模型能够在选定的本地设备上实用运行。演示涵盖图表解读、文档转换和日常计算,而已发布的基准测试则提供了评估的起点。
关键部署限制在于工作内存、设备总 RAM 和存储权重之间的差异。手机端结果作为特定优化配置是可信的,但它并不承诺完整 35B 模型可装入 3 GB,也不承诺其能在每台设备上以同等效果运行。
从一句话开始,几分钟内拿到完整网站。