MiniMax H3 是面向完整制作流程的多模态视频模型,可处理文本、图像、视频和音频并生成带原生音频的 2K 视频。本文介绍其在广告、电商、产品设计和社交内容中的实际用法。
视频生成模型发展迅速,但大多数仍停留在素材生成器的层面。它们生成一段片段,然后让创作者在另一款剪辑应用中自行处理字幕、排版、转场、调色、音乐、节奏和视觉效果。
MiniMax H3正是为了改变这一工作流程而设计。
H3于2026年7月31日发布,是一款通用多模态视频模型,可在同一上下文中接受文本、图像、视频和音频输入。它可以生成4至15秒的同步立体声视频,输出分辨率可达768p或最高2K。
MiniMax表示,该模型旨在参与完整的内容制作流程,而不仅仅是生成原始素材。其目标应用场景包括广告、品牌推广、电子商务、产品设计、UI和UX、游戏、动态海报、片头序列以及社交媒体内容。
MiniMax将H3定位为开源权重、通用型多模态视频模型。
原始报告将这一转变描述为视频生成迎来了它的“编程时刻”。这一比喻并非字面意义,但这个想法很有价值:创作者可以越来越多地描述他们想要的结果,提供参考资料,检查输出,并通过自然语言指令进行迭代,而无需手动构建每一个层次。
开源权重状态: MiniMax最初表示权重将在数天内发布。官方H3-Base检查点现已可在Hugging Face上获取,遵循MiniMax H3社区许可。然而,H3-Context-IR、H3-Regenerate-2K以及稀疏注意力实现并未全部包含在初始权重发布中。
最初令人惊艳的示例并非简单的电影镜头。它们包括动态排版、手绘效果、产品图形、动画片头序列、音乐、对话和转场。
这些通常被视为独立的后期制作任务。
传统工作流程可能如下:
H3试图将其中多个决策整合在一起进行建模。
一个提示词可以描述视觉风格、镜头顺序、节奏、屏幕文字、表演指导、声音景观和转场效果。参考文件可以提供角色、产品、动作、摄影机风格、声音、配乐或剪辑节奏。
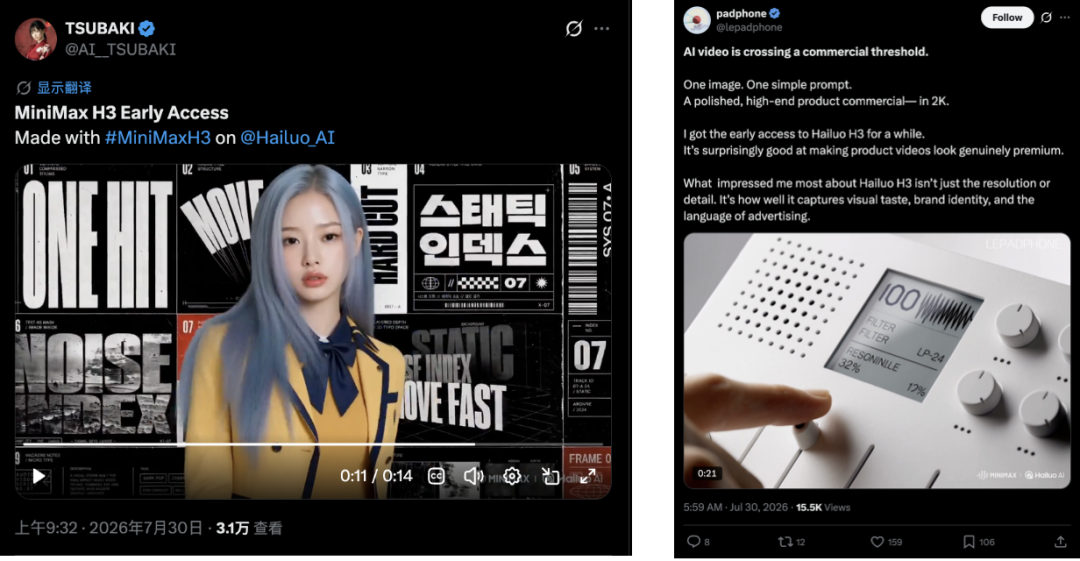
早期测试者使用H3制作风格化角色视频和精致的产品
advertising.*
这并不意味着专业编辑软件已经过时。较长的项目仍然需要精确的时间线控制、资产管理、修改、法务审核以及多种格式的交付。
重要的变化在于,模型现在可以在一次生成中产出更接近成品短视频素材的内容。
原作者通过MiniMax的Hailuo界面测试了H3。
第一个实验是一段虚构男团幕后花絮视频,主角是AI行业知名人物。文本提示词描述了预期的基调和剪辑风格,而H3负责生成视觉序列。
随后作者测试了一段带有苹果风格演示美学的发布视频。仅添加了简短风格标签,生成结果却包含了半透明玻璃效果、渐变、动态图形以及类似演示的节奏。
一个更具挑战性的测试使用了长提示词来描述一支六镜头预告片。每个镜头都有各自的情感方向、表演指导和节奏。
根据报告,H3紧密遵循了镜头顺序,生成了场景分明的快速蒙太奇,而非将指令压缩成一段泛泛的片段。
这类任务同时考验多项能力:
结果仍然属于主观演示,而非受控基准测试。一个成功的社媒案例并不能保证每条长提示词都能一次成功。
尽管如此,与以往只期待简短视觉描述的老式视频系统相比,该模型显然更适合结构化的创意指令。
文字历来是AI生成视频中最脆弱的环节之一。
图像模型只需在一帧中正确渲染一个词。视频模型则必须在镜头、表面、光照和周围场景持续运动的同时,在大量帧中保持相同的字形。
任何一帧的小错误都可能导致闪烁、拼写错误或排版不稳定。
原版测试表明,H3在以下方面已达到可用的水平:
MiniMax官方发布材料中也将精准的文字和品牌渲染列为核心能力。
该模型并不能保证每次生成都产出完美文字。小字号、长句、特殊字体和复杂运动仍可能导致失败。
H3更有价值之处在于,它似乎能建模文字与场景之间的关系。
在一个示例中,与钻石项链相关联的文字呈现出反射光照和景深感,而非简单的平面叠加。这更接近视觉合成,而非普通的字幕放置。
对于商业团队而言,可靠的排版往往比华丽的电影级运镜更有价值。广告、产品
发布、社交媒体内容等都依赖于可读的信息。
H3 联合生成音视频。
官方模型卡说明如下:
MiniMax 列出的支持对话语言包括:
其他语言可能也能使用,但质量会有差异。
原文还指出,用户可以提供音频作为参考。H3 可以结合语音片段、音乐或其他音频素材,同时配合图像和视频参考。
在当前 API 中,音频不能作为唯一的参考输入,必须同时提供图像或视频。
这一集成非常重要,因为生成的语音应匹配场景的节奏和情感。视频后期添加的配音虽然听起来正确,但仍可能与面部动作、节奏或镜头切换脱节。
H3 的原生视听设计旨在令这些元素保持对齐。
MiniMax 按照生成视频的时长对 H3 进行定价。
当前全球按量付费费率如下:
| 输出 | 价格 |
|---|---|
| 2K 视频 | 每秒 0.13 美元 |
| 768p 视频 | 每秒 0.08 美元 |
| 768p 至 2K 重新生成 | 每秒输出 0.05 美元 |
| H3-Context-IR 输入 | 每百万 tokens 0.90 美元 |
| H3-Context-IR 输出 | 每百万 tokens 3.60 美元 |
按当前费率计算,10 秒直接生成的费用大约为:
| 分辨率 | 近似输出成本 |
|---|---|
| 768p | 0.80 美元 |
| 2K | 1.30 美元 |
参考输入的计费遵循单独的规则:
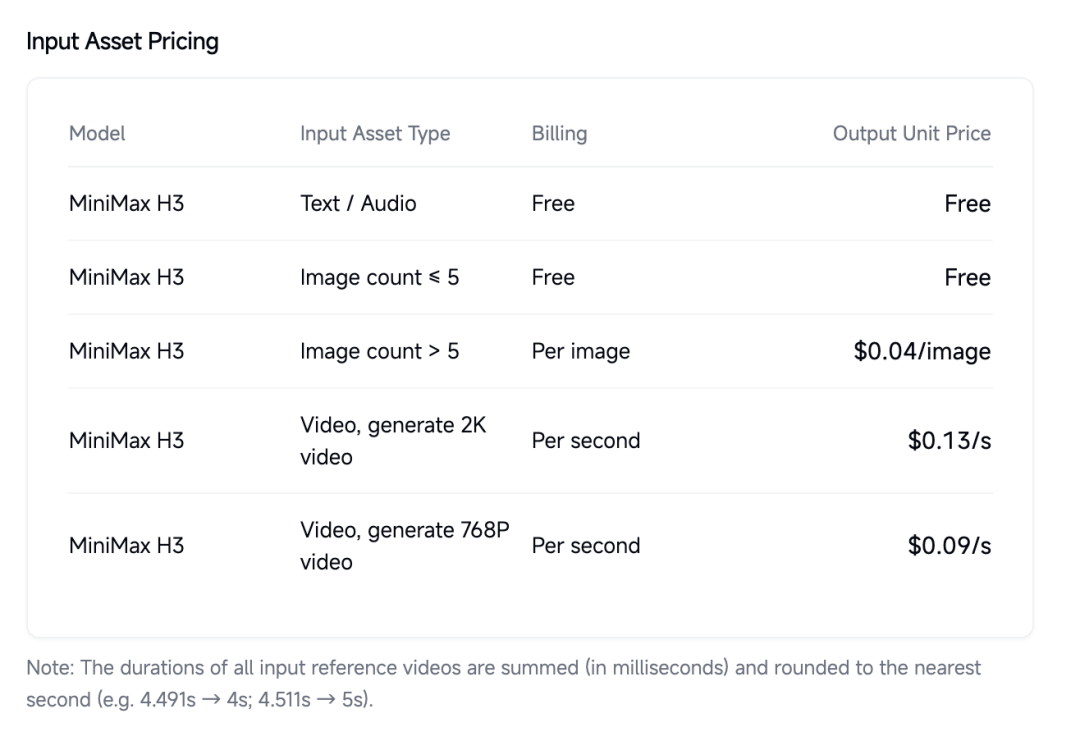
来源文章截取了 H3 最初的输入素材和输出定价。
上述截图列出 768p 生成价格为每秒 0.09 美元。MiniMax 当前的全球定价页面现标为每秒 0.08 美元,因此应以实时官方文档作为当前信息来源。
MiniMax 声称,在 2K 分辨率下,H3 的成本不到主流竞品的三分之一;在 768p 分辨率下,成本不到主流 720p 模型的一半。
该比较基于 MiniMax 选择的竞品和设置。每段有效视频的实际成本取决于重试次数、参考素材、片段长度、重新生成,以及首次输出是否可直接使用。
Artificial Analysis 目前将 MiniMax H3 列于其带音频的视频编辑排行榜首位。
在本文档编写时,排名显示如下:
| 排名 | 模型 | Elo | API 价格 |
|---|---|---|---|
| 1 | MiniMax H3 | 1,129 | 7.80 美元/分钟 |
| 2 | Gemini Omni Flash | 1,122 | 6. |
00/分钟 |
| 3 | HappyHorse-1.0 | 1,096 | $27.04/分钟 |
| 4 | Wan 2.7 | 1,080 | $16.90/分钟 |
| 5 | Dreamina Seedance 2.0 720p | 1,037 | $5.57/分钟 |
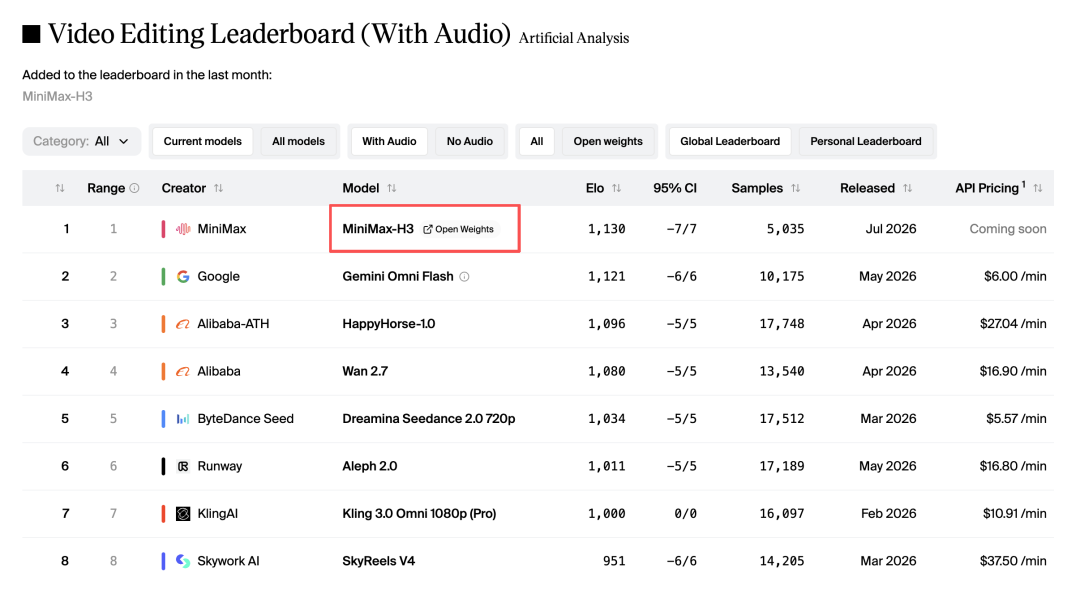
来源文章将H3置于Artificial Analysis视频编辑排行榜榜首。
H3在文生视频和图生视频测试中也名列前茅。
排行榜结果会随着新模型和投票的加入而发生变化。它们衡量的是特定提示集上的群体偏好,不应被视为某一模型适合所有制作流程的证明。
这一结果仍然值得关注,因为H3将强劲的编辑评分与已发布的基础权重相结合,而许多领先的视频模型仍然保持封闭。
H3并不将文本、图像、视频和音频视为互不相关的输入模态。
它将它们作为一个统一的多模态上下文来接受,并试图理解这些素材与所请求输出之间的关系。
例如,一个提示可以要求H3:
官方API目前支持:
| 参考类型 | 限制 |
|---|---|
| 图片 | 最多9张 |
| 视频片段 | 最多3个 |
| 音频片段 | 最多3个 |
| 混合文件总数 | 最多12个 |
参考视频和音频片段长度必须在2到15秒之间,每种媒体类型的最大总时长为15秒。
提示词限制为7,000个字符。
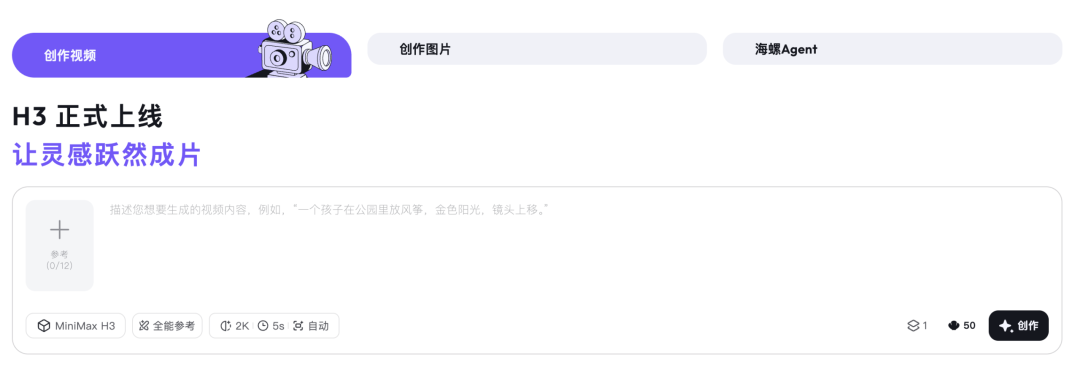
海螺界面将提示、多模态参考、分辨率、时长和宽高比整合在一起。
这种设计使参考素材比编写超长提示词更加重要。
一段文字可以描述所需的光线效果,但一张参考图像可以更直接地传达相同的视觉效果。文字描述可以解释一个动作,但参考视频可以展示精确的时机。
该模型的价值在于解读这些参考应如何重新组合,而非仅仅复制它们。
来源文章强调了一个虽小但实用的产品功能:上传的素材会出现在近期使用面板中。
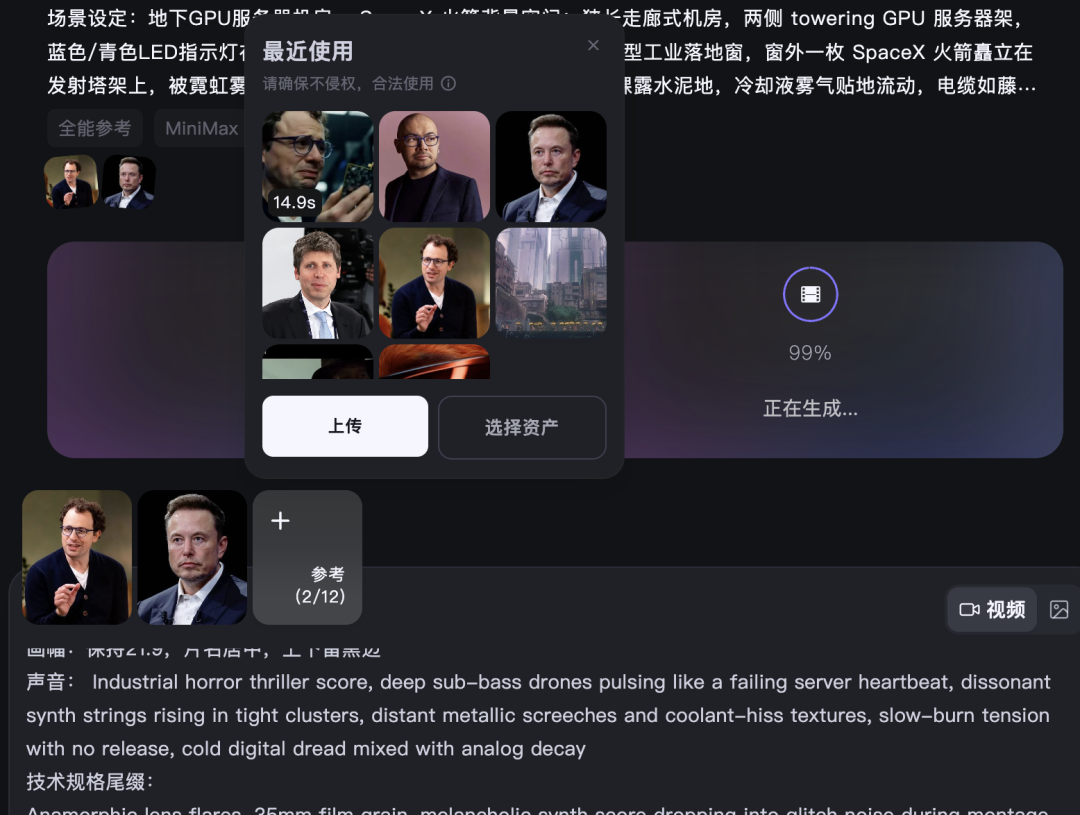
先前上传的图片和参考素材可以从近期素材面板中重复使用。
这很实用
对于那些反复使用相同角色、产品、标志、品牌色调、声音、视觉风格、地点或动态参考的工作流程。
它减少了每次生成时上传和整理相同文件的需求。
MiniMax将H3描述为一个围绕任务泛化构建的系统,而非独立专家模型的集合。
早期的生成系统通常将创意工作分割为孤立的任务,如文本转视频、图像转视频、首尾帧生成、角色参考、风格参考、动态迁移、声音参考、视频编辑、音效生成和音乐生成。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
H3经过训练,能够在单一多模态系统中通过自然语言表达这些关系。
完整的在线H3工作流程包含三个主要模块:
多模态输入
      ↓
H3-Context-IR
      ↓
H3-Base(768p)
      ↓
H3-Regenerate-2K
      ↓
最终视频(含立体声音频)
H3-Context-IR是一个托管的预处理和编排系统。
它分析文本、图像、视频和音频之间的关系,然后生成H3-Base可以使用的结构化中间表示。
该系统可以执行指令解析、跨模态关联、时间分析、场景分解、音视频关系建模、缺失细节的提示补全以及复杂逻辑推理。
MiniMax的技术博客指出,部分源材料在被提炼为约4,000个token的平均上下文表示之前,需要约100,000个token的推理计算。
H3-Context-IR不包含在初始开源权重版本中,因为它依赖多个托管模型和服务。MiniMax通过API提供该功能,并为希望构建自己的预处理系统的团队发布提示指南。
H3-Base以768p分辨率生成视频和立体声音频。
不同的输入模态通过相应的编码器或VAE进行编码,打包成统一的多模态序列,然后送入H3-Omni Transformer。
发布的模型提供两个任务专用检查点:
| 检查点 | 主要任务 |
|---|---|
| H3-Base-FL2VA | 文本转视频以及首尾帧转视频 |
| H3-Base-Ref2VA | 基于参考的音视频生成 |
两个检查点均使用BF16精度。
H3的2K工作流程不是传统的超分辨率放大工具。
768p结果和原始多模态上下文会被反馈回H3,使模型能够以更高分辨率重新生成输出。
MiniMax将其称为上下文内再生成。
传统的超分辨率系统试图从低分辨率视频中推断缺失细节。H3可以复用原始提示和参考信息,这可能有助于其更准确地恢复小文字、产品细节和场景信息。
H3-Regenerate-2K不包含在初始开源权重版本中。目前可通过MiniMax的托管工作流程和API使用。
MiniMax确定了系统背后的四项主要技术。
在传统的视频提示中,一段文字说明描述目标片段。
而在H3中,
字幕还必须说明每个参考与输出的关系、参考之间的相互关系、哪个动作应来自哪个视频、哪个声音属于哪个角色、音频在多个镜头之间如何变化,以及哪些内容应保留或编辑。
语言是连接这些多模态关系的桥梁。
MiniMax构建了专用模型和全模态理解流水线来生成这种表示。
H3使用独立的视觉和音频潜空间。
视觉VAE是一个时间因果视频自动编码器,具有16倍空间压缩、4倍时间压缩、24个潜通道,并在Transformer之前进行额外的分块处理。
MiniMax表示,新的VAE相比其早期方法在有效序列长度上提供了4倍的提升,降低了训练和推理成本,同时有助于支持原生2K生成。
音频VAE先独立处理左右立体声通道,然后再重新组合。它将32 kHz音频压缩为每通道40 Hz的潜令牌。
H3-Omni Transformer是一个密集的单流Transformer。
官方模型卡列出:
MiniMax表示AdaLN调制输出可以预计算并缓存,因此仅用于推理的部署无需加载这些参数。
该模型在训练期间分离理解和生成任务,以更好地处理多模态序列长度的大幅变化。MiniMax报告称,这将端到端训练吞吐量提升了近30%。
H3使用原生稀疏注意力进行训练,以降低长多模态序列的成本。
初始开源权重版本目前使用全注意力进行推理。MiniMax表示稀疏注意力实现将在未来更新中发布。
这一区别对本地部署很重要,因为当前可用的实现可能需要比MiniMax内部优化的服务栈更多的计算资源。
MiniMax在Hugging Face上以MiniMax H3社区许可协议发布了H3-Base权重。
该仓库包括H3-Base-FL2VA、H3-Base-Ref2VA、处理器文件、分词器文件、文本编码器、Omni Transformer权重、视觉和音频VAE、示例脚本、部署说明以及可复现的768p示例。
检查点使用Qwen3-VL-32B的完整预训练权重作为H3编码器,并将其第50层隐藏状态提供给H3-Omni Transformer。
模型可通过以下命令下载:
hf download MiniMaxAI/MiniMax-H3 --local-dir MiniMax-H3
MiniMax将SGLang、vLLM、Diffusers和ComfyUI列为支持或推荐的推理框架。
其SGLang示例使用四块GPU:
sglang serve \
  --model-path MiniMaxAI/MiniMax-H3 \
  --num-gpus 4 \
  --ulysses-degree 4 \
  --performance-mode speed \

--host 0.0.0.0 \
  --port 30010 \
  --model-variant fl2va
这是一个官方示例,并非通用最低要求。实际内存和性能取决于检查点、时长、分辨率、实现方式和硬件。
将 H3 简单称为“完全开源”可能会产生误导。
已发布的 H3-Base 权重相当可观,支持本地 768p 生成。然而:
团队在规划商业部署之前,应仔细审查许可和架构说明。
对于私有品牌资产而言,该发布仍然创造了有意义的选择。企业可以在许可条款范围内研究、微调并部署基础模型,而无需将每个源资产发送到第三方生成接口。
官方 API 支持三种主要生成模式:
生成工作流为异步模式:
task_id。开发者还可以使用官方 MiniMax CLI:
npm install -g mmx-cli
mmx auth login
mmx video generate \
  --model MiniMax-H3 \
  --prompt "A polished product commercial with animated typography"
对于多模态参考工作流:
mmx video generate \
  --model MiniMax-H3 \
  --prompt "Keep the same character and follow the reference motion" \
  --reference-image character.png \
  --reference-video motion.mp4
在生产环境中使用前,应查看 CLI 和 API 文档,因为输入限制、计费和受支持的参数可能会发生变化。
H3 并不会消除所有后期制作任务。
一个专业的营销项目可能仍然需要逐帧精确剪辑、客户审阅、授权音乐、法律和版权检查、精准的品牌合规性、长片连续性、多种宽高比导出、真人表演指导和色彩管理交付。
H3 改变的是起点。
创作者不再收到一段无声的素材,而是可以获得一个包含剪辑、声音、排版、配音、特效和可识别的视觉方向的短资产。
这使得该模型特别适用于:
该模型还表明,视频生成正变得越来越不局限于特定任务。一个单一系统可以日益解读一组创意资产,并执行更完整的创意简报。
MiniMax H3 是一个通用多模态视频生成和编辑系统。它接受文本、图像、视频和音频输入,可以生成 4 到 15 秒的视频,并带有同步立体声。
声音。
能。托管API支持2K输出。完整流程会先用H3-Base生成768p的结果,然后使用H3-Regenerate-2K在保留原始上下文的情况下以更高分辨率重新生成视频。
MiniMax已根据其社区许可发布了H3-Base权重。完整的在线系统并未完全开源,因为H3-Context-IR、H3-Regenerate-2K和稀疏注意力推理并未全部包含在初始版本中。
能,已发布的H3-Base检查点可以部署在本地进行768p生成。MiniMax提供了SGLang示例,并提供了vLLM、Diffusers和ComfyUI工作流的链接,但该模型需要大量GPU资源。
目前的全球标价为2K分辨率每秒生成0.13美元,768p分辨率每秒0.08美元。超过前五张的参考图片、参考视频、重新生成以及H3-Context-IR可能会产生额外费用。
会。H3联合生成视频和原生32kHz立体声音频,包括对白、音乐和音效。
API支持最多九张图片、三个视频和三段音频片段,最多12个混合文件。同时还存在时长和文件大小限制。
MiniMax将H3设计用于广告、品牌推广、电子商务、产品设计、UI和UX以及其他商业用途。团队仍应审查输出内容,验证所有输入素材的权利,并查看社区许可和平台条款。
定价:当前的H3代次、参考输入、重新生成及Context-IR定价。
MiniMax H3将AI视频从单一的片段生成推向更高层次,在一个系统内整合了视觉生成、剪辑逻辑、字幕排版、对白、音效、音乐以及多模态参考。
托管版本可生成4至15秒视频,自带原生立体声音频,输出分辨率最高可达2K。目前,该版本在Artificial Analysis视频编辑排行榜上位居首位,并通过MiniMax全球API以每生成一秒0.13美元的价格提供2K输出。
MiniMax现已发布H3-Base检查点,支持本地768p生成及后续开发。但由于Context-IR、2K重新生成以及稀疏注意力推理尚未全部开源,完整的托管工作流仍部分封闭。
H3的核心转变并非仅是生成更优质的画面,而是从生成一段片段,演进为理解并执行一份完整的短视频创作简报。
从一句话开始,几分钟内拿到完整网站。



