
MiniMax 于 10 月 19 日发布了 M3.1 Flash,时间上紧随 DeepSeek V4.1 Flash-1017 之后。本文通过编码和智能体任务的得分与成本图表对两者进行比较,显示价格相对较低的模型在部分评测中已经接近成本更高的系统。
其中“DeepSeek 第一、MiniMax 第二”的表述,针对的是特定的编码成本性能比较。它不应被理解为涵盖所有任务、模型版本或部署设置的综合排名。更有价值的问题是:哪种配置能够以可接受的总成本可靠地完成工作。
编码结果与企业智能体工作流
MiniMax 的发布材料报告称,M3.1 Flash 在 DeepSWE v1.1 上取得了 73.7% 的成绩。该评测涉及代码仓库理解、开发、修复和测试。来源表格在这项比较中列出的分数为:DeepSeek V4.1 Flash-1017 为 77.0,GPT-5.6 Sol 为 73.0,Opus 5 为 74.0。
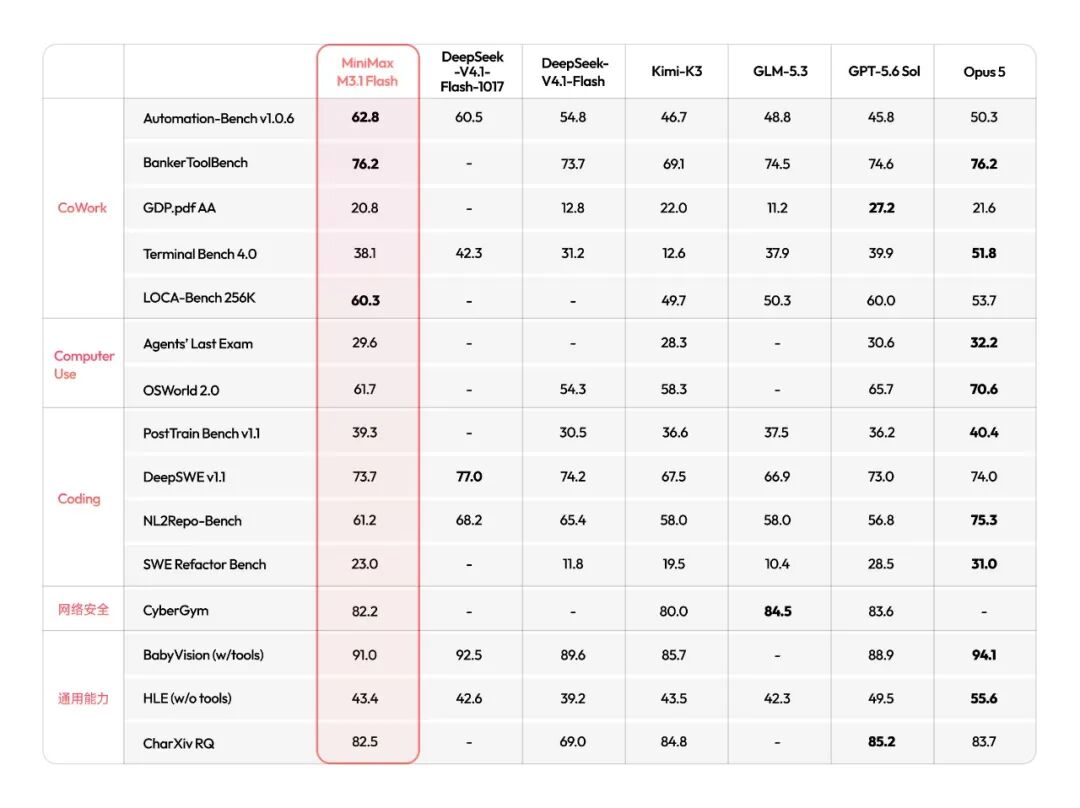
由 Xinzhiyuan 转引的公司对比;模型版本和评测条件非常重要。
成本图表显示,在其报告的得分下,M3.1 Flash 位于低成本一端,而 DeepSeek Flash-1017 在该图表比较中领先。不同推理力度对应不同的数据点,因此选择某一种配置可能同时改变成本和结果。
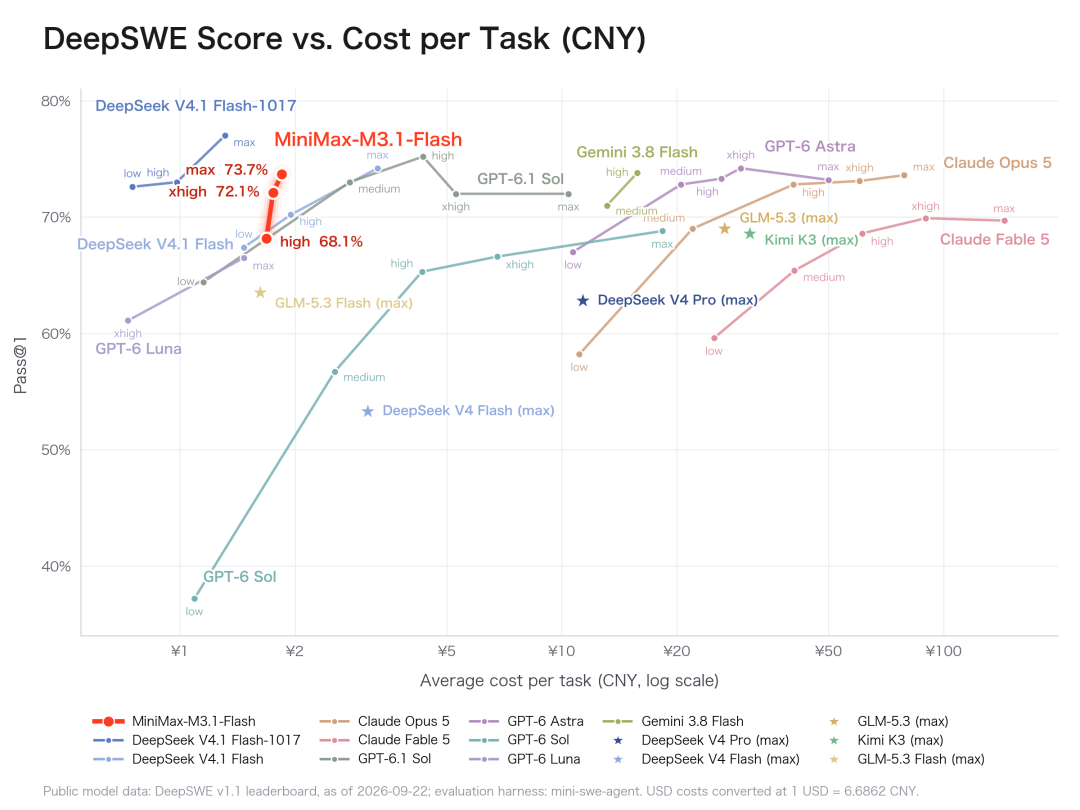
在这项评测中,平均成本低于 2 CNY,并不意味着每次缺陷修复都收取固定费用。Token 消耗、失败尝试次数、代码仓库规模和工具调用都会改变实际任务成本。
自动化与工具使用
在 Automation-Bench 上,所提供的图表报告了 最大推理力度下 62.8% 的成绩。图表将 M3.1 Flash 放在所展示的其他配置之上,其中也包括一个以部分得分换取更低成本的低推理力度 MiniMax 配置点。
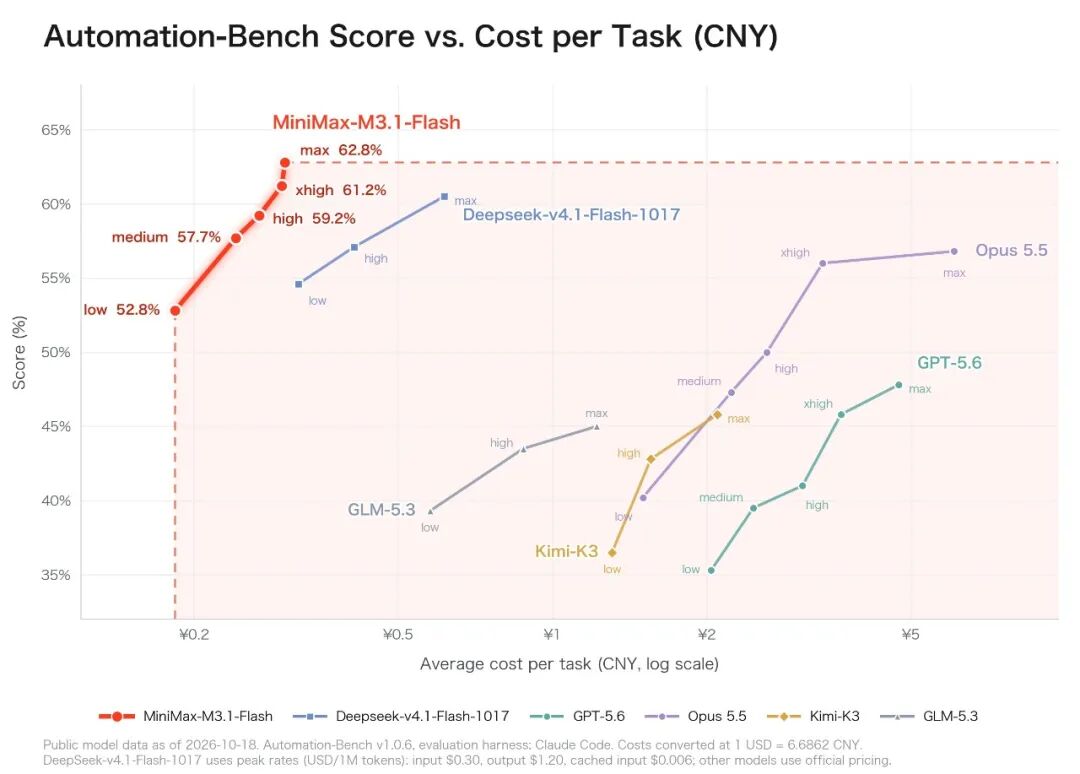
来源描述了涵盖 SaaS 工具和业务职能的企业工作流。基准测试只能近似其中一部分工作,并不能证明某个模型能够在每一个真实的销售、财务或客户支持流程中成功运行。
MiniMax 报告的其他分数包括:
| 评测 | 来源中的 M3.1 Flash 分数 | 对比边界 |
|---|---|---|
| LOCA-Bench 256K | 60.3。 | 略高于图中 GPT-5.6 Sol 的 60.0。 |
| BankerToolBench | 76.2。 | 与该表中的 Opus 5 分数持平。 |
| CyberGym | 82.2。 | 低于图中 GLM-5.3 和 GPT-5.6 Sol 的分数,但在该快照中仍具有竞争力。 |
| OSWorld 2.0 | 61.7。 | 高于图中 DeepSeek V4.1 Flash 的 54.3;并非所有列出模型中的最高分。 |
| Agents' Last Exam | 29.6。 | 低于 GPT-5.6 Sol 的 30.6 和 Opus 5 的 32.2。 |
这些是彼此独立的测试。如果没有明确的方法论,不能将这些数字进行平均,并据此得出具有普遍意义的成功率。
计算机使用与 739 CNY 的 ALE 估算
MiniMax 的官方公告确认了 OSWorld V2 为 61.7、Agents' Last Exam 为 29.6 的报告分数。其关于在这些测试中领先中国模型的说法,受到发布时所采用的比较范围和测试条件限制。
来源中的 ALE 图表估算,完成全部 152 项任务需要 739 CNY,通过率为 29.6%。这并不意味着每项任务都通过,也不意味着该成本是按每个成功任务计算的。
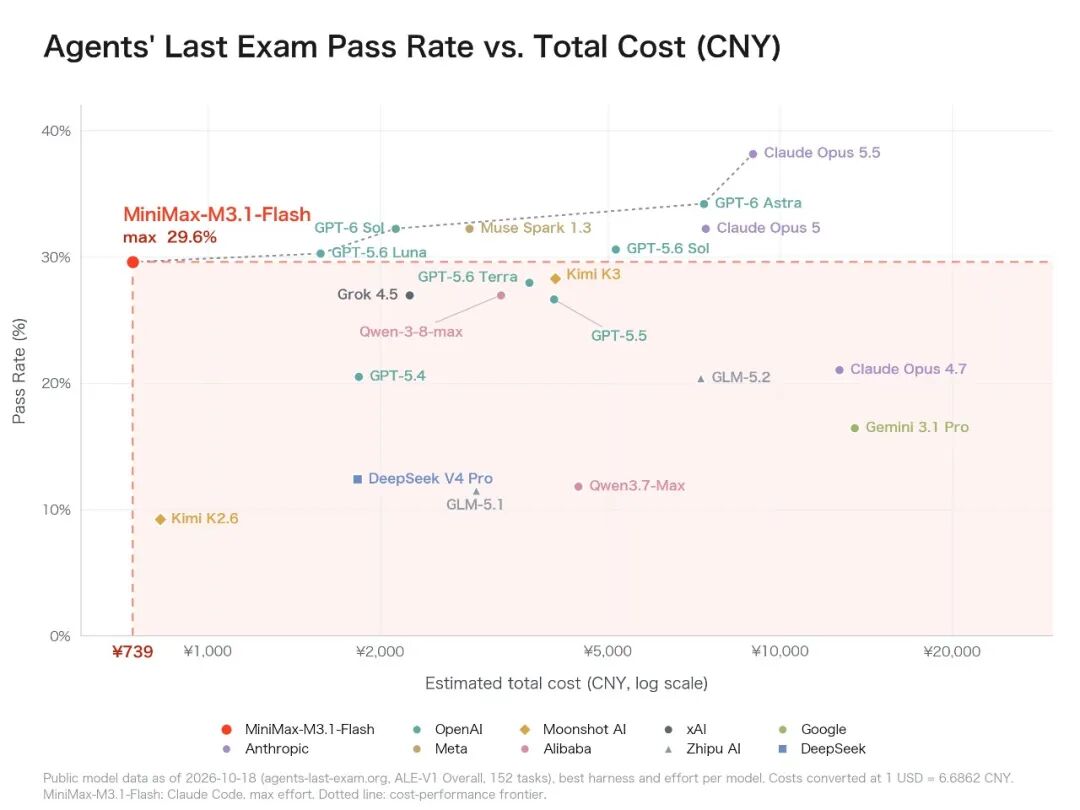
将 739 CNY 除以 152,可得每次尝试任务约为 4.86 CNY。这一算术结果解释了图表的尺度,但不包括组织自身的集成、基础设施或人工审核成本。
虚线前沿连接了在图示成本下具有较优结果的部分配置。其形状取决于所纳入的模型、评测日期和成本假设。前沿上的某个点可以作为有用的比较证据,但不能证明同一配置对所有工作负载来说都是最便宜的。
Token 定价与缓存计算
MiniMax 的官方英文公告列出了每百万 Token 的统一价格:输入 0.15 美元、输出 0.60 美元、缓存输入 0.015 美元。所提供的中文文章则给出了人民币费率:输入 1 CNY、输出 4 CNY、缓存读取 0.10 CNY。
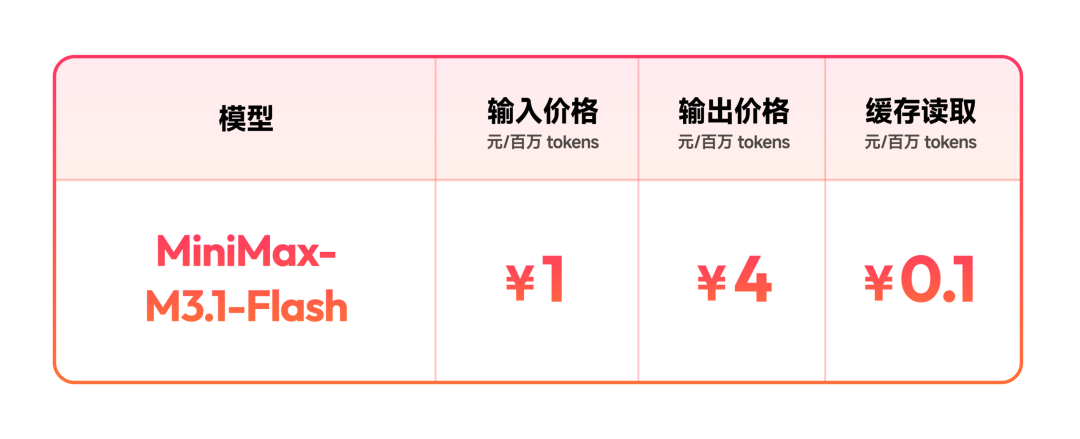
这两套货币价格不应被视为精确的实时汇率换算结果。预算规划时,应使用实际计费平台和账户适用的费率。
来源将 MiniMax 的人民币费率与所报告的 DeepSeek 高峰期和非高峰期价格进行了比较。其基于 10 亿输入 Token 的示例可以在所述假设下进行核算:
| 缓存命中率 | MiniMax 输入成本 | 来源中的 DeepSeek 高峰期输入成本 | 本示例中的较低金额 |
|---|---|---|---|
| 90% | 190 CNY。 | 236 CNY。 | MiniMax 低 46 CNY。 |
| 95% | 145 CNY。 | 138 CNY。 | DeepSeek 低 7 CNY。 |
| 99% | 109 CNY。 | 59.60 CNY。 | DeepSeek 低 49.40 CNY。 |
对于 MiniMax 在 90% 缓存命中率下的情况,10 亿个输入 Token 等于 1,000 个百万 Token 单位:100 × 1 + 900 × 0.10 = 190。这些仅输入成本的示例不包含输出 Token,也不包含所引用费率未体现的任何其他费用。
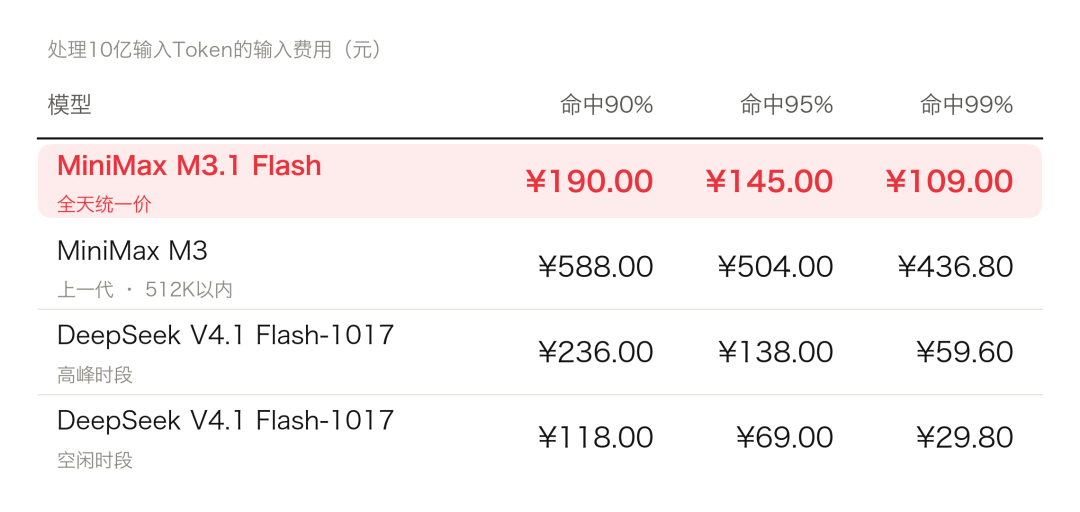
这也说明,当缓存成本占主导地位时,较低的未缓存输入价格并不能保证最终账单最低。文章将基准测试中的平均成本外推到 1,000 个业务任务,只是预算示例,并不是生产环境运行这些任务的报价。
MiniMax 另外声称,与其上一代产品相比,整体智能体任务使用成本降低了 70%。这一工作负载层面的说法,不同于简单的单 Token 价格下降。
推理速度、Space Bunny 与 API 设置
几分钟搭建展示站并增长获客
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
公司将匿名测试的 Space Bunny 认定为 M3.1 Flash 的早期版本,并表示其处理的 Token 数量超过 200 万亿。公司报告称,输出速度最高达到每秒 200 个以上 Token,中位速度超过每秒 170 个 Token,同时在线推理速度接近提升三倍。
这些数据来自公司测量。每秒 Token 数量衡量的是输出吞吐量,而完成一项智能体任务所需的时间还包括推理、工具调用、等待、重试和测试等环节。
MiniMax 的模型调用指南确认支持 1,000,000 Token 上下文窗口以及文本、图像和视频输入。支持这些输入并不意味着模型能够生成图像或视频。
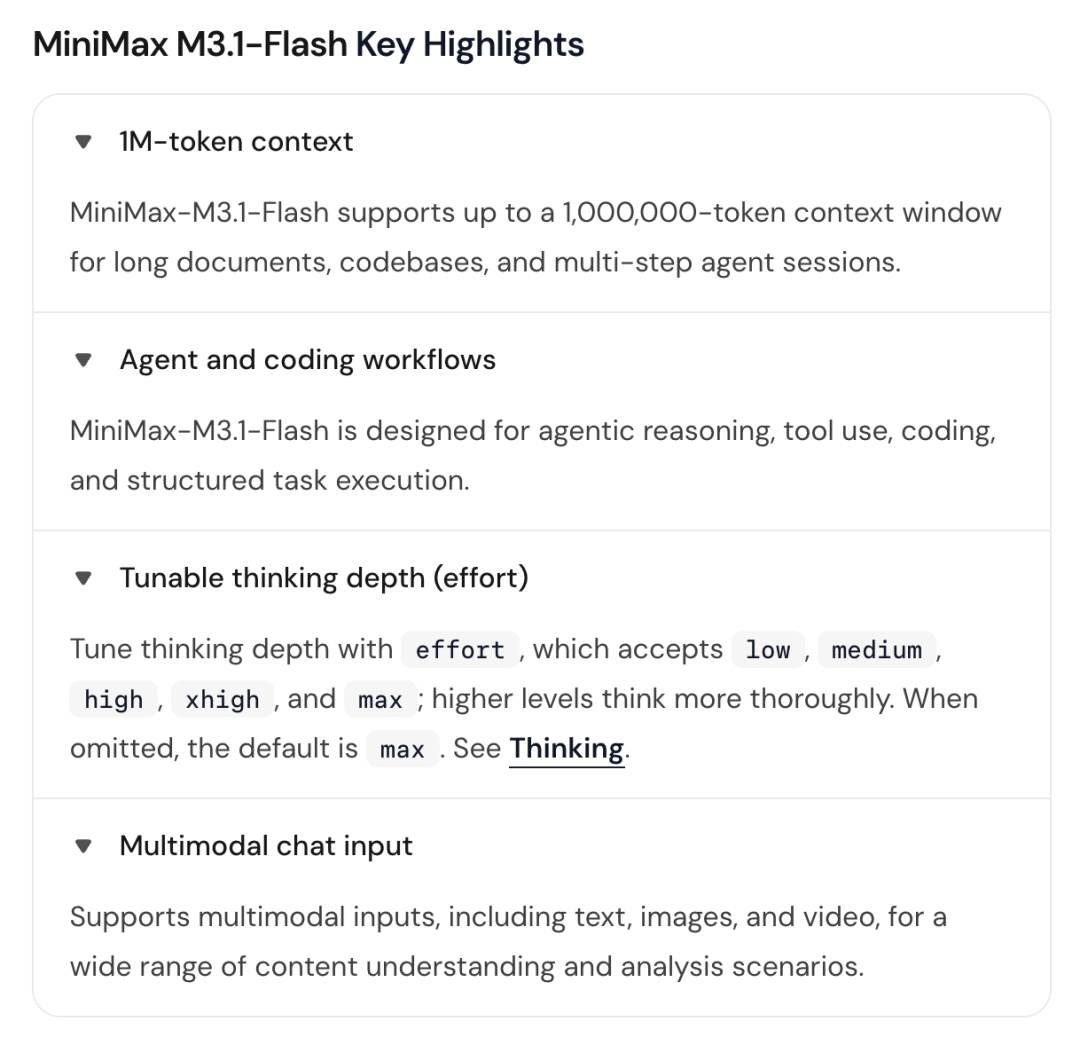
该指南确认了五种思考级别:low、medium、high、xhigh 和 max。省略该设置时,默认值为 max;思考功能无法禁用。 请求字段取决于所使用的协议:
| 协议 | 思考深度字段 |
|---|---|
| Anthropic-compatible | output_config.effort。 |
| OpenAI-compatible Chat Completions | reasoning_effort。 |
| OpenAI Responses | reasoning.effort。 |
这些字段名称不应被合并为一个顶层的 effort 参数。官方指南表示,较高的级别通常会生成更多思考 Token 并增加延迟;降低推理力度会减少这部分工作,但不会将其完全关闭。
发布时的访问方式包括 MiniMax API、M Plan 和 MiniMax Code。公告称模型权重将在之后发布,因此本文不表示自托管版本或其最终许可证在发布时已经可用。
来源中的折叠城市与宝塔示例
Xinzhiyuan 描述了将模型连接到 Codex,并要求其创建一个交互式折叠城市。其记录包括折叠滑块、夜间照明,以及可以旋转视角来检查场景的功能。
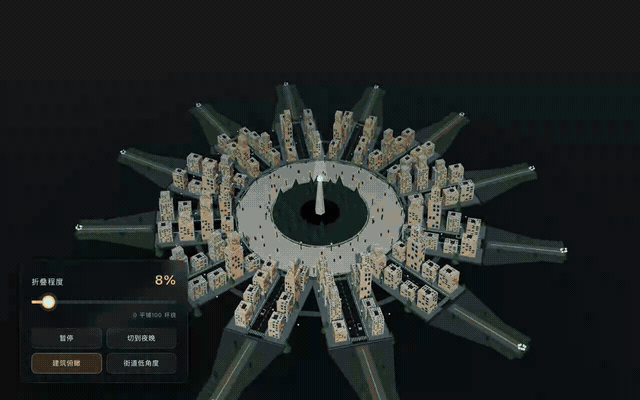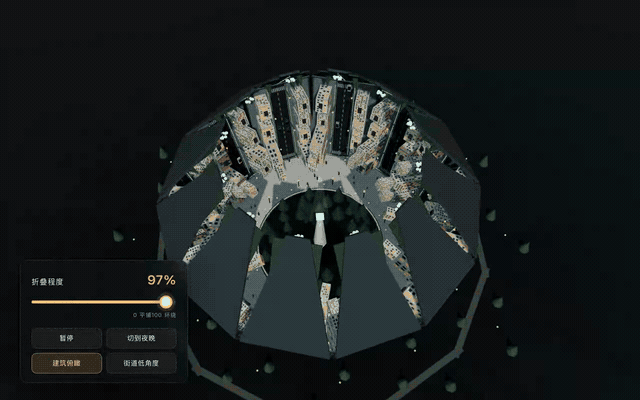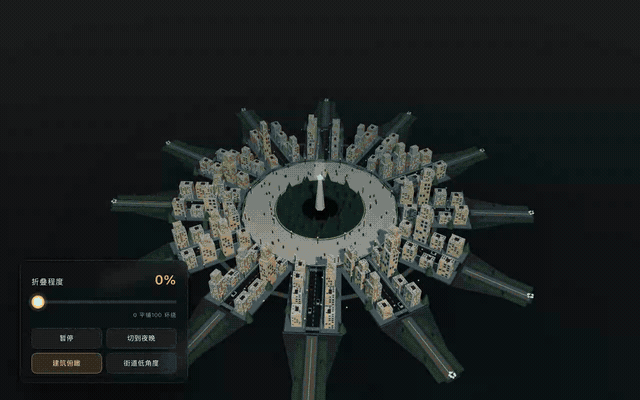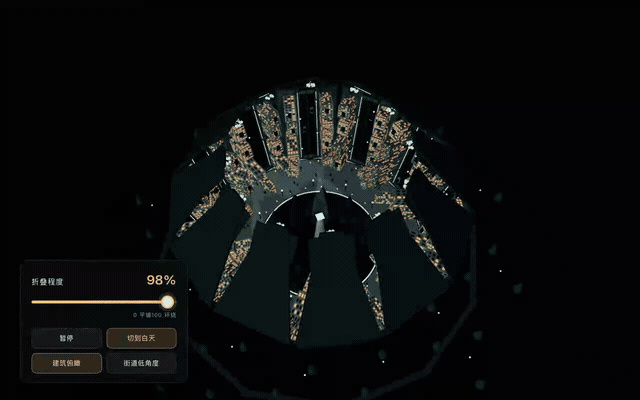
这是发布方的演示,并不是本文档新进行的测试。该图像展示了一个特定输出,但不能据此证明帧率、代码质量或跨浏览器表现。
文章还转引了开发者 AJ 的宝塔示例。据称,该示例通过一次 API 调用生成,使用最大思考级别,约消耗 50,000 个 Token。关于视觉效果更强的说法属于该开发者的判断,并不是与 DeepSeek 进行标准化比较的结果。
将 Flash 模型匹配到具体工作
来源的比较显示出不同的优势:DeepSeek 在图示软件工程图表中的位置,以及 MiniMax 在企业工作流结果中的强势表现。这些差异支持企业在具有代表性的工作上分别测试两者,而不是依赖单一的标题式排名。
应在人工审核后跟踪任务成功率、耗时、重试次数和总支出。当模型能够在不增加大量返工的情况下完成所需任务时,较低的 Token 费率才最有价值;否则,返工成本可能抵消节省的费用。
MiniMax 还表示,Pro 版本将在之后推出。该未来产品应与 M3.1 Flash 已记录的发布时行为分开看待。
常见问题
MiniMax M3.1 Flash 是整体表现第二好吗?
来源中的排名针对的是特定的编码得分与成本比较。文章中的其他评测显示了不同的排名和并列结果。
官方美元 Token 价格是多少?
MiniMax 的公告列出,每百万 Token 的输入价格为 0.15 美元,输出价格为 0.60 美元,缓存输入价格为 0.015 美元。在使用不同货币费率进行预算前,应确认适用的计费平台。
739 CNY 的 ALE 数字是否意味着所有任务都通过了?
不是。它是完成 152 个尝试任务的预计总成本。报告的通过率为 29.6%,该金额不包括图表假设之外的成本。
指南支持哪些输入和多长的上下文?
官方指南列出了文本、图像和视频输入,并支持最多一百万 Token 的上下文。理解输入并不意味着支持图像或视频生成。
如果省略思考设置,会发生什么?
文档说明默认值为 max。如需选择较低级别,应使用正确的协议专用字段;思考功能无法关闭。
模型权重在发布时已经可用了吗?
发布公告称模型权重将在之后发布。托管 API 访问权限与承诺发布模型权重,是两项不同的可用性说明。
相关工具
- MiniMax API 平台:提供 MiniMax 模型和开发者服务的托管访问。
- MiniMax Code:发布公告中提供的桌面端编程应用。
- M Plan:公告中提到的 MiniMax 访问订阅方案。
- DeepSeek Flash-1017 仓库:对比模型发布的代码仓库。
相关链接
- BAAI Hub 上的所提供文章:CNY 成本比较和图示示例的来源。
- MiniMax 的 M3.1 Flash 公告:官方发布定价、访问方式和公司基准测试声明。
- MiniMax 模型调用指南:已确认的上下文、输入格式和协议专用思考控制设置。
- MiniMax API 平台:官方开发者入口。
- MiniMax Code 下载页面:官方公告链接的桌面产品页面。
- DeepSeek V4.1 Flash-1017:与本文比较相关的模型仓库。
总结
M3.1 Flash 将低廉的 Token 定价与公司报告的、具有竞争力的编码、自动化和计算机使用结果结合起来。它的价值取决于推理力度设置、缓存行为,以及模型能否以可接受的返工成本完成实际工作流。
使用基准测试图表确定需要测试的对象,然后让成功结果、耗时和完整账单来决定模型。


