For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
Meta 发布 Muse Wonder 后出现了两类截然不同的证据:一类是强劲的基准测试结果,另一类则是有时说服力明显不足的开发者演示。新智元的一篇中文报道经 BAAI Hub 转载,将这种差距转化为对以基准测试为中心的优化方式的有力批评。
Meta 发布 Muse Wonder 后出现了两类截然不同的证据:一类是强劲的基准测试结果,另一类则是有时说服力明显不足的开发者演示。新智元的一篇中文报道经 BAAI Hub 转载,将这种差距转化为对以基准测试为中心的优化方式的有力批评。
这种分歧值得认真审视,但一次糟糕的演示并不能证明存在作弊行为。公正的解读需要明确具体模型版本、所测试的任务、模型周围运行的智能体软件,以及每项结果的来源。
来源文章描述了开发者对浏览器或 3D 游戏输出进行比较,并发现 Wonder 相较竞品模型表现令人失望。这类演示很容易检查:观众可以直接看到移动是否正常、摄像机行为是否合理,以及场景是否接近请求的结果。
该来源还引用 Meta 的 Alexandr Wang 的说法,称团队并未专门针对 3D 演示游戏进行训练,并鼓励开发者尝试真实的编程工作。这一回应由新智元报道;不应将其当作对每一项失败编程任务的笼统解释。
游戏演示仍然是相关证据。它们测试了代码生成、视觉判断、交互和调试的真实组合。其局限性在于范围:一个提示词和一次运行,无法证明模型在代码仓库维护、终端工作或长期软件项目中的整体表现。
Meta 的官方公告介绍了 Muse Wonder 和 Muse Wonder Full,它们是面向个人与专业智能体的模型。Wonder 通过 Meta Model API 和 Muse Code 提供;Full 则面向 Muse Code 订阅用户提供。
该公告将 Active Memory 定义为在跨对话中保留重要上下文,并在相关时检索这些上下文。Active Focus 则指向朝某一目标持续推进的能力,包括尝试替代方案、适应新信息、请求澄清,以及在重要操作前进行检查。
这些描述有助于解释 Meta 试图改进的方向。它们是产品和评估层面的主张,而非智能体一定能够完成每项分配任务的保证。
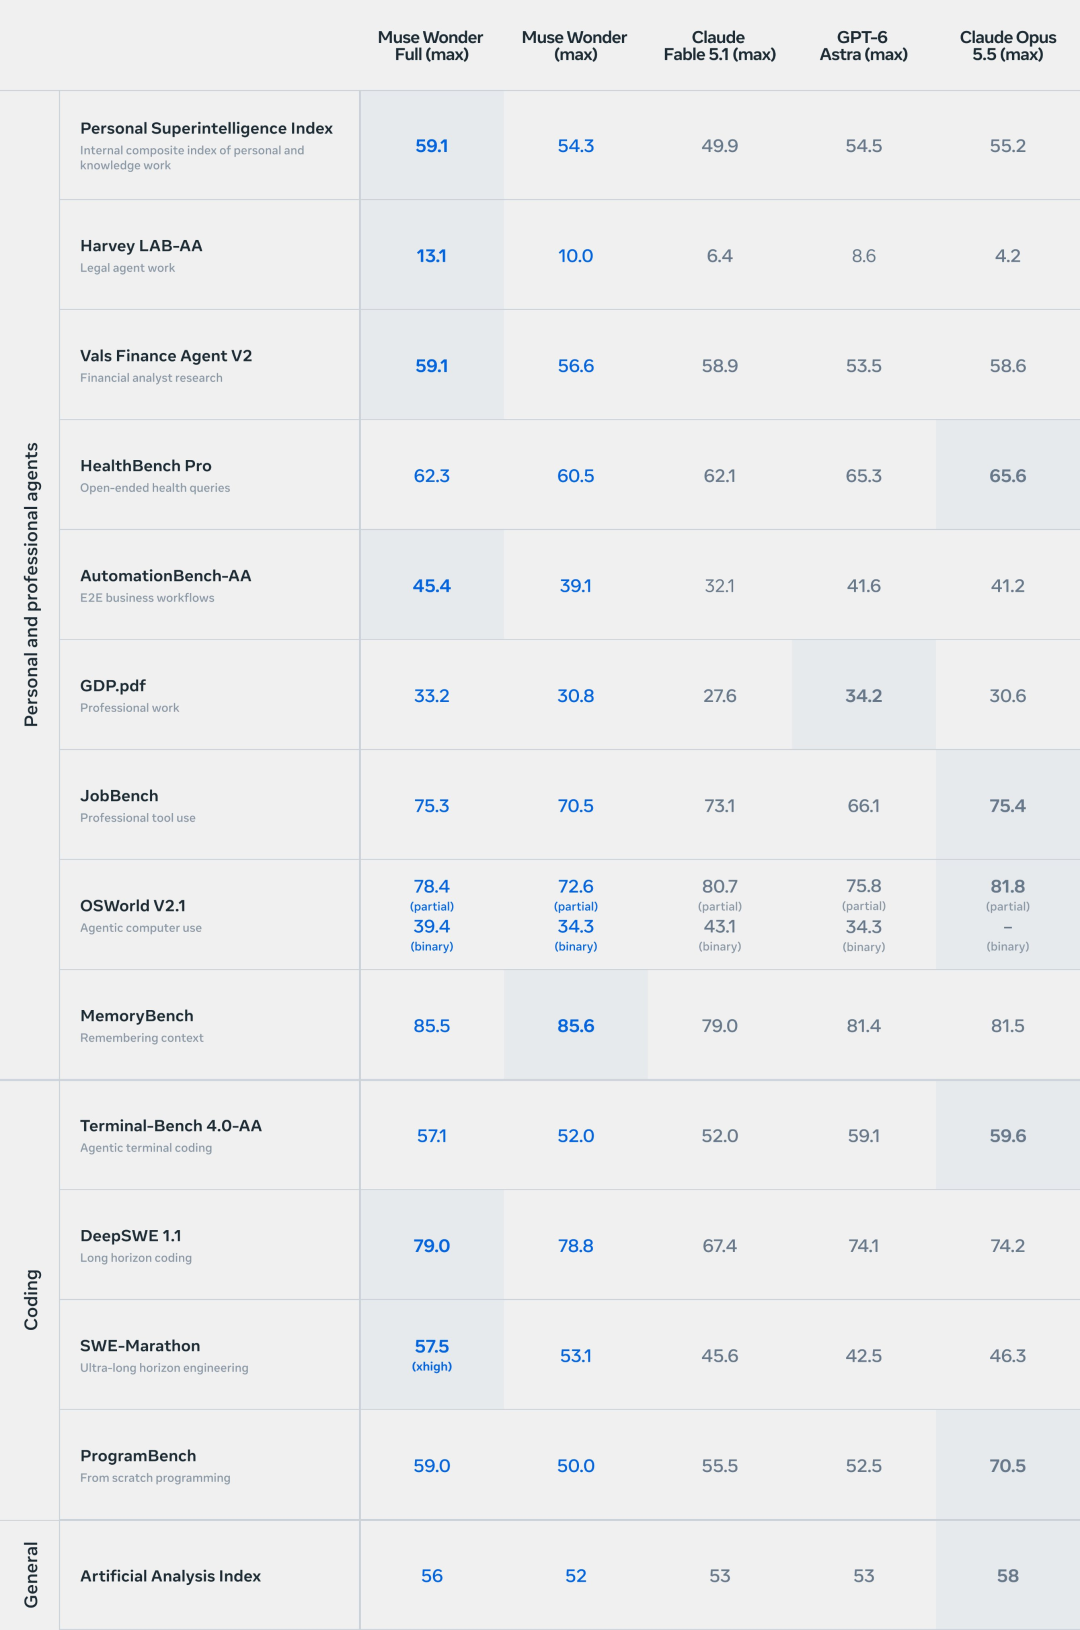
Meta 发布的对比表格,由新智元在 BAAI Hub 上转载。数值适用于发布材料中展示的配置和评估条件。
该表并未显示一个全能的赢家。其编程结果会因任务而明显变化:
| 评估项目 | Muse Wonder Full | Claude Opus 5.5 | 对比方向 |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Full 得分更高 |
| SWE-Marathon | 57.5 | 46.3 | 在报告的设置下,Full 得分更高 |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opus 得分更高 |
| ProgramBench | 59.0 | 70.5 | Opus 得分更高 |
Meta 的配套材料还报告了其在记忆和智能体工作流方面的优势,同时也指出其他模型领先的领域。长期软件工作中的强劲成绩,并不意味着它在从零生成应用程序方面也拥有最强表现。
对于 SWE-Marathon 而言,评估条件尤其重要。Meta 的模型卡显示,竞品通过 Codex 和 Claude Code 运行,而 Wonder Full 的突出结果使用了 xhigh 配置。这些是有意义的产品级结果,但它们并不是让所有模型在完全相同的智能体框架中进行的单一受控实验。
Meta 的发布博客明确讨论了熟悉基准测试与陌生任务之间的差距。其分析比较了随着测试时计算量增加,模型在分布内和分布外任务上的表现,并认为 Wonder Full 更强的基础模型改善了后训练收益向其他任务的迁移能力。
这为 Meta 的立场提供了相关的技术证据。但它仍是模型开发者选择并呈现的评估,无法解决关于开发者输出的每一项质疑。
同样,关于游戏演示令人失望的报告,也不能证明基准测试污染或结果造假。要证实这些主张,需要比来源文章提供的内容更直接的数据、方法或结果操纵证据。
Artificial Analysis 的独立报道显示,在最大推理强度下,Wonder Full 的 Intelligence Index v4.3 得分为 56,Wonder 的得分为 52。因此,测试常规 Wonder 的 API 用户,评估的是与多张图表中重点展示的 Full 模型不同的发布版本。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
Artificial Analysis 列出每个版本均具有一百万 token 的上下文窗口。对于 Wonder,该平台报告的价格为:每百万输入 token 4 美元、缓存输入 0.20 美元、输出 20 美元。其估算的每项 Intelligence Index 任务 4.52 美元,是评估特定的成本,而非任何用户请求的固定价格。
来源还批评没有公开发布开放权重。所核查的发布公告和访问说明均未提供可下载的 Wonder 权重,因此开发者不应假设可以进行本地自托管。
Meta 表示,Wonder 在其吉瓦级 Prometheus 数据中心完成训练。BAAI 的文章将此次发布与 Mark Zuckerberg 和 Wang 关于 AI 基础设施投资规模,以及个人智能体在商业中作用的言论联系起来。
这些言论描述的是更广泛的战略。不应将其转换为针对该特定模型的、已验证的训练成本数字。同样,智能体协商或购买服务的示例是一种产品行为愿景,而不是每一种此类工作流均已部署的证据。
下一步更有价值的是可重复测试:保持需求不变,明确版本和推理设置,记录运行环境,并衡量已完成的工作。与单一醒目的分数或单次突出的失败相比,这种方式能够更可靠地揭示优势和弱点。
不能。它们可以显示模型在所演示任务上的表现不佳,但要证明基准测试作弊,需要关于评估方法、数据或结果操纵的独立证据。
它们是该模型家族中不同的产品版本,具有不同的发布访问路径。Artificial Analysis 报告称,在其 Intelligence Index v4.3 的最大推理强度下,Wonder 得分为 52,Full 得分为 56。
引用的表格针对不同编程评估给出了不同答案。Full 在 DeepSWE 1.1 和所报告的 SWE-Marathon 设置中领先,而 Opus 在 Terminal-Bench 4.0-AA 和 ProgramBench 中领先。
只能在说明测试设置的前提下进行比较。Meta 的模型卡显示,竞品使用各自的编程产品运行,因此除底层模型外,智能体行为和工具差异也会影响结果。
Artificial Analysis 的发布报道显示,其价格为每百万输入 token 4 美元、每百万缓存输入 token 0.20 美元,以及每百万输出 token 20 美元。在投入生产使用前,请核实服务提供商当前的计费条款。
从已核查的发布材料中,尚未确认有公开的权重下载。已记录的访问路径是:Wonder 通过 API 和 Muse Code 访问,Full 则通过 Muse Code 订阅访问。
Muse Wonder 的发布结果显示,这是一个在智能体和软件工程方面取得强劲分数、但在不同编程类别上结果不均衡,并且常规版与 Full 版本具有不同访问路径的模型家族。
有用的结论应当针对具体任务:在接受“全面胜利”的主张或作弊指控之前,先核实确切模型,并测试实际完成的工作。
从一句话开始,几分钟内拿到完整网站。