For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/muse-wonder-full-vs-gemini-4-argon-benchm-70ca5d3f.md.
Meta 推出 Muse Wonder,使两个名称相近的模型进入竞争领域。这让第一个问题变得格外实际:你关注的是 Muse Wonder,还是 Muse Wonder Full?
Meta 推出 Muse Wonder,使两个名称相近的模型进入竞争领域。这让第一个问题变得格外实际:你关注的是 Muse Wonder,还是 Muse Wonder Full?
Artificial Analysis 报告称,在最大推理强度下,Intelligence Index v4.3 对 Wonder 的评分为 52,对 Wonder Full 的评分为 56。BAAI Hub 上转载的中文文章重点关注 Full 超过 Gemini 4 Argon 报告的 53 分结果。这是特定模型配置之间的基准对比,并不能证明任一 Wonder 变体在所有实际任务中都能获胜。
Meta 的官方公告称,Muse Wonder 可通过 Meta Model API 和 Muse Code 使用。Muse Wonder Full 面向 Muse Code 订阅用户开放。该公司表示,Wonder 后续将为其 Muse 助手中的体验提供支持,并首先向订阅用户推出。
| 模型 | Intelligence Index v4.3,最大推理强度 | Meta 描述的发布访问方式 |
|---|---|---|
| Muse Wonder | 52 | Meta Model API 和 Muse Code |
| Muse Wonder Full | 56 | Muse Code 订阅 |
这些差异在尝试复现已发布结果时非常重要。通过 API 访问 Wonder,与通过编码产品评估 Full 并不是一回事。
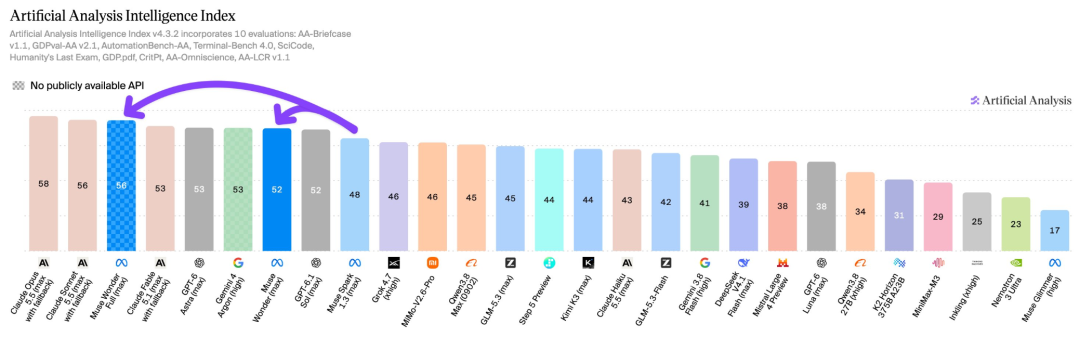
图表:Artificial Analysis,由 BAAI Hub 上的 QbitAI 报道复现并标注。它反映了来源发布时的比较结果。
Artificial Analysis 还报告称,两个变体均支持一百万 token 的上下文窗口。其发布分析列出的 Wonder API 价格为:每百万输入 token 4 美元、每百万缓存输入 token 0.20 美元,以及每百万输出 token 20 美元。由于 Full 的发布访问方式为订阅产品,因此该分析未按 token 为其定价。
BAAI 文章强调了 Gemini 4 Argon 在报道时访问权限更加受限。可用性可能快速变化,因此这一历史对比不应被解读为对任何一家提供商当前访问规则的承诺。
Meta 将 Wonder 定位为面向个人和专业智能体的模型家族。其公告为两项不同的能力赋予了明确名称。
Active Memory 关注跨对话保留重要信息,并检索与新任务相关的细节。对于个人助手而言,这可能意味着无需用户每次重复,便可使用已建立的偏好。
Active Focus 关注在首次尝试失败时继续朝目标推进。Meta 描述了尝试替代方案、适应新信息、在需要时寻求澄清,以及在重要操作前进行检查等行为。
编程同时需要这两类行为。智能体可能需要在经历多轮编辑、测试失败和修订的过程中保留原始约束。Meta 表示,Wonder 模型在需要长时间工作的多样化任务上接受训练,并建立在用于 Muse Spark 的扩展方法之上。
来源将强劲的软件工程基准表现与 3D 游戏演示中的褒贬不一反应进行了对比。即使两者都要求模型编写代码,它们也是不同的工作负载。
DeepSWE 1.1 测试的是现有软件上的工作,而 ProgramBench 涉及从零构建程序。Meta 发布材料中的对比表显示,在 ProgramBench 上,Wonder Full 得分为 59.0,而 Claude Opus 5.5 得分为 70.5。因此,一个模型可能在一种工程任务中领先,却在另一种任务中落后。
原始报道还提到,有开发者在 Unity 演示中更偏好 Opus,另一位开发者则报告了一次成功的 Wonder Full 运行。这些都是个体观察,使用的提示词、环境和成功标准各不相同。它们之间的分歧,是应当检查任务设置的理由,而不是将这些轶事平均为通用排名的理由。
对于长时间运行的软件测试,还有一个限定条件很重要:Meta 的模型卡说明,其 SWE-Marathon 对比使用了竞争供应商的编码智能体,其中包括 Codex 和 Claude Code。这使该结果与端到端产品比较相关,但它并不是让每个模型都使用同一智能体框架的受控比较。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这为标题中的基准提供了实际对应物。一个产出不那么令人印象深刻的游戏演示的模型,仍可能适用于维护任务;而较高的指数分数也不能成为输出出错的借口。
它是 Meta 的 Muse Wonder 模型家族中的完整变体。Meta 的发布公告使其面向 Muse Code 订阅用户开放,而常规 Wonder 变体还提供 API 访问。
来源在发布时的 Intelligence Index 对比中,将 Wonder Full 列为 56 分,将 Gemini 4 Argon 列为 53 分。这描述的是所展示的特定指数和配置,并不是所有任务或评估中的结果。
Meta 的公告区分了两种访问路径。它将 Wonder 列为可通过 API 和 Muse Code 使用,而 Full 面向 Muse Code 订阅用户开放。
Artificial Analysis 的发布报道列出:每百万输入 token 4 美元、每百万缓存输入 token 0.20 美元,以及每百万输出 token 20 美元。这些是发布时报告的价格,因此在部署前应查看提供商的计费条款。
Active Memory 关注从较早的对话中检索有用信息。Active Focus 关注持续执行,包括在任务遇到障碍时尝试另一种方法。
它们表明该模型在那些特定任务和设置中存在弱点。更广泛的编码表现还包括代码仓库维护、调试、工具使用,以及在更长的工作流程中满足需求。
Wonder Full 强劲的发布评分使其成为高要求智能体工作中值得关注的选项。常规 Wonder 模型具有不同的评分和访问路径,因此任何性能主张都必须附带具体的变体名称。
使用基准排名选择试用候选模型,然后在你需要它实际完成的工作上比较确切的模型。
从一句话开始,几分钟内拿到完整网站。



