For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/nvidia-aspire-v1-0-robot-debugging-skills-a8a0a489.md.
NVIDIA 发布了 ASPIRE V1.0,这是一个机器人框架,可将执行失败转化为下一次尝试的素材。编码智能体编写机器人控制程序、运行程序、检查执行情况并修复代码。成功的修复随后可以成为技能库中的可复用条目。
NVIDIA 发布了 ASPIRE V1.0,这是一个机器人框架,可将执行失败转化为下一次尝试的素材。编码智能体编写机器人控制程序、运行程序、检查执行情况并修复代码。成功的修复随后可以成为技能库中的可复用条目。
ASPIRE 是 Agentic Skill Programming through Iterative Robot Exploration(通过迭代式机器人探索进行智能体技能编程) 的缩写。它的核心理念是:经验可以积累为可检索的操作知识,而不必将每一次改进都编码进新训练的模型权重中。
此次发布还凸显了底层推理模型的重要性。QbitAI 报道称,团队接入 GPT-6 Astra 后,表现大幅提升。NVIDIA 当前的资料显示,该框架在多个前沿模型上都取得了较好的结果,同时保留了原有的执行引擎和技能机制。
一次抓取失败本身并不能揭示原因。物体的位置可能识别错误,抓取候选方案可能不理想,机械臂可能无法触及目标,也可能是规划的运动与环境发生了碰撞。
ASPIRE 的执行引擎会记录感知、规划、抓取和控制调用过程中的证据,包括观察结果、输入和输出,以及可用的视觉证据。智能体可以检查多模态轨迹中与问题相关的部分,而不是只把最终失败当作唯一反馈。
工作流程很直接:
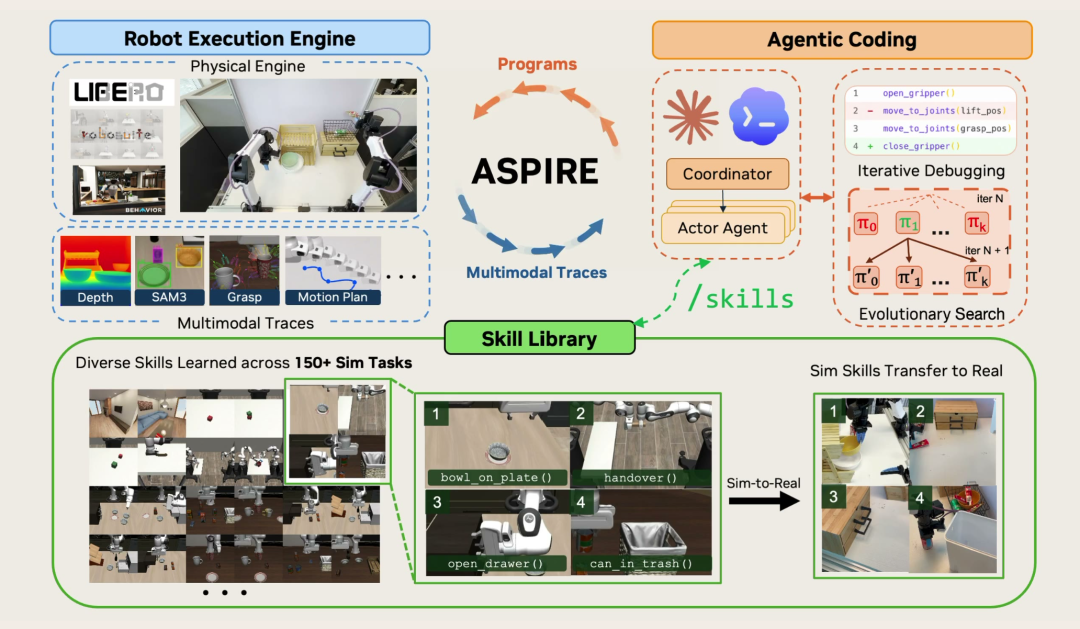
ASPIRE 方法示意图,图片来源于研究团队,由原始报道转载。
该框架还通过进化搜索探索不同的程序。智能体不会反复微调同一种失败方案,而是可以尝试不同的指令序列、规划器或抓取策略,再保留通过执行检查的方案。
例如,抓取低处物体可能需要调整机器人的位置、更换机械臂,或尝试不同的运动规划器。最终有用的产出既包括修正后的程序,也包括说明该修正适用于何种情况的解释。
一次性修复只能帮助完成一个任务。可检索的技能则能够帮助处理之后遇到的、具有相同底层难点的任务。
ASPIRE 会将经过验证的修复提炼成文本形式的机器人知识。遇到新任务时,智能体会检索相关条目,并将其作为上下文指导,用于创建新程序。这不同于在固定坐标下简单重放旧轨迹。
原始资料介绍了一个展示用技能库,其中包含 90 多项技能,覆盖 18 个类别中的 150 多项任务。这些类别涵盖感知、抓取、导航、物体搜索、双臂操作和故障恢复。NVIDIA 表示,公开的浏览器展示的是具有代表性的样本,并非完整目录。
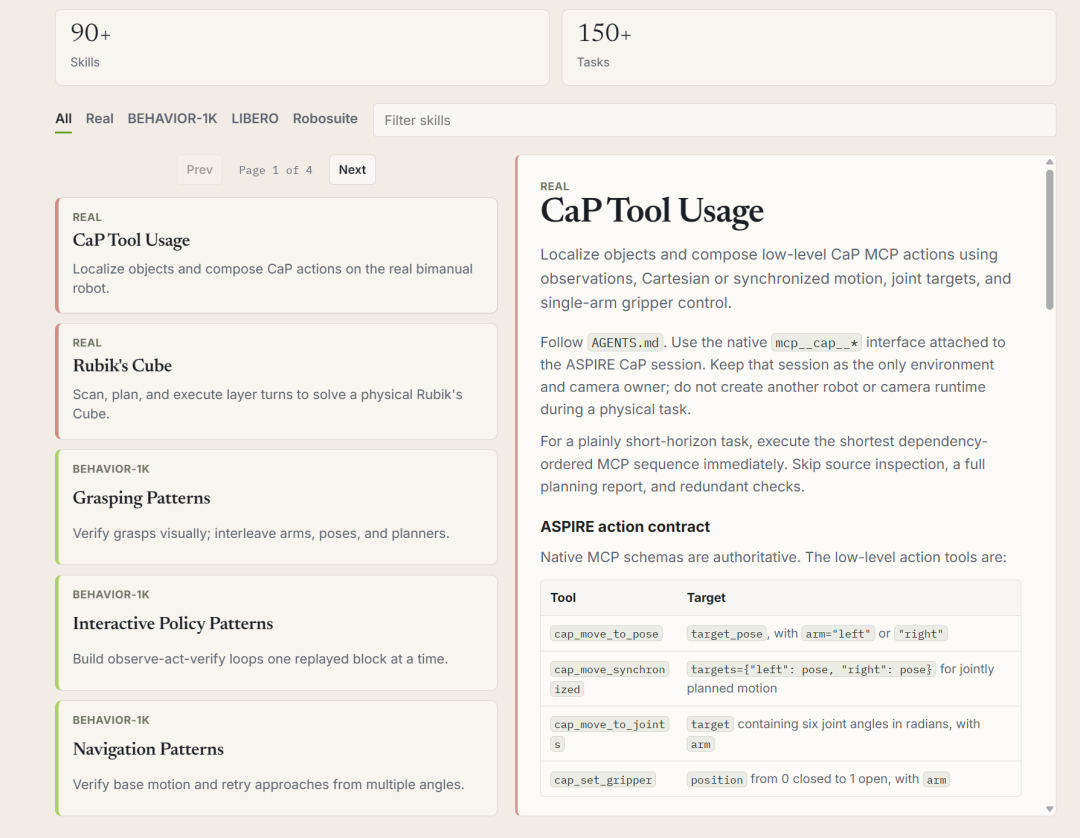
原始报道中展示的技能库界面。
该项目报告称,在具有代表性的未见过的长周期任务上,零样本成功率为 31%;相比之下,采用大量测试时推理和重试的先前方法为 4%。这是特定评估设置下的结果,并不代表执行全新家务任务时的普遍成功率。
研究人员还报告了从仿真迁移到真实机器人的初步跨具身迁移结果。检索适用的仿真中发现的技能,减少了机器人在真实环境中首次成功运行程序所需的 token 数量,并提高了该程序在留出任务上的成功率。但这并不能证明每项仿真技能都能原样迁移到每一种机器人或 API。
原始报告称,团队将早期使用的 Claude Opus 4.6 后端替换为 GPT-6 Astra 后,仿真结果大幅提升。Jim Fan 的公告还称,Claude Opus 5.5 的表现略高于 Astra,而 Sonnet 5.5 在成本与能力之间处于较有利的位置;在该项对比中,每项任务成本约为 12 美元。
当前官方项目页面报告了以下使用 Claude Opus 5.5 获得的主要结果:
| 评估项目 | 项目报告结果 | 范围 |
|---|---|---|
| LIBERO-Pro | 平均成功率 99% | 全部 80 项测试任务 |
| Robosuite | 在具有代表性的任务上成功率为 100% | 选定任务,并非整个套件 |
| BEHAVIOR-1K | 在具有代表性的任务上成功率为 100% | 选定任务,并非全部 1,000 项活动 |
资料指出,Robosuite 中有 7 项代表性任务,BEHAVIOR-1K 中有 2 项代表性任务。分母很重要:不应将该结果描述为解决了 BEHAVIOR-1K 的全部任务。
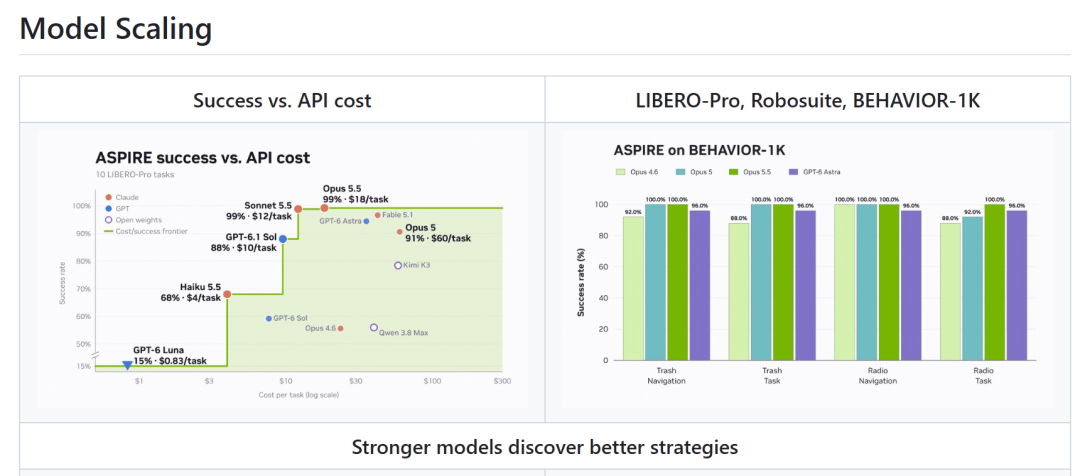
ASPIRE 项目报告展示的模型扩展对比。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
仓库中的另一项模型扩展实验评估了 10 项 LIBERO-Pro 任务,并报告了不同模型之间从 15% 到 99% 不等的成功率。该实验不应与完整的 80 项任务结果混为一谈。
实际意义在于:随着模型更换,感知工具、控制接口和积累的技能仍可继续发挥作用。项目将此描述为机器人领域的一种更广泛模式:更强的通用推理能力能够提升现有智能体系统的表现。
公开仓库包含代码、配置、智能体技能和复现实验操作手册。NVIDIA 拥有的项目材料以及贡献的项目材料采用 Apache 2.0 许可;第三方组件仍遵循各自的许可条款。
仓库将仿真实验与真实机器人操作区分开来。仿真环境需要进行主机准备,包括配置 CUDA、uv,以及获取受限访问的 SAM3 权重。要复现实验,还需要选择套件、任务集、随机种子安排和输出路径,而不能假定一条通用命令就能复现所有已发布结果。
重要提示: README 指出,生成的 Python 代码拥有完整的导入权限,试验进程和看门狗也不构成安全沙箱。官方指南要求使用隔离的主机,并为实体硬件另行设置授权和控制机制。仿真运行成功,并不足以作为无人监督地在真实环境中运行的准备。
该项目还列出了尚未解决的局限:可靠的成功检测、安全重置、安全监控、校准、固定的原语 API、搜索成本高,以及长期技能记忆管理不完善。随着技能库不断扩展,其中的条目可能会过时,或变得过于具体。
报道最后提及了 World Labs 的另一项进展。该公司的官方帖子确认,Atlas beta 版已开始逐步开放,演示重点是精准的相机路径控制。
QbitAI 还报道称,Atlas 可生成时长一分钟、分辨率为 1440p 的内容,能根据图像或手机视频进行重建,生成点云和高斯泼溅输出,并为机器人提供 RGB/深度仿真。对于本文可访问的简短官方帖子,无法独立确认这些详细规格。
生成环境与学习机器人技能可能是相互补充的研究方向。本文查阅的资料并未宣布 ASPIRE 与 Atlas 集成,因此,这种组合目前只是报道提出的一种可能性,并非已发布的工作流程。
ASPIRE 是一个机器人框架,它利用编码智能体编写、执行和调试机器人控制程序,并将经过验证的经验保存为可供后续任务复用的技能。
该项目强调技能迭代和操作知识积累,而不是对底层模型进行梯度更新。冻结的前沿模型可以检索这些技能,并在编写新程序时加以利用。
没有。报告中的 100% 结果针对选定的 BEHAVIOR-1K 代表性任务,而非全部活动。LIBERO-Pro 的 99% 数据范围不同,涵盖 80 项测试任务。
该项目评估了多个前沿模型,并称其框架不依赖特定编码智能体。不过,成功率和成本仍取决于模型、任务和实验配置;能够兼容并不意味着结果相同。
研究人员报告了初步证据,表明选定的仿真中发现的技能能够减少不同具身形态和 API 下真实机器人的调试工作量。实体机器人运行仍然需要校准、监控、安全重置和结果验证。
官方项目明确表示,该系统还不是完全自主的真实世界学习系统。README 也将仿真用途与操作实体硬件所需的操作员控制措施区分开来。
ASPIRE 将机器人执行轨迹与编码和调试循环相结合,并把经过验证的修复保存为可复用知识。此次发布通过代码、操作手册和技能浏览器,让这一工作流程变得可供检查。
其结果展现了有希望的模型扩展表现和早期技能迁移,同时也有基准测试覆盖范围和实体部署方面的重要限制。可复用的技能循环是其核心贡献;选定基准测试中接近完美的结果,并不能免除对真实环境进行受控评估的必要性。
从一句话开始,几分钟内拿到完整网站。



