For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/nvidia-vera-rubin-at-ocp-2026-mgx-1-2-dsx-6b3d7f12.md.
随着 AI 工厂从兆瓦级迈向吉瓦级基础设施,挑战已不再仅限于将更快的加速器部署进数据中心。供电、液冷、网络、可维护性、电网响应能力和可互操作的机架设计,都必须同步扩展。
随着 AI 工厂从兆瓦级迈向吉瓦级基础设施,挑战已不再仅限于将更快的加速器部署进数据中心。供电、液冷、网络、可维护性、电网响应能力和可互操作的机架设计,都必须同步扩展。
在圣何塞举办的 2026 Open Compute Project Global Summit 上,NVIDIA 宣布了一系列合作伙伴关系、开放规范和软件贡献,旨在为下一代 AI 基础设施建立更通用的基础。
核心是 NVIDIA Vera Rubin。NVIDIA 通过开放的 NVIDIA MGX 架构向 OCP 贡献了关键的 Vera Rubin 机架和计算托盘设计,使系统构建商和基础设施合作伙伴能够基于共享参考设计开展工作,而不必独立构建每一层。
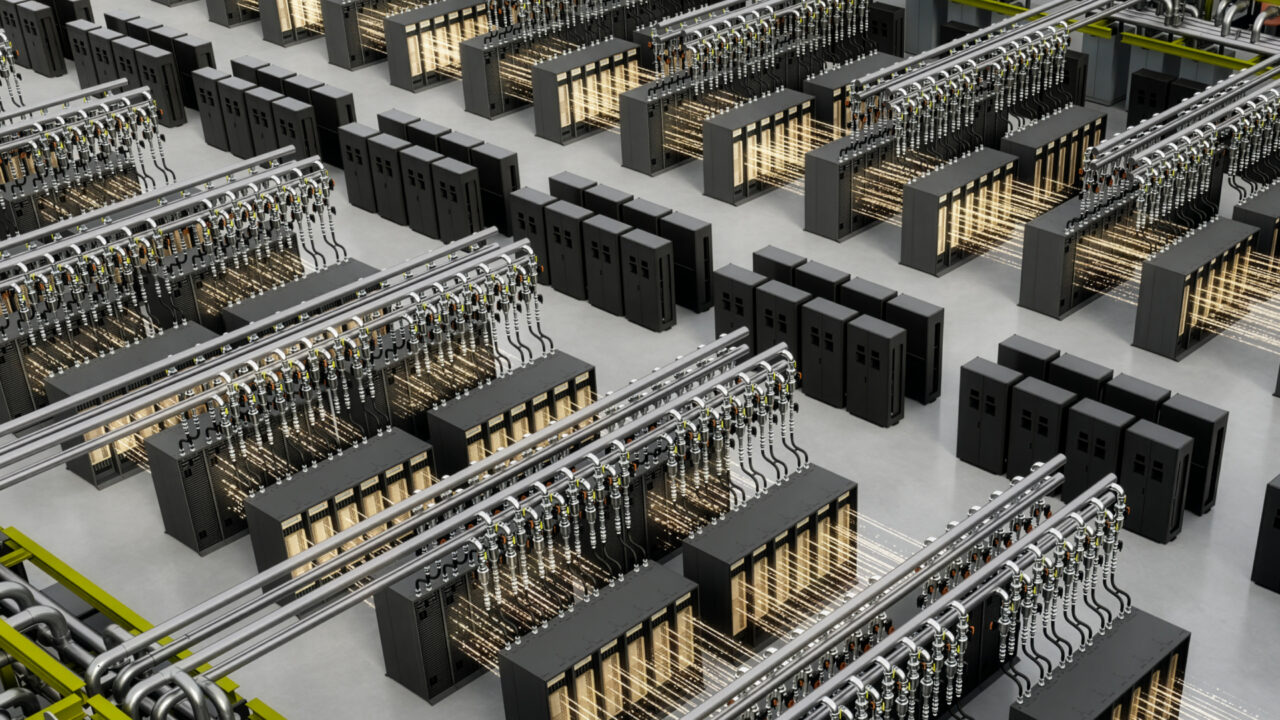
这些公告涵盖 AI 工厂的三个相互关联层面:
其结果是,行业将更广泛地推动开放、可复用的基础设施,让合作伙伴能够在全球规模上制造、部署和维护这些设施。
在 OCP Global Summit 2026 上,NVIDIA 及其生态系统合作伙伴宣布了围绕 Vera Rubin 的多项基础设施举措。
主要公告包括:
在活动现场,NVIDIA 超大规模计算与高性能计算副总裁 Ian Buck 将开放基础设施描述为在全球范围扩展 AI 工厂日益重要的一部分。
这些公告的共同主线是协同设计。计算、网络、供电、冷却和软件正被视为同一系统的组成部分,而不是彼此孤立的层级。
NVIDIA 与其他行业参与者一道,通过 OCP 的 Open DC Initiative,为第三代 MGX AI 数据中心参考设计作出贡献。
更新后的 MGX 1.2 规范将该架构扩展至支持更高功率、液冷式 AI 工厂。
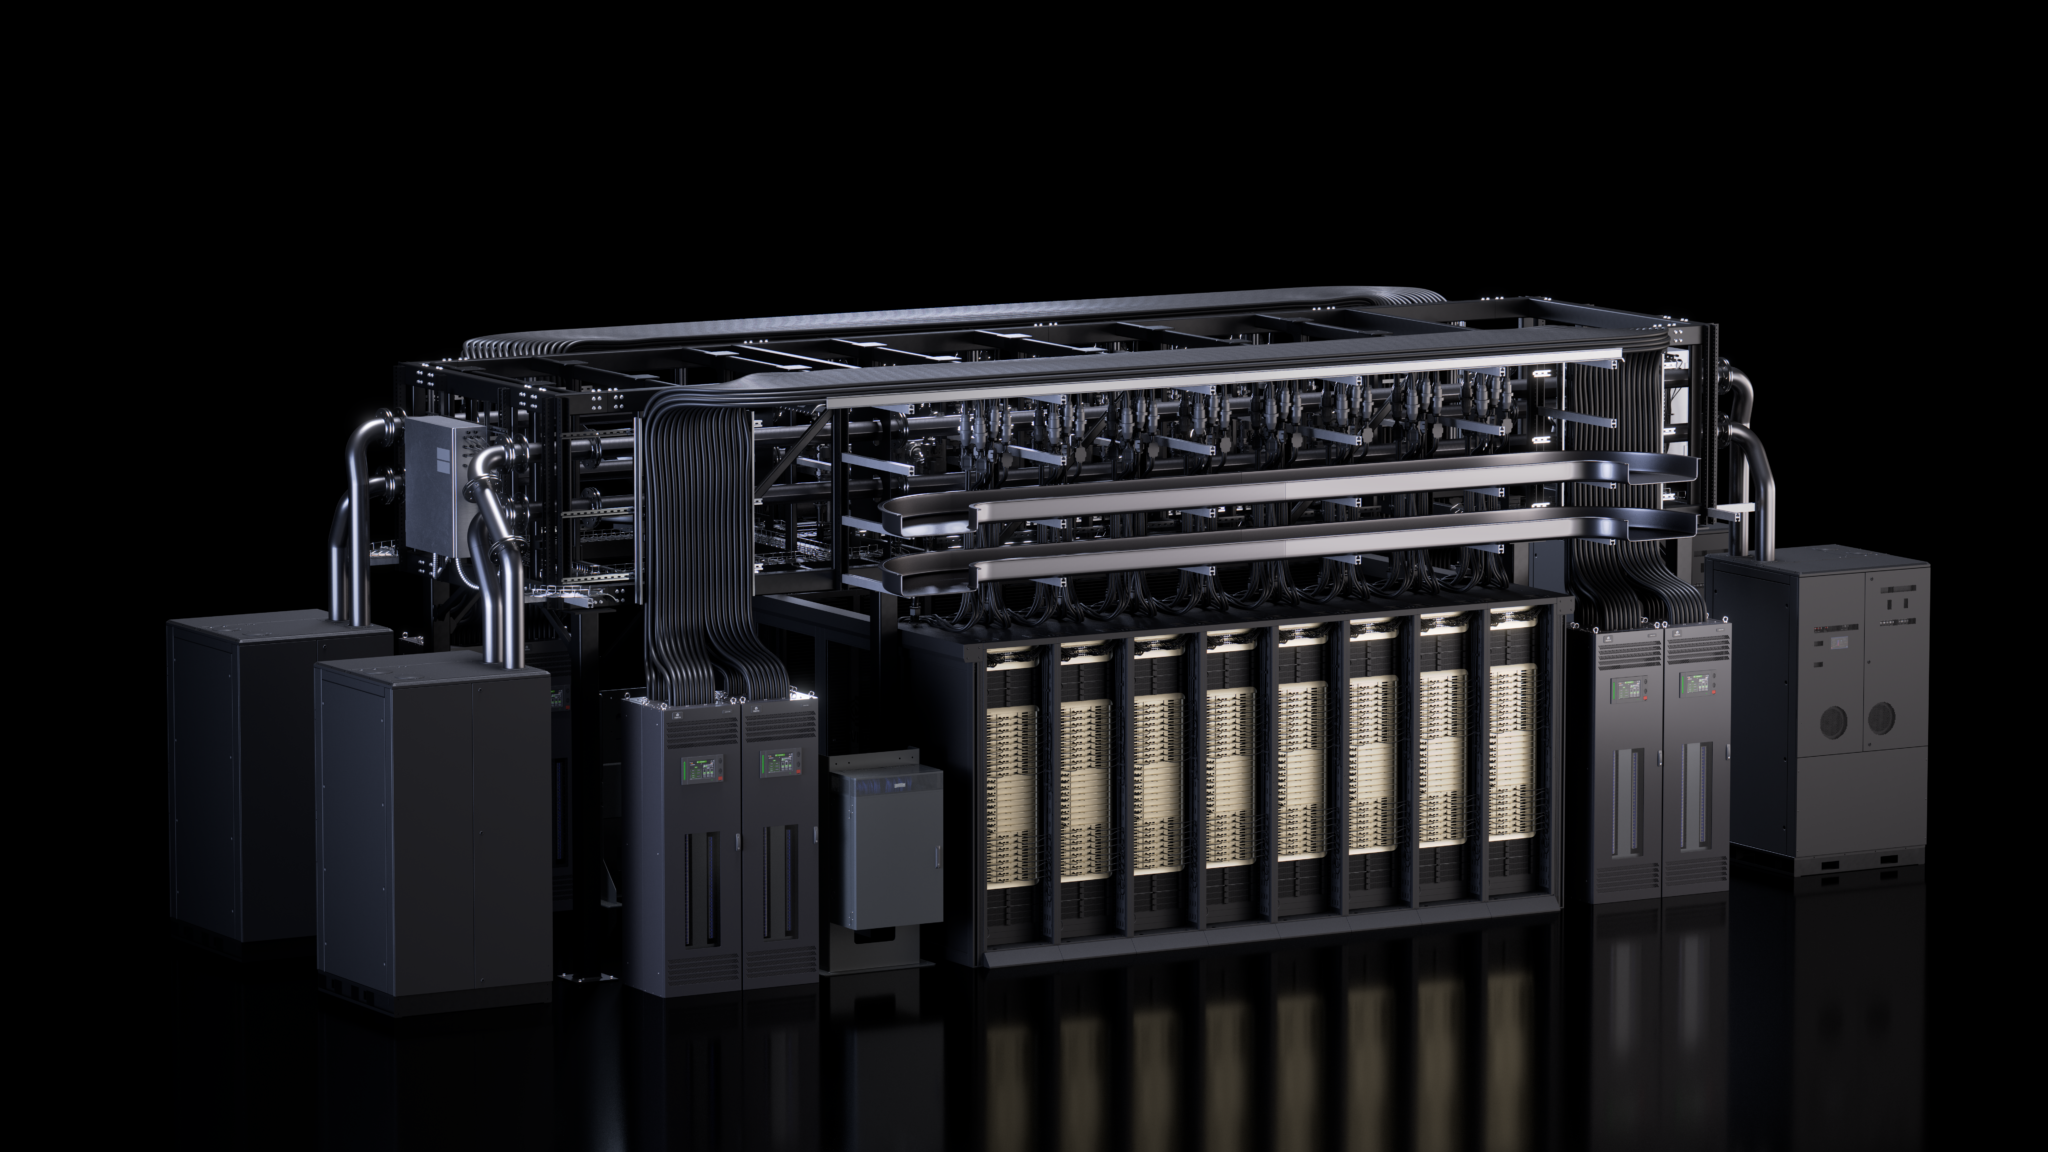
主要新增功能包括:
NVIDIA 表示,该架构能够支持最高 250kW 的机架部署,同时提升可维护性和基础设施复用能力。
MGX 是一种模块化参考架构,而非单一固定的服务器设计。
它为 OEM、ODM 和基础设施合作伙伴提供了共同的机械、电气和冷却基础,同时仍允许采用不同的 CPU、GPU、网络和存储组合。
对于 Vera Rubin,这意味着合作伙伴可以围绕已知的机架级设计构建系统,而不必每次都从专有平台起步。
Vera Rubin NVL72 平台结合了:
随后,它可以通过 NVIDIA Quantum-X800 InfiniBand 或 Spectrum-X Ethernet 进行横向扩展。
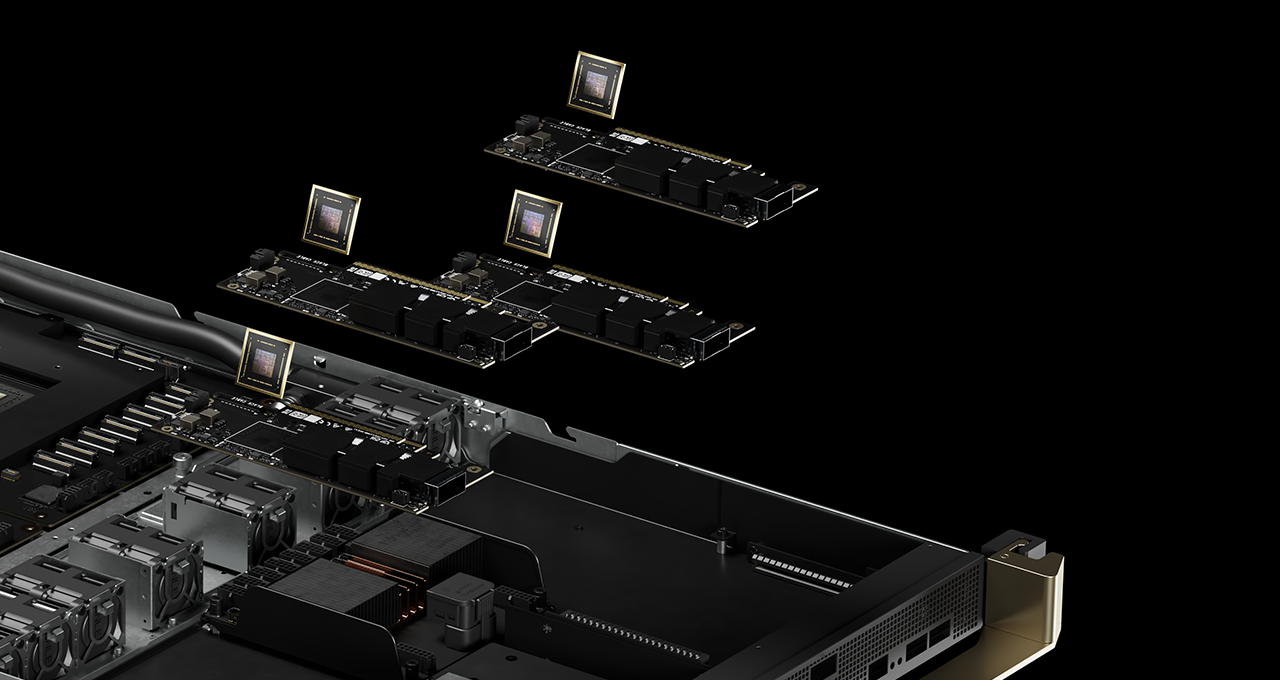
NVIDIA 还将相同的 MGX 设计原则扩展至专用的 Vera CPU 机架。
Vera Rubin NVL72 面向大规模训练和推理,而 Vera CPU 机架则针对 CPU 密集型智能体工作负载,例如:
更广泛的理念是,即使 AI 工作负载的不同部分需要不同的计算资源,也要保持物理基础设施的一致性。
NVIDIA 的 DSX AI Factory 平台旨在将计算、网络、供电、冷却、设施和软件协调为一个经过优化的整体系统。
软件层的核心是 DSX OS,NVIDIA 将其描述为用于可复用 AI 工厂运营的开放操作层。
在 OCP 上,NVIDIA 为 DSX OS 扩展了四个开源组件。
NVIDIA Config Manager 可自动化完成大规模交换机配置。
其目标是帮助运营商部署、验证和维护一致的网络结构,尽量减少手动配置。
NVIDIA Cluster Readiness Engine 在生产训练开始前,使用工作负载模拟对 GPU 集群进行压力测试。
目标是在足够早的阶段发现硬件或基础设施问题,从而避免代价高昂的训练任务失败。
NVIDIA Rack Management Service 提供机架级硬件抽象和运营层。
该软件不再将每台服务器视为独立单元,而是将机架视为固件管理和大规模基础设施控制的一等运营单元。
NVIDIA Infrastructure Controller 的 Cluster API Provider 旨在加速裸金属部署和租户接入。
NVIDIA 表示,其目标是将原始 AI 硬件在数小时内而不是数天内转化为可投入生产的集群。
这些组件基于 NVIDIA 运营 DGX Cloud 的经验开发,旨在让 AI 工厂能力更容易集成到多租户云平台中。
大型 AI 部署所需的不仅是共享机架设计。设施、冷却系统、电力架构和公用电网响应行为也需要具备共同预期。
在 OCP 上,NVIDIA 与 AMD、Google 和 Meta 共同发布了面向下一代 AI 基础设施的更新版开放数据中心规范。
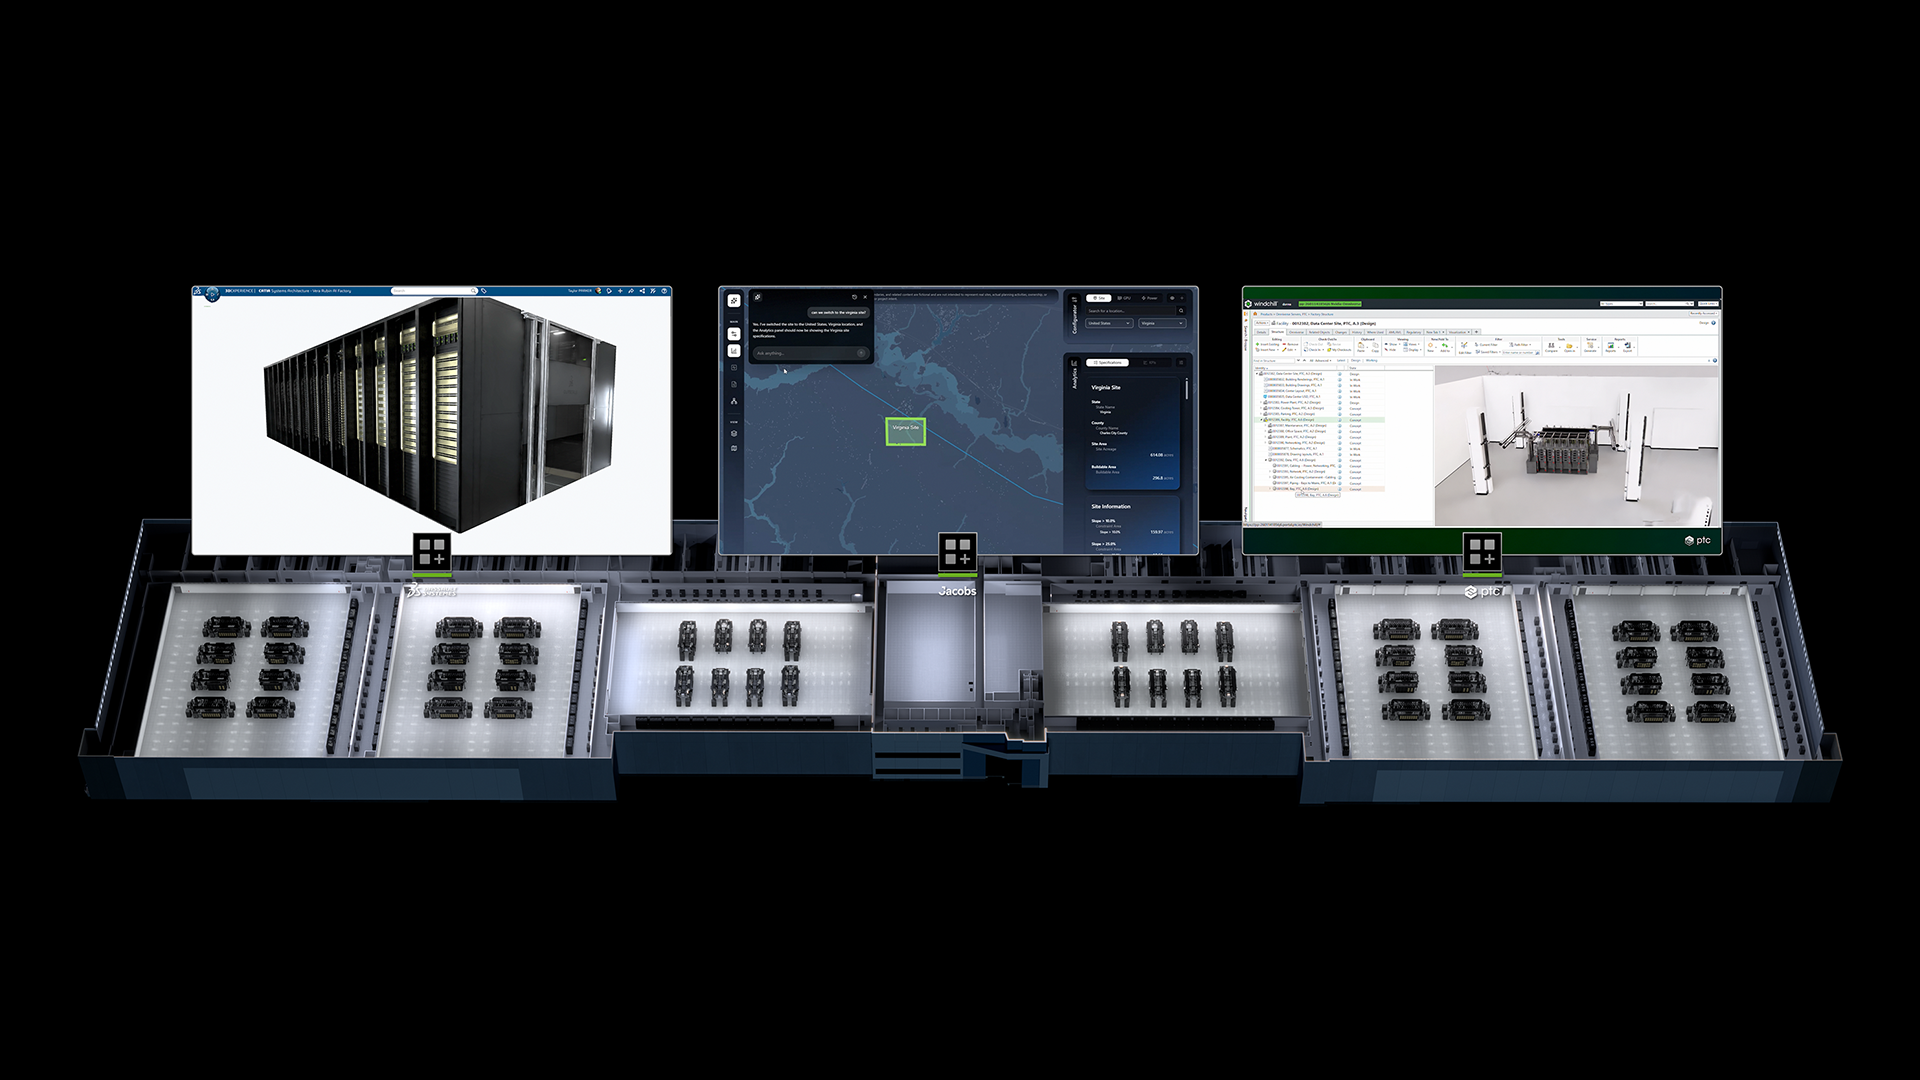
Open Data Center Specification v0.7 为 AI 工厂设施设计定义了共同蓝图。
它涵盖的领域包括:
其目的在于为制造商、托管数据中心服务商和运营商提供共同目标,而不是要求他们等待每位客户分别提供专有规范。
Google、Meta、Microsoft 和 NVIDIA 还发布了 OCP Grid Resilience Specification。
该规范定义了超大型 AI 基础设施在公用电网扰动期间应如何响应。
设计目标是让 AI 设施能够:
随着 AI 设施规模扩大到其功耗突变足以影响周边电网的程度,这一点变得愈发重要。
NVIDIA 表示,其 DSX 参考设计提供了一条可部署的实施路径,可将这些开放标准落地为实际的 AI 工厂基础设施。
功率密度正成为 AI 工厂设计中最大的约束之一。
随着训练、推理和推理计算集群不断增长,传统的低电压配电需要越来越多的铜材、电缆和转换硬件。
在 OCP 上,Visionbay.ai 发布了 K-1 的计划。这是一个基于 800 VDC 架构的 AI 工厂平台,设计时已考虑未来的 Vera Rubin 部署。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
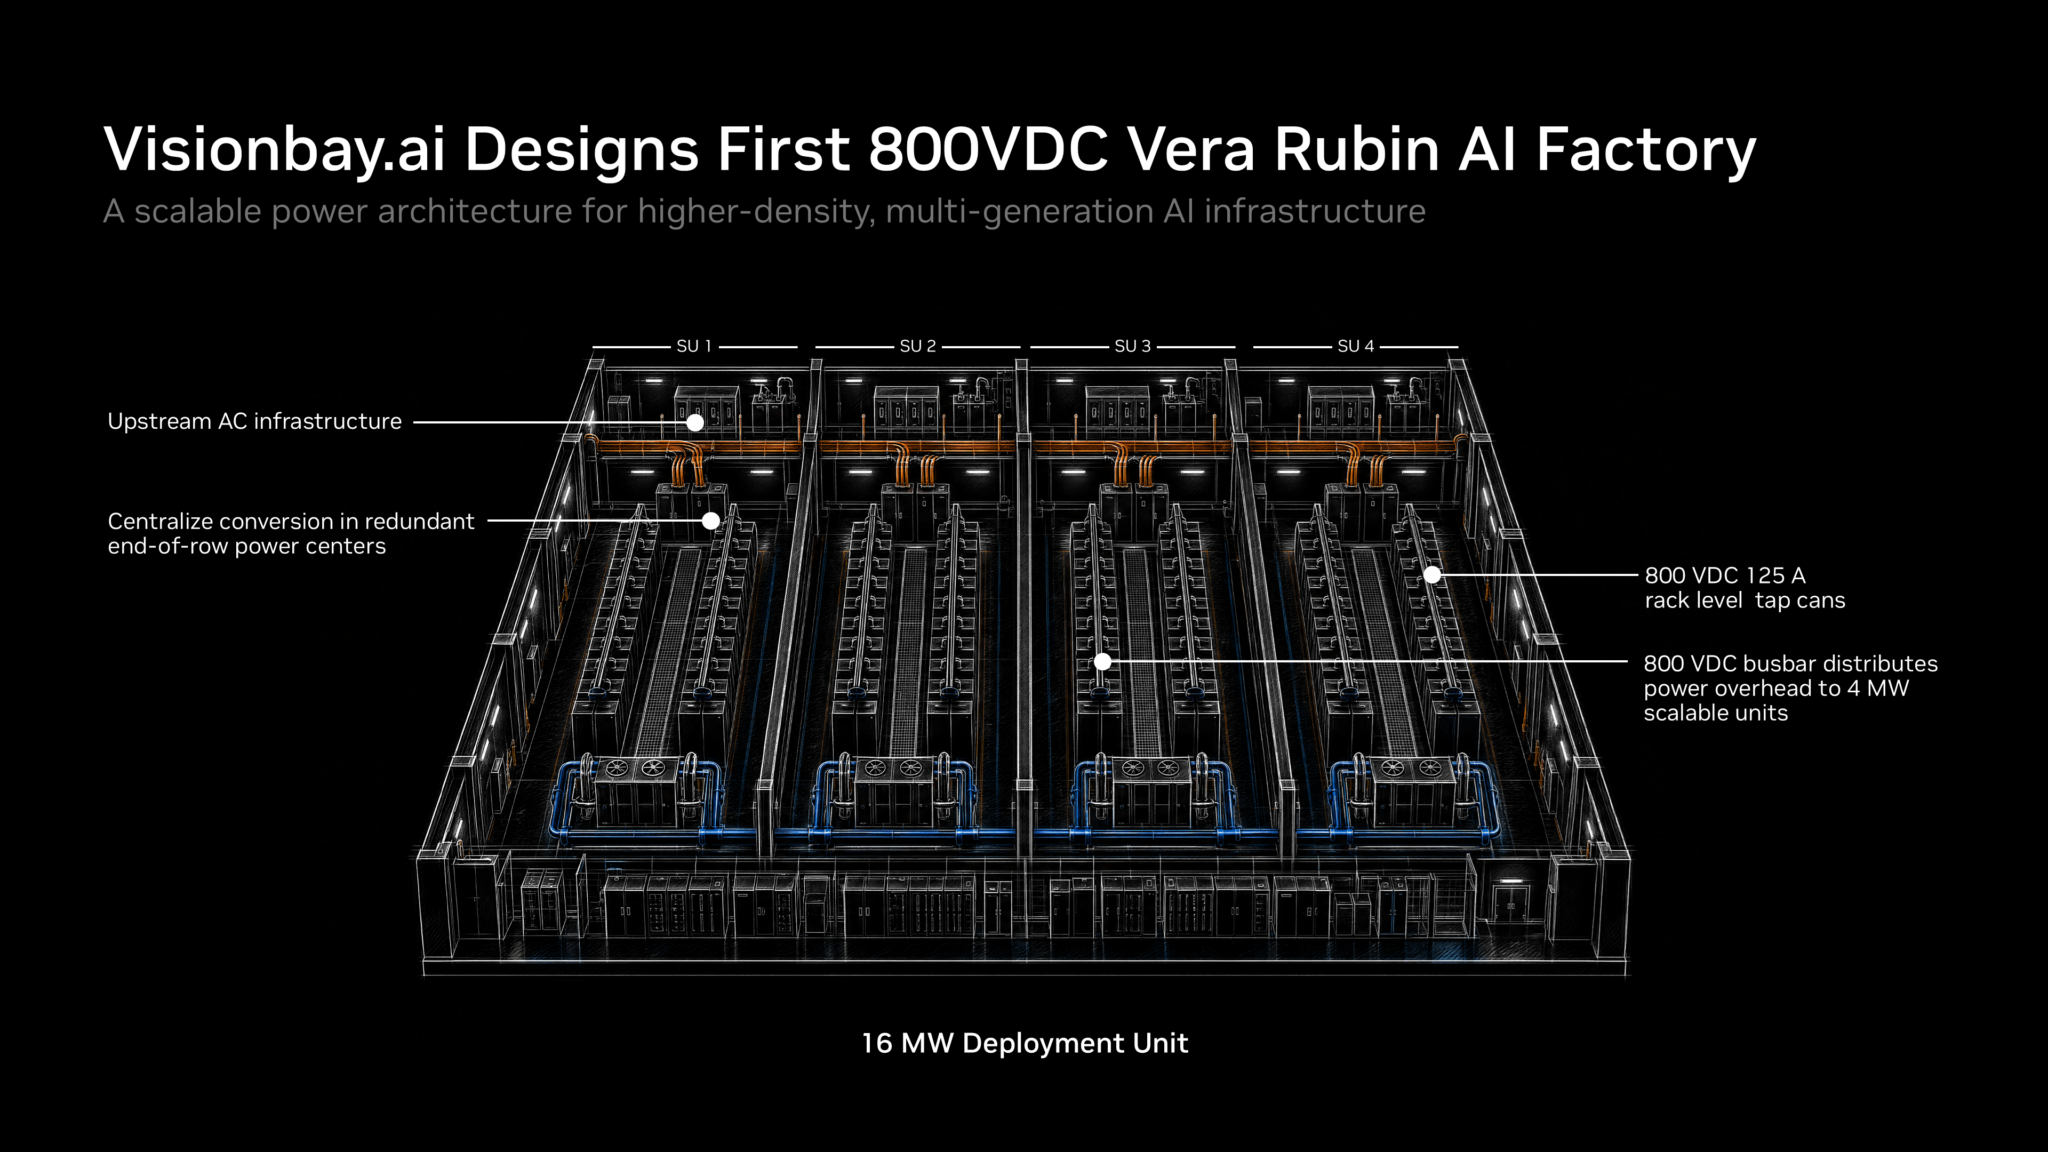
该设计将 NVIDIA 的 800 VDC 参考架构与 Vertiv 的电力和热管理技术相结合。
该架构旨在将高压直流配电进一步靠近计算层。
K-1 不再通过大量铜材反复转换和分配较低电压的电力,而是使用集群级电力中心集中进行交流转直流转换,再将 800 VDC 分配至更靠近机架的位置。
据 NVIDIA 介绍,这种方法可以:
该平台还被设计为可逐步采用,而不是要求整个设施一次性迁移到 800 VDC。
这为运营商提供了一条路径:在高压直流最具价值的区域率先引入,同时保持与现有基础设施的兼容性。
在 OCP 上,Meta 和 NVIDIA 宣布了双方网络合作的又一进展。
Meta 正在采用 NVIDIA Spectrum-6 102.4Tb/s Ethernet 交换机,用于运行在开放网络基础设施上的更大型 Vera Rubin AI 工厂。
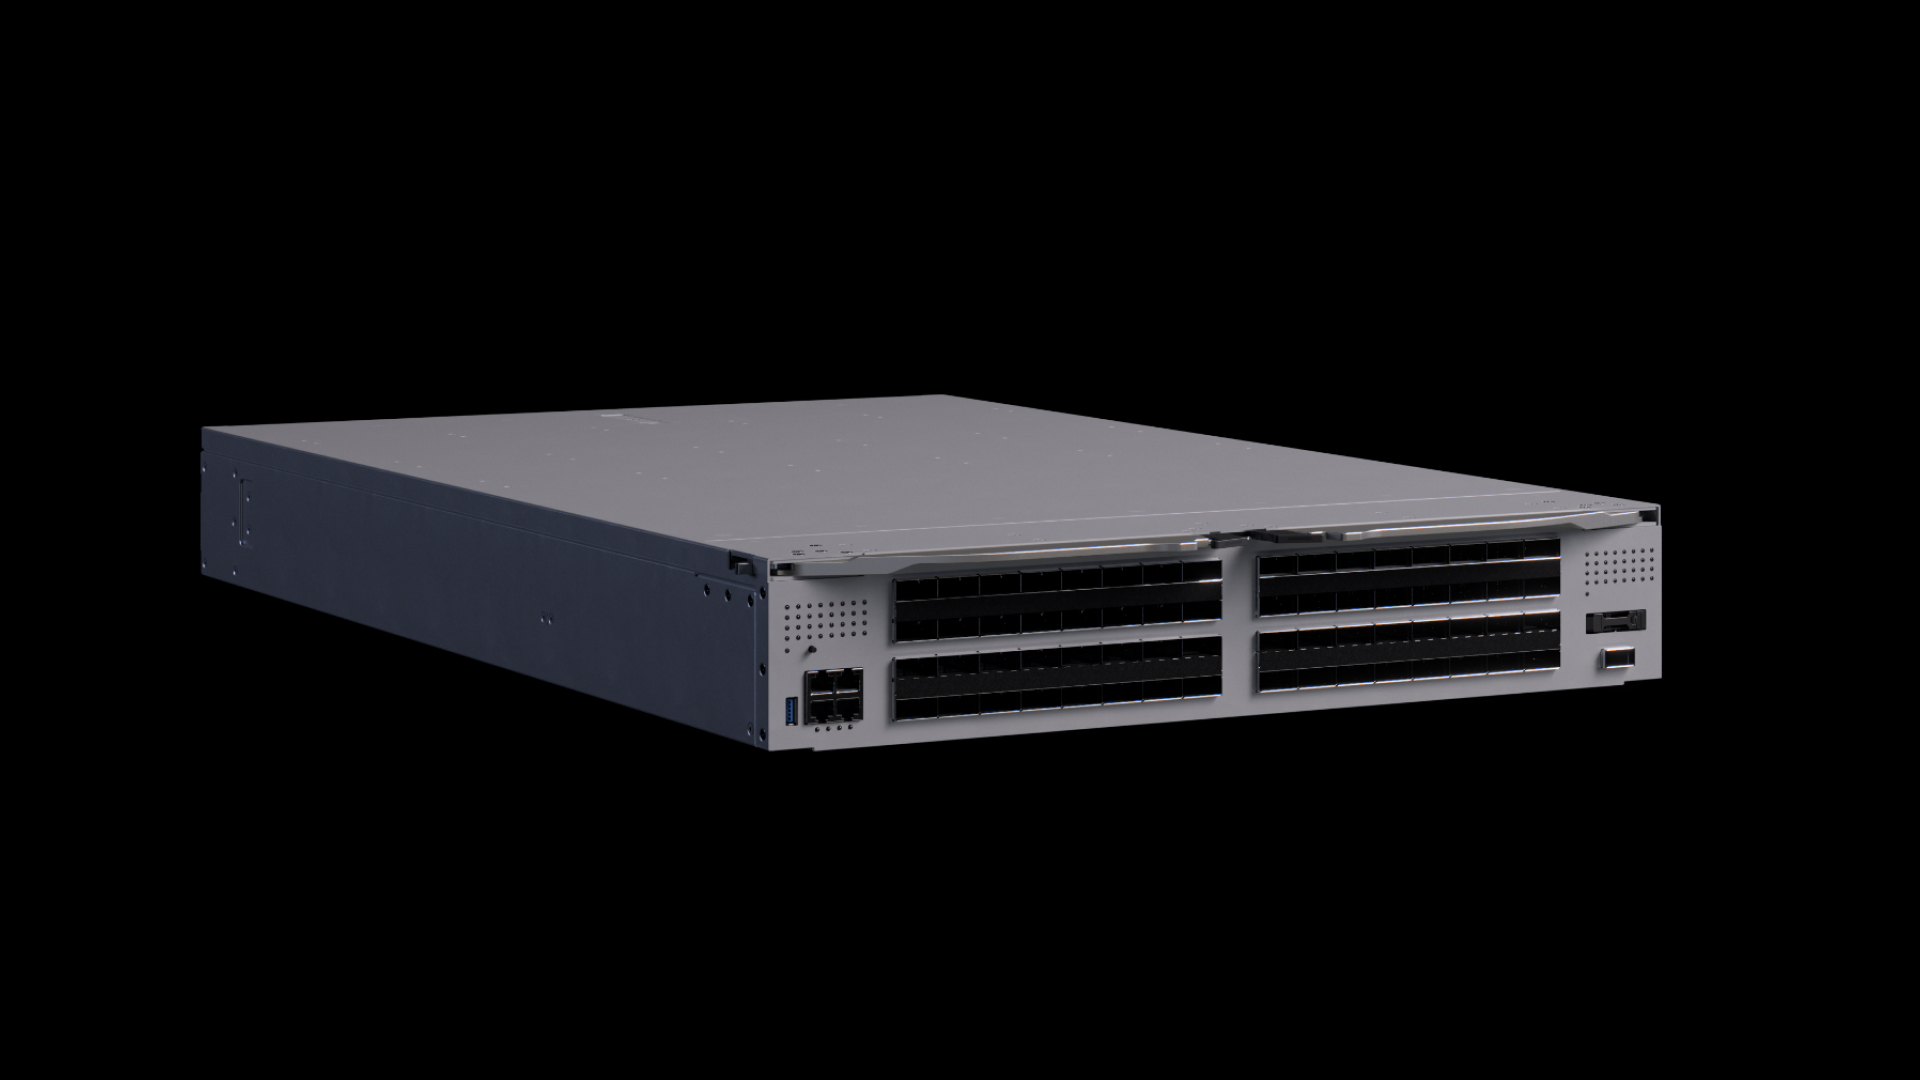
Spectrum-6 提供:
Meta 基于 Spectrum-6 的交换机称为 N-IceCube。
它旨在适配 IcePack,即 Meta 的 100T 液冷网络机架。
N-IceCube 运行 Meta 的开源网络操作系统 FBOSS。
FBOSS 使用 Switch Abstraction Interface(SAI),这是一项 OCP 标准,可提供用于控制交换机硬件的厂商无关接口。
这使 Meta 能够在采用 Spectrum-6 交换芯片的同时,继续使用熟悉的软件控制平面。
此次合作的一个重要部分是 Spectrum-X Multiplane 技术。
借助 Spectrum-6 交换机和 ConnectX-9 SuperNIC,Multiplane 可在硬件层面将 GPU 流量分散到最多八个独立网络平面。
该设计旨在支持拥有超过 100,000 个 GPU 的 AI 工厂,同时减少所需的交换机层级数量。
多条路径也提高了韧性。
如果一个网络组件发生故障,流量可以切换至其余平面。工作负载可在带宽降低的情况下继续运行,而不必使整个网络结构失效。
最终形成的网络架构旨在兼具高扩展性,并在真实生产环境中更易于运营。
随着 AI 集群规模不断扩大,物理光连接本身也成为限制因素。
NVIDIA 和 Cisco 宣布了 Ultra-Dense Small Form Factor Pluggable(USFP) 计划。这是一种面向下一代 AI 网络设计的新型可插拔光收发模块。
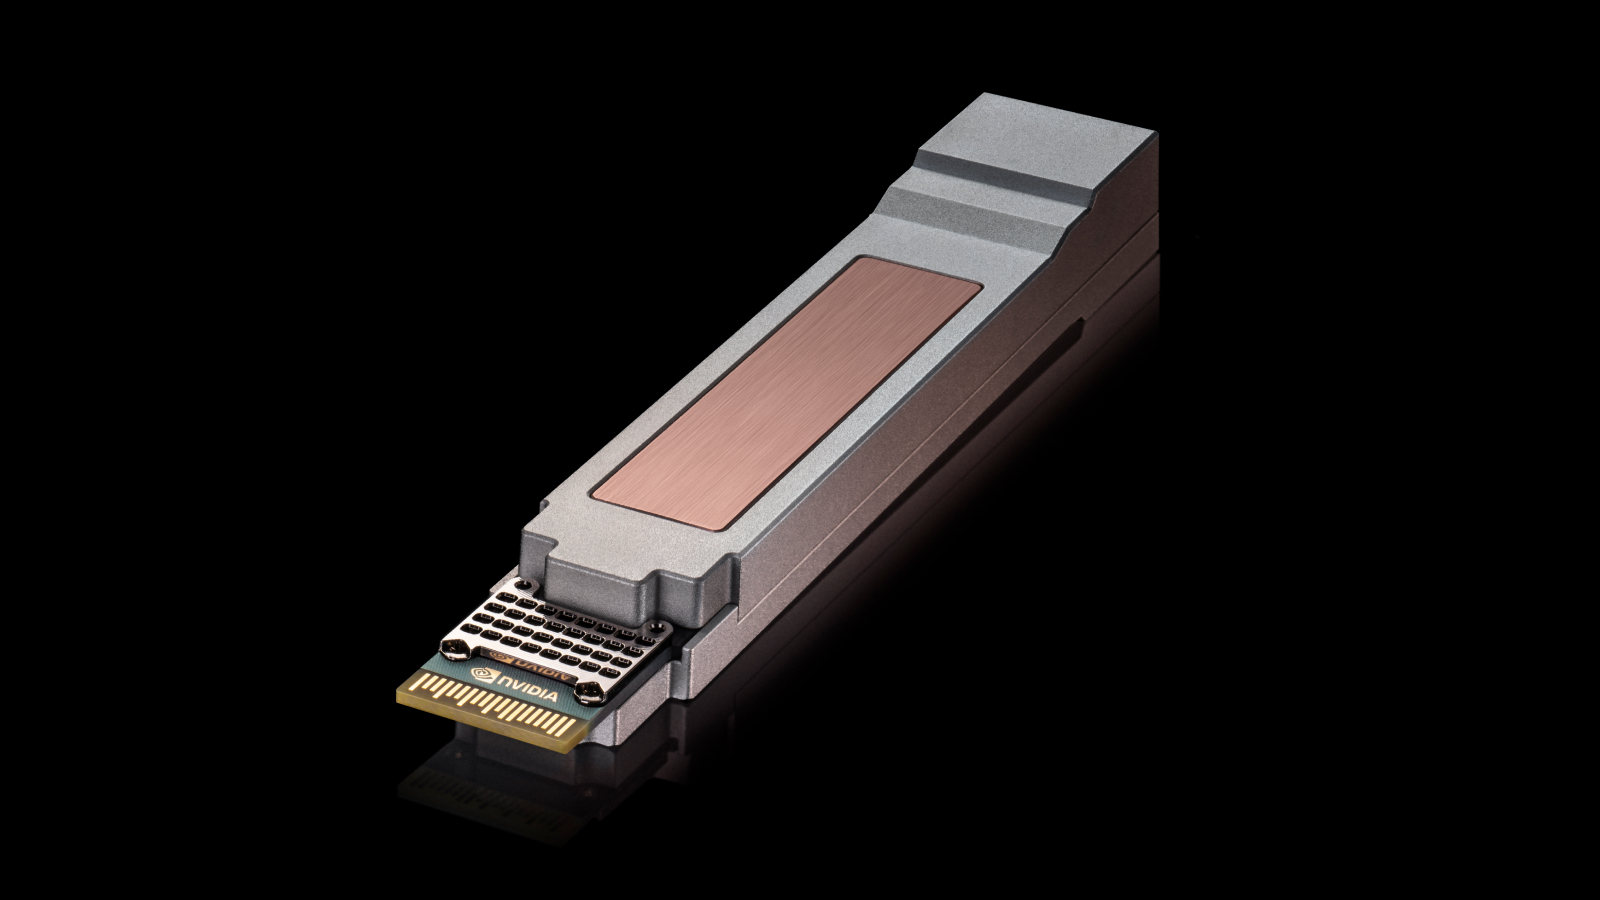
USFP 旨在为 每通道 400Gb/s 网络提供路径,同时保持与广泛使用的每通道 200Gb/s OSFP 外形规格大致相同的占用空间。
计划中的设计包括:
目标是在不增加额外网络层级的情况下连接更多计算资源,避免增加延迟、功耗和运营复杂性。
NVIDIA 和 Cisco 正与 TE Connectivity 和 Amphenol 合作开发笼架、连接器和模块,并计划通过由社区推动的多源化方式推进 USFP。
这使该设计符合 OCP 更广泛的互操作性主题,而不是形成单一供应商的光学器件生态系统。
NVIDIA 和 Google 还宣布,未来 NVIDIA ConnectX-10 SuperNIC 和 BlueField DPU 将支持 Falcon Transport。
Falcon 是一种传输协议,旨在通过 Ethernet 网络实现可靠、高性能的通信,尤其适用于拥塞场景。
它支持:
该合作将 NVIDIA 硬件加速与 DOCA 软件相结合,实现 Falcon,同时保持应用程序可使用标准 RDMA 编程接口。
这很重要,因为它为 NVIDIA 和 Google 的网络硬件提供了共同的传输层,同时允许软件继续使用熟悉的 RDMA API。
在大型 AI 网络结构中,Falcon 能够在不同路径之间分配流量、适应拥塞并从丢包中恢复,而不要求应用程序直接管理这些细节。
NVIDIA 通过开放的 MGX 架构向 OCP 贡献了关键的 Vera Rubin 机架和计算托盘设计,并参与制定了新的设施、电网和网络标准。它还发布了四个新的开源 DSX OS 基础设施组件。
MGX 1.2 是面向高密度加速计算的更新版机架级参考架构。它增加了盲插式液冷、5,000A 母排、原生 19 英寸支持、可配置 I/O 插槽,以及对最高 250kW 机架的支持。
新发布或重点展示的组件包括 NVIDIA Config Manager、Cluster Readiness Engine、Rack Management Service,以及 NVIDIA Infrastructure Controller 的 Cluster API Provider。它们分别覆盖网络配置、集群健康测试、机架级运营和裸金属部署。
随着机架功率不断提高,更高电压的直流配电能够减少所需的铜材、电缆和转换设备。NVIDIA 的设计旨在支持未来兆瓦级 AI 机架,同时允许在现有设施中逐步采用。
Spectrum-6 是 NVIDIA 面向 AI 工厂的 102.4Tb/s Ethernet 交换机平台。它提供每通道 200Gb/s 网络能力,Meta 正将其作为 N-IceCube 和 Spectrum-X Multiplane 架构的一部分采用。
USFP 是 NVIDIA 和 Cisco 正在开发的一种新型可插拔光模块外形规格,面向每通道 400Gb/s 网络。它旨在提升带宽密度和功耗效率,同时保留可插拔光学器件的可维护性。
Falcon 是 Google 的高性能 Ethernet 传输协议。预计未来的 ConnectX-10 SuperNIC 和 BlueField DPU 将通过 NVIDIA 硬件加速和 DOCA 软件支持该协议,同时保留 RDMA 编程接口。
是。NVIDIA 在 2026 年 5 月宣布,Vera Rubin 正与全球系统和供应链合作伙伴一起进入全面量产阶段,并开始规模化制造系统。
在 OCP Global Summit 2026 上,NVIDIA 将 Vera Rubin 从一个计算平台扩展为更开放的基础设施蓝图。MGX 1.2 进一步标准化了机架、冷却和供电设计,而 DSX OS 则增加了用于配置、验证和运营大型 AI 集群的开源工具。
周边生态系统也正朝着相同方向发展。新的 OCP 设施和电网规范定义了大型 AI 工厂应如何建设,以及它们在电力扰动期间应如何响应。Visionbay 的 800 VDC 设计应对了不断提升的机架密度,而 Meta、Cisco 和 Google 则通过 Spectrum-6、USFP 和 Falcon Transport 扩展网络技术栈。
核心主题是互操作性:Vera Rubin 正在成为不仅涵盖 GPU,而且覆盖计算、网络、供电、冷却和运营的共享参考架构。
从一句话开始,几分钟内拿到完整网站。



