For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/openai-math-release-backlash-ahm-statemen-ac66e132.md.
OpenAI 于 2026 年 10 月 6 日发布数学研究成果后,引发了迄今最激烈的争论之一:当前沿 AI 开始以人类社群难以消化的速度产出研究成果时,数学研究将发生什么变化?
OpenAI 于 2026 年 10 月 6 日发布数学研究成果后,引发了迄今最激烈的争论之一:当前沿 AI 开始以人类社群难以消化的速度产出研究成果时,数学研究将发生什么变化?
OpenAI 发布了数百篇由其内部前沿模型生成的数学手稿,覆盖数学和理论计算机科学的多个领域。最初的仓库包含 722 篇手稿,归入 372 个成果系列。
这一发布立即引发了强烈关注。
一些数学家认为,这代表着发现速度的一次历史性加速。
另一些人则担心,大量艰深的论证在专业人士拥有足够时间理解、验证、置于学术语境中或进行解释之前,就已经被一次性放入公共领域。
最强烈的组织化批评来自 人类数学协会(Association for Human Mathematics,AHM)。该组织于 10 月 7 日发布声明,敦促数学家停止与 OpenAI 合作,并呼吁建立一种以人类理解为核心的科学愿景。
Terence Tao 通过在自己的数学博客上以客座文章形式转载该声明,扩大了它的传播范围。
这一细节非常重要。
Tao 并非 AHM 声明的作者,而公开的 AHM 声明由该组织的 传播工作组(Communications Working Group) 签署。Tao 的博客明确说明,这是一篇转载自 AHM 自身声明页面的客座文章。
因此,将这一事件概括为“Terence Tao 带领数学家向 OpenAI 宣战”并不准确。
更准确的描述是:
AHM 针对 OpenAI 的发布模式发表了措辞强烈的声明,而 Tao 通过转载该声明扩大了其影响力。
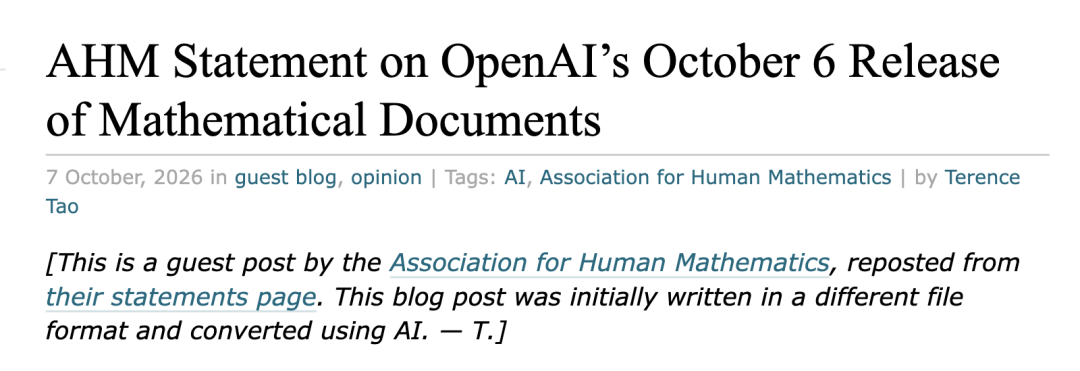
AHM 的声明篇幅不长,但立场异常直接。
该组织认为,OpenAI 大规模发布 AI 生成的数学内容,违背了现有科学规范,也违背了独立的 数学与人工智能咨询小组(Advisory Group on Mathematics and Artificial Intelligence,AGMAI) 此前提出的建议。
AHM 的核心反对意见并不局限于某个证明是否正确。
这份声明关注的是整个过程。
其立场可以概括为四点:
AHM 的声明最后敦促数学家停止与 OpenAI 合作。
这确实是一项抵制呼吁。
但它不应被误认为是整个数学界的共识立场。
AHM 是一个会员制组织,对人类创作的数学以及与商业 AI 公司合作的限制有公开承诺。其会员资格向数学研究界中达到研究生水平及以上的成员开放。
在最终核验时,AHM 的公开会员页面列出了 809 名会员,其中包括 532 名 AI-free caucus 成员。
这是一个具有实际影响力的组织,但并不是代表所有数学家的正式机构。
Scott Aaronson 后来也明确指出了同样的区别:AHM 会员代表自己发言,而不是代表整个数学界。
通过查看 AGMAI 的建议,可以更容易理解这场争议。
AGMAI 是一个由高等研究院托管的独立小组。其成员包括 Timothy Gowers、Martin Hairer、Edward Witten、Ravi Vakil 等数学家。
OpenAI 曾联系其中一些成员,希望成立一个外部咨询小组,但该小组独立运作,不接受 OpenAI 的报酬。
9 月 29 日,AGMAI 发布了《负责任发布 AI 生成数学成果》指南。
该小组在第一段就表示,不支持前沿 AI 实验室在公众科学界无法访问的专有模型上测试高级数学问题。
它明确要求这些实验室停止这样做。
这正是 AHM 后来抓住的重点。
然而,OpenAI 仍继续使用其内部模型评估开放研究问题。
与此同时,OpenAI 表示,它曾就 如何负责任地发布已经产生的结果 征求 AGMAI 的意见。
这是两个不同的问题:
前沿实验室是否应该在开放研究问题上测试专有模型?
以及:
如果实验室已经获得了重要的 AI 生成结果,应该如何发布这些结果?
AHM 认为,OpenAI 忽略了第一个问题,却利用针对第二个问题的咨询为此次发布提供合法性。
OpenAI 的立场是,持续开展内部科学评估对于开发更好的研究工具非常重要,而发布流程仍然可以通过社区反馈得到改进。
AGMAI 于 9 月 29 日发布的建议并不只是简单地要求“停止”。
对于尚未被人类理解的 AI 生成数学成果,该小组建议实验室:
OpenAI 执行了其中部分建议。
该公司将材料发布在带有版本控制和引用协议的公共 GitHub 仓库中。
它发布了许多证明的 Lean 形式化版本。
它发布了 10 份经过删节的推理摘要。
它披露了大致的计算使用量和评估统计数据。
它还承诺资助研讨会、会议和其他项目,帮助人类理解 AI 生成的重要成果。
但这次发布仍然引发争议,因为其规模前所未有,而且其中大量工作尚未被人类数学家消化。
最初的发布内容如下:
| 发布详情 | OpenAI 公开数据 |
|---|---|
| 初始手稿数量 | 722 |
| 成果系列 | 372 |
| 向模型提出的问题数量(约) | 4,000 |
| 每项成果的平均计算量 | 约相当于 ChatGPT Pro 思考 3 小时 |
| 经过删节的推理摘要 | 10 |
| Lean 形式化版本 | 许多,但并非所有手稿都有 |
官方仓库将“系列”定义为一组相关论文,其中可以包括主要成果、替代证明、推论或配套论证。
这很重要,因为:
722 篇手稿 ≠ 722 个彼此无关的已解决问题
这些手稿被归入 372 个成果系列。
OpenAI 也没有声称内部模型解决了它尝试的每一个问题。
仓库显示,该内部模型在评估过程中被提出了 约 4,000 个问题。
BAAI 来源转载了 Scott Aaronson 在 10 月 7 日发布的《数学末日》文章中的数据:约 8,000 个尝试问题,以及大致 5% 的成功率。
Aaronson 写道,这似乎是他听到的说法。
OpenAI 自己的仓库目前给出了不同的数字:
约 4,000 个问题
由于该仓库是第一方发布记录,本文将 OpenAI 的数字作为主要参考。
此外,也不宜简单地用 372 除以 4,000 来计算“成功率”。
成果系列并不一定与单个尝试提示词一一对应,而且仓库表示,目录是根据重要性经过筛选和聚合的。
最初的“722 篇手稿”已经不再是当前数量。
OpenAI 的仓库历史显示,一个符号错误使一篇手稿和两篇依赖该手稿的论文失效。
三篇手稿被撤回。
OpenAI 还修订了另外 14 篇手稿,涉及证明修复、陈述更正、假设澄清、依赖关系修正和引用更正。
截至最近一次核验,仓库包含:
719 篇手稿
372 个成果系列
这为争论双方都提供了重要证据。
对于批评者而言,这说明为什么在完全理解之前进行大规模发布可能会造成质量控制问题。
对于支持者而言,这表明 OpenAI 正在维护一个公开的修订和撤回流程,而不是假装首次发布不可改变。
仓库保留了旧版本,并包含说明具体缺陷的撤回通知。
理论计算机科学家的反应最容易体现这次发布带来的情绪冲击。
Scott Aaronson 将这一事件称为 “数学末日”。
他的文章列出了复杂性理论、算法、数论、数学物理学和其他领域中的重要主张。
对 Aaronson 个人而言,最令人震动的成果之一,是声称证明了 唯一游戏猜想(Unique Games Conjecture,UGC)。
他的妻子 Dana Moshkovitz 在职业生涯的大部分时间里都研究与 UGC 相关的问题。
发布的手稿附带了 Lean 证书,但 Aaronson 强调,形式化验证并不等同于人类理解。
Moshkovitz 最初的反应并不只是“证明是错的”。
相反,她认为这篇手稿极其难读。
她批评其中对既有成果的使用不清晰、引用令人困惑、构造方式陌生,而且论述几乎无法在没有 AI 协助的情况下理解。
与此同时,她的反应也并非完全负面。
Aaronson 的文章还引用了她对未来的设想:具有创造性视野的数学家可以利用 AI 检查和实现想法,而这些陌生的构造可能会带来许多值得学习的内容。
这种反应比原始文章中“绝望”的表述更加复杂。
问题不仅在于 AI 是否能够解决一个问题。
更在于人类是否能够有意义地吸收 AI 发现的内容。
这场争论中最重要的区别之一,是:
形式正确性
与:
人类数学理解
Lean 可以机械地检查形式化证明是否由给定公理和此前验证过的引理推导而来。
这是一种强有力的保证形式。
但 Lean 证明不会自动回答以下问题:
传统数学所做的不只是证明真理。
它还围绕真理建立一个可复用的思想结构。
这正是 AHM 和 AGMAI 强调 人类理解 时所指的核心。
OpenAI 于 10 月 6 日发布的公告并没有声称,将仓库上传完成就意味着科学过程已经结束。
该公司表示,希望这些结果能够推动人类知识进步,并将资助:
OpenAI 还表示,正在探索由社区托管的替代方案,避免材料只能存放在公司控制的仓库中。
该公司承诺改进未来的发布方式。
其中包括改进数学论述和呈现方式。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
OpenAI 的论点实际上是:
这些结果已经存在。通过附带相关材料、修订记录和形式化证明将其发布,社区就可以开始理解它们。
AHM 的反驳是:
以快于社区理解速度的方式创建和发布成果,会改变研究生态本身;而验证负担的存在并不是中性的。
这并不是简单的“AI 好”与“AI 坏”之争。
双方是在争论什么才算负责任的科学进步。
BAAI 的标题将这一事件描述为 Tao “带领”集体抵制 OpenAI。
第一方来源并不支持这种说法。
Tao 的博客写道:
这是人类数学协会的一篇客座文章,
转载自该协会的声明页面。
该声明署名为:
人类数学协会
传播工作组
Tao 的名字并未出现在 AHM 当前公开的会员名单中。
这并不意味着他不同意 AHM 提出的所有担忧。
Tao 曾多次讨论 AI 发展速度极快给数学带来的挑战,包括他所称的一种“证明消化不良”风险:成果到来的速度可能超过社区的吸收能力。
但转载声明并不等同于撰写、签署声明,或领导发布声明的组织。
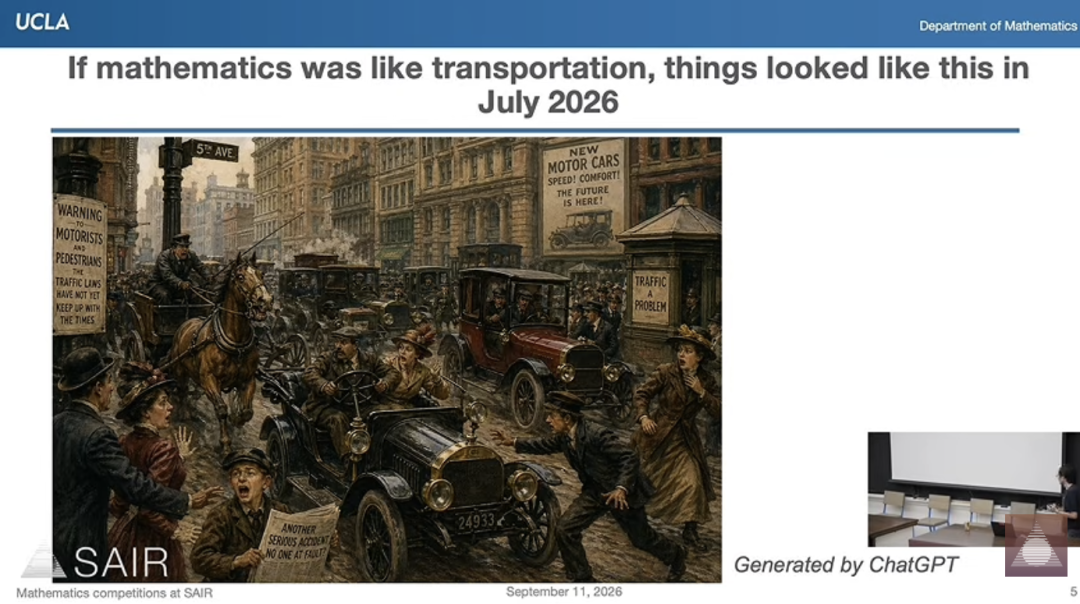
原始文章最具概念性的部分,涉及一个难题被“解决”之后会发生什么。
在传统数学中,一个重要成果通常会带来多年的后续工作:
证明本身只是起点。
一种强大的新技术可能比它最初证明的定理更有价值。
令人担忧的是,AI 现在可能产出多于社区消化能力的前沿论证。
这会造成一种不对称:
AI 生成能力
        ↓
数百个证明

人类专家能力
        ↓
缓慢阅读、检查、解释和教学
如果产出规模远快于理解速度,研究人员最终可能会把越来越多时间花在解释机器生成的数学上,而不是选择自己的研究方向。
AGMAI 明确提出了这一担忧。
其 10 月 6 日的回应表示,数学研究的未来不能只是人类理解由 AI 实验室挑选和产出的结果。
数学家仍然必须能够选择自己的问题,并追求不由私人公司评估优先级定义的方向。
原始文章有时将这场争议描述为数学家感觉自己被“取代”。
职业焦虑显然是反应的一部分。
但第一方声明提出了更广泛的论点。
数学不只是一张等待被逐一解决的开放问题清单。
研究人员还重视:
一个能够快速产出证明的模型,会改变这一生态系统中的某个环节。
但它不会自动取代其余部分。
更深层的争论在于:当一个组织拥有比公共研究界强大得多的数学工具时,谁来控制研究议程?
AGMAI 将其描述为形成 双层体系 的风险,在这种体系中,专有实验室的进展速度超过整个领域。
还有一个更微妙的研究层面担忧。
对于一些数学家而言,发现答案的路径与最终定理同样重要。
如果一个解决方案突然出现,即便缺少清晰解释,未来的尝试也不再具有心理上的独立性。
研究人员知道:
这些信息会永久改变搜索过程。
原始文章将此描述为“污染”。
一个不那么带有价值判断的说法是 信息独立性的丧失。
一旦一个领域知道终点,研究人员就无法再以同样方式经历最初的不确定性。
这是否构成伤害,取决于人们认为数学研究的目的是什么。
如果唯一目标是积累真实定理,那么快速解决显然很有吸引力。
如果目标还包括培养独立的人类发现和洞察,答案就没有那么简单。
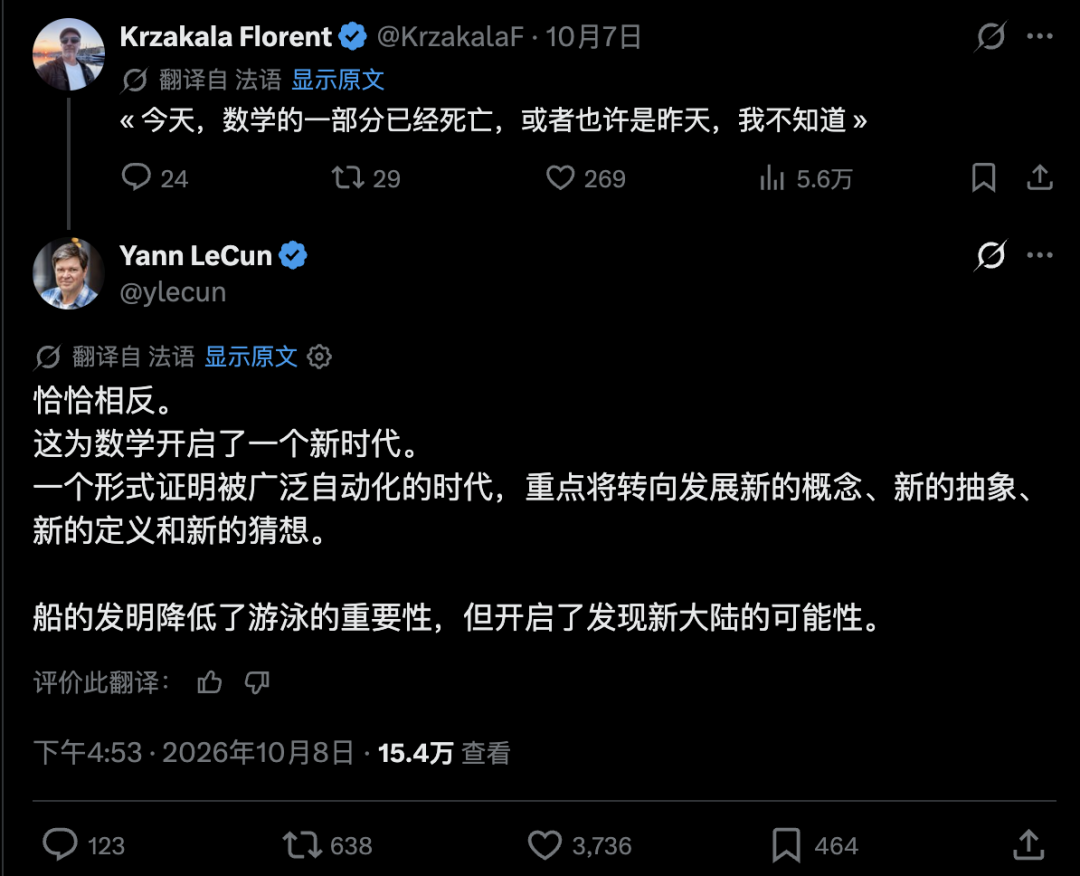
Yann LeCun 的回应代表了相反的观点。
他在公开评论中表示,数学正在进入一个新时代,而不是走向消亡。
他的立场是,随着形式化证明日益自动化,人类注意力可以转向:
这种类比并不陌生:
一项技术可能让某种人类技能变得不那么核心,同时扩大人们能够完成的事情范围。
在这一观点下,自动化证明并不会扼杀数学。
它会改变人类数学家的比较优势。
Scott Aaronson 也持类似的混合立场。
当他认为 AI 公司的行为值得批评时,他会强烈批评这些公司;但他也反对因为人类研究人员希望先解决开放数学问题,就要求公司完全不要解决这些问题。
他的结论是,数学必须适应变化。
目前还无法知道 10 月 6 日发布的多少成果能够以当前形式经受详细的专家审查。
OpenAI 自己也警告,部分未形式化的成果可能存在问题。
三篇手稿立即被撤回,说明谨慎是必要的。
与此同时,将整个发布内容斥为“AI 垃圾”也很困难。
部分手稿拥有可由机器检查的 Lean 形式化版本。
专家正在积极阅读重要成果。
这批材料包含涉及一些严肃研究人员多年研究问题的主张。
因此,正确的标准既不是盲目接受,也不是自动拒绝。
每项成果都需要独立的验证路径:
AI 生成手稿
        ↓
在可行的情况下进行形式化验证
        ↓
专家阅读
        ↓
文献和原创性检查
        ↓
解释性重构
        ↓
社区接受或拒绝
这一过程需要时间。
| 主张 | 当前状态 |
|---|---|
| OpenAI 发布了 700 多篇 AI 生成的数学手稿 | 已确认 |
| 初始仓库包含 722 篇手稿 | 已确认 |
| 当前仓库包含 719 篇手稿 | 已确认,原因是撤回了 3 篇 |
| 该合集包含 372 个成果系列 | 已确认 |
| 模型被测试了约 8,000 个问题 | Scott Aaronson 报道如此,但 OpenAI 仓库称约 4,000 个 |
| 平均每项成果使用约相当于 ChatGPT Pro 思考 3 小时的计算量 | OpenAI 已确认 |
| 许多手稿拥有 Lean 形式化版本 | 已确认 |
| 每篇手稿都经过形式化验证 | 错误 |
| 每项成果都已被人类专家完全理解 | 否 |
| AHM 呼吁数学家停止与 OpenAI 合作 | 已确认 |
| Terence Tao 撰写或领导了 AHM 声明 | 第一方来源不支持 |
| Tao 在自己的博客上转载了 AHM 声明 | 已确认 |
| AGMAI 认可 OpenAI 的完整流程 | 否;AGMAI 明确表示其角色不构成认可 |
| OpenAI 正在资助帮助人类理解的项目 | 已确认 |
| 所有 372 个成果系列都已成为被接受的数学定理 | 否 |
这场争议可能会持续存在,超出当前这个仓库的生命周期。
如果前沿模型继续进步,数学界需要建立能够与其同步扩展的工作流程。
有几项要求已经变得清晰。
每项成果都应说明由哪个模型生成、使用了哪些提示词、消耗了多少计算量,以及经过了怎样的人类编辑。
在可能的情况下,证明应附带可由机器检查的材料。
如果专家无法理解证明为什么有效,那么仅仅证明正确还不够。
AI 系统需要更强的工作流程,用于识别相关的既有技术并分配贡献归属。
科学成果不应完全依赖于生成成果的公司所控制的基础设施。
如果实验室发布数百项高级成果,解释这些成果的负担不应完全转嫁给无偿工作的学者。
如果只有少数公司能够访问最强大的数学系统,研究社群就无法保持真正的思想独立性。
这些观点比简单的“人类对抗 AI”标题更接近 AGMAI 争论的实际内容。
OpenAI 发布了一个大型公共仓库,其中包含由内部前沿模型生成的数学手稿和证明材料。最初发布的内容包括 722 篇手稿,归入 372 个成果系列。
OpenAI 在发现一个论证中的符号错误同时影响了两篇依赖该论证的论文后,撤回了 3 篇手稿。仓库保留了版本历史和撤回通知。
第一方来源不支持这一说法。该声明由人类数学协会传播工作组发布;Tao 在自己的个人博客上以客座文章形式转载了声明。
AHM 是一个致力于在 AI 时代维护数学作为人类思想实践的组织。其会员资格向同意相关承诺的研究生及以上级别研究人员开放,包括对与商业 AI 公司开展某些合作,以及发表 AI 生成数学写作的限制。
AGMAI 是由高等研究院托管的独立数学与人工智能咨询小组。它就如何负责任地与数学研究互动向 AI 实验室提供建议,但对 OpenAI 没有决策权。
AGMAI 表示,其咨询角色不应被理解为认可产出这些结果的流程。该小组欢迎建设性互动,但表示数学界必须判断其建议得到了多大程度的遵循。
不是。OpenAI 表示,许多证明拥有 Lean 形式化版本,但并非全部都有。仓库明确警告,部分未形式化的成果可能存在问题。
形式化正确的证明能够确立逻辑有效性,但数学还依赖解释、可复用思想、概念结构、历史背景和新的研究方向。人类理解能够将孤立的定理转化为一个活跃学科的一部分。
OpenAI 于 10 月 6 日发布的数学成果既是一次研究里程碑,也是对数学学术规范的一次压力测试。该公司发布了数百篇 AI 生成的手稿,其中许多附带形式化材料,但人类理解的速度并没有跟上产出规模。
AHM 随后敦促数学家停止与 OpenAI 合作,并维护一种以人类理解为核心的科学。Tao 通过转载该声明扩大了其传播范围,但他并未撰写或领导该声明。AGMAI 则采取了更偏流程性的立场:反对在开放研究问题上测试专有模型,同时在相关成果已经存在时,为负责任发布这些成果提出详细建议。
仓库本身已经在不断变化。3 篇手稿已被撤回,其他手稿得到修订,专家社群也开始开展更加缓慢的工作,以理解模型究竟发现了什么。
核心冲突并不只是人类数学家与 AI 的对立,而是新定理的产出速度是否会远远超过验证、解释、置于语境中,并决定数学未来方向的人类流程。
从一句话开始,几分钟内拿到完整网站。