For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/openai-s-gpt-7-and-gpt-8-research-focus-w-75b1c0ac.md.
GPT-6 仍然很新,但 OpenAI 已经在思考远超 GPT-6 的未来。
在 2026 年 9 月 23 日举行的 Fellows Forum AI Summit 上,OpenAI 应用研究负责人 Boris Power 估计,公司约 80% 到 90% 的研究已经聚焦于:
GPT-7
GPT-8
以及后续世代
这一说法来自他与 Zachary Lipton 的一场公开对话,讨论前沿模型如何从研究走向智能体和真实世界系统。
Power 的核心观点并不是 GPT-6 已经不重要。
OpenAI 仍在积极改进当前一代模型。9 月早些时候,该公司发布了其能力最强的 GPT-6 模型 GPT-6 Astra。9 月 22 日,公司又通过速度更快、价格更低的 GPT-6 Sol 和 GPT-6 Luna 扩展了这一模型家族。
这看似形成了一个矛盾:
Power 的解释将二者联系了起来。
OpenAI 可以持续改进当下的模型,因为这些修复能够让当前产品变得更好,也能为研究团队带来有价值的经验。同时,最大的长期收益可能来自构建能力强得多的下一代模型,然后利用该模型帮助训练成本更低的系统。
由此形成了一种双轨战略:
推动能力前沿不断向前
+
让实用能力沿着成本曲线下沉
Power 对当前一代系统的某些工作使用了不同寻常的强烈措辞。
他说,某些旨在改善当下模型的投入,在内部被视为 “极其短视”。
这并不代表这些工作毫无意义。
假设一个当前模型在工具调用方面存在困难。
团队可能会:
这能让产品立即变得更好。
它还可以帮助研究人员理解模型为何失败,以及哪些干预措施产生了效果。
Power 的警示在于修复措施的 生命周期。
一个需要在 GPT-6 中精心干预的问题,可能会在 GPT-7 中自然消失,因为下一代模型在底层能力上已经更强。
换句话说:
今天的补丁
可能会成为
明天过时的权宜之计
这就是为何研究机构必须持续判断:哪些问题值得进行深入投入。
某项修复未来可能过时,并不意味着用户可以等待。
人们今天就在使用当前产品。
如果一个模型反复偏离目标、无法正确使用工具,或者需要过多人工监督,这个问题仍然很重要。
因此,Power 区分的是:
什么能立即改善产品
以及:
什么能创造最大的长期研究价值
OpenAI 的 GPT-6 Astra 发布表明,公司仍在第一类工作上投入大量精力。
在官方 Astra 公告中,OpenAI 介绍了面向实际工作的改进,包括更快的计算机使用能力以及在 Codex 中更好的协作能力。
Astra 可以在继续执行不依赖答案的工作时,向用户提出一个聚焦的问题。如果该决策具有重要影响,它会等待;如果缺失的细节属于常规信息,它可以基于合理假设继续推进。
OpenAI 还表示,当用户在任务过程中添加新要求时,Astra 能更好地保持对原始目标和约束条件的把握。
这些细节听起来可能不如基准测试分数引人注目,但它们直接决定了一个 AI 系统的行为更像工具,还是更像一位有能力的同事。
Power 论点的另一半与模型规模有关。
如果许多用户最终需要的是更快、更便宜的模型,为什么还要如此重度地投资昂贵的前沿模型?
因为更强的模型可以成为教师。
Power 描述了一种类似如下的模式:
训练一个能力极强的通用模型
→ 用它生成高质量示例
→ 筛选有价值的输出
→ 使用这些示例训练更小的模型
→ 以更低成本部署小模型
这属于 模型蒸馏 的一种形式。
学生模型不需要复制教师模型的所有能力。
它只需要继承足够多的教师模型有效行为,以完成目标任务。
因此,即使客户从不直接使用前沿模型,前沿模型上的工作依然可能对他们产生价值。
OpenAI 曾在更早的产品世代中公开介绍过蒸馏。
2025 年 3 月,该公司推出新一代音频模型时表示,其使用了先进的蒸馏方法,将大型音频模型中的知识迁移到更小、更高效的系统中。
该公司还介绍了使用自我对弈数据来捕捉更真实的对话动态,从而让较小模型依然具备实用性和响应能力。
OpenAI Cookbook 中的另一个示例让这种教师—学生模式更容易理解。
该示例将 GPT-4o 作为 GPT-4o mini 的教师模型,用于葡萄酒葡萄品种分类任务。
在一个包含 300 个示例的验证集中,报告的准确率为:
GPT-4o:
79.67%

GPT-4o mini:
64.67%

蒸馏后的 GPT-4o mini:
79.33%
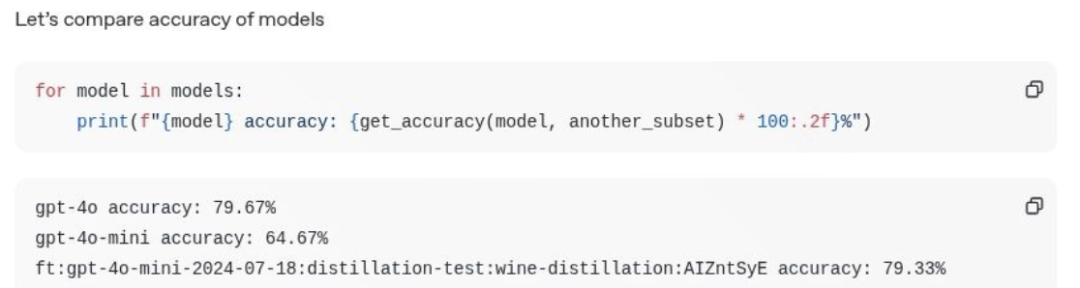
蒸馏后的学生模型在这一特定任务上的表现几乎与教师模型持平。
这 并不意味着这个小模型在整体能力上已经等同于 GPT-4o。
它说明,一个能力强大的教师模型能够足够有效地迁移针对性行为,使得更小的模型能在狭窄工作负载中变得更有价值。
GPT-6 模型家族在产品规模上应用了类似思路,尽管 OpenAI 尚未公布完整训练配方,因此无法据此将 Luna 简单称为“蒸馏版 Astra”。
OpenAI 表示,GPT-6 Sol 和 GPT-6 Luna 的训练方法与 GPT-6 Astra 所使用的方法类似,将 Astra 这一代的进展带到了更快、更实惠的模型中。
公司对该模型家族的定位如下:
GPT-6 Astra
能力最高

GPT-6 Sol
以较低成本提供强大的通用性能

GPT-6 Luna
面向高吞吐量工作的低成本模型
OpenAI 在 9 月 22 日发布时公布的 GPT-6 官方定价为:
| 模型过渡 | 输入 | 输出 | 降幅 |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2 / 100 万 tokens | $20 → $10 / 100 万 tokens | 50% |
| GPT-5.6 Luna → GPT-6 Luna | $0.20 → $0.10 / 100 万 tokens | $1.20 → $0.50 / 100 万 tokens | 50% |
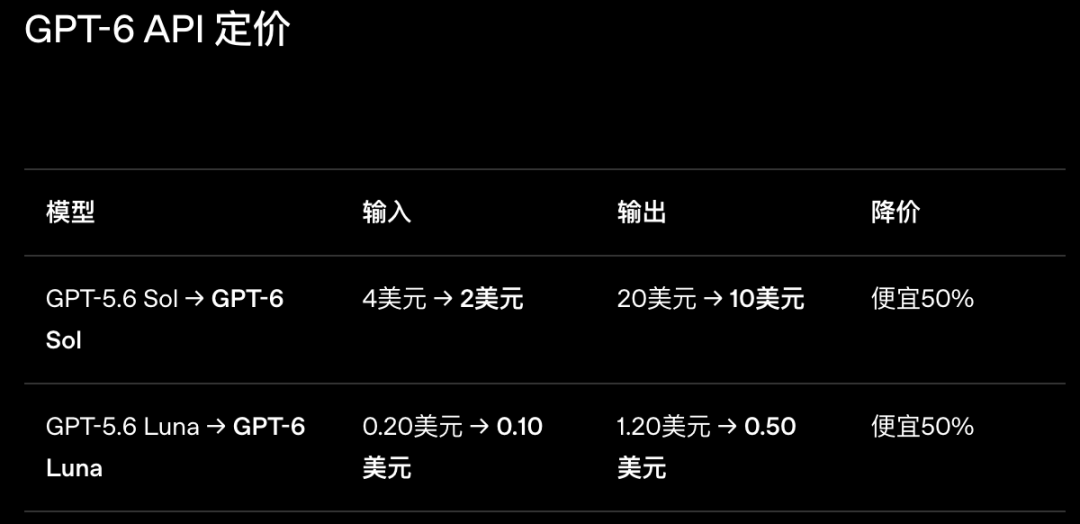
OpenAI 明确将这一目标描述为:让不同预算和工作负载都能获得前沿智能。
更大的模型抬高能力上限。
更小的模型则让更多此类能力进入日常使用。
因为大多数工作流从头到尾的难度并不相同。
项目报告就是一个很好的例子。
设想有多份源文件,它们:
工作的第一部分需要更强的判断力。
一个能力较强的模型可以:
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
一旦方向确定,许多剩余步骤就变得更常规。
更小的模型可能完全足以处理:
如果出现新的模糊情况,任务可以再升级交给更强的模型。
因此,实用工作流可能如下:
强模型
→ 复杂判断

小模型
→ 重复执行

强模型
→ 异常处理
更便宜的 tokens 并不自动意味着工作成本更低。
小模型的单次请求成本可能更低,但如果它要求用户投入更多工作,整体成本反而可能更高,例如需要:
因此,有价值的问题不是:
哪个模型的 token 价格最低?
而是:
整个被接受的结果需要多少成本?
这一总成本同时包括机器成本和人工时间。
如果用户必须成为全职 AI 项目经理,才能让更便宜的模型成功完成工作,那么更低的 API 账单并不算真正的收益。
因此,最佳分工取决于任务本身。
当一个小模型能够以低成本、可靠地完成定义明确的工作时,它就很有价值。
当任务确实需要更强的判断力时,大模型则值得其更高的价格。
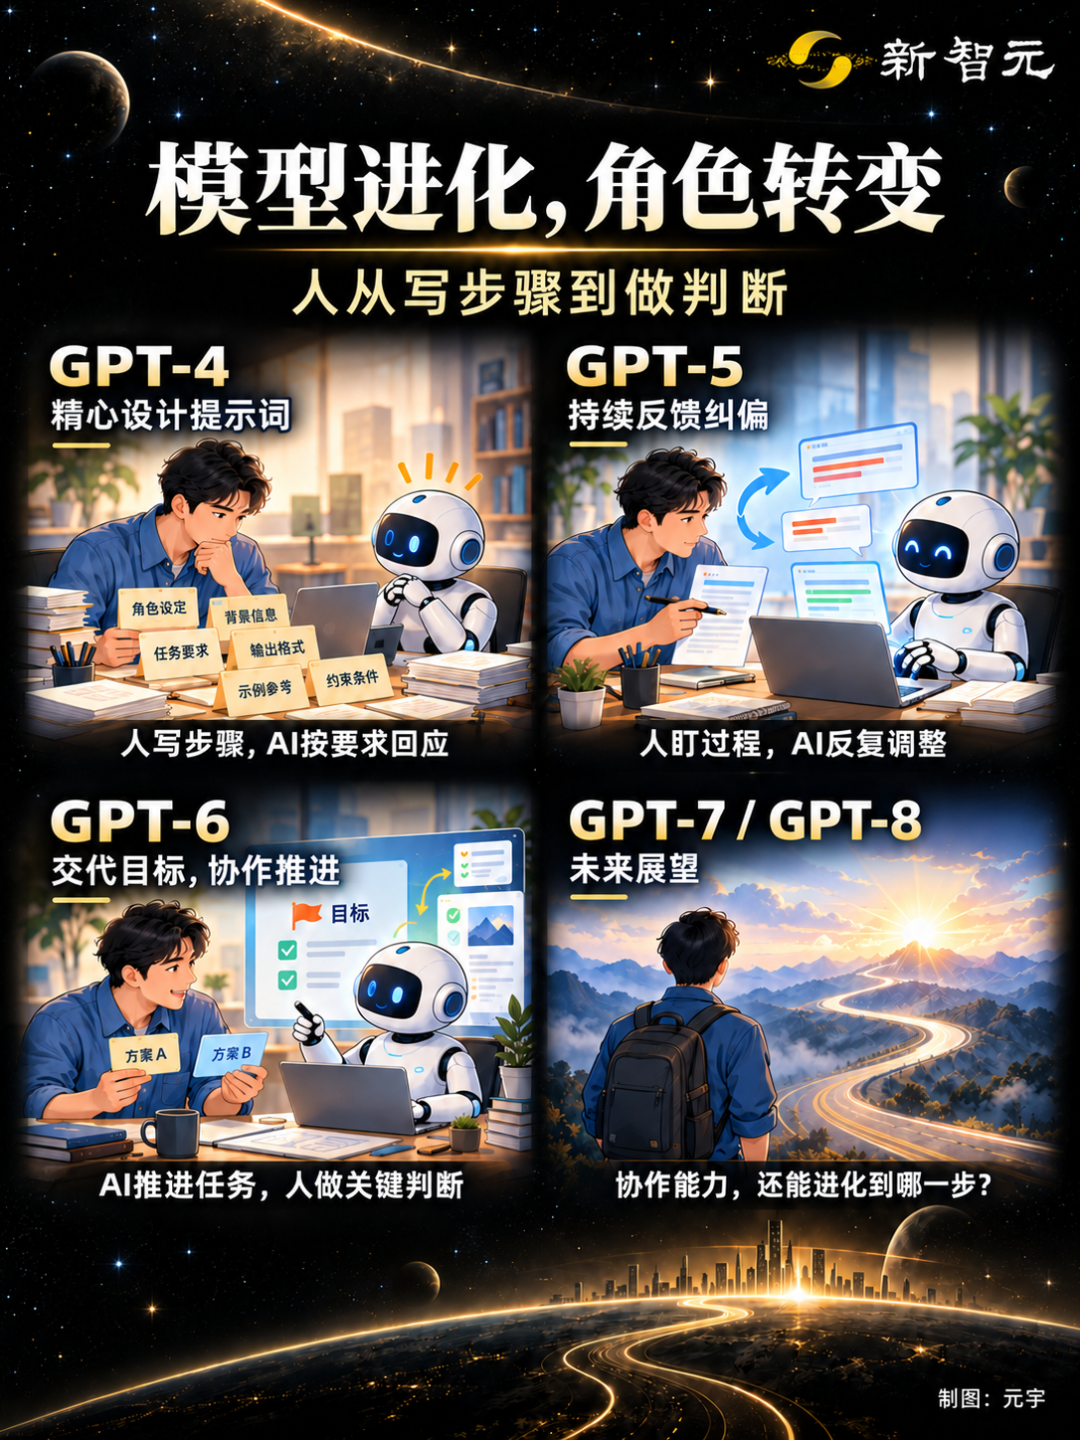
Power 还描述了人们与不同世代模型交互方式的变化。
来源文章大致将这一演进概括为:
GPT-4:
人类仔细设计步骤

GPT-5:
人类引导过程并持续纠正

GPT-6:
人类越来越多地只需陈述目标并监督关键决策
这是一个简化描述,并非对每项任务的保证。
但 OpenAI 自身的 Astra 文档描述了相同的总体方向。
Astra 可以:
这改变了人类的角色。
用户不再需要手动指定每一个步骤,而是越来越多地进行类似以下的操作:
设定目标
→ 定义约束
→ 审查重要选择
→ 检查结果
GPT-7 和 GPT-8 的关键问题在于,这种转变还能推进多远。
模型进步通常通过基准测试分数呈现。
但对于日常工作,另一个指标可能更重要:
用户仍然需要提供多少监督?
在向模型给出目标后:
如果 GPT-7 或 GPT-8 能降低这些负担,其价值可能超过小幅的基准测试提升。
这也是为什么大模型研究与小模型工作会相互强化。
前沿模型尝试发现更强大的行为能力。
更便宜的模型则尝试让其中足够多的能力能够以可扩展的成本被使用。
这个标题数字需要一个重要限定。
Power 所说的“80% 到 90%”是他在公开对话中给出的估计。
它 不是:
Fellows Forum 的议程确认,Power 以 OpenAI 应用研究负责人的身份,在 9 月 23 日一场题为 “Where Models Meet Reality” 的炉边谈话中发言。
对录音的独立报道将这段关于 80%–90% 的表述定位在完整活动录像约 1:32:52 处。
因此,最稳妥的解读是:
Power 认为,OpenAI 绝大部分研究注意力都在投向 GPT-6 之后的模型世代,因为他预计最大的基础性能力提升将出现在那里。
不应将其解读为字面意义上的财务或资源核算声明。
Power 在 9 月 23 日发表了上述观点。
六天后,即 9 月 29 日,OpenAI 发布了 GPT-6.1 Sol。
该模型并不是原文论点的核心,因为讨论重点是 Power 在活动中描述的 Astra → Sol/Luna 教师—学生逻辑。
不过,对于现在发布文章的读者来说,这依然是有用的背景信息。
OpenAI 将 GPT-6.1 Sol 描述为 GPT-6 系列中最新的模型家族,其在编程、计算机使用和专业工作方面的能力接近 Astra,但标准 API 价格低得多。
它进一步印证了访谈中讨论的相同模式:
前沿能力不断提升
→ 低成本模型吸收更多能力
→ 用户以更低成本获得更强性能
这也表明,单个中间版本的名称不如整体研究战略重要。
OpenAI 应用研究负责人 Boris Power 在 Fellows Forum 2026 上估计,约 80%–90% 的 OpenAI 研究聚焦于 GPT-7、GPT-8 及后续世代。该数字是其公开估计,并非经过审计的公司资源分配报告。
没有。Power 的发言中没有宣布 GPT-7 或 GPT-8 的公开发布日期或详细产品路线图。他用这些名称来指代 GPT-6 之后的模型世代,并认为这些世代正在获得大部分长期研究关注。
当前一代的工作能让今天的产品变得更好,并为研究人员提供更快的反馈。Power 的观点是,某些修复可能生命周期很短,因为能力更强的下一代模型可能让底层问题更容易解决,甚至完全消除。
模型蒸馏是一类训练技术:更强的教师模型帮助训练更小的学生模型。常见工作流是由教师模型生成高质量示例,对这些示例进行筛选,再训练小模型复现目标任务所需的行为。
OpenAI 表示,Sol 和 Luna 使用了与 Astra 类似的训练方法,并继承了同一代的进展,但尚未公布足够细节,无法将 Luna 或 Sol 简单描述为 Astra 的压缩副本。更准确地说,它们将相关的能力进展带到了成本更低的层级。
在 9 月 22 日发布时,OpenAI 将 GPT-6 Sol 定价为每 100 万输入 tokens 2 美元、每 100 万输出 tokens 10 美元;GPT-6 Luna 定价为每 100 万输入 tokens 0.10 美元、每 100 万输出 tokens 0.50 美元。OpenAI 表示,两者均比各自 GPT-5.6 对应模型的促销定价低 50%。
当任务需要复杂判断、处理模糊推理、异常处理或做出重要决策时,应使用更强的模型。一旦总体方向确定,小模型通常更适合处理高吞吐量、定义清晰、重复性的工作。
趋势正从编写每一个步骤,转向设定目标、定义约束并审查重要决策。OpenAI 的 Astra 文档特别描述了异步提问、等待答案时持续工作,以及在长任务中更好地保持原始目标的能力。
Boris Power 对 80%–90% 的估计,使 OpenAI 的研究战略变得更容易理解。该公司可以持续改进当下的 GPT-6 产品,同时将大部分长期研究注意力投入未来模型世代,因为其预计那里将带来更大的能力提升。
这项战略的另一半同样重要。更强的前沿模型不仅仅是高端产品;它们还可以充当教师和研究平台,帮助将有用能力迁移到 Sol 和 Luna 等更快、更便宜的系统中。
对用户而言,实际问题并不是哪个模型最大,而是如何分配工作:让复杂判断交给能够处理它的模型,同时将常规执行交给能够可靠完成任务的最低成本模型。
OpenAI 的长期押注似乎很直接:持续抬高能力上限,然后让更多这种能力变得足够实惠,以便每天使用。
从一句话开始,几分钟内拿到完整网站。



