For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/recursive-self-improvement-what-ai-resear-557e0db8.md.
AI 系统正在承担更多构建 AI 所涉及的工作:编写软件、调试基础设施、运行实验,以及建议下一步应尝试什么。这使得**递归自我改进**(通常简称为 **RSI**)成为一个日益具有现实意义的研究问题。
AI 系统正在承担更多构建 AI 所涉及的工作:编写软件、调试基础设施、运行实验,以及建议下一步应尝试什么。这使得递归自我改进(通常简称为 RSI)成为一个日益具有现实意义的研究问题。
关键区别在于,AI 是在加速由人类主导的流程,还是能够独立设计并开发出更强的后继系统。所提供的 BAAI 报告描述了一个正向后者发展的行业。公开研究为前者提供了具体证据,同时对于这种进展究竟能走多远,仍存在很大的不确定性。
根据 Anthropic 的研究讨论,完整的 RSI 是指一个系统具备自主设计和开发其后继系统的能力。能够改进训练脚本的编程 Agent 可能会对此过程有所贡献,但并不意味着它完成了整个闭环。
其中涉及几项彼此不同的能力:
在某一层级取得成功,并不能证明在之后的每一个层级也同样成功。Anthropic 明确表示,在其描述中,完整 RSI 尚未实现,也并非必然会实现。
Anthropic 报告称,截至2026 年 5 月,Claude 编写的代码占其代码库中已合并代码的 80% 以上。这是一项针对已合并代码的归因衡量,而不是声称 AI 作出了 80% 以上的全部工程决策。
该公司还报告称,2026 年第二季度每位工程师的典型代码产出约为 2024 年水平的八倍,以每日合并代码行数衡量。其自身提出的限定至关重要:代码行数并不完美地衡量产出数量,不应被解读为有效生产力提高了八倍。
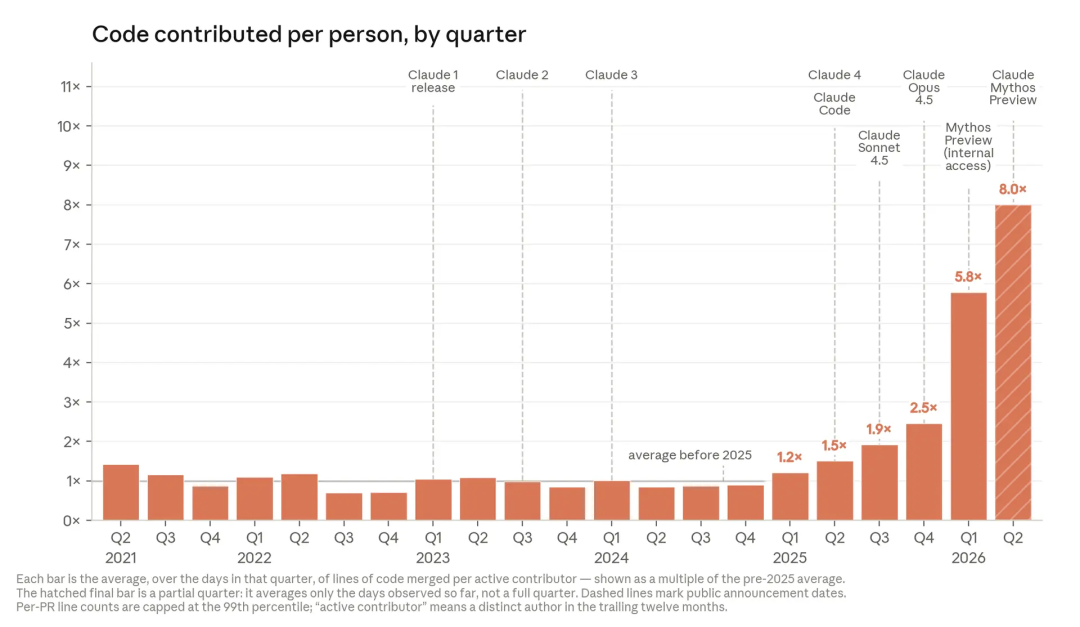
Anthropic 图表转载自 BAAI Hub 上的新智元文章。
实际变化在于,工程师可以指导和审查更多工作,而无需亲自键入每一项实现。这仍使目标设定、代码质量、共享基础设施和审查能力成为约束条件。它并不能证明人工审查已经不再必要。
编写实现代码只是研究的一部分。Agent 还需要运行实验、检查结果,并判断某项改动是否确实带来了改善。
Anthropic 描述了一项重复优化测试:模型获得训练代码后,尝试在保留正确性检查的同时让其运行得更快。结果在不同模型代际之间显著改善。该公司警告称,绝对加速幅度取决于初始代码中存在多少可优化空间;这并不是对前沿模型训练获得同等加速的衡量。
其自动化弱到强研究项目提供了另一个例子。Agent 可以在人类选定的问题和评分框架内提出并执行实验。这是在指定边界内实现研究自动化的证据,而不是证明系统独立选择了最有价值的研究议程。
SWE-bench通过代码库任务和测试来评估软件修改。METR 的任务完成时间跨度则考察模型能够以指定可靠性水平完成的任务时长。
这些衡量指标回答的是不同问题。一个系统可能更擅长修复代码库问题,或完成耗时更长的任务,但仍无法独自规划一个成功的模型开发项目。
时间跨度结果也具有概率性质。基准测试中的任务时长,并不意味着 Agent 能够在任何项目上可靠地工作同样长的实际时间。人类基线、成功阈值、工具访问权限和任务分布都会产生影响。
源文章引用了关于内部 Agent、更短发布周期、未发布模型和大规模科学产出的社交媒体讨论。这类说法可能指向值得调查的议题,但并不能独立证明存在自主自我改进闭环。
更短的发布间隔可能有多种解释。一个模型解决复杂数学问题,证明的是它在这些问题上的能力;这本身并不能说明该模型改进了自己的训练过程。同样,关于某实验室内部模型的匿名说法,不能替代具有可复现证据的技术报告。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
更站得住脚的结论更为有限:公开披露显示,AI 正在完成不断增加比例的工程工作和部分实验性研究。这样的进展是否会成为完整 RSI,仍是一个开放问题。
Anthropic 讨论了日益自动化的开发可能带来的收益和风险。能力更强的研究 Agent 可能加速科学工作,同时也会让验证、监控和对齐变得更具挑战。
同一过程还可能造成常规运营瓶颈。如果 Agent 生成代码的速度超过人们审查代码的速度,更快的生成并不会直接转化为更快、更可靠的部署。即使实施成本变低,算力可用性、实验质量以及关于构建什么的决策仍然重要。
因此,评估 RSI 时应追踪每一个阶段的证据:Agent 做了什么、谁选择了它的目标、它使用了哪些资源,以及结果如何被检查。
RSI 指递归自我改进。在这里,它是指 AI 系统能够自主设计和开发出能力更强的后继系统,而不仅仅是帮助人类改进软件。
代码生成表明,开发流程的一部分可以被自动化。完整 RSI 需要将研究方向、实施、训练和评估等更广泛的能力结合起来,因此 AI 编写代码占比高并不是充分证据。
它指的是截至 2026 年 5 月,归因于 Claude 且已合并到 Anthropic 代码库中的代码。它不应被解读为公司所有工作中由 AI 自主完成的比例,也不应被解读为 AI 作出战略决策的比例。
它可以反映产出量的变化,但不能直接衡量实用性、可维护性或业务价值。Anthropic 自己也提醒,其代码产出增长八倍的数据可能高估了真实的生产力提升。
它们描述了模型在特定任务集合上、以既定成功水平完成任务时的表现,并以人类完成任务的时长作为参考。它们并不保证 Agent 能够完成任何时长相当的现实任务。
可以;Agent 可以在由人类提供的问题与评分框架内设计和运行实验。这种方式可以带来有价值的研究自动化,同时将更高层级的决策保留给人类。
主要的 Anthropic 讨论明确指出,这并非不可避免。研究判断、算力、基础设施、评估和其他瓶颈都可能限制或改变这一发展轨迹,预测应当与已得到证明的结果区分开来。
公开证据支持这样一种判断:AI 辅助编程和受限范围内的研究自动化已有显著增长。这些进展使递归自我改进的前景值得研究,但并不能证明一个完全自主的后继系统开发闭环已经存在。
关键问题在于,一个系统能够独立执行和验证 AI 开发中的哪些环节,而不是它的发布节奏或头条基准成绩看起来有多么惊人。
从一句话开始,几分钟内拿到完整网站。



